什么是预训练:先确定预算
基座模型通过最小化下一个 token 交叉熵来学习文本的分布,通常是在打包成固定长度序列的文档混合上:
这里 |\mathcal D| 统计参与预测的 token 数。token 本身提供监督目标;文本可以包含任务或指令,但目标不需要额外人工标签。损失以每 token 奈特计,取指数后即为困惑度(第 07 模块)。预训练得到基座模型;第 09 模块 再进行指令与偏好训练。
在昂贵训练开始之前确定方案
启动前确定分词器、模型结构、数据策略和调度。后续修改可能需要重新分词、迁移权重或调整训练阶段。应先用小规模消融实验解决不确定选择,再投入长时间训练。只要明确记录,后续仍可调整数据配比或逐步增加 batch 大小。
| 决策 | 所需证据 | 对应章节 |
|---|---|---|
| 模型大小和训练 token | 计算核算和缩放拟合 | 1 |
| 数据来源、过滤、去重与污染 | 审计删除结果,做代理模型消融 | 2、3 |
| 数据配比、分词器与打包 | 来源使用次数与压缩测试 | 4 |
| 模型结构与优化器 | 参数计数与小规模扫描 | 5、6 |
| 精度和稳定器 | 特定机制的诊断 | 7 |
| 内存和并行布局 | 先算术再测量 | 8–10 |
| 恢复与评估 | 故障日志、留出损失及任务不确定性 | 11、12 |
| 小规模完整运行与领域适配 | 基线及明确的验收门槛 | 13、14 |
预训练流程及对应章节:来源、提取、语种识别、过滤、去重、去污染、数据混合、分词器、打包分片、训练、检查点、评估、基座模型。主训练之前的小规模评估,为数据和训练方案选择提供依据。
贯穿案例研究
模块 07 的假想工程团队采用中英双语模型,起草和检查反应堆容器泄压系统的安全案例论证。模型有 36 层,宽度 4,096,32 个查询头、8 个 KV 头,头维度 128,SwiGLU 中间宽度 15,360,词表大小 152,064,嵌入不共享,采用 RMSNorm,不含偏置。第 5 节精确算得 9,550,729,216 个参数;计算采用此值,速查表舍入为 9.5B,约低 0.5%。这是分析情景,不是已发布产品或真实训练计划。
首先用它理解如何构建这样的基座模型:在 80 张 H100 上,以 8,192 上下文训练 2T token。团队实际采用已发布检查点,而非执行这项计划。团队可能自行进行的训练是在 1.8B 领域 token 加 0.2B 通用回放数据上继续预训练,且只有通过第 14 节的基线比较和验收门槛才接受结果。模块 09 对保留的检查点做后训练;适配失败则回到已发布的指令模型。模块 10 部署最终结果。
统一 FLOP 计数约定
第 06 模块 推导了计数。每个 token、每个矩阵乘法权重的前向计算约需 2 FLOP;反向约为前向的两倍。输入嵌入只查表,因此嵌入不共享的模型有 N_{\text{matmul}}=N-Vd。长度 T 的序列中,因果注意力平均每 token 的前向计算量为 2LdT。考虑架构的训练估算为
内存计入全部 N 参数。Chinchilla 的已发表拟合使用其预算约定 C_6=6ND,没有单列注意力项。绘制等 FLOP 曲线及计算投资回收时应保持同一约定;其他地方应将 6ND 明确标为简化公式。这些是模型运算量估计,不含通信和大部分逐元素操作。有些论文按完整方形注意力计数:PaLM 的利用率计算采用 6N+12LTd。利用率数据必须说明计数约定。
输入表具有 152064(4096)=622854144 参数,因此 N_{\text{matmul}}=8927875072。在上下文 8,192 处:
注意力比权重项多增加 13.5% 开销。采用 6N=57.30 的简化估算时,权重项约高估 7%,总量约低估 6%。上下文增至 131,072 时,注意力增加 16 倍,每 token 总成本约为 8k 上下文的 2.8 倍。
从计算量换算训练时间
设每张设备的持续速率为 r,所需 GPU 小时为 C/(3600r),再除以 GPU 数即可得到经过小时数。模型 FLOP 利用率(MFU)是有效模型 FLOP/s 与对应精度硬件峰值的比值。硬件 FLOP 利用率(HFU)还计入重计算,因此激活检查点可以提高 HFU,却不提高有效 token 吞吐量。
本系列假设 H100 SXM 的密集 bf16 峰值为 989 TFLOP/s,持续速率为 r=4\times10^{14} FLOP/s,约对应 40% MFU。精确乘积 0.40(989) 为 395.6 TFLOP/s;正文或交互组件使用精确峰值时采用这个数。利用稀疏性的峰值不适用于密集训练。这些只是规划假设,实际吞吐量、停机时间和并行布局决定日历耗时。
全表采用 6ND、舍入后的 9.5B 参数和 r=4\times10^{14} FLOP/s。各行用于假设比较,不是历史训练记录。
| 训练 | 简化估算 FLOP | GPU 小时 | 经过时间 |
|---|---|---|---|
| 9.5B,训练 190B token | 1.083\times10^{22} | 7,521 | 16 张 GPU,19.6 天 |
| 9.5B,训练 2T token | 1.14\times10^{23} | 79,167 | 80 张 GPU,41.2 天 |
| 9.5B,训练 15T token | 8.55\times10^{23} | 593,750 | 80 张 GPU,309.2 天 |
| 1B,训练 20B token | 1.2\times10^{20} | 83.3 | 4 张 GPU,20.8 小时 |
| 9.5B,继续训练 2B token | 1.14\times10^{20} | 79.2 | 8 张 GPU,9.9 小时 |
精确模型结构需要 60{,}815{,}007{,}744(2\times10^{12})= 1.2163\times10^{23} FLOP。按舍入后的持续速率,需 84,465 GPU 小时,即 80 张 GPU 上的 44.0 天。若精确取上述峰值的 40%,需 85,405 GPU 小时、44.5 天;30% MFU 时则需 59.3 天。假设每 GPU 小时 2.50 美元,舍入速率下的 GPU 时间成本约 211,000 美元,不含消融、失败训练、存储与人员。在相同假设下,2B token 的继续预训练计划成本为其千分之一。
分配训练与服务预算
模块 07 推导了 Chinchilla 分配。已发表的舍入参数拟合为
常数对应特定语料、分词器和 70M–16B 参数、5B–500B token 的拟合实验。每参数二十 token 的经验规则关联论文中的其他估计方法;参数化拟合的最小值具有不同的比例。下方浅色曲线段表示外推。
Chinchilla 在预算 C_6=10^{20},10^{21},10^{22},10^{23} 下的拟合损失。圆点标出拟合最小值,十字标出每参数二十 token 的分配。菱形表示 9.55B 案例模型分别训练 190B、2T 和 15T token。超出原始参数或 token 拟合范围的曲线使用浅色;这些都不是案例模型的实测结果。
精确案例结构训练 2T token 时,C_6=1.14609\times10^{23}:
| 分配 | 参数 | token | 拟合损失 |
|---|---|---|---|
| 案例研究 | 9.551B | 2.000T | 2.00199 |
| 固定预算的拟合最小值 | 15.526B | 1.230T | 1.99848 |
| 每参数二十 token | 30.904B | 0.618T | 2.00537 |
三种损失相差不到 0.007 奈特,近似服务运算量 2N 却差异很大。若比较相同损失,拟合最优方案以 15.018B 参数、1.182T token 达到案例损失,训练成本为 C'_6=1.065\times10^{23}。令生命周期运算量相等,C_6+2NS=C'_6+2N'S,得到
按团队每天 12M token 的用量,约需 170 年;按每天 10B token,则约需 74 天。模型生产者可能服务大量用户,因此生命周期总用量会改变选择。这个比较外推了拟合,假设相同损失对应相同质量,并忽略注意力、量化、batch 和价格。它不能预测真实部署的延迟或任务得分。
为什么必须区分固定预算下的最低损失与等损失下的服务比较?
查看答案
固定预算的替代方案具有不同预测损失。要判断额外训练何时能换来相同拟合质量下更便宜的服务,须先求出损失相同的替代方案,再比较训练与服务开销。
数据 I:来源、提取、语种与质量过滤
除规模外,数据质量是影响最大的因素,数据流程也占据预训练的大部分工程工作。本节及后两节沿图 8.1 从原始文本走到训练序列。每个阶段都有带阈值的规则,也都会误删本应保留的文本,因此同时说明阈值和误删对象。图 8.3 用漏斗展示各阶段。
过滤漏斗以逐级缩短的水平条表示:URL 过滤、文本提取、语种识别、启发式规则、去重和质量分类器。比例仅作示意,不表示数量;旁注给出正文引用的 FineWeb(约 15T token)与 FineWeb-Edu(约 1.3T)公开数据。各阶段旁列出一个删除对象:成人网站 URL、cookie 横幅、英文语料中的法语页面、导航栏、镜像页面和关键词垃圾文本。
数据来源与清单
Common Crawl 是几乎所有网络语料的基础:公开抓取结果约每月发布一次快照,每份包含数十亿页面。WARC 文件保存原始 HTTP 响应,WET 文件保存 Common Crawl 自身提取的纯文本。语料通常还加入代码仓库、书籍、学术论文、参考资料和论坛。案例中的双语模型还按使用目的加入中文网络、书籍及学术文本。
许可与同意问题尚未完全解决,各司法辖区也不同。抓取时遵守 robots.txt 中的退出指示。语料清单为每个组成部分记录来源、快照或日期、许可、所用过滤器及 token 数。这是最基本的记录;缺少它,日后便无法说明模型训练数据,或排除被发现有问题的组成部分后重建语料。
提取和编码
网页包含大量非正文内容:导航、cookie 横幅、页脚和重复页眉。trafilatura 等专用提取器定位 HTML 主文本。直接处理 WARC HTML,而非采用 WET 文本,可能带来收益:FineWeb 作者用两种结果训练小模型,发现仅这项选择就能改善模型。
编码修复也在此阶段进行。将 UTF-8 误解码为 Windows-1252,会把长破折号变成 —。这种乱码(mojibake)可能通过下方所有质量规则,因为周围词语正常。实验 1 在 5,000 篇原始 TinyStories 文档中标记了 303 篇可疑文本,约 6%;只有 97 篇通过简单的整串修复探测。这是启发式标记,并非完整编码审计;保留这些问题可能教模型再现乱码。
语种识别
基于字符 n-gram 特征的线性分类器,为每篇文档给出各语言分数;常用的是 fastText 语种识别模型(Joulin 等,2017)。保留最高分超过阈值的文档,再按所需比例采样;FineWeb 英文流程的阈值为 0.65。字符 n-gram 有效,是因为不同语言在少量词中已有不同字母组合。短文本的 n-gram 太少,难以判断;中英混写技术文本可能把分数分散到两种语言,均未过阈值;相近语言和文字也会混淆。
启发式质量过滤器
Gopher 规则(Rae 等,2021)使用按空白分词后可廉价计算的统计量。文档违反任一规则即删除:
- 词数少于 50 或多于 100,000;
- 平均词长不在 3–10 个字符之间;
- 每词的井号或省略号数多于 0.1;
- 超过 90% 的行以项目符号开头,或超过 30% 的行以省略号结尾;
- 含字母字符的词少于 80%;
- 以下停用词出现不足两个:the、be、to、of、and、that、have、with;
- 重复:超过 30% 的行或段落重复;最频繁的 2、3、4 元字符组分别覆盖超过 20%、18%、16% 的字符;重复 n 元字符组覆盖比例超过对应阈值,阈值从 5 元组的 15% 降至 10 元组的 10%。
每条规则针对一种垃圾内容:长度规则针对片段和转储,符号规则针对标签云,项目符号和省略号规则针对列表和预告,字母规则针对数字表格,重复规则针对模板和垃圾文本。停用词规则是最廉价的正文检测。
文档 (a) 是一份维修记录:
报警前三天,泵轴轴承持续过热。外圈磨损使配合松动, 增大的间隙使轴振动。维修团队更换了轴承, 用百分表检查对中,并把检查间隔从六个月缩短到三个月, 因为振动日志显示故障已经发展数周。
文档 (b) 将 Home | About us | Contact | Privacy policy | Login | Cart 重复五行;文档 (c) 将 BUY NOW!!! $$$ #deal CHEAP #sale watches FREE shipping >>> 在同一行重复八次。下面按英文原文的空白分词计数,标点仍附在词上:
| 统计量 | 限制 | (a) | (b) | (c) |
|---|---|---|---|---|
| 词数 | 50–100,000 | 68 | 5 × 13 = 65 | 8 × 10 = 80 |
| 平均词长 | 3–10 | 4.65 | 3.46 | 4.90 |
| 每词井号数 | 不多于 0.1 | 0 | 0 | 16/80 = 0.20,不通过 |
| 含字母的词 | 不少于 80% | 100% | 40/65 = 61.5%,不通过 | 64/80 = 80% |
| 出现的停用词 | 不少于 2 个 | 4(and、the、to、with) | 0,不通过 | 0,不通过 |
| 重复行 | 不多于 30% | 0 | 4/5 = 80%,不通过 | 无(只有一行) |
(a) 通过全部规则。(b) 的 65 个“词”包括 25 个 | token,因此通过长度规则,却不通过字母、停用词和重复行规则。(c) 不通过符号及停用词规则,含字母比例恰好 80%,可通过字母规则。两个垃圾页面还违反 n-gram 重复限制:超过一半字符处在重复的 5-gram 中,远高于 15% 阈值;所以即使去掉井号,只有一行的 (c) 仍会被检出。实验 1 将这些规则的明确子集应用到更大语料,记录每篇文档首个失败项。与完整生产过滤器比较前,应先检查规则定义和首个失败计数。
C4 的清理(Raffel 等,2020)采用不同做法,逐行处理:只保留以句末标点结束的行,删除含“lorem ipsum”或花括号的页面,并删除含有淫秽词屏蔽列表中任一词的页面。花括号规则原本针对网页残留的 JavaScript,却也删除了几乎所有源代码,因此代码需要独立流程(练习 5)。
规则依赖语言。按空白分词的规则不适用于中文,因为中文词之间没有空格,整段会被视为少数很长的“词”。中文组成部分需要对应的字符规则:字符长度、汉字占比、重复字符 n-gram,以及“的”“是”等常见虚词组成的中文停用词表。
基于模型的质量过滤器
小型分类器学习区分高质量参考文本和随机网络文本,再为每篇文档评分;语料可按分数阈值过滤,或按随分数增加的概率采样。公开记录的例子是 FineWeb-Edu(Penedo 等,2024):大语言模型按 0–5 分评估约 450,000 页的教育价值,嵌入模型上的小型分类器学习评分后,处理全部约 15T token 的 FineWeb。保留 3 分及以上,得到约 1.3T token;用它训练的模型,在知识和推理基准上优于使用同量 FineWeb token 的模型。DCLM(Li 等,2024)为同一目的训练 fastText 分类器,成本足够低,可处理整次抓取。
1.3\text{T}/15\text{T} = 0.087:分类器保留约 8.7% token,即每 11.5 个保留一个。只从 FineWeb-Edu 取数据训练 2T token,每个 token 平均出现 2/1.3 = 1.5 次,处于重复成本较低的范围(第 4 节);训练 15T token 则平均重复 11.5 次,远超该范围。严格过滤以数量换质量,而重复限制决定这种交换能走多远。
主要失败是覆盖范围收窄。分类器编码了标注者的偏好,例如百科式、正式、以英文为中心。因此有价值但风格不同的维修日志、论坛排障讨论、代码注释和其他语言文本,可能因低分被删除。
个人数据和安全
正则表达式查找邮箱、电话号码和 IP 地址,将它们替换为 <EMAIL> 等占位 token,而非直接删除,以保持文本连贯。姓名难以可靠识别,通常大多保留。过度匹配会损害技术文本:10.2.0.1 这样的版本号就像 IP 地址。
安全过滤采用 URL 屏蔽列表和分类器,粗糙规则也会带来损害:Dodge 等(2021)发现,C4 词语屏蔽列表不成比例地删除了少数群体撰写或相关的文本。删除所有有害文本,也会削弱模型识别它们的能力,而后训练(第 09 模块)教模型拒绝时需要这种识别能力。
按成本排序,并保留日志
先运行廉价过滤器:URL 屏蔽列表、语种识别和启发式规则;再对剩余文本运行昂贵的模型分类器及近似重复检测。记录每篇文档被删除的原因。模型日后出现问题时,这些日志就是调试依据,可据此发现某个过滤器删掉了需要的领域文本。
为什么停用词规则能廉价地检出垃圾文本和导航页面?
查看答案
自然正文几乎总包含八个最常见英文虚词中的至少两个,菜单、列表和关键词垃圾文本则常常没有。测试只需对已分词文本求集合交集。
把偏好维基百科式文本的质量分类器用于维修日志,会发生什么?你会如何处理?
查看答案
多数日志得分低而被删除,尽管它们恰是所需领域数据。质量分类器编码了风格偏好,因此可为领域数据设计专用过滤器,或豁免该分类器,同时检查删除日志,了解每个过滤器实际删掉了什么。
数据 II:去重与去污染
网络中存在大量重复:镜像、转载、模板和复制,让同一许可文本、通用页脚和新闻出现数千次。重复浪费计算,增加记忆及逐字输出,并使数据配比偏向复制最多的内容。两项研究说明了影响大小。Lee 等(2022)发现,在去重 C4 上训练的模型输出记忆文本的频率约降低十倍,并以更少步骤达到相同或更好的准确率。Hernandez 等(2022)发现,将 0.1% 数据重复 100 次,会让 800M 参数模型的表现降至约一半规模的水平,即使 90% 训练 token 仍然唯一。
精确重复
规范化每篇文档,例如转小写、合并空白,再计算 SHA-1 或质量良好的 64 位哈希,每个哈希只保留首次出现的文档。还可跨文档在行、段落级去除成千页面重复的 cookie 通知、页脚和许可段落。更细粒度的方法处理子串:语料后缀数组能找出多次出现的文本片段;Lee 等删除了长度至少 50 token 的重复片段。
近似重复和 Jaccard 相似度
日期变化、广告不同或少数词被修改的页面,哈希也会不同。检测近重复时,将文档表示为其包含的词 n-gram 集合,称为 shingles(连续词片段),这里使用 5-gram。用 Jaccard 相似度衡量两个集合的重叠:
网络规模下无法对所有文档对计算 J。MinHash 用短签名估计相似度,分带则避免比较绝大多数文档对(图 8.4)。
MinHash 与分带示意。两篇短文档变成 5 词 shingle 集合,画成有阴影交集的圆,旁标 J。每个集合生成 128 项签名,分成 16 个带,每带 8 项。某个带的全部 8 项一致时突出显示,使文档对成为候选,再用精确 Jaccard 相似度验证。
推导 MinHash
对所有 shingle 的取值范围施加随机排列 \pi,记录各集合排列值的最小值,则
证明很简短。考虑 \pi(A \cup B) 中排列值最小的元素。随机排列不偏好任何元素,所以并集中的 |A \cup B| 个元素均等可能成为最小值。若它位于 A \cap B,它同时是两个集合的最小值;若只在其中一个集合,它是该集合的最小值,另一集合的最小值则更大。因此,两最小值恰在整体最小元素属于 A \cap B 时相同,概率为 |A \cap B|/|A \cup B|。
一个随机排列相当于一次正面概率为 J 的抛硬币。采用 k 个独立排列,令 h_i(A) 表示集合 A 在第 i 个排列下的最小值。一致比例
是 J 的无偏估计,因为每个指示变量均值为 J。其方差为 J(1 - J)/k,因为 k\hat J 服从 k 次试验的二项分布。这 k 个最小值构成文档的签名,每篇只计算一次;无论文档多长,比较两个签名只需 k 次整数比较。实际中用廉价哈希 h(x) = (ax + b) \bmod p 近似随机排列,其中 a、b 随机选取,p 是大素数。这就是 Broder(1997)的 MinHash。
\hat J 的标准误为 \sqrt{J(1 - J)/k}:
- J = 0.8、k = 128: \sqrt{0.8 \times 0.2/128} = \sqrt{0.00125} = 0.035。
- J = 0.5、k = 128: \sqrt{0.25/128} = 0.044。
- J = 0.8、k = 256: \sqrt{0.16/256} = 0.025。
误差减半需要四倍哈希数量。J = 0.8 时,两个标准误为 \pm 0.07,足以区分 0.8 与 0.5,却不能区分 0.80 与 0.75。实验 1 用 128 个哈希测得,相对精确 Jaccard 的平均绝对误差约为 0.03,与这些标准误吻合;正态估计的平均绝对误差约为标准误的 0.8 倍。
推导 LSH 分带
签名使单次比较便宜,但十亿文档仍有 5 \times 10^{17} 个文档对。局部敏感哈希(LSH)仅比较可能相似的文档对。将 k = br 项签名分为 b 个带,每带 r 行,把每篇文档的各带哈希到桶中。若两篇文档在某个带共享桶,即该带的 r 行全部相同,就成为候选对。
相似度为 s 时,每行独立地以概率 s 一致,一个带全部一致的概率为 s^r,不一致的概率为 1 - s^r。全部 b 个带均不一致的概率为 (1 - s^r)^b,因此
这是关于 s 的 S 形曲线(图 8.5)。最陡点 d^2P/ds^2 = 0 满足 s^r = (r - 1)/(rb - 1);对于实际的 b 和 r,它接近 1/b,所以阈值近似为
恰好位于阈值的文档对,以约 1 - (1 - 1/b)^b \approx 1 - e^{-1} = 0.63 的概率成为候选。每带行数更多,曲线更陡、阈值更高;带数更多则降低阈值。
把 k = 128 分为 b = 16、r = 8 时,阈值为 (1/16)^{1/8} = 0.71。在 s = 0.5 处,单带一致概率为 0.5^8 = 0.0039,16 个带全部不一致概率为 (1 - 0.0039)^{16} = 0.939,所以 P = 0.061。其他相似度按同样步骤计算:
| s | 0.3 | 0.5 | 0.6 | 0.7 | 0.75 | 0.8 | 0.85 | 0.9 |
|---|---|---|---|---|---|---|---|---|
| P(\text{candidate}) | 0.001 | 0.061 | 0.237 | 0.613 | 0.815 | 0.947 | 0.994 | 0.9999 |
FineWeb 的 b = 14、r = 8(阈值 0.72)在相似度 0.5、0.75、0.8 处,候选概率分别为 0.053、0.772、0.924。较宽松的 b = 32、r = 4(阈值 0.42)让 87% 的 s = 0.5 文档对成为候选,需要验证更多文档;较严格的 b = 8、r = 16(阈值 0.88)只检出 s = 0.8 文档对的 20%。
几行代码即可重现此表,并探索其他 b、r 组合:
def p_candidate(s, b, r):
    """Probability that a pair with Jaccard similarity s agrees in at least one band."""
    return 1 - (1 - s ** r) ** b


for b, r in [(16, 8), (14, 8), (32, 4), (8, 16)]:
    threshold = (1 / b) ** (1 / r)
    row = " ".join(f"{p_candidate(s, b, r):.3f}" for s in (0.5, 0.6, 0.7, 0.8, 0.9))
    print(f"b={b:2d} r={r:2d} threshold {threshold:.2f} | P at s=0.5..0.9: {row}")
b=16 r= 8 threshold 0.71 | P at s=0.5..0.9: 0.061 0.237 0.613 0.947 1.000
b=14 r= 8 threshold 0.72 | P at s=0.5..0.9: 0.053 0.211 0.565 0.924 1.000
b=32 r= 4 threshold 0.42 | P at s=0.5..0.9: 0.873 0.988 1.000 1.000 1.000
b= 8 r=16 threshold 0.88 | P at s=0.5..0.9: 0.000 0.002 0.026 0.204 0.806
LSH 的 S 形曲线:横轴为 Jaccard 相似度 s(0 到 1),纵轴为文档对成为候选的概率(0 到 1)。曲线对应 (b, r) = (16, 8)、(14, 8)、(32, 4)、(8, 16),竖线标出各自阈值 (1/b)^{1/r}(0.71、0.72、0.42、0.88)。实验 1 在各相似度区间测得的检出率以散点绘在 (16, 8) 曲线旁。
成本、验证与聚类
对全部 n 文档两两比较,需要 n(n - 1)/2 次比较。LSH 将每篇文档插入 b 个桶,每带一个,只比较共享桶的文档。随后在 shingle 集合上用精确 Jaccard 阈值验证候选;按这个策略,误报候选只增加验证时间,不会产生错误接受的文档对。签名一致比例是带采样误差的近似替代,可误接受低于精确阈值的文档对。用并查集将已验证的文档对分成簇,因为近重复会成链:A 接近 B,B 接近 C。每簇保留一篇文档。
10^9 篇文档形成 10^9 \times (10^9 - 1)/2 \approx 5 \times 10^{17} 个文档对。16 个带需要 16 \times 10^9 = 1.6 \times 10^{10} 次桶插入,每次计算 8 个整数的哈希,只比较共享桶的文档。实验 1 的 6,400 篇语料有 6{,}400 \times 6{,}399/2 = 20{,}476{,}800 个文档对,约 20.5M;记录的运行中 LSH 只提出约 780 个候选。
已发表流程的选择
FineWeb 使用 5 词 shingle、112 个哈希,分成 14 个带,每带 8 项,针对相似度约 75% 的文档对。它还发现,对每个抓取快照单独去重,比对所有快照一起去重训练出的模型更好。较旧快照经全局去重后,主要剩下其他快照没有的页面,而这些页面质量低于被删除的内容。
修改幅度与阈值同样重要。随机替换比例 q 的词,会破坏所有包含该词的 shingle,因此长度 n 的 shingle 约有 s = (1 - q)^n 存活。若每篇文档约有 m 个 shingle,共享 sm 个,则 J \approx sm/(2m - sm) = s/(2 - s)。shingle 越长,近似副本看起来越不相似。
对 5 词 shingle,q = 0.05(每二十词改一个)给出 s = 0.95^5 = 0.774、J = 0.774/1.226 = 0.63。完整结果为
| q | 0.01 | 0.03 | 0.05 | 0.08 | 0.12 | 0.20 |
|---|---|---|---|---|---|---|
| s = (1 - q)^5 | 0.951 | 0.859 | 0.774 | 0.659 | 0.528 | 0.328 |
| J = s/(2 - s) | 0.91 | 0.75 | 0.63 | 0.49 | 0.36 | 0.20 |
每二十词改一个的副本,相似度仅约 63%;16 个带、每带 8 项的设置只让约三分之一成为候选。每八词改一个(J = 0.36)则几乎从不成为候选。若用 13 词 shingle,同样 5% 修改得到 s = 0.95^{13} = 0.513、J = 0.35。
去污染
测试题进入训练数据后,基准可能测到答案记忆而非解题能力。去污染(decontamination)删除与拟报告评估集共享长 n-gram 的训练文档。GPT-3(Brown 等,2020)采用 13-gram 重叠,这个长度的偶然匹配很少。应在训练前处理,保留删除清单,并把未经去污染的公开基准视为可能受污染。常见短语、许可文本及著名引文会造成误报;改写或翻译的测试题不共享原题的长 n-gram,会造成漏报。对案例中的双语模型,译成中文的英文测试题可通过所有 n-gram 检查。第 07 模块,第 12 节 讨论如何解读可能污染的能力声明,第 09 模块 讨论后训练数据污染。
为什么 MinHash 碰撞概率恰好是 Jaccard 相似度?
查看答案
A \cup B 中哈希最小的元素均等可能是其中任一元素;它属于 A \cap B 时,两集合的最小值恰好一致。
b = 16、r = 8 时,真实 Jaccard 为 0.6 的文档对有多少成为候选?这有什么影响?
查看答案
约 24%:1 - (1 - 0.6^8)^{16} = 0.237。只要在删除文档前按阈值验证每个候选,它们只增加验证时间,不损害正确性。
为什么应在训练前去污染,而不是训练后删掉重叠测试题?
查看答案
事后删除测试题会缩小评估集,使其偏向抓取未包含的内容。先去污染可保留完整、干净的测试集,并留下删除记录。
数据 III:配比、多语言平衡、分词器与打包
过滤和去重后,语料由若干来源组成,每个有一定数量的唯一 token。三个决策把它们变成训练数据:每个来源用多少、如何分词,以及如何将 token 打包成序列。
配比
数据混合由各来源权重 w_s 构成,总和为 1。训练 D token 时,来源 s 提供 w_s D token;若该来源有 U_s 个唯一 token,平均被使用 w_s D/U_s 次。配比主动选择,不照搬抓取的自然比例。代码也可改善非代码推理任务;少量参考资料和教材可提升整体模型;任一来源过多则会收窄覆盖。因此,小型高质量来源常被有意重复两到四次。Muennighoff 等(2023)发现,最多约四轮重复数据几乎与新数据同样有效,再继续重复则价值迅速下降。
训练总 token 为 w_s \times 2\text{T};轮数等于使用 token 数除以唯一 token 数:
| 来源 | 唯一 token | 权重 | 训练使用 token | 轮数 |
|---|---|---|---|---|
| 英文网络 | 1,500B | 50% | 1,000B | 0.67 |
| 中文网络 | 600B | 20% | 400B | 0.67 |
| 代码 | 400B | 15% | 300B | 0.75 |
| 学术论文 | 80B | 6% | 120B | 1.5 |
| 图书 | 50B | 4% | 80B | 1.6 |
| 参考资料 | 20B | 2% | 40B | 2.0 |
| 数学 | 30B | 3% | 60B | 2.0 |
权重合计 100%,token 合计 2,000B。网络来源尚未全部用完;四个较小的精选来源获得其自然占比的两到三倍,例如参考资料占 2,680B 唯一 token 的 0.75%,训练权重却为 2%。这些来源会重复,但都不到四轮。数字仅作示意,不是任何模型的训练方案。
用代理训练调整配比:在候选混合上训练 100M–1B 参数模型,比较各领域留出损失及小型基准组。DoReMi(Xie 等,2023)则学习权重:训练小型代理模型时,提高其损失远落后于参考模型的领域权重,再把得到的权重用于大型训练。无论哪种方法,都应先确定大型训练的配比或分阶段配比调度。风险是代理模型找到的排名不一定迁移到更大模型。
多语言平衡
用温度采样平衡语言,采样语言 l 的概率为
其中 q_l 是该语言在可用数据中的占比。\alpha = 1 保持自然比例,\alpha \to 0 时趋向均匀;\alpha = 0.3 很常见,mT5 就采用它。代价是低资源语言重复更多;固定容量下,各语言还会竞争参数。
数据占比为 q = (0.80, 0.15, 0.05)。当 \alpha = 0.3 时,0.80^{0.3} = 0.935、0.15^{0.3} = 0.566、0.05^{0.3} = 0.407 合计 1.909,得到 p = (0.490, 0.297, 0.213)。当 \alpha = 0.5 时,p = (0.594, 0.257, 0.149);当 \alpha = 0.7 时,p = (0.688, 0.213, 0.099)。在 \alpha = 0.3 下,最小语言的采样概率是自然占比的 0.213/0.05 = 4.3 倍,最大语言为 0.490/0.80 = 0.61 倍,所以最小语言的重复频率约为最大语言的七倍,在最大语言完成首轮前已达到四轮。
分词器
BPE 算法见 第 07 模块,这里把分词器作为数据流程决策。先在最终数据混合的样本上训练,因为预算、来源权重和上下文长度都以其 token 计。词表大小 V 带来嵌入参数 Vd(不共享时加倍)及输出 softmax 开销(前向每 token 2dV FLOP),同时换取较短序列:词表越大,文本通常切成更少 token。32k 适合英文;双语或多语言语料常用 100k–150k,让各语言都能学到自己的合并。压缩效率决定各语言的上下文和计算成本:每字符需要两倍 token,就需约两倍文档成本,窗口只能放入一半文本。其他选择由实验确定:逐位分数字以改善算术、字节回退保证覆盖、提前保留聊天模板所需特殊 token(第 09 模块),以及将 V 填充到 64 或 128 的倍数以提高 kernel 效率;案例的 152,064 即 1{,}188 \times 128。
| V = 32{,}000 | V = 152{,}064 | |
|---|---|---|
| 嵌入参数 Vd | 131M(不共享时 262M) | 623M(不共享时 1.25B) |
| 一条 8,192-token 序列的 fp32 logits,占用 8{,}192 \times V \times 4 字节 | 1.05GB | 4.98GB |
| 输出头前向,每 token 2dV | 0.26 GFLOP | 1.25 GFLOP |
案例中,两个词表矩阵占全部参数的 13%;输出头占前向计算的 7%,即每 token 1.79 \times 10^{10} FLOP 中的 1.25 \times 10^9 FLOP。logits 也常是训练步骤中最大的单个张量(第 8 节)。双语词表会在这三处付出成本。
打包
用文档结束 token 连接文档,再切成长度 T 的序列,避免填充浪费计算。可允许同序列内跨文档注意力,做法简单却引入无关上下文;也可用块对角因果掩码限制(图 8.6)。Llama 3 采用掩码,发现标准预训练中影响较小,但极长序列中影响明显。长文档会跨序列切分;最佳适应打包(Ding 等,2024)像装箱一样把整篇文档分配到序列,减少切分。
打包示意。五篇不同长度的文档画成彩色条,用文档结束标记连接,再切成固定长度 T 的行。旁边画出一行跨越三篇文档时的两种 T \times T 注意力掩码:完整因果三角允许跨文档注意力,块对角因果掩码则将跨文档区域置灰。
实验 2 在 TinyStories 上训练 4,096 token 的 BPE。含文本结束 token 的故事平均长 222 token,中位数 194,第 90 百分位 333,最长 1,120。每篇填充到 512,平均只用 512 个位置中的 222 个,约 1 - 222/512 = 57\% 计算被浪费;超过 512 的 2.9% 故事仍被截断。填充到 256 则浪费 23%,因为长故事填满整行,同时截断 19% 故事。打包成 256 token 窗口可避免大部分填充,但末尾不完整窗口需要明确策略。跨窗口的故事会被切开,后半部分失去前半部分的上下文。
分片与加载器
分词后语料在分片中存成 token ID 的平面数组。词表不超过 65,536 项时采用 uint16,例如 实验 2 的 4,096;更大词表采用 uint32,例如案例中的 152,064。加载器位置,包括分片、偏移和随机状态,必须保存在每个检查点(第 11 节)中,以免恢复后重复或跳过数据。
一个有 20B token 的来源,在 2T token 训练中占 2%。相当于多少轮?是否有问题?
查看答案
使用 0.02 \times 2\text{T} = 40\text{B} token,即 40\text{B}/20\text{B} = 2 轮,处于重复成本较小的约四轮以内。
为什么要在最终配比上训练分词器而不是仅在英文网络文本上训练?
查看答案
只用英文训练的分词器对中文和代码压缩较差,未学到其常见字符串的合并,每字符消耗更多 token,从而占用更多计算和上下文。
大规模架构:结构、混合专家与 muP
第 1 节 确定参数预算,本节把预算变成模型结构。块本身来自 第 06 模块:RMSNorm 前置归一化、RoPE 分组查询注意力、SwiGLU 前馈网络及无偏置。剩余选择是尺寸和若干通常参考先例的开关,还有规模增大后出现的两个问题:是否把前馈层换成混合专家,以及如何将小模型调好的超参数迁移到大模型。
计算一个块
第 06 模块,第 11 节 推导了块的参数量。设有 n_h 个查询头、n_{kv} 个键值头,头维度为 d_h,每层包含
模型另外加入嵌入参数 Vd(输出头不共享时加倍)及最终归一化参数 d。通常 n_h d_h = d、n_{kv} = n_h/4,注意力参数为 d^2 + d^2/2 + d^2 = 2.5d^2,因此每层为 (2.5 + 3d_{\text{ff}}/d)\,d^2 加归一化参数:d_{\text{ff}} = 3.5d 时为 13d^2,例如 Llama 3 8B;案例中的 3.75d 则为 13.75d^2。
粗略规则 N \approx 12Ld^2 来自旧式块:完整多头注意力(4d^2)与隐藏宽度 4d 的 GELU MLP,两个矩阵为 d \times 4d、8d^2。SwiGLU 的 \mathbf{W}_{\text{down}}\big(\mathrm{SiLU}(\mathbf{W}_{\text{gate}}\mathbf{x}) \odot \mathbf{W}_{\text{up}}\mathbf{x}\big) 含三个矩阵,合计 d \times d_{\text{ff}};若要与 GELU MLP 参数相同,需 3d\,d_{\text{ff}} = 8d^2,即 d_{\text{ff}} = 8d/3,这就是 8/3 规则的来源。许多较新模型扩大到 3–3.75d,再减少层数以维持参数预算。
配置沿用模块 07 的假设案例,并补上预训练细节:L = 36、d = 4{,}096,32 个查询头、8 个 KV 头,d_h = 128,每个 GQA 组含 4 个查询头,因此 h_{kv} = n_{kv}d_h = 1{,}024;SwiGLU d_{\text{ff}} = 15{,}360;RMSNorm 前置归一化及最终归一化;RoPE 基数 500,000;预训练上下文 8,192;中英字节级 BPE 词表大小 152,064;嵌入不共享、无偏置。
- 注意力:4{,}096 \times 4{,}096(Q)+\ 2 \times 4{,}096 \times 1{,}024(K、V)+\ 4{,}096 \times 4{,}096(O)= 41{,}943{,}040。
- SwiGLU:3 \times 4{,}096 \times 15{,}360 = 188{,}743{,}680。两个归一化:8{,}192。
- 每层 230{,}694{,}912(13.75d^2 + 2d),36 层合计 8{,}305{,}016{,}832。
- 嵌入:每表 152{,}064 \times 4{,}096 = 622{,}854{,}144,两表共 1{,}245{,}708{,}288;最终归一化 4{,}096。
总量为 9{,}550{,}729{,}216:块占 8.31B,两张嵌入表占 1.25B。规则 12Ld^2 = 7.25\text{B} 少算了 1.06B 个块参数:在 3.75d 下,FFN 实际为 11.25d^2,规则却假设 8d^2;GQA 仅节省注意力的 1.5d^2,即 4d^2。
对另一结构同样计数:L = 32、d = 4{,}096,32/8 个头,d_{\text{ff}} = 14{,}336、V = 128{,}256,嵌入不共享,得到 6{,}979{,}584{,}000 + 1{,}050{,}673{,}152 + 4{,}096 = 8{,}030{,}261{,}248,即已发布 Llama 3 8B 的 8.03B。实验 4 核对这两种参数量。
案例解码器块以一条 8,192 token 序列标注张量形状:残差流 (1, 8192, 4096),Q (1, 32, 8192, 128),K、V (1, 8, 8192, 128),SwiGLU 隐藏激活 (1, 8192, 15360)。各矩阵参数量:Q 16.8M、K 4.2M、V 4.2M、O 16.8M、门控 62.9M、上投影 62.9M、下投影 62.9M。块重复 36 次,位于输入嵌入(622.9M)与不共享输出头(622.9M)之间。
选择形状
9–10B 模型的候选选择,需用代理训练验证:
| 决定 | 典型选择 | 原因 |
|---|---|---|
| 层数 L | 32–42 | 不同结构的损失差异较平坦;更深模型增加每 token 时间和流水线阶段成本 |
| 宽度 d | 3,584–4,096 | 根据 N、L 推得;128 的倍数利于 kernel |
| 查询头 / KV 头 | 28–32 / 4–8 | 每组 4–8 个查询头的 GQA 缩小 K、V 和 KV cache,损失代价较小 |
| 头维度 | 128 | 约定和 kernel 效率 |
| FFN | SwiGLU | 在相同参数下,损失低于 GELU MLP |
| 归一化 | RMSNorm 前置归一化,加最终归一化 | 稳定深层训练,比层归一化便宜 |
| 位置 | RoPE,基数 10^4–10^6 | 更大基数适用于更长预期上下文(第 14 节) |
| 词表 | 双语 128k–152k;共享或不共享 | 压缩两种语言(第 4 节);不共享增加 Vd 参数 |
| 预训练上下文 | 4k–8k,训练中期延长 | 注意力成本随 T 增长;从一开始就采用极长上下文较浪费 |
| 偏置 | 无 | 质量收益有限;移除可改善稳定性并简化实现 |
| 密集或 MoE | 这个规模采用密集模型 | 混合专家以内存和通信换取 FLOP,见下文 |
先确定参数预算,再选结构,检查 kernel 效率及逐层执行成本。代理消融提供迁移证据,却不保证每项选择在完整规模下都表现相同。
大规模混合专家
第 05 模块,第 12 节 引入了混合专家。LLM 规模下,每个 FFN 换成 E 个专家 FFN 和路由器;路由器由 d \times E 线性层及 softmax 组成。每个 token 进入得分最高的 k 个专家,输出按路由权重加权求和:
每 token 计算量取决于它经过的激活参数;内存取决于总参数,因为每个专家的权重、梯度和优化器状态都需存储。
将 36 个 FFN 各换成 8 个同大小专家,每层采用 top-2 路由及 4{,}096 \times 8 路由器。
- 总参数:36 \times (41{,}943{,}040 + 8 \times 188{,}743{,}680 + 32{,}768 + 8{,}192),加上嵌入和最终归一化后为 = 57.1\text{B}。
- 每 token 激活参数(注意力、两个专家、路由器、归一化):36 \times 419{,}471{,}360,加嵌入及最终归一化后为 = 16.3\text{B}。其中 15.7B 参与矩阵乘法,即除输入嵌入之外的全部参数。
- 按本系列规则(第 1 节),每 token 训练 FLOP 为 6 \times 15.7 \times 10^9 + 7.25 \times 10^9,加注意力 T = 8{,}192,合计 = 1.02 \times 10^{11},约为密集模型 6.08 \times 10^{10} 的 1.7 倍。
- 模型状态每参数 16 字节(第 8 节),合计 16 \times 57.1\text{B} = 914 GB,是密集模型 152.8 GB 的 6.0 倍。
八倍 FFN 参数带来 1.7 倍计算量和六倍内存。
专家并行将专家分到多个 GPU。每个 token 经一次 all-to-all 调度到持有目标专家的 GPU,输出再经第二次 all-to-all 合并回原 GPU。bf16 下,每 token、每 MoE 层约移动 2 \times k \times d \times 2 字节;上例为 2 \times 2 \times 4{,}096 \times 2 = 32{,}768 字节。因此一条 8,192 token 序列经过 36 层,前向最多传输 9.7 GB,反向也约相同。所选专家位于其他节点时,较慢的 第 9 节 链路可能让 all-to-all 成为瓶颈(图 8.8)。
四张 GPU 上的专家并行调度与合并,每张持有两个专家。每个 token 路由到两个专家所在 GPU,输出返回原 GPU。示例中每个专家容量为 2,560 次分配。溢出分配的贡献从专家和中省略,残差路径仍保留。箭头表示执行阶段,不是实测通信量。
负载均衡。 若不约束,路由器可能只选择少数专家:被偏好的专家获得更多梯度,进而改善并获得更多选择。Switch Transformer 的辅助损失(Fedus 等,2022)抑制这个反馈:
其中 f_i 是分派到专家 i 的 token 比例,P_i 是该 batch 中专家 i 的平均路由概率。完全均衡时 f_i = P_i = 1/E,和为 E \cdot E \cdot (1/E^2) = 1,损失为 \alpha;Switch 使用 \alpha = 10^{-2}。计数 f_i 不可微,梯度通过 P_i 传播:\partial\mathcal{L}_{\text{aux}}/\partial P_i = \alpha E f_i,最忙专家的梯度最大。
容量。 容量受限路由器在一个含 B_{\text{tok}} token 的路由组 batch 中,每个专家最多处理 \mathrm{CF}\cdot kB_{\text{tok}}/E 次分配,CF 为容量因子。该策略丢弃溢出的分配;没有任何保留分配的 token 只沿残差路径传播。其他路由器可采用无丢弃调度。比较前应说明策略。
E = 4 的负载均衡损失:f = (0.55, 0.15, 0.15, 0.15) 和 P = (0.50, 0.167, 0.167, 0.167) 得到 E\sum_i f_i P_i = 4 \times (0.275 + 3 \times 0.025) = 1.40,完全均衡时则为 1.00。P_1 上的梯度正比于 f_1 = 0.55,为其他专家的 3.7 倍,因此专家 1 的路由概率下降最快。
整个路由组共有 8,192 token,k = 2、E = 8、\mathrm{CF} = 1.25,每个专家有 1.25 \times 2 \times 8{,}192/8 = 2{,}560 个槽位。若某专家得到 16,384 次路由分配中的 30%,即 4,915 次,就会丢弃 4{,}915 - 2{,}560 = 2{,}355 次,近一半分配失去该专家贡献。另一个选中专家若接受这个 token,它仍会获得那部分输出。
后续两项概念性改进:DeepSeek-V3 主要不靠辅助损失均衡负载,而仅在 top-k 选择的路由分数中加入每专家偏置,不改合并输出的权重。每步后降低过载专家偏置、提高空闲专家偏置,使均衡机制不再干扰语言建模梯度。DeepSeekMoE 把专家拆成许多较小专家,每 token 路由到更多专家,并增加所有 token 都经过的共享专家,避免各专家重复存储常识。
何时采用 MoE。 应比较实测激活运算量、全部专家存储和路由通信。Mixtral 8x7B 的已发表计数为总量 46.7B、激活 12.9B;DeepSeek-V3 为 671B、37B。激活参数量本身不能预测延迟或等效密集模型损失。案例保留密集模型,避免专家路由,使每个副本可在一个节点内分片。
跨宽度迁移学习率:muP
标准参数化下,最优学习率随宽度变化,所以宽度 256 的扫描结果不能直接用于 4,096。原因在 Adam 的归一化更新:\Delta\mathbf{W} 每个元素大小约为 \eta,基本不依赖梯度尺度(第 02 模块,第 8 节)。对扇入为 n 的隐藏矩阵,梯度是外积 \boldsymbol{\delta}\mathbf{x}^\top,所以 \Delta W_{ji} 的符号为 -\mathrm{sign}(\delta_j)\,\mathrm{sign}(x_i),同一输入对应的输出变化为
这 n 项同向累加,因此变化按 \eta n 增长,而不是随机符号和的 \eta\sqrt{n}。若要在宽度增长时保持一阶变化不变,隐藏矩阵需采用 \eta \propto 1/n。muP(最大更新参数化)(Yang 等,2021)结合相应初始化和输出缩放构建 logits,使窄代理模型上的最优学习率可迁移到宽模型。
宽度 256 的扫描找到最优隐藏矩阵学习率 1 \times 10^{-2}。宽度 4,096 时,扇入扩大 16 倍,muP 对隐藏矩阵设 1 \times 10^{-2} \times 256/4{,}096 = 6.25 \times 10^{-4};嵌入与输出层遵循其他规则。
实际替代方法包括对最优学习率和 batch 大小随计算量拟合幂律(DeepSeek LLM,2024),或在两三个规模上做简单扫描。
为什么 MoE 内存由总参数决定,而 FLOP 由激活参数决定?
查看答案
全部专家的权重、梯度和优化器状态都必须存储在某些 GPU 上,但每个 token 只经过 k 个专家,只有这些专家的权重参与其矩阵乘法。
在辅助损失中 f_i 是不可微的。损失如何仍然平衡负载?
查看答案
梯度通过 P_i 传播,由 f_i 加权:\partial\mathcal{L}_{\text{aux}}/\partial P_i = \alpha E f_i。收到最多 token 的专家,路由概率下降最多,从而将 token 分流到其他专家。
为什么在 Adam 的标准参数化下,在宽度 256 处调整的学习率必须在宽度 4,096 处下降?
查看答案
Adam 的每个更新元素大小约固定为 \eta。更宽矩阵让更多更新项同向累加到各输出,因此相同 \eta 带来约 n 倍输出变化。保持变化不变需要 \eta \propto 1/n。
优化方案:AdamW、调度与 batch 大小
预训练会把一套优化器设置保持数周,不能靠昂贵主训练本身逐项调参。本节为案例计划确定各设置并解释原因。算法来自 第 02 模块;新挑战是约五十万步、每步数百万 token 的规模,而且没有轻易重来一次的机会。
预训练中的 AdamW 设置
更新公式(第 02 模块,第 8 节),梯度为 \mathbf{g},偏差校正后的矩为 \hat{\mathbf{m}}、\hat{\mathbf{v}},解耦权重衰减为 \lambda:
预训练采用 \beta_1 = 0.9、\beta_2 = 0.95、\epsilon = 10^{-8}、\lambda = 0.1,只对权重矩阵做权重衰减,不对归一化增益或偏置衰减;许多方案也不对嵌入衰减。
为什么采用 \beta_2 = 0.95,而非 0.999。 二阶矩平均约记住 1/(1-\beta_2) 步:0.95 对应 20 步,0.999 对应 1,000 步。记忆过长时,梯度尺度突然上升,却遇到陈旧而偏小的 \mathbf{v},使更新 \hat{\mathbf{m}}/\sqrt{\hat{\mathbf{v}}} 过大。
某权重的梯度 RMS 为 10^{-3},于是 v = 10^{-6};因梯度符号不断改变,m 接近零。随后出现一次 10^{-2} 的梯度,此时 m = 0.1 \times 10^{-2} = 10^{-3}。忽略在训练后期已接近 1 的偏差校正:
- \beta_2 = 0.999:v = 0.999 \times 10^{-6} + 0.001 \times 10^{-4} = 1.099 \times 10^{-6},\sqrt{v} = 1.048 \times 10^{-3},更新为 \eta\,m/\sqrt{v} = 0.954\,\eta。
- \beta_2 = 0.95:v = 0.95 \times 10^{-6} + 0.05 \times 10^{-4} = 5.95 \times 10^{-6},\sqrt{v} = 2.44 \times 10^{-3},更新为 0.410\,\eta。
若梯度持续扩大十倍,v_t = 10^{-4} - 0.99 \times 10^{-4}\,\beta_2^{\,t} 在 \beta_2^{\,t} = 0.505 时达到新水平的一半:0.95 需 14 步,0.999 需 683 步。与此同时,m 约 20 步便跟上;因此 0.999 下更新在第 19 步增到 5.1\,\eta,300 步后仍为 1.9\,\eta,而 0.95 下从不超过 1.1\,\eta。
\epsilon。 大型或深层模型、训练后期的参数梯度 RMS 可能降至 \epsilon,这时分母 \sqrt{\hat{v}} + \epsilon 被 \epsilon 主导,无意中抑制更新。Wortsman 等(2024)因此把 \epsilon 降到约 10^{-15}。Llama 2 使用 10^{-5};10^{-8} 则是常见默认值。
权重衰减的时间尺度。 每步解耦衰减将需衰减权重乘以 (1 - \eta\lambda),因此权重约在 1/(\eta\lambda) 步内忘记初值。应将该时间尺度与训练长度比较。
\eta = 3 \times 10^{-4}、\lambda = 0.1 对应 1/(\eta\lambda) = 33{,}333 步。案例计划共 508,626 步,若一直保持峰值学习率,相当于 15 个时间尺度;对下方平均速率为峰值 55% 的衰减调度积分,约为 8.4,单靠衰减便将初始权重缩小到 e^{-8.4} = 2 \times 10^{-4}。实验 2 的 \eta = 3 \times 10^{-3} 对应 3,333 步,长于其 600 步训练,所以权重衰减在那里作用很小。
学习率与调度
峰值学习率是训练中最重要的数值,通过小规模扫描加 muP 或拟合缩放规则(第 5 节)确定;大模型通常需更低峰值。可参考已发表方案:Llama 2 的 7B、13B 采用峰值 3 \times 10^{-4},34B、70B 采用 1.5 \times 10^{-4};预热 2,000 步,余弦衰减到峰值的 10%,batch 为 4M token,裁剪阈值 1.0。7–10B 可预期 1 \times 10^{-4}–3 \times 10^{-4},更大模型通常更低。
预热(warmup)在最初 1,000–2,000 步线性提高学习率,原因有三:Adam 的 \mathbf{v} 即使校正偏差,初始样本仍太少;早期梯度大,初始化附近曲率高;最初几步若直接使用完整学习率,可能把模型推到无法离开的区域(实验 3 展示了类似情况)。
预热加余弦衰减,设预热 T_w 步、总计 T 步,\eta_{\min} = 0.1\,\eta_{\max}:
弱点是 T:训练开始前就固定终点。提前停止时尚未完成衰减,延长训练时却已衰减到底。
预热—稳定—衰减(WSD)先预热,大部分训练保持峰值,最后 10%–20% 步数再衰减到接近零。相同预算下可匹敌余弦调度(Hägele 等,2024;MiniCPM 推广了它),且无需预定终点:可以延长训练,或从任意稳定阶段检查点分支衰减,一次训练得到多个预算的模型。衰减期间损失明显下降,是步长缩小时噪声被平均的结果,而非学到新知识;因此最后阶段之前,WSD 可能看起来比余弦更差。
计算得到的 10,000 步学习率调度:预热后余弦衰减至峰值的 10%,WSD 最后 20% 线性衰减至零,以及无预热的恒定学习率。预热在第 500 步结束。这些是调度曲线,不是实测损失曲线。
全局 batch 含 480 条 8,192 token 序列,每步 3{,}932{,}160 token,接近 Llama 2 的 4M。2T token 计划因此需 2 \times 10^{12}/3{,}932{,}160 = 508{,}626 步。预热 2,000 步,占训练 0.4%,达到峰值 3 \times 10^{-4},再余弦衰减至 3 \times 10^{-5}:
| 步数 | 阶段 | 学习率 |
|---|---|---|
| 1,000 | 预热进行到一半 | 1.5 \times 10^{-4} |
| 2,000 | 峰值 | 3.0 \times 10^{-4} |
| 127,000 | 衰减进程约四分之一 | 2.61 \times 10^{-4} |
| 254,313 | 训练中点 | 1.66 \times 10^{-4} |
| 381,000 | 衰减进程约四分之三 | 7.0 \times 10^{-5} |
| 508,626 | 结束 | 3.0 \times 10^{-5} |
例如第 127,000 步,衰减进度为 (127{,}000 - 2{,}000)/506{,}626 = 0.247,\cos(0.247\pi) = 0.714,\eta = 3 \times 10^{-5} + 0.5 \times 2.7 \times 10^{-4} \times 1.714 = 2.61 \times 10^{-4}。
同一调度的代码形式,供训练循环每步调用:
import math


def lr_at(step, peak=3e-4, warmup=2_000, total=508_626, floor_frac=0.1):
    """Linear warmup to `peak`, then cosine decay to floor_frac * peak at `total`."""
    if step < warmup:
        return peak * step / warmup
    progress = (step - warmup) / (total - warmup)
    floor = floor_frac * peak
    return floor + 0.5 * (peak - floor) * (1 + math.cos(math.pi * progress))


for step in (1_000, 2_000, 127_000, 254_313, 381_000, 508_626):
    print(f"{step:>7,}  {lr_at(step):.2e}")
  1,000  1.50e-04
  2,000  3.00e-04
127,000  2.61e-04
254,313  1.66e-04
381,000  7.01e-05
508,626  3.00e-05
batch 大小与临界 batch
Batch 以 token 计:9B 规模常为每步 1M–4M token,有时在训练中逐步增大。McCandlish 等(2018)推导了多大 batch 有用。采用当前权重附近损失的二次近似,真实梯度 \mathbf{G}、Hessian \mathbf{H}、每 token 梯度协方差 \boldsymbol{\Sigma}。在 B token 的 batch 上执行普通 SGD 更新 -\eta\hat{\mathbf{G}},其中 \hat{\mathbf{G}} 的均值为 \mathbf{G}、协方差为 \boldsymbol{\Sigma}/B。展开至二阶,对 batch 取平均,并使用 \mathbb{E}[\hat{\mathbf{G}}^\top\mathbf{H}\hat{\mathbf{G}}] = \mathbf{G}^\top\mathbf{H}\mathbf{G} + \operatorname{tr}(\mathbf{H}\boldsymbol{\Sigma})/B:
令关于 \eta 的导数为零,得到最优步长及每步最优损失变化:
其中 \Delta L_{\max} = -\lVert\mathbf{G}\rVert^4/(2\,\mathbf{G}^\top\mathbf{H}\mathbf{G}) 是无限 batch 能达到的效果,梯度噪声尺度为
当 \mathbf{H} 接近单位矩阵的倍数时可作上述近似。McCandlish 等用 \epsilon 表示学习率;这里用 \eta,避免与 Adam 的 \epsilon 混淆。Batch 为 B 时,每步达到最大可能进展的 1/(1 + B_{\text{noise}}/B),所以达到给定损失需要
其中 D_{\min} = S_{\min}B_{\text{noise}}。McCandlish 等用 E 表示样本数;这里用 D 保留本模块的 token 记号,因为 E 已表示 第 5 节 中的专家数。把两项超额部分相乘,得到 (S/S_{\min} - 1)(D/D_{\min} - 1) = (B_{\text{noise}}/B)(B/B_{\text{noise}}) = 1,即用步数换 token 的双曲线。临界 batch 大小 B_{\text{crit}} = B_{\text{noise}} 处,两者均为各自最小值的两倍。损失下降时,平均梯度缩小快于噪声,B_{\text{noise}} 随之增大,这为训练中增大 batch 提供理由。
对于 B_{\text{noise}} = 2\text{M} token、S/S_{\min} = 1 + 2\text{M}/B 和 D/D_{\min} = 1 + B/2\text{M}:
| batch B (token) | 0.25M | 0.5M | 1M | 2M | 4M | 8M | 16M |
|---|---|---|---|---|---|---|---|
| 步数,S/S_{\min} | 9.0 | 5.0 | 3.0 | 2.0 | 1.5 | 1.25 | 1.125 |
| token, D/D_{\min} | 1.125 | 1.25 | 1.5 | 2.0 | 3.0 | 5.0 | 9.0 |
低于 B_{\text{noise}} 时,batch 加倍几乎让步数减半,只增加少量数据;高于该值后,每次加倍节省的步数越来越少,额外数据成本却越来越高。
达到固定损失所需步数与 token 的关系,在双对数坐标中绘制 D/D_{\min} 对 S/S_{\min} 的曲线:双曲线 (S/S_{\min} - 1)(D/D_{\min} - 1) = 1,batch 为 0.25M、0.5M、1M、2M、4M、8M、16M token 的点位于 B_{\text{noise}} = 2\text{M}。临界 batch 标在 (2, 2);小 batch 一端数据效率高,大 batch 一端时间效率高。
梯度累积将 batch 大小与内存需求解耦:一次优化器更新前,累加多个 micro-batch 的梯度。全局 batch 为 micro-batch × 累积步数 × 数据并行度(第 9 节)。
学习率随 batch 一起调整。 低于临界 batch 时,更大 batch 可容忍更大学习率;SGD 大致按比例增长,Adam 更接近平方根增长。上方推导假设普通 SGD,因此用于 Adam 时应视为经验模型,通过扫描确认。
对于 \beta_2 = 0.95,Adam 的二阶矩估计大约记住了多少步?
查看答案
约 1/(1-\beta_2) = 20 步,因此可在几十步内适应梯度尺度变化;若为 0.999,则约记住一千步。
WSD 调度允许哪些余弦调度难以做到的操作?
查看答案
可随时延长训练或决定结束。稳定阶段不依赖预定终点,可从任意稳定检查点分支衰减,因此一次训练可产生多个预算的模型。
在 B = B_{\text{crit}} 处,与最小值相比,一次运行需要多少步数和 token?
查看答案
均为两倍:S/S_{\min} = 1 + B_{\text{noise}}/B = 2、D/D_{\min} = 1 + B/B_{\text{noise}} = 2。
稳定性与精度:裁剪、z-loss、QK-norm、bf16 与 fp8
长期训练必须避免发散。两个因素影响稳定性:运算采用的数值格式,以及对损失和模块的小幅修改,使数值保持在格式可表示范围内。每项修改针对具体失败机制,理解机制才知道何时采用。
格式
浮点数有符号位、决定范围的指数位及决定精度的尾数位。尾数有 m 位时,x 附近相邻数值间距约为 x \cdot 2^{-m}。
| 格式 | 符号 / 指数 / 尾数位数 | 最大值 | 最小正规值 | 相对间距 |
|---|---|---|---|---|
| FP32 | 1 / 8 / 23 | 3.4 \times 10^{38} | 1.2 \times 10^{-38} | 2^{-23} \approx 1.2 \times 10^{-7} |
| fp16 | 1 / 5 / 10 | 65,504 | 6.1 \times 10^{-5};次正规值可低至 6.0 \times 10^{-8} | 2^{-10} \approx 9.8 \times 10^{-4} |
| BF16 | 1 / 8 / 7 | 3.4 \times 10^{38} | 1.2 \times 10^{-38} | 2^{-7} \approx 7.8 \times 10^{-3} |
| fp8 E4M3FN | 1 / 4 / 3 | 448 | 1.6 \times 10^{-2} | 2^{-3} = 0.125 |
| FP8 E5M2 | 1 / 5 / 2 | 57,344 | 6.1 \times 10^{-5} | 2^{-2} = 0.25 |
bf16 有 7 个小数尾数位,fp32 有 23 个;两者指数位数相同,但 bf16 精度更低。fp16 把位数分配到另一方向,比 bf16 多三位尾数,但最大值仅 65,504。第 10 模块,第 7 节 在推理时使用相同格式。
fp32、fp16、bf16、E4M3FN 和 E5M2 的位数分配与正数可表示范围,包括次正规值。左侧箭头表示低于图示下界的范围。2\times10^{-8} 梯度小于 fp16 最小次正规值;乘以 65,536 后移到 1.31\times10^{-3}。
运行时的混合精度
典型方案:bf16 输入做矩阵乘法,张量核心内采用 fp32 累加;保留 fp32 主权重和优化器状态;softmax、归一化及损失用 fp32 计算。保留主权重,是因为直接给 bf16 权重加上微小更新会被舍入掉。
[2^{-6}, 2^{-5}) 中一个权重为 0.02,bf16 的 7 位尾数给出间距 2^{-6} \times 2^{-7} = 2^{-13} = 1.22 \times 10^{-4}。训练后期学习率 3 \times 10^{-5},归一化 Adam 更新约为 1,实际更新为 3 \times 10^{-5},小于半个间距,因此 6.1 \times 10^{-5}。每步更新都被舍入成零,权重始终不动。fp32 在 0.02 附近间距为 2^{-6} \times 2^{-23} = 1.9 \times 10^{-9},可以保留该更新。
import torch

w_bf16 = torch.tensor(0.02, dtype=torch.bfloat16)
w_fp32 = torch.tensor(0.02, dtype=torch.float32)
update = 3e-5                       # late-run learning rate x an Adam step of about 1

print(f"bf16 stores 0.02 as {w_bf16.item():.11f}")
print(f"bf16 after update:  {(w_bf16 + update).item():.11f}")   # unchanged
print(f"fp32 after update:  {(w_fp32 + update).item():.11f}")   # moved by 3e-5
bf16 stores 0.02 as 0.02001953125
bf16 after update:  0.02001953125
fp32 after update:  0.02002999932
fp16 与损失缩放。 fp16 精度高于 bf16,范围却很窄:小于最小次正规值约一半的梯度会舍入成零,有些 kernel 还会把次正规值直接置零;注意力分数或激活超过 65,504 则溢出为无穷。损失缩放(Micikevicius 等,2018)在反向前将损失乘以缩放系数 s,使所有梯度扩大 s 倍并可表示,再在更新前除以 s。动态缩放自动选择 s:梯度出现 inf 或 NaN 时将 s 减半并跳过更新;连续若干干净步骤后将 s 加倍,PyTorch 默认间隔 2,000 步。bf16 与 fp32 有相同指数位数,常用方案无需 fp16 式损失缩放,这是现代训练更稳定的重要原因。
2 \times 10^{-8} 梯度低于 fp16 最小次正规值 2^{-24} = 5.96 \times 10^{-8} 的一半,所以舍入为零。使用 s = 65{,}536 = 2^{16} 后,计算得到 2 \times 10^{-8} \times 65{,}536 = 1.31 \times 10^{-3},可轻松表示,再在更新前以 fp32 除以 s。
fp8。 较新训练方案(截至 2026 年)仅对大型矩阵乘法进一步降低精度。精度较高的 E4M3 保存前向权重和激活;一些方案用范围更大的 E5M2 保存梯度。最大值分别只有 448、57,344,因此每个张量都需缩放系数,可根据近期最大绝对值历史设置一个,或像 DeepSeek-V3 按块设置:激活采用 1 \times 128 块,权重采用 128 \times 128 块,乘积以更高精度累加。归一化、softmax、损失和优化器仍保留较高精度。需审慎验证,目前尚非通用默认方案。
梯度裁剪
当其范数超过阈值 c(通常为 1.0)时,按全局范数进行裁剪会在所有参数上重新缩放整个梯度:
c = 1.0 时,全局范数 4.0 会让所有梯度乘以 0.25,方向保持不变。记录被裁剪步骤的比例。裁剪应处理偶发尖峰;若多数步骤都裁剪,实际有效学习率低于调度值,可能掩盖持续问题。
z-loss
交叉熵只取决于 logits 差值。对 logits \mathbf{z}、目标 y,损失为 -z_y + \log Z,其中 Z = \sum_j e^{z_j}。给每个 logit 加常数 c,两项都会增加 c 并抵消。损失不约束 logits 整体水平,因而它可能漂移;较大 logits 在 bf16 中会损失精度,不稳定的指数实现还可能溢出。z-loss 把 \log Z 拉向零。采用 \partial\log Z/\partial z_j = e^{z_j}/Z:
Logit 30 位于 [16, 32),bf16 间距为 16 \times 2^{-7} = 0.125,附近只能以 0.125 为步长变化,每步改变概率比 e^{0.125} = 1.13。4–8 附近的间距为 4 \times 2^{-7} = 0.031。若 \log Z = 30、系数 10^{-4},z-loss 为每个 logit 梯度加入 2 \times 10^{-4} \times 30 = 6 \times 10^{-3} 乘以 \softmax(\mathbf{z})_j,持续将其拉回 \log Z = 0;单独交叉熵没有这种约束。
代码中,z-loss 只是交叉熵旁的一行;演示展示它如何约束交叉熵不敏感的整体平移:
import torch
import torch.nn.functional as F


def lm_loss(logits, targets, z_coef=1e-4):
    """Cross-entropy plus z-loss. logits: (B, T, V), maybe bf16; targets: (B, T)."""
    logits = logits.float()                     # the loss is computed in fp32
    log_z = torch.logsumexp(logits, dim=-1)     # (B, T): log of the normaliser Z
    ce = F.cross_entropy(logits.flatten(0, 1), targets.flatten())
    return ce + z_coef * (log_z ** 2).mean()


torch.manual_seed(0)
logits = torch.randn(2, 8, 50, dtype=torch.bfloat16)
targets = torch.randint(0, 50, (2, 8))
shifted = logits.float() + 30.0                 # same softmax, log Z larger by 30
for name, z in (("original", logits), ("shifted by 30", shifted)):
    ce = F.cross_entropy(z.float().flatten(0, 1), targets.flatten())
    print(f"{name:>13}: cross-entropy {ce:.4f}, with z-loss {lm_loss(z, targets):.4f}")
     original: cross-entropy 4.4256, with z-loss 4.4277
shifted by 30: cross-entropy 4.4256, with z-loss 4.5448
QK 归一化与注意力 logit 增长
注意力 logits 为 \mathbf{q}\cdot\mathbf{k}/\sqrt{d_h},本身没有上界。训练中查询和键投影增大,会放大 logits,使 softmax 过度集中、注意力熵下降,训练可能停滞或发散(Dehghani 等,2023;Wortsman 等,2024)。QK-norm 在点积前,对每头的 \mathbf{q}、\mathbf{k} 使用带可学习增益的 RMSNorm。维度 d_h、单位 RMS 的向量长度为 \sqrt{d_h},因此
再乘以可学习增益。其他概念性稳定措施包括更低峰值学习率、更长预热、移除偏置、输出头前归一化,以及对残差投影使用缩放初始化。
在小模型上测试修复
Wortsman 等(2024)表明,高学习率小模型可重现大模型的不稳定,允许廉价测试缓解方法:用多个学习率训练,绘制最终损失,考察学习率敏感性,即偏离最优学习率后损失恶化多快。实验 3 在笔记本上进行该实验,同样发现高学习率下注意力 logit 增长导致不稳定;QK 归一化抑制了增长,单独预热、裁剪或 z-loss 则未解决。
当前环境中,3\times10^{-3} 的 150 步参考运行,最后 20 步平均损失为 4.273,最终 batch 的最大注意力 logit 为 28.4。3\times10^{-2} 时,损失为 5.234、logit 为 971.7。逐项累加预热、裁剪、z-loss 后,损失为 5.389–5.549,logit 为 753–1,138;再加 QK 归一化后降为 4.786、12.4。四项措施在参考学习率下共同使用时,损失为 4.024。这是受控训练诊断,不是九个留出评估检查点的比较。
为什么典型的 bf16 配方避免了 fp16 式的损失缩放?
查看答案
bf16 有 8 位指数,可以表示小得多的数,但极小值仍可能下溢。fp16 只有 5 位指数,最小正次正规值约 6 \times 10^{-8}。采用渐进下溢和舍入到最近值时,低于最小间距一半的数舍入为零;部分 kernel 还会把次正规值直接置零。
z-loss 约束了交叉熵未约束的什么量?
查看答案
Logits 的整体水平 \log Z。交叉熵只依赖差值,对所有 logits 的共同平移不敏感。
某次训练有 95% 步骤被裁剪,这说明什么?
查看答案
有效学习率主要由裁剪阈值而非调度决定,学习率、数据或某层可能持续产生大梯度。应找出原因,而非直接提高阈值。
内存核算
配置能否放进 GPU,应先计算再试运行。训练步骤需要四类内存:模型状态(权重、梯度、优化器状态)、反向所需激活、logits 和各类缓冲区。本节逐项核算案例模型。单位约定:GB 为 10^9 字节,GiB 为 2^{30} 字节;本模块采用 GB,其他模块复用的数值旁也给出 GiB。
模型状态:每个参数 16 个字节
两种计算得到相同结果。(a) bf16 混合精度加 Adam:bf16 权重 2、bf16 梯度 2、fp32 主权重 4、Adam 一阶矩 4、二阶矩 4,合计每参数 16 字节。(b) PyTorch 采用 fp32 参数加 autocast:fp32 权重 4、梯度 4、\mathbf{m} 4、\mathbf{v} 4,合计 16;bf16 权重副本临时生成。变体包括 fp32 梯度或累积缓冲区再加 2,得到 18 字节;8 位优化器状态为 2 + 2 + 4 + 1 + 1 = 10 字节;带动量 SGD 只保存 4 字节状态,而 Adam 为 8 字节。ZeRO 论文将规则写为 2 + 2 + K、K = 12。
16 \times 9.551 \times 10^9 = 152.8 GB,即 142.3 GiB:bf16 权重和梯度各 19.1 GB,fp32 主权重及两个 Adam 矩各 38.2 GB。尚未保存任何激活,单张 80 GB GPU 就已经放不下。
激活
反向传播需要每层矩阵乘法及非线性操作的输入(第 02 模块)。案例块采用 FlashAttention、无 dropout,bf16 下每层每 token 保存:
| 保存的张量 | 字节 |
|---|---|
| 两个 RMSNorm 的输入 | 2 \times 2d |
| Q、K、V 投影的输入 | 2d |
| Q | 2d |
| K 和 V | 2 \times 2h_{kv} |
| 注意力输出,即 O 的输入 | 2d |
| MLP 的输入 | 2d |
| SwiGLU 门控、上投影及二者乘积 | 3 \times 2d_{\text{ff}} |
| 总计 | 12d + 4h_{kv} + 6d_{\text{ff}} |
案例中共 12 \times 4{,}096 + 4 \times 1{,}024 + 6 \times 15{,}360 = 145{,}408 字节,即 35.5d。不同实现因融合或重计算策略可相差约 20%。Korthikanti 等(2023)对原始 GPT 块的计数为 34sbh 字节,其中 s 为序列长度,b 为 batch,h 为宽度;dropout 掩码和 GELU 带来不同项,但总量相近。
若不用 FlashAttention,每层 softmax 概率再加 2n_hT^2 字节,dropout 掩码还需更多。FlashAttention 在反向时分块重算,去掉 T^2 项。以 fp32 计算损失的 logits 再加 T \times V \times 4 字节,常是单步最大的单个张量;分块或融合交叉熵可避免同时生成全部 logits。
激活共 145{,}408 \times 8{,}192 \times 36 = 42.9 GB,每层 1.19 GB;fp32 logits 为 8{,}192 \times 152{,}064 \times 4 = 4.98 GB。若不用 FlashAttention,bf16 注意力概率每层再需 2 \times 32 \times 8{,}192^2 = 4.29 GB,全部层合计 155 GB。
激活检查点
激活检查点也称梯度检查点,只保存每层输入,每层每 token 2d 字节,在反向时重算该层前向。内存由全部保存输入及一层激活构成。代价是多一次前向:每 token 训练由三次前向等价量变为四次,约增加三分之一。选择性检查点只重算廉价且占内存大的部分,例如注意力分数和激活函数。每 \sqrt{L} 层保存一个分段检查点(Chen 等,2016),以相同的一次额外前向代价获得 O(\sqrt{L}) 内存复杂度。
保存层输入需 2 \times 4{,}096 \times 8{,}192 \times 36 = 2.42 GB,逐层重算时再需 1.19 GB;合计 3.61 GB,而非 42.9 GB,计算量增加约三分之一。
其余内存用于通信缓冲区、临时工作区和分配器碎片,应预留 5%–10%。将优化器状态卸载到 CPU 内存的 ZeRO-Offload 可缓解容量,却较慢。推理则只需每参数 2 字节的 bf16 权重,案例为 19.1 GB,再加 KV cache(第 10 模块)。
案例模型内存在单张 80 GB GPU 上的堆叠条形图:bf16 权重 19.1 GB、梯度 19.1 GB,fp32 主权重及两个 Adam 矩各 38.2 GB,模型状态共 152.8 GB;一条 8,192 token 序列再需激活 42.9 GB、fp32 logits 5.0 GB。第二条采用完整激活检查点,激活降为 3.6 GB。两条都超过 80 GB 虚线,这解释了 第 9 节 的必要性。
模型状态为 5.8\text{M} \times 16 字节,即 = 93 MB。实验在 CPU 用 fp32 运行,对应没有 bf16 副本的方案 (b)。对 16 \times 256 token 的 batch,激活按每值 4 字节计约 0.4 GB,logits 为 67 MB,笔记本即可轻松容纳,所以 实验 2 可省略本节全部节省内存技术。
bf16 混合精度加 Adam 的每参数 16 字节分别用在哪里?
查看答案
2 用于 bf16 权重,2 用于 bf16 梯度,4 用于 fp32 主权重,4 + 4 用于 Adam 的两个矩。
为什么激活检查点的计算成本比原来高出大约三分之一而不是两倍?
查看答案
仅重复前向传播:每个 token 的 6N FLOP 的 2N,因此训练成本为 8N 而不是 6N。
数据并行、ZeRO 和 FSDP
案例的 152.8 GB 模型状态无法放进单张 GPU;2T token 计划的约 84,500 GPU 小时也要在数周内完成,而非数年。把同一模型的训练分到多张 GPU 可解决两类问题。本节从复制或分片模型状态的方法开始;第 10 节 再切分层本身。
数据并行与环形 all-reduce
数据并行中,每张 GPU 保存完整模型,处理全局 batch 的一部分。更新前,通过 all-reduce 在 GPU 间平均梯度,让各副本权重保持相同。限制是每张 GPU 都需容纳完整模型。
All-reduce 常用环形实现。将 N_d 张 GPU 排成环,把 S 字节缓冲区分成 N_d 块。在 reduce-scatter 阶段的 N_d - 1 步中,每张 GPU 每步向邻居发送一块 S/N_d 字节,将收到的块加到本地副本,再转发刚累加的块。N_d - 1 步后,每张 GPU 持有一个已跨全部 GPU 求和的块。all-gather 阶段再经 N_d - 1 步传递这些块,直到各 GPU 持有全部求和结果。每张 GPU 发送及接收量均为
各链路同时工作,若每张 GPU 的链路带宽为 \mathrm{BW},时间约为 2S/\mathrm{BW},几乎不依赖 GPU 数;只有步数及对应延迟随 N_d 增长。框架将梯度分桶,在反向生成某桶后立即归约,使大部分通信与计算重叠。
四 GPU 环形 all-reduce。Reduce-scatter 表标出每个步骤接收的块及已贡献的 GPU 编号;all-gather 表列出每步后已知的完整求和块。每張 GPU 共发送六个四分之一大小的块,对 S 字节梯度,共发送 1.5S 字节。
带宽数量级(截至 2026 年的典型值):8 GPU H100 节点内,NVLink 每 GPU 单向约 450 GB/s,双向共 900 GB/s;节点间 InfiniBand 或 RoCE 每 GPU 约 50 GB/s,即 400 Gb/s。约九倍差距影响并行布局选择。
案例的 bf16 梯度为 S = 2 \times 9.551 \times 10^9 = 19.1 GB。一个节点内(N_d = 8),每 GPU 发送 2 \times 7/8 \times 19.1 = 33.4 GB,按 450 GB/s 需 0.074 秒;80 GPU 间每 GPU 发送 2 \times 79/80 \times 19.1 = 37.7 GB,按 50 GB/s 需 0.75 秒。2T token 计划每优化器步的计算时间约 7.5 秒(第 10 节)。通信可被计算隐藏,内存需求却无法隐藏,因为各 GPU 仍需 152.8 GB。
ZeRO:对模型状态进行分片
ZeRO(Rajbhandari 等,2020)保留数据并行,但停止复制无需复制的状态。设模型有 N 个参数,分布到 N_d 张 GPU,论文将并行度写为 \Psi;优化器状态每参数 K = 12 字节。各阶段逐步分片每参数 16 字节中的更多部分:
| 策略 | 分片内容 | 每 GPU 内存 | 案例,8 张 GPU |
|---|---|---|---|
| 数据并行 | 无 | 16N | 152.8 GB |
| ZeRO-1 | 优化器状态 | 4N + 12N/N_d | 52.5 GB |
| ZeRO-2 | 再加梯度 | 2N + 14N/N_d | 35.8 GB |
| ZeRO-3 | 再加权重 | 16N/N_d | 19.1 GB |
80 张 GPU 上,ZeRO-3 每 GPU 只需 1.9 GB 模型状态。通信由各 GPU 持有的内容决定。阶段 1、2 中,各 GPU 只更新自己的 1/N_d 参数,因此对梯度做 reduce-scatter,让各 GPU 收到自身分片的总和,再 all-gather 更新后的 bf16 权重;每步 N + N = 2N 个元素,与数据并行 all-reduce 相同。阶段 3 还分片权重,因此每层在前向和反向之前各 all-gather 一次,再对梯度 reduce-scatter,共 3N,是数据并行的 1.5 倍。
根据 第 8 节,每张 GPU 再加入一条 8,192 token 序列:激活 42.9 GB,完整检查点时为 3.61 GB;logits 为 4.98 GB。
- ZeRO-3:19.1 + 42.9 + 5.0 = 67.0 GB,可容纳,余约 13 GB;完整检查点下为 19.1 + 3.6 + 5.0 = 27.7 GB。
- ZeRO-2:35.8 + 42.9 + 5.0 = 83.7 GB,无法容纳;完整检查点下为 44.4 GB。
- ZeRO-1:无检查点时 100.4 GB,有检查点时 61.1 GB。
无检查点时只有 ZeRO-3 可容纳;采用检查点后,ZeRO-1 和 ZeRO-2 也能容纳。
案例在八张 GPU 上的每 GPU 总内存估计:DP、ZeRO 阶段 1–3,分别采用或不采用完整激活检查点。各条包含模型状态、一条 8,192 token 序列的激活和 fp32 logits。80 GB 线未包含运行时余量。按简化估计,阶段 3 即使不用检查点也可容纳。
FSDP 和混合分片
FSDP(完全分片数据并行)是 PyTorch 对阶段 3 的实现。模型划分成单元,通常每个单元为一个 Transformer 块;使用前 all-gather 权重,使用后释放,当前单元计算时预取下一单元。梯度累积是一个陷阱:默认每个 micro-batch 都两次聚集权重并对梯度 reduce-scatter,因此每步通信量随 micro-batch 数增长。若将 reduce-scatter 延到最后一个 micro-batch,各 GPU 就需保存未分片梯度;若跨 micro-batch 保留聚集权重,则保存未分片权重副本。两者都会消耗原本想靠分片节省的内存。
混合分片(HSDP)在节点内通过 NVLink 分片,跨节点复制。每个优化器步骤,GPU 的梯度分片与其他节点对应分片做 all-reduce,而频繁的聚集始终留在节点内。第 10 节 解释案例为何采用此布局。
全局 batch
第 6 节 的全局 batch 由布局决定:
案例在 80 GPU 上每步 480 序列,即每 micro-batch 1 序列 × 累积 6 步 × 80。第 14 节 在单节点继续预训练采用 1 × 16 × 8 = 128。并行布局和 batch 大小必须一同选择。
为什么 GPU 数增加时,环形 all-reduce 的每 GPU 流量几乎不增长?
查看答案
每 GPU 发送缓冲区大小的 2(N_d - 1)/N_d,极限接近 2S;GPU 更多意味着更多步骤、每块更小,而非每 GPU 发送更多字节。
ZeRO-3 为获得 1/N_d 内存付出什么代价?
查看答案
反向前多一次权重 all-gather,每步 3N 个元素,而数据并行为 2N,即 1.5 倍;每层还需等待聚集,除非通过预取隐藏。
张量、流水线与上下文并行:选择布局
数据并行和状态分片分配模型副本及训练状态,却不自动切分单个大层的计算或激活内存。其他并行维度切分层、层堆栈或序列。收益取决于当前限制:内存容量、计算还是通信。
沿其自然维度分割前馈网络
对 \mathbf{Y}=\phi(\mathbf{X}\mathbf{A}),将 \mathbf{A} 的输出列切分为 [\mathbf{A}_1,\mathbf{A}_2],每个设备计算自己的 \mathbf{Y}_i=\phi(\mathbf{X}\mathbf{A}_i)。逐元素激活不混合这些列,因此无需交换。SwiGLU 的门控与上投影必须以相同方式分列,保证逐元素乘积使用对应特征。
后续 \mathbf{Z}=\mathbf{Y}\mathbf{B} 将 \mathbf{B} 的行切成对应块,各设备计算部分和 \mathbf{Z}_i=\mathbf{Y}_i\mathbf{B}_i,再用 all-reduce 得到 \mathbf{Z}=\sum_i\mathbf{Z}_i。注意力类似,可分配完整头,再累加输出投影的部分贡献。这是 张量并行(TP),由 Megatron-LM 针对 Transformer 发展。
通信模式由分区计算决定,不只由模型大小决定。基本 Transformer TP 布局中,前向注意力和 FFN 都需对残差宽度的张量归约,反向也需对应通信。常用估算是每训练 micro-batch、每层四次残差大小的 all-reduce。融合、重叠及序列并行变体会改变交换时机。
令 \mathbf{X}=(1,2)、\mathbf{A}=\mathbf{I}_2,经过 ReLU 得到 \mathbf{Y}=(1,2)。把两列分到两个设备,再采用 \mathbf{B}=(3,4)^{\top},设备一贡献 1(3)=3、设备二贡献 2(4)=8,和为 11,与未分区乘积相同。若在另一种分解中,先求和再逐元素激活,通常会改变函数:\phi(a+b) 未必等于 \phi(a)+\phi(b)。
案例中,micro-batch 为 1、长度 8,192 的 bf16 残差张量含 8192(4096)(2)=67{,}108{,}864 字节。36 层每层四次这样的载荷,共 9.66 GB。按有效载荷速率 450 GB/s,理想传输时间为 21.5 ms;50 GB/s 下为 193 ms。环形因子、延迟及集合通信争用还需更精确模型。不过,这已解释为何频繁的逐层通信应走快速节点内链路。
KV 头数必须能被所选 TP 度数划分,否则需复制并承担额外内存与通信。8 个 KV 头不能直接分成 16 份互不重叠的完整头。启动前应检查配置可整除性及实现支持的布局。
TP 组内的序列并行为归一化等操作划分序列区域,避免复制全部相关激活。用 reduce-scatter 与 all-gather 替代 all-reduce,可保留总交换量,同时减少保留的重复激活。它不同于通过独立组分布注意力上下文。
用流水线切分层堆栈
流水线并行(PP)将连续层分配给不同阶段。前向激活跨阶段传递,反向梯度沿相反方向返回。Micro-batch 使各阶段同时处理全局 batch 的不同部分。
在有 p 个阶段、m 个 micro-batch 的均衡简单调度中,填充与排空在 m 个有效时间槽之外再占 p-1 槽。空闲占总调度时间的比例为 (p-1)/(m+p-1);相对理想忙碌时间的额外开销为 (p-1)/m。两个分母描述不同量。
四阶段、八个 micro-batch 时,空闲占调度时间的 3/(8+3)=27.3\%;相对八个有效槽的开销为 3/8=37.5\%。增到 32 个 micro-batch,空闲比例降为 3/35=8.6\%。若要低于 10%,解 3/(m+3)<0.1 得 m>27,所以该均衡模型下最小整数为 28。
一前一后调度比先累积全部前向减少同时保存的 micro-batch 激活。虚拟或交错阶段可减少空闲气泡,但增加交换。实际阶段耗时取决于嵌入、词表投影、序列长度及每层成本,不能只看层数。案例的 36 层可均分为 2、3、4、6、9 阶段,但层数相同不证明耗时相同。
序列过大时切分上下文
上下文并行(CP)将一个序列分到多个设备,各进程计算本地查询,同时接收其他进程的必要键值块。环注意 将块级注意力与这些块的环形传递重叠。因果注意力下,连续分区使早期块工作少于后期块;交错或成对分块可改善均衡。
长度 131,072 做八路序列划分,每个进程得到 16,384 个位置。对应分区的本地激活可缩小约八倍,但完整可见关系仍需计算和通信。上下文并行不是滑动窗口近似,也不自动把全部模型状态存储除以八。
根据资源限制选择布局
先选能提供有效 kernel 工作量的最小 micro-batch,检查模型状态、激活与 logits。若可容纳并让权重聚集留在快链路上,就在节点内分片状态。若激活内存或单层计算仍是限制,考虑 TP;切分层堆栈有用、且 micro-batch 足够抑制气泡时,增加 PP。长上下文的本地激活或注意力无法容纳时,增加 CP。再用累积达到全局 token batch。
明确写出布局,如 DP \times TP \times PP \times CP,并区分状态分片子组与复制子组。乘积必须描述实际设备拓扑,而非仅凑出 GPU 数。MoE 的专家并行再引入路由维度,在专家持有者间交换选中的 token。
假设的 80 GPU 基座训练中,普通复制 AdamW 每 GPU 需 152.8 GB 状态,超过 80 GB。80 GPU 的 ZeRO-1 状态约 39.6 GB,加入激活 42.9 GB 和 logits 5.0 GB 后仍超限。跨全部 80 进程分片可减少状态,却让反复权重聚集跨节点。一个候选是在每个 8 GPU 节点内分片,在 10 个节点间复制,并用检查点留出余量。19.1 GB 常驻状态分片尚不包含聚集权重的峰值和通信缓冲区。应测量此候选及其他方案,不能只根据这些组成项宣称最优拓扑。
累积很多 micro-batch 时,为什么节点内权重聚集有帮助?
查看答案
每个 micro-batch 都可能重复聚集权重。本地分片把频繁流量留在快速节点内链路,跨节点复制只需较低频率地通信累积梯度分片。实际收益取决于重新分片及重叠策略。
长期训练中的故障与运行管理
长期训练是带恢复状态的完整流程,不只是优化器循环。同样的损失尖峰可能来自数据错误、数值不稳定或设备故障。选择措施前,记录足够上下文以区分原因。
利用症状缩小原因范围
能恢复的短暂尖峰与持续发散不同。检查损失、梯度范数、激活尺度、最大注意力 logit、输出对数归一化常数及裁剪比例。同一数据位置反复出现尖峰,提示 batch 相关原因,但确定性模型不稳定也可能在该处重现。用同一检查点和 batch 复现,再比较受控修改。
| 现象 | 应检查的证据 | 候选措施 |
|---|---|---|
| 损失或梯度出现非有限值 | 输入、精度、归一化分母、出错操作 | 跳过无效更新,复现并修复数值原因 |
| 注意力 logits 不断增长 | 每层查询/键尺度和注意力熵 | 测试 QK 归一化或尺度控制 |
| 输出归一化常数漂移 | 词表 logits 和 log-sum-exp | 测试输出正则项 |
| 训练损失改善,留出损失停滞 | 重复分片、来源比例、数据顺序 | 修复数据流程并重新考虑配比 |
| 从首个 batch 起损失就很高 | 分词器版本、目标移位、掩码、初始 logits | 检查数据与模型接口约定 |
| 恢复后重复或跳过数据 | 加载器游标、RNG、工作进程状态、恢复步数 | 模型状态和数据状态一起恢复 |
| 单个副本差异很大 | 设备诊断、输入分片、权重校验和 | 换设备复现并隔离故障 |
预热、裁剪、bf16、QK 归一化和输出 z-loss 分别处理不同机制。裁剪有限的全局梯度,无法修复非有限注意力中间值。重启后换了 batch 而结果改善,并不足以证明修复有效。实验 3 在小型不稳定性实验中比较受控干预。
检查点应恢复训练,而不只是预测
保存模型及主权重、优化器矩、调度位置、步数和已用 token 数、RNG 状态、加载器进度、配置、分词器身份及数据清单。保留较早检查点,防止后续检查点损坏。在依赖恢复前,测试下一 batch 和下一更新是否与原运行相同。
异步写入需要一致快照。若复制张量时训练同时更新,可能混入多个步骤的状态;仅启动后台写入并不能保证正确。完整检查点需有持久化完成记录,恢复规则必须忽略未完成写入。
案例的主权重及 Adam 矩约每参数 12 字节,合计 12(9{,}550{,}729{,}216)=114.6 GB;加 bf16 模型权重后约 133.7 GB。假设总写速率为 2 GB/s,数据传输本身约需 57–67 秒,元数据、同步及存储波动还会增加耗时。
用明确模型选择检查点间隔
设检查点写入耗时 \delta,间隔 \tau,平均中断间隔 M。若故障在间隔中均匀出现,每次平均损失的工作时间为 \tau/2。单位时间的近似开销为
求导得到 f'(\tau)=-\delta/\tau^2+1/(2M),令其为零得 \tau^*=\sqrt{2\delta M}。正的二阶导数 2\delta/\tau^3 证明为最小值。这个近似忽略重启耗时、写入期间故障及非独立中断,只是规划基线。
写入 60 秒、假设 MTBF 为 3.09 小时时,\tau^*=\sqrt{2(60)(3.09)(3600)}=1155 秒,即 19.3 分钟,估计开销约 10.4%。假设 MTBF 为 633 小时时,间隔为 16,537 秒,即 4.59 小时,开销约 0.73%。写入耗时减半,使最优间隔缩短为原来的 1/\sqrt2,而非一半。这些中断率是情景假设,不是对新集群的实测故障预测。
监测数值并为告警确定行动
记录各来源损失、留出损失、梯度及更新与权重的范数、学习率、裁剪比例、激活尺度、最大注意力值及输出归一化常数。同时跟踪 token/s、峰值内存、集合通信耗时、停滞工作进程、各来源 token 数和文档边界。每种告警都需对应行动:检查数据、复现数值故障、恢复已知检查点或排查设备。
已知答案测试和副本比较可揭示静默损坏,但校验和相同不能检出共享软件错误。即使训练损失与硬件健康正常,领域及通用评估仍不可缺少。错误配比或污染评估可能产生平滑曲线,模型却不满足用途。
为什么恢复后同一数据位置的损失尖峰只是线索,而非数据错误的证据?
查看答案
它指向与 batch 的可重复交互。应检查并改变 batch,同时测试数值计算与模型状态;有效但困难的输入也可能重现确定性不稳定。
训练中评估与基座模型检查点
训练损失衡量对已用数据混合的拟合,本身不能确定泛化、实用能力或不存在污染。训练前定义评估集,并使其独立于训练和配比调优。
区分来源与分布
按来源和语言跟踪留出损失,不只看混合平均值。大来源可能主导平均值,掩盖小领域退步。加入混合之外的文本,测试跨分布迁移。划分前先把近重复文档归组,否则名义留出文档可能几乎等同训练文档。改变分词器后,不能直接比较每 token 损失。
高频小规模评估检查数据与数值健康,较低频的广泛测试检查各语言知识、阅读、算术、代码及目标领域。比较检查点时固定提示、分词、评分与解码设置。生成评估会增加采样噪声;可执行测试和参考答案也必须正确且覆盖充分。
将选项评分为完整的延续
对基座模型,可累加每个选项的 token 对数概率,条件为题目及该选项前面的 token。包括预期空格、模板和终止约定。更长选项自然累加更多负项。长度归一化会改变决策标准,应报告该标准,不能看过结果后再换。
假设一个选项仅一 token,对数概率 −1.2;另一个有两个 token,对数概率 −1.5、−0.8。总分分别 −1.2、−2.3,第一个胜出;每 token 平均分别 −1.2、−1.15,第二个胜出。这些是指定 token 数的说明性分数,不是分词器测量。任一规则都不是对所有基准自动正确,应遵循该基准协议。
小基准无法支持精确断言
这里适用 第 01 模块,第 10 节 的不确定性方法。500 道独立题、准确率 40% 时,二项标准误为 \sqrt{0.4(0.6)/500}=0.0219,近似 95% 区间半宽约 4.3 个百分点。24 题填空集准确率 50% 时,标准误为 10.2 个百分点,区间很宽。两检查点评估同样题目时,应报告题数并做配对比较;单独区间是否重叠,不能决定配对检验结果。
反复在小验证集选最高分检查点,会对验证集过拟合。用它指导开发,另保留最终测试集。若证据不足以区分噪声,微小表观改善不应成为大幅修改方案的理由。
预测运行自身分布的损失
相同分词器和数据上的试训可支持损失预测。一种时间序列形式为 \mathcal{L}(D)=\mathcal{L}_{\infty}+aD^{-\gamma},其中 D 表示已用 token。训练中拟合参数并检查残差。偏离预测可能表示配比变化、重复数据或优化问题,但仅凭偏差无法确定原因。早期数据范围窄,也难以约束渐近值,因此应展示对拟合窗口的敏感性。
评估若干较晚检查点。附近权重平均或指数移动平均可能有益,但必须用相同协议评估。只平均参数布局兼容的模型,检查是否退步。第 09 模块 进一步讨论模型合并。
基座模型发布应包含什么
有用的发布包含权重、配置、分词器、训练日志、数据清单、去污染记录和评估曲线。公开发布可能省略其中部分,留下下游测量需解决的不确定性。基座模型用于续写文本;仅在混合文档上训练,并不能提供可靠助手协议或拒绝策略,尽管语料可能让它偶然表现出类似指令遵循的行为。第 09 模块 讨论受控后训练行为及评估。
假想安全案例团队取得开放基座模型后,先测量领域语言损失、术语碎片化和任务表现,再考虑继续预训练。通用基准分数不足以证明工程陈述可靠。测量结果决定 第 14 节 的下一步。
两个检查点在同样 500 题上得分 41% 和 44%。评估改善需要哪些信息?
查看答案
需要配对题目结果、评估协议及差异的不确定性估计。边际准确率不能说明两个方向各有多少题改变结果。还需考虑在该测试集上反复选择检查点的影响。
可以实际执行的小规模训练
有用的小规模训练以低失败成本练习完整流程。除解码器外,还需可复现的语料和分词器、可恢复加载器、调度、检查点、日志及评估。不出现 NaN,只满足了部分要求。
明确计数的单 GPU 方案
考虑无偏置解码器:12 层、宽度 768、12 个查询及 KV 头、SwiGLU 宽度 2048、RoPE、RMSNorm,词表 32,000 且嵌入共享。在有清理记录的约 2.5B token 网络文本样本上训练。分词器只用训练部分,预处理选择之前先保留评估集,记录样本及分词器版本。
| 项目 | 待测试的初始方案 |
|---|---|
| 优化器 | AdamW,betas 为(0.9,0.95),权重衰减 0.1 |
| 学习率 | 峰值 6\times10^{-4},预热 700 步,再余弦衰减至 6\times10^{-5} |
| 全局 token batch | 2048 个 token 的 256 个序列:524,288 token |
| 精度 | bf16 autocast 与 fp32 优化器状态;验证实现的权重策略 |
| 稳定性 | 梯度裁剪 1.0;检查注意力及输出 logit 尺度 |
| 注意力 | SDPA,使用已验证兼容的融合实现 |
| 日志 | 每十步记录损失、梯度范数、学习率、吞吐量 |
| 评估 | 每 250 步评估固定留出损失及小型任务集 |
| 恢复 | 每 500 步保存完整检查点,按实测写入与故障成本调整 |
这些是受控试训的起始设置,不保证对任一混合都稳定。根据峰值内存选 micro-batch 和累积步数,而非一次塞入 256 条序列。检查梯度累积是否按有效 token 正确加权,包括被掩码的填充位置。
每层有 4(768^2)+3(768)(2048)+2(768)=7{,}079{,}424 个参数,十二层共 84,953,088。共享嵌入贡献 32000(768)=24{,}576{,}000,最终归一化再加 768,总计 109,529,856。124M 的 GPT-2 结构使用不同词表及学习式位置编码;架构家族名称不能代替计数。实验 4 核对了精确组成项。
token、步骤和时间
每步 524,288 token,2.5B token 约需 4768.4 个完整 batch。可采用较小的最后 batch 或舍入预算,但须记录实际使用量。若直接按 5000 步调度且不处理差异,最终 token 预算就会改变。
按本系列约定,共享词表仍计入矩阵乘法参数。在 T=2048、D=2.5\times10^9 下,训练成本约为 (6N+6LdT)D=1.93\times10^{18} FLOP;简化 6ND 得 1.64\times10^{18}。若持续吞吐量为 989 TFLOP/s 峰值的 40%,模型计算约 1.36 小时;25% 时约 2.18 小时。小矩阵、评估和数据流程开销会增加实际耗时。应测量代表性试训,而非仅凭峰值算术排期。
每 token 损失 3 奈特,对应当前分词器和语料的困惑度 e^3=20.1。这是量级示例,不是对该方案的结果预测。不同语料上的拟合定律不能确定本次最终损失,应根据相同数据的试训预测,并报告留出结果。
缩小完整流程,而不只缩小模型
实验 2 使用更小的 CPU 解码器与 TinyStories,以低成本练习预处理、训练、评估和采样。语料和分词器不同,不能直接拿其实验损失与网络文本方案比较。仍须记录已用 token、报告 QUICK/FULL 设置、测试恢复,并同时检查生成样本和数值损失。
为什么 CPU 实验较低的最终损失不能证明网络文本方案达到相同质量?
查看答案
语料及分词器不同,每 token 不确定性与任务难度也不同。应在共享且记录明确的评估任务上比较质量,或采用可比单位与匹配协议,不能只比较原始 token 损失。
中期训练与继续预训练
接近训练预算末尾,是主动调整混合并评估高质量或专业来源的合适时机。中期训练(mid-training)通常指广泛预训练与行为后训练之间的阶段。继续预训练(CPT)从已有权重出发,继续优化下一 token 目标,常转向新领域。这两个术语本身都不规定唯一的数据方案或优化器调度。
结合数据和位置方案扩展上下文
延长窗口不只改变位置上限,还引入新偏移、更多竞争键,并增加每 token 的完整注意力计算。位置插值将目标位置映射到较短的训练角度范围;陈等人。 比较上下文扩展方法。改变基频和其他缩放方法采用不同角度映射,RoPE 推导见 第 06 模块。
使用合适长文档或构造任务训练,在整个窗口测试检索和多步使用,再复测短上下文。成功检索一个片段,不证明可靠地联合推理多个片段。打包不相关短文档,也不会自动使其等同连贯长文档。
案例解码器有 N_{\text{matmul}}=8{,}927{,}875{,}072、L=36、d=4096。长度 8,192 时,每 token 训练计算为 6N_{\text{matmul}}+6LdT=6.0815\times10^{10} FLOP;131,072 时为 1.6953\times10^{11},约 2.79 倍。因此即使分布注意力,长序列上消耗相同 token 数也更昂贵。
调整分布,同时检查遗忘
仅领域训练可改善领域损失,却损害通用能力。回放把通用文本混入适配数据,保留原分布信息。回放比例应测试,不是通用常数。始终使用领域及通用留出集,并各配相应任务测试。回放消耗部分 token 预算,也可能减缓领域适配。
学习率从低于全新广泛预训练峰值的水平开始,比较受控范围。若发布检查点不含优化器矩,短预热很有用:已有训练权重并不意味着新的 Adam 状态具有正确尺度。除非证据支持修改,保持分词器固定。新增词表行需要训练嵌入及兼容输出头;仅在配置中添加 token 字符串,不会赋予其含义。
改变分词器之前先测领域术语碎片化。每词平均 token 是诊断指标;双语文本还须明确选择字符或字节等单位。Token 数更少,本身不证明领域建模更好。实验 5 在小型继续训练中比较回放和学习率。
训练前确定安全案例决策
以下仍是假设案例。团队采用模块 07 的双语开放基座模型,起草和检查反应堆容器泄压系统安全案例论证。先测领域语言损失、术语碎片化和领域任务集,并比较更便宜的指令微调基线。下一 token 训练可改善领域分布拟合,却不能单独提供可靠证据处理,也不保证比指令微调更适合该应用。
实测差距若支持 CPT,则准备 1.8B 领域 token 与 0.2B 通用回放 token。记录来源、允许用途及针对领域评估的去污染。候选来源包括公开调查报告、监管指南、已发表安全案例文献及获得适当许可的文本。不可访问或未获许可的材料不能算作预算中可用数据。
采用长度 8,192、全局 batch 128 序列、假设峰值学习率 3\times10^{-5}、预热 100 步及余弦衰减到 3\times10^{-6}。每 200 步评估领域损失、通用损失和任务集。训练前设验收门槛,例如要求领域改善且通用任务退步不超过一个百分点,并使用足够配对题目判断该幅度。不确定性大时,仅看点估计不足以验收。
全局 batch 为 128(8192)=1{,}048{,}576 token。2B token 相当于 1907.35 个 batch:1907 完整步略低于预算,1908 步略高,除非缩短最后 batch。每 token 6.0815\times10^{10} FLOP,模型计算为 1.2163\times10^{20} FLOP。假设每 GPU 持续 4\times10^{14} FLOP/s,需 84.5 GPU 小时,八张 GPU 的理想耗时 10.6 小时。每 GPU 小时 2.50 美元时,仅模型计算约 211 美元。这些价格及速率是假设,日期为 2026 年 10 月。
八路 ZeRO-3 的每 GPU 组成估计为模型状态 19.1 GB、激活 42.9 GB、fp32 logits 5.0 GB,额外缓冲区之前约 67.0 GB。完整检查点将激活降为 3.61 GB,小计约 27.7 GB,代价是额外重算。实验 4 可交互探索这些假设;80 GB 是否足够,仍需测量实际峰值。
2T token 基座计划的模型 FLOP 是这次 2B token 适配的千倍。语料构建、评估、试训及工程师时间仍是额外成本。CPT 通过预定门槛后,模块 09 从该检查点做行为后训练,训练预期聊天格式;若失败或无必要,团队可直接采用已发布指令模型。应在检查点谱系中记录决定,不能悄悄更换起点。
模型已有训练权重,为什么继续预训练仍需预热?
查看答案
新的优化器矩可能从零开始,新分布的梯度尺度也可能不同。已训练权重不提供适合新混合的已训练优化器状态。应试验学习率,并监测领域和通用结果。
常见问题与排查
| 症状 | 候选原因 | 查看 |
|---|---|---|
| 训练曲线平滑,领域表现差 | 配比错误、碎片化或评估不匹配 | 各来源留出损失与领域任务集 |
| 留出损失好,全新文档表现差 | 近重复或污染 | 分组划分、去污染记录 |
| 内存超过计算器估计 | 聚集权重、fp32 logits、缓冲区或碎片未计入 | 测量峰值,逐项比较 |
| GPU 更多却效率下降 | 集合通信、小 kernel 或流水线气泡 | 分析代表性 micro-batch 和通信 |
| 重启后重复数据 | 遗漏加载器或 RNG 状态 | 恢复后比较下一 batch |
| 裁剪后仍反复出现 NaN | 梯度之前的中间值无效或溢出 | 复现出错操作及数值精度路径 |
| 领域损失下降,通用能力退步 | 领域转移过大或适配学习率过高 | 受控回放与学习率实验,配对通用评估 |
| 长上下文连简单任务也失败 | 位置或数据方案未建立有效利用能力 | 改变证据位置、干扰项和任务类型 |
| 小基准每次选出不同最佳检查点 | 采样噪声或反复选择 | 增加配对题目,保留独立最终测试 |
有用的训练必须有明确数据约定、可观测数值行为、经过测试的恢复及独立评估。解码器只是完整流程的一部分。
实验 1 — 小型数据流程:过滤与 MinHash-LSH
目标。 向小语料加入已知垃圾文本与副本,审计启发式过滤器,实现精确和近似重复检测,并将实测候选率与 LSH 公式比较。每次删除都记录明确原因。这是在儿童故事上的实验,不是可直接用于技术文档的质量策略。
从 小故事 下载一个 10 MB parquet 文件;该合成英文故事数据集按 CDLA-Sharing-1.0 发布。代码把公开验证文件作为原始语料,并未将数据集原来的训练与测试划分用于本实验模型评估。修订版本固定,语料文件不加入教程仓库。若尚未安装,按本系列实验依赖安装 pandas、pyarrow。
构建带有审计跟踪的语料库
受控实验中,前 5,000 篇故事标记为 clean,只表示“原始输入”,不代表人工质量审核通过。加入四类垃圾文本、精确副本及六组轻微修改的副本。近重复生成器以概率 q 独立替换各词,可能没有任何修改,尤其在 q=0.01 时。因此标签记录来源,而不保证相似度。
import re
import time
import json
import random
import hashlib
import itertools
import zlib
from pathlib import Path
from collections import Counter, defaultdict
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from huggingface_hub import hf_hub_download

random.seed(0)
np.random.seed(0)
revision = "f54c09fd23315a6f9c86f9dc80f725de7d8f9c64"
path = hf_hub_download(
    "roneneldan/TinyStories",
    "data/validation-00000-of-00001-869c898b519ad725.parquet",
    repo_type="dataset", revision=revision,
)
stories = pd.read_parquet(path)["text"].tolist()
docs = stories[:5000].copy()
labels = ["clean"] * len(docs)
rng = random.Random(0)
def add(text, label):
    docs.append(text)
    labels.append(label)

menus = ["Home", "Products", "Support", "Prices", "Contact", "About"]
for i in range(150):
    lines = [" | ".join(rng.sample(menus, len(menus))) for _ in range(12)]
    add("\n".join(lines), "navigation")
spam = ["BUY", "NOW!!!", "$$$", "#deal", "#sale", "CHEAP", ">>>", "***", "100%", "FREE"]
for i in range(150):
    add(" ".join(rng.choices(spam, k=rng.randint(60, 120))), "spam")
for i in range(150):
    sentence = stories[rng.randrange(5000)].split(".")[0] + "."
    add("\n".join([sentence]*rng.randint(8, 15)), "repeated line")
for i in range(150):
    add(" ".join(stories[rng.randrange(5000)].split()[:rng.randint(5, 25)]), "short")
for i in range(200):
    add(stories[rng.randrange(5000)], "exact copy")
near_pairs, edit_rates = [], []
for q in [.01, .03, .05, .08, .12, .20]:
    for i in range(100):
        original = rng.randrange(5000)
        words = docs[original].split()
        edited = [rng.choice(["river", "signal", "engine", "garden"])
                  if rng.random() < q else word for word in words]
        near_pairs.append((original, len(docs)))
        edit_rates.append(q)
        add(" ".join(edited), "near copy")
print("Released validation stories:", len(stories))
print("Experimental corpus:", len(docs), dict(Counter(labels)))
Released validation stories: 21990
Experimental corpus: 6400 {'clean': 5000, 'navigation': 150, 'spam': 150, 'repeated line': 150, 'short': 150, 'exact copy': 200, 'near copy': 600}
记录首个失败的启发式规则
这些规则近似 Gopher 过滤启发式 的一个子集,定义明确:词按空白分隔;重复行比例统计首次之后的出现次数;高频二元组比例以其字符贡献除以文本长度。与生产实现比较时,这些简化不能忽略。
STOP = {"the", "be", "to", "of", "and", "that", "have", "with"}
def quality_reason(text):
    words = text.split()
    if not 50 <= len(words) <= 100000:
        return "word count"
    if not 3 <= np.mean([len(w) for w in words]) <= 10:
        return "word length"
    if (text.count("#") + text.count("..."))/len(words) > .1:
        return "symbols"
    lines = [line.strip() for line in text.splitlines() if line.strip()]
    if sum(line.startswith(("-", "*", "•")) for line in lines)/len(lines) > .9:
        return "bullet lines"
    if sum(line.endswith("...") for line in lines)/len(lines) > .3:
        return "ellipsis lines"
    if sum(any(char.isalpha() for char in w) for w in words)/len(words) < .8:
        return "alphabetic words"
    lower = [re.sub(r"[^a-z]", "", w.lower()) for w in words]
    if len(set(lower) & STOP) < 2:
        return "stop words"
    if (len(lines)-len(set(lines)))/len(lines) > .3:
        return "duplicate lines"
    pairs = Counter(zip(words, words[1:]))
    pair, count = pairs.most_common(1)[0]
    if count*sum(map(len, pair))/max(1, len(text)) > .2:
        return "frequent bigram"
    return None

reasons = [quality_reason(text) for text in docs]
table = pd.crosstab(pd.Series(labels, name="label"),
                    pd.Series([r or "pass" for r in reasons], name="first failure"))
print(table.to_string())
print("Original stories rejected:",
      sum(r is not None for r in reasons[:5000]), "/ 5000")

patterns = ("â€", "Ã", "Â")
flagged = [i for i,text in enumerate(docs[:5000]) if any(p in text for p in patterns)]
repaired = 0
for i in flagged:
    try:
        candidate = docs[i].encode("cp1252").decode("utf8")
    except UnicodeError:
        continue
    if not any(p in candidate for p in patterns):
        repaired += 1
print("Mojibake candidates:", len(flagged), "whole-string repair successes:", repaired)
first failure  alphabetic words  duplicate lines  ellipsis lines  pass  stop words  symbols  word count
label
clean                         0                0               1  4997           0        0           2
exact copy                    0                0               0   200           0        0           0
navigation                  150                0               0     0           0        0           0
near copy                     0                0               0   599           0        0           1
repeated line                 0               24               0     0         122        0           4
short                         0                0               0     0           0        0         150
spam                          0                0               0     0           0      150           0
Original stories rejected: 3 / 5000
Mojibake candidates: 303 whole-string repair successes: 97
修复探测不修改语料,因为下一阶段要比较副本与生成它们的原文。生产修复应在生成指纹前执行,记录修改,并处理混合编码,不能把这种单次转换用于所有文档。转换成功本身也不证明恢复了原文。
精确指纹与 shingle 集合
哈希前规范化大小写与空白。这里 SHA-1 是索引,不是安全保证;键还包含规范化字符串,以防意外摘要碰撞。按此规范化定义的精确重复,可能包括生成后未实际修改的近重复副本。近重复采用连续五词的集合,避免重复出现增加 shingle 权重。
def normalise(text):
    return " ".join(text.lower().split())

exact_seen, exact_removed = {}, set()
for i,text in enumerate(docs):
    normal = normalise(text)
    key = (hashlib.sha1(normal.encode()).digest(), normal)
    if key in exact_seen:
        exact_removed.add(i)
    else:
        exact_seen[key] = i
print("Exact duplicates (all input):", len(exact_removed))

def shingles(text):
    words = normalise(text).split()
    return {tuple(words[i:i+5]) for i in range(len(words)-4)}

sets = [shingles(text) for text in docs]
def jaccard(a, b):
    union = a | b
    return len(a & b)/len(union) if union else 1.0

true_j = np.array([jaccard(sets[a], sets[b]) for a,b in near_pairs])
print("Generated near-copies that are exact:",
      sum(normalise(docs[a]) == normalise(docs[b]) for a,b in near_pairs))
print("Near-pair true Jaccard range:", f"{true_j.min():.3f}", f"{true_j.max():.3f}")
Exact duplicates (all input): 242
Generated near-copies that are exact: 18
Near-pair true Jaccard range: 0.000 1.000
上面的“真实 Jaccard”比较实际的 shingle 集合。下方 MinHash 为速度使用 CRC32 ID;相对真实集合,ID 碰撞和近似哈希族都是额外误差来源。
MinHash 签名与分带候选
一次抽取 128 个哈希函数,供全部文档共用。乘法使用 uint64:32 位输入乘以小于 2^{31}-1 的系数可放入 uint64,却可能溢出 uint32。空 shingle 集合获得哨兵签名,不放进候选桶,因为空集合没有有用相似性证据。
理想独立 MinHash 的签名一致比例估计 Jaccard;16 个带、每带 8 行时,文档对以 1-(1-s^8)^{16} 的概率成为候选。这里的简单通用哈希族只是理想情况的近似,应比较实测与曲线,而非把公式当作精确保证。
p = np.uint64(2**31-1)
hash_rng = np.random.default_rng(0)
a = hash_rng.integers(1, int(p), size=128, dtype=np.uint64)
b = hash_rng.integers(0, int(p), size=128, dtype=np.uint64)
signatures = np.full((len(docs), 128), int(p), dtype=np.uint64)
start = time.perf_counter()
for i,shingle_set in enumerate(sets):
    if shingle_set:
        ids = np.array([zlib.crc32(" ".join(shingle).encode())
                        for shingle in shingle_set], dtype=np.uint64)
        signatures[i] = ((ids[:, None]*a[None, :] + b[None, :]) % p).min(0)
signature_seconds = time.perf_counter()-start
estimated = np.array([(signatures[x] == signatures[y]).mean() for x,y in near_pairs])
error = np.abs(estimated[:300]-true_j[:300])
print("Signature seconds:", f"{signature_seconds:.2f}")
print("First 300 pairs, mean/max absolute error:",
      f"{error.mean():.4f}", f"{error.max():.4f}")

buckets = defaultdict(list)
for i,signature in enumerate(signatures):
    if sets[i]:
        for band in range(16):
            buckets[(band, signature[band*8:(band+1)*8].tobytes())].append(i)
start = time.perf_counter()
candidates = set()
for bucket in buckets.values():
    candidates.update(itertools.combinations(bucket, 2))
print("Candidate pairs:", len(candidates), "of", len(docs)*(len(docs)-1)//2,
      "possible; bucket-pair seconds:", f"{time.perf_counter()-start:.2f}")
detected = np.array([pair in candidates for pair in near_pairs])
bin_edges = [0, .4, .5, .6, .7, .8, .9, 1.000001]
observations = []
print("Jaccard bin       pairs empirical theory-mean")
for lo,hi in zip(bin_edges, bin_edges[1:]):
    mask = (true_j >= lo) & (true_j < hi)
    if mask.any():
        theory = 1-(1-true_j[mask]**8)**16
        row = dict(lower=lo, upper=min(hi,1), pairs=int(mask.sum()),
                   mean_j=float(true_j[mask].mean()),
                   empirical=float(detected[mask].mean()), theory=float(theory.mean()))
        observations.append(row)
        print(f"[{lo:.1f}, {min(hi,1):.1f}] {mask.sum():7d} "
              f"{row['empirical']:9.3f} {row['theory']:11.3f}")
similarity = np.linspace(0,1,501)
plt.figure(figsize=(7, 3))
plt.plot(similarity, 1-(1-similarity**8)**16, label="Ideal independent MinHashes")
plt.scatter([r["mean_j"] for r in observations],
            [r["empirical"] for r in observations], label="600 constructed pairs")
plt.xlabel("True five-word-shingle Jaccard")
plt.ylabel("Candidate probability / observed fraction")
plt.title("LSH: 16 bands of 8 rows")
plt.legend()
plt.tight_layout()
plt.show()
Signature seconds: 0.55
First 300 pairs, mean/max absolute error: 0.0275 0.1390
Candidate pairs: 780 of 20476800 possible; bucket-pair seconds: 0.01
Jaccard bin       pairs empirical theory-mean
[0.0, 0.4]     187     0.000       0.002
[0.4, 0.5]      69     0.000       0.029
[0.5, 0.6]      69     0.029       0.119
[0.6, 0.7]      56     0.464       0.405
[0.7, 0.8]      85     0.906       0.812
[0.8, 0.9]      66     1.000       0.986
[0.9, 1.0]      68     1.000       1.000
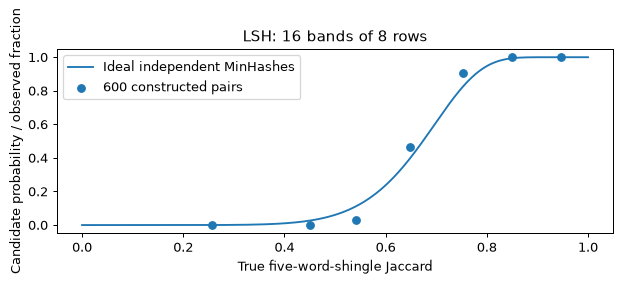
打印的理论列对每个文档对的实际相似度代入公式再取平均,不用宽分箱的中点替代。各对共用哈希族,也可能共用源故事,因此分箱计数不是独立 Bernoulli 试验。散布用于诊断,不是已验证覆盖率的不确定性区间。
验证候选、聚类并记录删除
LSH 只提出候选。并入簇之前,用实际 shingle 重叠验证。并查集每簇保留最小文档索引。即使 A 与 C 低于阈值,传递闭包仍可经 B 连接两者;这是聚类策略,不要求簇内每对都过阈值。
最终流程先删质量不合格文档,再在剩余文档中删精确副本,最后处理已验证近重复簇。此时须重新确定精确重复的保留文档,因为此前首次出现的文档可能已未通过质量过滤。
def cluster_remove(active, threshold):
    active = set(active)
    parent = {i:i for i in active}
    def find(i):
        while parent[i] != i:
            parent[i] = parent[parent[i]]
            i = parent[i]
        return i
    for x,y in sorted(candidates):
        if x in active and y in active and jaccard(sets[x],sets[y]) >= threshold:
            rx,ry = find(x),find(y)
            parent[max(rx,ry)] = min(rx,ry)
    return {i for i in active if find(i) != i}

threshold_results = {}
for threshold in [.7,.8,.9]:
    removed = cluster_remove(range(len(docs)), threshold)
    expected = {copy_id for (source,copy_id),similarity in zip(near_pairs,true_j)
                if similarity >= threshold} | set(range(5600,5800))
    precision = len(removed & expected)/len(removed) if removed else 0
    recall = len(removed & expected)/len(expected) if expected else 0
    threshold_results[str(threshold)] = dict(removed=len(removed),
                                            precision=precision, recall=recall)
    print(f"Threshold {threshold:.1f}: removed {len(removed)}; "
          f"constructed-label precision {precision:.3f}; recall {recall:.3f}")

log = {i:"quality: "+reason for i,reason in enumerate(reasons) if reason}
survivors = [i for i in range(len(docs)) if i not in log]
seen = {}
for i in survivors:
    normal = normalise(docs[i])
    key = (hashlib.sha1(normal.encode()).digest(),normal)
    if key in seen:
        log[i] = "exact copy of document " + str(seen[key])
    else:
        seen[key] = i
before_near = [i for i in survivors if i not in log]
near_removed = cluster_remove(before_near,.8)
for i in near_removed:
    log[i] = "near-duplicate cluster at Jaccard threshold 0.8"
counts = Counter(reason.split(":")[0].split(" of ")[0].split(" at ")[0]
                 for reason in log.values())
print("Pipeline:", len(docs), "in;", dict(counts),
      "removed;", len(docs)-len(log), "out")
for i in sorted(log)[:5]:
    print("document", i, "label", labels[i], "reason", log[i])
metrics = dict(input_docs=len(docs), label_counts=dict(Counter(labels)),
               quality_rejections=sum(r is not None for r in reasons),
               original_rejections=sum(r is not None for r in reasons[:5000]),
               mojibake_flags=len(flagged), repair_successes=repaired,
               exact_duplicates_all_input=len(exact_removed),
               minhash_mae=float(error.mean()), minhash_max_error=float(error.max()),
               candidate_pairs=len(candidates), detection_bins=observations,
               thresholds=threshold_results, pipeline_removed=dict(counts),
               output_docs=len(docs)-len(log))
Path("lab1-metrics.json").write_text(json.dumps(metrics,indent=2),encoding="utf8")
Threshold 0.7: removed 461; constructed-label precision 0.892; recall 0.981
Threshold 0.8: removed 379; constructed-label precision 0.881; recall 1.000
Threshold 0.9: removed 306; constructed-label precision 0.876; recall 1.000
Pipeline: 6400 in; {'quality': 604, 'exact copy': 218, 'near-duplicate cluster': 116} removed; 5462 out
document 65 label clean reason quality: word count
document 200 label clean reason quality: ellipsis lines
document 2838 label clean reason quality: word count
document 5000 label navigation reason quality: alphabetic words
document 5001 label navigation reason quality: alphabetic words
构造标签精度将删除结果与超过所选相似度阈值的插入副本比较。它不是人工标注重复精度:原始故事或垃圾页面也可能与另一输入重复。应检查这些表观误报,不能把每处差异都归为算法错误。
预期观察
不同垃圾类别触发不同规则,部分原始故事也被删,说明启发式规则需要误删审计。编码问题可通过普通词汇过滤。精确副本数可能多于插入数,因为某些近重复抽样未做有效修改。
真实 shingle 相似度升高时,候选率快速上升。修改一个词最多改变五个 shingle,因此不高的改词比例也会显著降低 Jaccard,避开较严格的八行分带方案。候选生成节省两两比较,但会漏掉文档对。验证可防止低重叠哈希碰撞被接受为重复,却无法找回 LSH 从未提出的文档对。
进一步尝试
- 保持 128 项签名,分别改用 32 带 × 4 行及 8 带 × 16 行,比较候选数和召回率,绘制三条理论曲线。
- 留出五十篇源故事作为模拟基准,插入十篇编辑版本,比较五词 MinHash 与十三词重叠检测。将语料用于验证前,应按重复家族整体划分。
- 把质量规则用于有编号目标和简短记录的结构化技术论证。将网络正文阈值迁移到工程领域之前,先检查被拒绝的样本。
实验 2 — 在 TinyStories 上预训练一个小型 GPT
目标。 训练分词器和解码器,打包文档,监测训练与验证,对小型填空测试评分,证明检查点可同时恢复权重、优化器和随机采样器。保存分词器、模型配置及实测运行记录。
本实验复用实验 1 的固定版本 10 MB TinyStories 下载,但自行划分及训练分词器。各实验可在全新进程独立运行。合成儿童故事只用于小规模训练,不证明技术推理能力。先用 QUICK = True 运行 150 步,改为 False 则运行 600 步;两者架构相同。也可用免费 Colab GPU,代码仅在 CUDA 设备支持时使用 bf16 autocast。
固定划分、分词器与打包数据流
拟合 BPE 前,先留出 1,000 篇故事。以全部 256 字节为基础,保留文本结束特殊 token,用其余 20,990 篇训练大小 4,096 的词表。训练、评分、生成保持映射不变。公开验证 parquet 是本实验原始语料;这里的划分独立于 TinyStories 原来的训练与验证划分。
QUICK = True
import math
import time
import json
from pathlib import Path
from contextlib import nullcontext
import numpy as np
import pandas as pd
import torch
from torch import nn
from torch.nn import functional as F
import matplotlib.pyplot as plt
from tokenizers import Tokenizer, models, trainers, pre_tokenizers, decoders
from huggingface_hub import hf_hub_download

torch.set_num_threads(4)
torch.manual_seed(0)
np.random.seed(0)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
use_bf16 = device.type == "cuda" and torch.cuda.is_bf16_supported()

def precision():
    return (torch.autocast("cuda", dtype=torch.bfloat16) if use_bf16
            else nullcontext())

revision = "f54c09fd23315a6f9c86f9dc80f725de7d8f9c64"
path = hf_hub_download(
    "roneneldan/TinyStories",
    "data/validation-00000-of-00001-869c898b519ad725.parquet",
    repo_type="dataset", revision=revision,
)
stories = pd.read_parquet(path)["text"].tolist()
order = np.random.default_rng(0).permutation(len(stories))
train_texts = [stories[i] for i in order[1000:]]
valid_texts = [stories[i] for i in order[:1000]]

def train_tokenizer(texts):
    tokenizer = Tokenizer(models.BPE())
    tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=False)
    tokenizer.decoder = decoders.ByteLevel()
    trainer = trainers.BpeTrainer(
        vocab_size=4096, special_tokens=["<|endoftext|>"],
        initial_alphabet=pre_tokenizers.ByteLevel.alphabet(), show_progress=False,
    )
    tokenizer.train_from_iterator(texts, trainer=trainer)
    return tokenizer

tokenizer = train_tokenizer(train_texts)
eos = tokenizer.token_to_id("<|endoftext|>")

def pack(texts, tok=tokenizer):
    ends = tok.token_to_id("<|endoftext|>")
    encoded = tok.encode_batch(texts)
    lengths = [len(item.ids)+1 for item in encoded]
    stream = np.fromiter(
        (token for item in encoded for token in [*item.ids, ends]),
        dtype=np.uint16, count=sum(lengths),
    )
    return torch.from_numpy(stream.astype(np.int64)), lengths

train_data, lengths = pack(train_texts)
valid_data, _ = pack(valid_texts)
print("Device:", device, "bf16 autocast:", use_bf16)
print("Stories:", len(train_texts), "train;", len(valid_texts), "validation")
print("Vocabulary:", tokenizer.get_vocab_size(), "EOS:", eos)
print("Tokens:", len(train_data), "train;", len(valid_data), "validation")
Device: cpu bf16 autocast: False
Stories: 20990 train; 1000 validation
Vocabulary: 4096 EOS: 0
Tokens: 4650186 train; 228958 validation
打包在每篇故事后添加 EOS,再连接全部故事。窗口可以跨 EOS 边界;本实验允许注意前文档,不采用块对角文档掩码。每个位置仍使用因果目标。若将整篇故事填充到 512 的倍数,浪费比例见下方输出;该估计假设长于 512 的故事按块切分。
example = "Once upon a time, there was a little girl named Lily."
print("Example tokens:", tokenizer.encode(example).tokens)
characters = sum(map(len,train_texts))
words = sum(len(text.split()) for text in train_texts)
content_tokens = len(train_data)-len(train_texts)
padded = sum(512*math.ceil(length/512) for length in lengths)
print(f"Compression: {characters/content_tokens:.3f} characters/token; "
      f"{content_tokens/words:.3f} tokens/word")
print(f"Padding waste avoided: {1-len(train_data)/padded:.1%}")

# A measured large-matmul baseline, not the hardware's advertised peak.
dtype = torch.bfloat16 if use_bf16 else torch.float32
a = torch.randn(1024,1024,device=device,dtype=dtype)
b = torch.randn_like(a)
for _ in range(3):
    product = a@b
if device.type == "cuda":
    torch.cuda.synchronize()
start = time.perf_counter()
for _ in range(20):
    product = a@b
if device.type == "cuda":
    torch.cuda.synchronize()
matmul_rate = 20*2*1024**3/(time.perf_counter()-start)
print(f"Measured matmul baseline: {matmul_rate/1e9:.1f} GFLOP/s")
Example tokens: ['Once', 'Ġupon', 'Ġa', 'Ġtime', ',', 'Ġthere', 'Ġwas', 'Ġa', 'Ġlittle', 'Ġgirl', 'Ġnamed', 'ĠLily', '.']
Compression: 3.952 characters/token; 1.294 tokens/word
Padding waste avoided: 58.0%
Measured matmul baseline: 509.1 GFLOP/s
CPU 上用模型 FLOP/s 除以这个实测基线,得到利用率代理值。它不是生产 MFU,后者分母为训练精度对应的硬件公布峰值。矩阵大小、kernel 选择及其他运行程序都会影响基线,故应与吞吐量一同报告,而非当作机器规格。
声明解码器和优化器
这是模块 06 的因果解码器,为独立运行再次定义:RMSNorm、RoPE、SwiGLU、无偏置、共享输入输出嵌入。残差投影采用更小初始标准差。可选 QK 归一化在本实验关闭,由实验 3 测试。没有 dropout,便于解释恢复实验。
class RMSNorm(nn.Module):
    def __init__(self, width):
        super().__init__()
        self.weight = nn.Parameter(torch.ones(width))

    def forward(self, x):
        return F.rms_norm(x, (x.shape[-1],), self.weight, eps=1e-5)

class Attention(nn.Module):
    def __init__(self, d, heads, context, qk_norm=False):
        super().__init__()
        self.heads, self.dh = heads, d//heads
        self.qkv = nn.Linear(d, 3*d, bias=False)
        self.out = nn.Linear(d, d, bias=False)
        self.qnorm = RMSNorm(self.dh) if qk_norm else nn.Identity()
        self.knorm = RMSNorm(self.dh) if qk_norm else nn.Identity()
        angles = torch.outer(torch.arange(context),
                             10000**(-torch.arange(0, self.dh, 2)/self.dh))
        self.register_buffer("cos", angles.cos(), persistent=False)
        self.register_buffer("sin", angles.sin(), persistent=False)
        self.probe = False
        self.max_logit = 0.0

    def rotate(self, x):
        pairs = x.reshape(*x.shape[:-1], self.dh//2, 2)
        a, b = pairs.unbind(-1)
        cos = self.cos[:x.shape[-2]].to(x.dtype)
        sin = self.sin[:x.shape[-2]].to(x.dtype)
        return torch.stack((a*cos-b*sin, a*sin+b*cos), -1).flatten(-2)

    def forward(self, x):
        B,T,d = x.shape
        q,k,v = self.qkv(x).chunk(3, -1)
        q,k,v = [y.view(B,T,self.heads,self.dh).transpose(1,2)
                 for y in (q,k,v)]
        q,k = self.rotate(self.qnorm(q)), self.rotate(self.knorm(k))
        if self.probe:
            with torch.no_grad():
                scores = q.float() @ k.float().transpose(-2,-1)/math.sqrt(self.dh)
                causal = torch.ones(T,T,device=x.device,dtype=torch.bool).tril()
                self.max_logit = scores.masked_select(causal).abs().max().item()
        y = F.scaled_dot_product_attention(q,k,v,is_causal=True)
        return self.out(y.transpose(1,2).contiguous().view(B,T,d))

class Block(nn.Module):
    def __init__(self, d, heads, ff, context, qk_norm=False):
        super().__init__()
        self.n1, self.n2 = RMSNorm(d), RMSNorm(d)
        self.attn = Attention(d,heads,context,qk_norm)
        self.gate = nn.Linear(d,ff,bias=False)
        self.up = nn.Linear(d,ff,bias=False)
        self.down = nn.Linear(ff,d,bias=False)

    def forward(self, x):
        x = x + self.attn(self.n1(x))
        y = self.n2(x)
        return x + self.down(F.silu(self.gate(y))*self.up(y))

class GPT(nn.Module):
    def __init__(self, V=4096, d=256, layers=6, heads=8, ff=688,
                 context=256, qk_norm=False):
        super().__init__()
        assert d%heads == 0 and (d//heads)%2 == 0
        self.context = context
        self.embedding = nn.Embedding(V,d)
        self.blocks = nn.ModuleList(
            [Block(d,heads,ff,context,qk_norm) for _ in range(layers)])
        self.norm = RMSNorm(d)
        self.head = nn.Linear(d,V,bias=False)
        self.head.weight = self.embedding.weight
        for param in self.parameters():
            if param.ndim >= 2:
                nn.init.normal_(param,std=.02)
        for block in self.blocks:
            nn.init.normal_(block.attn.out.weight,std=.02/math.sqrt(2*layers))
            nn.init.normal_(block.down.weight,std=.02/math.sqrt(2*layers))

    def forward(self, tokens):
        x = self.embedding(tokens)
        for block in self.blocks:
            x = block(x)
        return self.head(self.norm(x))

def make_optimizer(model, lr):
    matrices = [p for p in model.parameters() if p.ndim >= 2]
    norms = [p for p in model.parameters() if p.ndim < 2]
    return torch.optim.AdamW(
        [{"params": matrices, "weight_decay": .1},
         {"params": norms, "weight_decay": 0.0}],
        lr=lr, betas=(.9,.95), eps=1e-8,
    )

def batch(stream, generator, T, B=16):
    starts = torch.randint(len(stream)-T, (B,), generator=generator)
    indices = starts[:,None] + torch.arange(T+1)
    windows = stream[indices].to(device)
    return windows[:,:-1], windows[:,1:]

@torch.no_grad()
def evaluate(model, batches):
    was_training = model.training
    model.eval()
    losses = []
    for x,y in batches:
        with precision():
            logits = model(x)
            loss = F.cross_entropy(logits.float().flatten(0,1), y.flatten())
        losses.append(loss.item())
    model.train(was_training)
    return float(np.mean(losses))

def learning_rate(step, steps, warmup, peak):
    if step < warmup:
        return peak*(step+1)/warmup
    fraction = (step-warmup)/max(1,steps-1-warmup)
    return peak*(.1 + .9*(1+math.cos(math.pi*fraction))/2)

@torch.no_grad()
def generate(model, prompt, count=60, temperature=.8, seed=0):
    was_training = model.training
    model.eval()
    ids = tokenizer.encode(prompt).ids
    generator = torch.Generator().manual_seed(seed)
    for _ in range(count):
        tokens = torch.tensor([ids[-model.context:]],device=device)
        with precision():
            logits = model(tokens)[0,-1].float().cpu()
        next_id = torch.multinomial((logits/temperature).softmax(-1),
                                    1,generator=generator).item()
        if next_id == eos:
            break
        ids.append(next_id)
    model.train(was_training)
    return tokenizer.decode(ids)
config = dict(V=4096,d=256,layers=6,heads=8,ff=688,context=256)
torch.manual_seed(0)
model = GPT(**config).to(device)
N = sum(p.numel() for p in model.parameters())
assert N == 5795072
optimizer = make_optimizer(model,3e-3)
print("Parameters:", N)
print("Decayed matrices:",sum(p.numel() for p in optimizer.param_groups[0]["params"]))
print("Undecayed norms:",sum(p.numel() for p in optimizer.param_groups[1]["params"]))
steps, warmup = (150,30) if QUICK else (600,60)
T = config["context"]
train_generator = torch.Generator().manual_seed(0)
valid_generator = torch.Generator().manual_seed(123)
valid_batches = [batch(valid_data,valid_generator,T) for _ in range(20)]
flops_per_token = 6*N + 6*config["layers"]*T*config["d"]
print("Steps:", steps, "tokens/step:",16*T,
      "training FLOPs/token:",flops_per_token)
Parameters: 5795072
Decayed matrices: 5791744
Undecayed norms: 3328
Steps: 150 tokens/step: 4096 training FLOPs/token: 37129728
对二十四道明确的填空题评分
下方每对候选中的第一个是预期答案。按条件对数概率之和为完整续写评分,包括前导空格;不要采样,也不要仅比较首个 token。断言追加选项不改变上下文 token。这是针对故事词汇及简单上下文使用的手写诊断,并非独立基准。多数答案仅凭最后几个词就能判断。
cloze = [
    ('Once upon a time, there was a little girl named', 'Lily', 'table'),
    ('She was very happy because she got a new', 'toy', 'sad'),
    ('The dog wagged its', 'tail', 'book'),
    ('Tom was hungry, so he ate an', 'apple', 'car'),
    ('It was raining, so they took an', 'umbrella', 'elephant'),
    ('At night, the sky was full of', 'stars', 'soup'),
    ('Lily asked, "Can I go to the park?" Mom said, "Yes, you', 'can', 'blue'),
    ('The bird flew up into the', 'sky', 'spoon'),
    ('Ben fell down and hurt his', 'knee', 'cloud'),
    ('They played in the sand at the', 'beach', 'book'),
    ('The ice cream was cold and', 'sweet', 'angry'),
    ('The little boat floated on the', 'water', 'bread'),
    ('He was sad because he lost his', 'ball', 'happy'),
    ('The baby was tired, so she went to', 'sleep', 'fly'),
    ('The fish swam in the', 'pond', 'tree'),
    ('Max wanted to play, but it was time for', 'bed', 'sky'),
    ('The car went fast down the', 'road', 'cake'),
    ('At the end of the day, the sun went', 'down', 'fork'),
    ('Kate lost her red hat in the park. The next day, she went back '
     'to the park to look for her', 'hat', 'dog'),
    ('Ben had a dog and a cat. The dog liked to bark, '
     'and the cat liked to', 'meow', 'bark'),
    ('It was a cold winter day. Outside, the ground was covered with', 'snow', 'sand'),
    ('Lily was sad because her doll was broken. Then Dad fixed it, and '
     'Lily felt', 'happy', 'sad'),
    ('Sam loved to swim. Every day after school, he went to the', 'pool', 'library'),
    ('The sky was dark and full of clouds. Soon it began to', 'rain', 'shine'),
]

@torch.no_grad()
def continuation_score(model, context, option):
    prefix = tokenizer.encode(context).ids
    full = tokenizer.encode(context+" "+option).ids
    assert full[:len(prefix)] == prefix
    ids = torch.tensor([full],device=device)
    with precision():
        logp = model(ids[:,:-1]).float().log_softmax(-1)
    targets = ids[:,1:]
    scores = logp.gather(-1,targets[:,:,None]).squeeze(-1)
    return scores[0,len(prefix)-1:].sum().item()

def cloze_score(model):
    was_training = model.training
    model.eval()
    correct = [continuation_score(model,c,a)>continuation_score(model,c,b)
               for c,a,b in cloze]
    model.train(was_training)
    return sum(correct), sum(correct[:18]), sum(correct[18:])

initial_loss = evaluate(model,valid_batches)
initial_cloze = cloze_score(model)
print(f"Initial validation: {initial_loss:.4f}; uniform ln(V): {math.log(4096):.4f}")
print("Initial cloze (all / local / earlier-context):",initial_cloze)
Initial validation: 8.3274; uniform ln(V): 8.3178
Initial cloze (all / local / earlier-context): (11, 11, 0)
训练、评估和检查点
用专用 CPU 生成器抽取随机窗口。窗口可能重叠;验证来自留出故事,因此低训练损失本身不是测试结果。记录裁剪前范数及实际学习率。固定验证 batch 和填空评分不改变训练采样器状态。
检查点记录下一步编号、权重、Adam 矩、采样器及全局随机状态。只存模型足以推理,却不能复现下一次训练更新。
def training_step(model, optimizer, generator, step):
    lr = learning_rate(step,steps,warmup,3e-3)
    for group in optimizer.param_groups:
        group["lr"] = lr
    x,y = batch(train_data,generator,T)
    optimizer.zero_grad(set_to_none=True)
    with precision():
        logits = model(x)
        loss = F.cross_entropy(logits.float().flatten(0,1),y.flatten())
    loss.backward()
    norm = nn.utils.clip_grad_norm_(model.parameters(),1.0).item()
    optimizer.step()
    return loss.item(),norm,lr

history, validation, resume_reference = [], [], []
wall_start = time.perf_counter()
interval_seconds = 0.0
midpoint = steps//2
for step in range(steps):
    start = time.perf_counter()
    loss,norm,lr = training_step(model,optimizer,train_generator,step)
    if device.type == "cuda":
        torch.cuda.synchronize()
    interval_seconds += time.perf_counter()-start
    history.append(dict(step=step+1,tokens=(step+1)*16*T,
                        loss=loss,grad_norm=norm,lr=lr))
    if midpoint <= step < midpoint+3:
        resume_reference.append(loss)
    if (step+1)%25 == 0:
        rate = 25*16*T/interval_seconds
        proxy = flops_per_token*rate/matmul_rate
        print(f"Step {step+1:3}; tokens {(step+1)*16*T:7}; loss {loss:.4f}; "
              f"norm {norm:.3f}; lr {lr:.2e}; {rate:.0f} tok/s; proxy {proxy:.1%}")
        interval_seconds = 0.0
    if (step+1)%150 == 0:
        val = evaluate(model,valid_batches)
        cloze_result = cloze_score(model)
        validation.append(dict(step=step+1,tokens=(step+1)*16*T,
                               loss=val,cloze=list(cloze_result)))
        print(f"Validation {step+1}: {val:.4f}; cloze {cloze_result}")
    if step+1 == midpoint:
        torch.save(dict(
            config=config,model=model.state_dict(),optimizer=optimizer.state_dict(),
            next_step=step+1,sampler=train_generator.get_state(),
            torch_rng=torch.get_rng_state(),numpy_rng=np.random.get_state(),
            cuda_rng=torch.cuda.get_rng_state_all() if device.type=="cuda" else [],
        ),"midpoint.pt")

elapsed = time.perf_counter()-wall_start
final_loss = evaluate(model,valid_batches)
print(f"Time: {elapsed:.1f}s; final validation {final_loss:.4f}; "
      f"perplexity {math.exp(final_loss):.2f}")
print("Sample:",generate(model,"Once upon a time",count=120))
Step  25; tokens  102400; loss 5.8707; norm 3.043; lr 2.50e-03; 8102 tok/s; proxy 59.1%
Step  50; tokens  204800; loss 5.2623; norm 1.451; lr 2.83e-03; 8153 tok/s; proxy 59.5%
Step  75; tokens  307200; loss 4.6081; norm 0.821; lr 2.19e-03; 7953 tok/s; proxy 58.0%
Step 100; tokens  409600; loss 4.2007; norm 0.535; lr 1.31e-03; 6285 tok/s; proxy 45.8%
Step 125; tokens  512000; loss 4.2029; norm 0.567; lr 5.84e-04; 6088 tok/s; proxy 44.4%
Step 150; tokens  614400; loss 3.9935; norm 0.506; lr 3.00e-04; 7358 tok/s; proxy 53.7%
Validation 150: 3.9858; cloze (15, 12, 3)
Time: 88.4s; final validation 3.9858; perplexity 53.83
Sample: Once upon a time!" there was a little girl was a little girl called with a tree. He was looked down and wanted to work.
验证恢复并保存可交付成果
只加载本地创建的这个检查点。恢复可信 Python 对象需要 weights_only=False;绝不能对不可信文件采用此选项。新优化器对照从相同权重开始,抽取相同窗口,却不恢复 Adam 累积矩。首个损失在首次更新前测量,因此相同;后续损失反映不同轨迹。
def resumed_losses(restore_optimizer):
    saved = torch.load("midpoint.pt",map_location=device,weights_only=False)
    resumed = GPT(**saved["config"]).to(device)
    resumed.load_state_dict(saved["model"])
    opt = make_optimizer(resumed,3e-3)
    if restore_optimizer:
        opt.load_state_dict(saved["optimizer"])
    generator = torch.Generator()
    generator.set_state(saved["sampler"].cpu())
    torch.set_rng_state(saved["torch_rng"].cpu())
    np.random.set_state(saved["numpy_rng"])
    if device.type == "cuda":
        torch.cuda.set_rng_state_all([state.cpu() for state in saved["cuda_rng"]])
    return [training_step(resumed,opt,generator,i)[0]
            for i in range(saved["next_step"],saved["next_step"]+3)]

restored = resumed_losses(True)
fresh = resumed_losses(False)
print("Original:"," ".join(f"{x:.6f}" for x in resume_reference))
print("Restored:"," ".join(f"{x:.6f}" for x in restored))
print("Fresh Adam:"," ".join(f"{x:.6f}" for x in fresh))
maximum_error = max(abs(a-b) for a,b in zip(restored,resume_reference))
print(f"Resume maximum loss error: {maximum_error:.3e}")
assert maximum_error < 1e-5
assert max(abs(a-b) for a,b in zip(fresh,resume_reference)) > 1e-4

torch.save(dict(config=config,model=model.state_dict()),"final-model.pt")
tokenizer.save("tokenizer.json")
metrics = dict(quick=QUICK,parameters=N,config=config,
               train_tokens=len(train_data),valid_tokens=len(valid_data),
               initial_validation=initial_loss,final_validation=final_loss,
               initial_cloze=list(initial_cloze),final_cloze=list(cloze_score(model)),
               elapsed_seconds=elapsed,matmul_flops_per_second=matmul_rate,
               history=history,validation=validation,
               resume_original=resume_reference,resume_restored=restored,
               resume_fresh_optimizer=fresh)
Path("lab2-metrics.json").write_text(json.dumps(metrics,indent=2),encoding="utf8")
fig,ax = plt.subplots(figsize=(7.2,3.6))
ax.plot([r["tokens"] for r in history],[r["loss"] for r in history],
        color="#0072B2",alpha=.65,label="Training batch")
ax.scatter([r["tokens"] for r in validation],[r["loss"] for r in validation],
           color="#D55E00",label="Held-out stories",zorder=3)
ax.set(xlabel="Training tokens seen",ylabel="Cross-entropy (nats/token)",
       title="TinyStories pretraining: loss and learning-rate schedule")
right = ax.twinx()
right.plot([r["tokens"] for r in history],[r["lr"] for r in history],
           color="#009E73",linestyle="--")
right.set_ylabel("Learning rate",color="#009E73")
ax.legend(loc="upper right")
fig.tight_layout()
plt.show()
Original: 4.722644 4.489676 4.691318
Restored: 4.722644 4.489676 4.691318
Fresh Adam: 4.722644 6.282327 5.666222
Resume maximum loss error: 0.000e+00
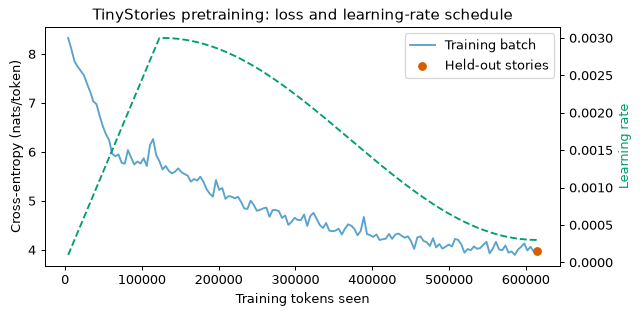
文件保存在实验运行目录,实验运行器使用 labs/module_08/run_lab2/。后续实验自行训练分词器及基座模型,不依赖这些文件。若复用检查点,应与运行记录一起保留固定语料版本及划分。
预期观察
当前 CPU 环境中,QUICK 留出损失从 8.3274 降到 3.9858,填空正确 15/24,其中局部题 12/18、早期上下文题 3/6。独立的 600 步 FULL 运行达到 2.8327,困惑度 16.99,正确 21/24,分别为 18/18、3/6。FULL 还每 25 步记录验证,供更细诊断;额外评估增加耗时,但不改变专用训练采样器。恢复后的三个损失仍精确匹配。记录区分 QUICK 和 FULL;样本与耗时依赖机器。
损失起初接近均匀分布基线,随后学习常见故事模式而下降。填空测试区分局部补全及依赖早期上下文的题目,但每题约改变 4.2 个百分点。少数题改善并非精确的通用能力估计。生成样本可能像故事,却仍有语法或事实错误。
完整检查点复现后三个损失,重新初始化 Adam 矩则改变第二、第三个。验证采用留出故事上的固定窗口。窗口彼此相关,文档划分也未保证重复家族整体划分;在把损失差异解释为精确泛化估计前,应审计这一问题。
进一步尝试
- 用实验 3 的 1.33M 参数结构,在相同估计 FLOP 下训练更多 token,比较留出损失。估算时计入注意力。
- 用稳定阶段及末尾线性衰减替代余弦衰减。在衰减前和训练末尾记录验证,不要把全部改善都归因于更多 token。
- 在 GPU 上逐步扩大宽度和 batch,测量内存、吞吐量,并用对应精度的设备公布峰值计算 MFU。
实验 3 — 引发不稳定,然后诊断其机制
目标。 提高小解码器的学习率,测量注意力 logits 和损失变化,按受控顺序测试预热、梯度裁剪、z-loss 和 QK 归一化,再比较三个学习率的敏感性。修复应针对观察到的故障机制。
若未缓存,本实验下载同一固定版本 10 MB TinyStories,训练自己的分词器并完整定义解码器。九次短训练都从相同种子开始、读取相同窗口。笔记本 CPU 预计需几分钟,也可使用 CUDA 或免费 Colab。
重复数据和模型设置
模型小于实验 2:宽度 128、四层、四头、SwiGLU 宽度 352、上下文 128、嵌入共享。QK 归一化在 RoPE 之前对查询和键应用可学习 RMSNorm。诊断开关测量最后一个训练 batch 中可见因果注意力 logit 的最大绝对值,不改变 SDPA 输出及梯度。
import math
import time
import json
from pathlib import Path
from contextlib import nullcontext
import numpy as np
import pandas as pd
import torch
from torch import nn
from torch.nn import functional as F
import matplotlib.pyplot as plt
from tokenizers import Tokenizer, models, trainers, pre_tokenizers, decoders
from huggingface_hub import hf_hub_download

torch.set_num_threads(4)
torch.manual_seed(0)
np.random.seed(0)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
use_bf16 = device.type == "cuda" and torch.cuda.is_bf16_supported()

def precision():
    return (torch.autocast("cuda", dtype=torch.bfloat16) if use_bf16
            else nullcontext())

revision = "f54c09fd23315a6f9c86f9dc80f725de7d8f9c64"
path = hf_hub_download(
    "roneneldan/TinyStories",
    "data/validation-00000-of-00001-869c898b519ad725.parquet",
    repo_type="dataset", revision=revision,
)
stories = pd.read_parquet(path)["text"].tolist()
order = np.random.default_rng(0).permutation(len(stories))
train_texts = [stories[i] for i in order[1000:]]
valid_texts = [stories[i] for i in order[:1000]]

def train_tokenizer(texts):
    tokenizer = Tokenizer(models.BPE())
    tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=False)
    tokenizer.decoder = decoders.ByteLevel()
    trainer = trainers.BpeTrainer(
        vocab_size=4096, special_tokens=["<|endoftext|>"],
        initial_alphabet=pre_tokenizers.ByteLevel.alphabet(), show_progress=False,
    )
    tokenizer.train_from_iterator(texts, trainer=trainer)
    return tokenizer

tokenizer = train_tokenizer(train_texts)
eos = tokenizer.token_to_id("<|endoftext|>")

def pack(texts, tok=tokenizer):
    ends = tok.token_to_id("<|endoftext|>")
    encoded = tok.encode_batch(texts)
    lengths = [len(item.ids)+1 for item in encoded]
    stream = np.fromiter(
        (token for item in encoded for token in [*item.ids, ends]),
        dtype=np.uint16, count=sum(lengths),
    )
    return torch.from_numpy(stream.astype(np.int64)), lengths

train_data, lengths = pack(train_texts)
valid_data, _ = pack(valid_texts)
print("Device:", device, "bf16 autocast:", use_bf16)
print("Stories:", len(train_texts), "train;", len(valid_texts), "validation")
print("Vocabulary:", tokenizer.get_vocab_size(), "EOS:", eos)
print("Tokens:", len(train_data), "train;", len(valid_data), "validation")
Device: cpu bf16 autocast: False
Stories: 20990 train; 1000 validation
Vocabulary: 4096 EOS: 0
Tokens: 4650186 train; 228958 validation
class RMSNorm(nn.Module):
    def __init__(self, width):
        super().__init__()
        self.weight = nn.Parameter(torch.ones(width))

    def forward(self, x):
        return F.rms_norm(x, (x.shape[-1],), self.weight, eps=1e-5)

class Attention(nn.Module):
    def __init__(self, d, heads, context, qk_norm=False):
        super().__init__()
        self.heads, self.dh = heads, d//heads
        self.qkv = nn.Linear(d, 3*d, bias=False)
        self.out = nn.Linear(d, d, bias=False)
        self.qnorm = RMSNorm(self.dh) if qk_norm else nn.Identity()
        self.knorm = RMSNorm(self.dh) if qk_norm else nn.Identity()
        angles = torch.outer(torch.arange(context),
                             10000**(-torch.arange(0, self.dh, 2)/self.dh))
        self.register_buffer("cos", angles.cos(), persistent=False)
        self.register_buffer("sin", angles.sin(), persistent=False)
        self.probe = False
        self.max_logit = 0.0

    def rotate(self, x):
        pairs = x.reshape(*x.shape[:-1], self.dh//2, 2)
        a, b = pairs.unbind(-1)
        cos = self.cos[:x.shape[-2]].to(x.dtype)
        sin = self.sin[:x.shape[-2]].to(x.dtype)
        return torch.stack((a*cos-b*sin, a*sin+b*cos), -1).flatten(-2)

    def forward(self, x):
        B,T,d = x.shape
        q,k,v = self.qkv(x).chunk(3, -1)
        q,k,v = [y.view(B,T,self.heads,self.dh).transpose(1,2)
                 for y in (q,k,v)]
        q,k = self.rotate(self.qnorm(q)), self.rotate(self.knorm(k))
        if self.probe:
            with torch.no_grad():
                scores = q.float() @ k.float().transpose(-2,-1)/math.sqrt(self.dh)
                causal = torch.ones(T,T,device=x.device,dtype=torch.bool).tril()
                self.max_logit = scores.masked_select(causal).abs().max().item()
        y = F.scaled_dot_product_attention(q,k,v,is_causal=True)
        return self.out(y.transpose(1,2).contiguous().view(B,T,d))

class Block(nn.Module):
    def __init__(self, d, heads, ff, context, qk_norm=False):
        super().__init__()
        self.n1, self.n2 = RMSNorm(d), RMSNorm(d)
        self.attn = Attention(d,heads,context,qk_norm)
        self.gate = nn.Linear(d,ff,bias=False)
        self.up = nn.Linear(d,ff,bias=False)
        self.down = nn.Linear(ff,d,bias=False)

    def forward(self, x):
        x = x + self.attn(self.n1(x))
        y = self.n2(x)
        return x + self.down(F.silu(self.gate(y))*self.up(y))

class GPT(nn.Module):
    def __init__(self, V=4096, d=256, layers=6, heads=8, ff=688,
                 context=256, qk_norm=False):
        super().__init__()
        assert d%heads == 0 and (d//heads)%2 == 0
        self.context = context
        self.embedding = nn.Embedding(V,d)
        self.blocks = nn.ModuleList(
            [Block(d,heads,ff,context,qk_norm) for _ in range(layers)])
        self.norm = RMSNorm(d)
        self.head = nn.Linear(d,V,bias=False)
        self.head.weight = self.embedding.weight
        for param in self.parameters():
            if param.ndim >= 2:
                nn.init.normal_(param,std=.02)
        for block in self.blocks:
            nn.init.normal_(block.attn.out.weight,std=.02/math.sqrt(2*layers))
            nn.init.normal_(block.down.weight,std=.02/math.sqrt(2*layers))

    def forward(self, tokens):
        x = self.embedding(tokens)
        for block in self.blocks:
            x = block(x)
        return self.head(self.norm(x))

def make_optimizer(model, lr):
    matrices = [p for p in model.parameters() if p.ndim >= 2]
    norms = [p for p in model.parameters() if p.ndim < 2]
    return torch.optim.AdamW(
        [{"params": matrices, "weight_decay": .1},
         {"params": norms, "weight_decay": 0.0}],
        lr=lr, betas=(.9,.95), eps=1e-8,
    )

def batch(stream, generator, T, B=16):
    starts = torch.randint(len(stream)-T, (B,), generator=generator)
    indices = starts[:,None] + torch.arange(T+1)
    windows = stream[indices].to(device)
    return windows[:,:-1], windows[:,1:]

@torch.no_grad()
def evaluate(model, batches):
    was_training = model.training
    model.eval()
    losses = []
    for x,y in batches:
        with precision():
            logits = model(x)
            loss = F.cross_entropy(logits.float().flatten(0,1), y.flatten())
        losses.append(loss.item())
    model.train(was_training)
    return float(np.mean(losses))

def learning_rate(step, steps, warmup, peak):
    if step < warmup:
        return peak*(step+1)/warmup
    fraction = (step-warmup)/max(1,steps-1-warmup)
    return peak*(.1 + .9*(1+math.cos(math.pi*fraction))/2)

@torch.no_grad()
def generate(model, prompt, count=60, temperature=.8, seed=0):
    was_training = model.training
    model.eval()
    ids = tokenizer.encode(prompt).ids
    generator = torch.Generator().manual_seed(seed)
    for _ in range(count):
        tokens = torch.tensor([ids[-model.context:]],device=device)
        with precision():
            logits = model(tokens)[0,-1].float().cpu()
        next_id = torch.multinomial((logits/temperature).softmax(-1),
                                    1,generator=generator).item()
        if next_id == eos:
            break
        ids.append(next_id)
    model.train(was_training)
    return tokenizer.decode(ids)
为缩小实验,使用固定训练划分中的前 8,000 篇故事;分词器仍在完整训练划分上拟合。注意力探测测量最后一个 batch,而非整个训练过程的最大值。
train_data, _ = pack(train_texts[:8000])
small_config = dict(V=4096,d=128,layers=4,heads=4,ff=352,context=128)
probe_model = GPT(**small_config)
print("Small model parameters:",sum(p.numel() for p in probe_model.parameters()))
print("Training stream:",len(train_data),"tokens")
del probe_model

def run(lr, warmup=0, clip=None, z_loss=0.0, qk_norm=False, steps=150):
    torch.manual_seed(0)
    model = GPT(**small_config,qk_norm=qk_norm).to(device)
    # Decay all parameters in this controlled sweep, including norm gains.
    optimizer = torch.optim.AdamW(model.parameters(),lr=lr,betas=(.9,.95),
                                 eps=1e-8,weight_decay=.1)
    generator = torch.Generator().manual_seed(0)
    losses, norms, normalisers = [], [], []
    start = time.perf_counter()
    for step in range(steps):
        rate = lr*min(1,(step+1)/warmup) if warmup else lr
        for group in optimizer.param_groups:
            group["lr"] = rate
        for layer in model.blocks:
            layer.attn.probe = step == steps-1
        x,y = batch(train_data,generator,128)
        optimizer.zero_grad(set_to_none=True)
        with precision():
            logits = model(x).float()
            ce = F.cross_entropy(logits.flatten(0,1),y.flatten())
            logZ = torch.logsumexp(logits,-1)
            objective = ce + z_loss*logZ.square().mean()
        if not torch.isfinite(objective):
            raise RuntimeError(f"Non-finite objective at lr={lr}, step={step}")
        objective.backward()
        norm = nn.utils.clip_grad_norm_(
            model.parameters(),clip if clip is not None else float("inf"))
        optimizer.step()
        losses.append(ce.item())
        norms.append(norm.item())
        normalisers.append(logZ.detach().mean().item())
    return dict(lr=lr,warmup=warmup,clip=clip,z_loss=z_loss,qk_norm=qk_norm,
                final_loss=float(np.mean(losses[-20:])),worst_loss=max(losses[20:]),
                attention_logit=max(b.attn.max_logit for b in model.blocks),
                logZ=float(np.mean(normalisers[-20:])),max_grad_norm=max(norms),
                seconds=time.perf_counter()-start,losses=losses)
Small model parameters: 1328256
Training stream: 1779818 tokens
逐项添加稳定措施
保持高学习率不变,每次加一项干预。最后的比较,只在已有其他三项措施的运行中加入 QK 归一化。交叉熵与 z-loss 分别记录,防止目标改变造成比较中的表观改善。
specs = [
    ("reference",dict(lr=.003)),
    ("high rate",dict(lr=.03)),
    ("+ warmup",dict(lr=.03,warmup=50)),
    ("+ clipping",dict(lr=.03,warmup=50,clip=1.0)),
    ("+ z-loss",dict(lr=.03,warmup=50,clip=1.0,z_loss=1e-4)),
    ("+ QK norm",dict(lr=.03,warmup=50,clip=1.0,z_loss=1e-4,qk_norm=True)),
]
results = {}
print("Condition       final CE   worst CE   |attn logit|  mean logZ  max grad")
for name,settings in specs:
    result = run(**settings)
    results[name] = result
    print(f"{name:15} {result['final_loss']:8.3f} {result['worst_loss']:10.3f} "
          f"{result['attention_logit']:14.1f} {result['logZ']:10.2f} "
          f"{result['max_grad_norm']:9.2f}")

fig,ax = plt.subplots(figsize=(7.2,3.6))
for name,color in [("reference","#0072B2"),("high rate","#D55E00"),
                   ("+ z-loss","#CC79A7"),("+ QK norm","#009E73")]:
    ax.plot(np.arange(1,151),results[name]["losses"],label=name,color=color,alpha=.8)
ax.set(xlabel="Training step",ylabel="Cross-entropy (nats/token)",
       title="High learning rate: distinguish the failure and its intervention")
ax.legend()
fig.tight_layout()
plt.show()
Condition       final CE   worst CE   |attn logit|  mean logZ  max grad
reference          4.273      5.948           28.4       8.92      3.00
high rate          5.234      6.285          971.7       8.22      5.94
+ warmup           5.389      6.313          975.6       8.12      5.97
+ clipping         5.549      6.337          752.7       7.81     16.05
+ z-loss           5.478      6.343         1138.2       7.82     15.77
+ QK norm          4.786      6.151           12.4       8.59      8.76
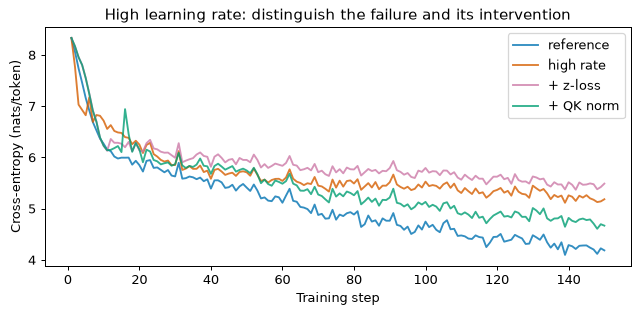
测量学习率敏感性
复用两个已测的无干预运行和高学习率稳定运行,再增加三次训练完成扫描。这些是相同步数后的训练损失,不是九个选定检查点的留出评估。用于诊断优化后,仍需独立验证所选方案。
rates = [.003,.03,.1]
bare = [results["reference"],results["high rate"],run(.1)]
all_fixes = [run(.003,warmup=50,clip=1,z_loss=1e-4,qk_norm=True),
             results["+ QK norm"],
             run(.1,warmup=50,clip=1,z_loss=1e-4,qk_norm=True)]
print("lr       bare CE   all-fixes CE   bare logit   all-fixes logit")
for lr,a,b in zip(rates,bare,all_fixes):
    print(f"{lr:5.3f} {a['final_loss']:10.3f} {b['final_loss']:14.3f} "
          f"{a['attention_logit']:12.1f} {b['attention_logit']:17.1f}")
metrics = dict(config=small_config,conditions=results,
               sweep_bare=bare,sweep_all=all_fixes)
Path("lab3-metrics.json").write_text(json.dumps(metrics,indent=2),encoding="utf8")
fig,ax = plt.subplots(figsize=(7.2,3.6))
ax.semilogx(rates,[r["final_loss"] for r in bare],"o-",color="#D55E00",
            label="Bare constant rate")
ax.semilogx(rates,[r["final_loss"] for r in all_fixes],"s-",color="#0072B2",
            label="Warmup + clip + z-loss + QK norm")
ax.set(xlabel="Peak learning rate",ylabel="Mean last-20-step loss (nats/token)",
       title="Learning-rate sensitivity of the small TinyStories model")
ax.legend()
fig.tight_layout()
plt.show()
lr       bare CE   all-fixes CE   bare logit   all-fixes logit
0.003      4.273          4.024         28.4               7.0
0.030      5.234          4.786        971.7              12.4
0.100      5.498          4.916       2632.1               8.7
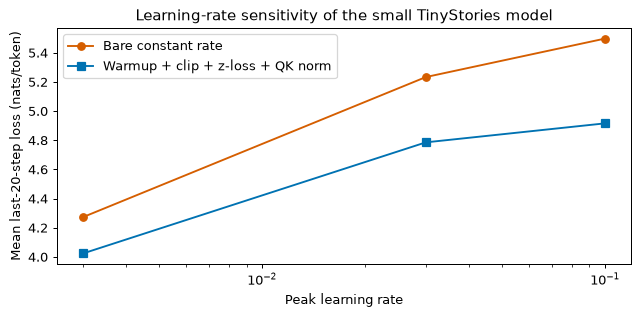
预期观察
同时比较损失和注意力 logit 增长。较大注意力 logits 会使 softmax 行过度集中、优化变差,即使所有记录的损失仍有限。裁剪约束梯度范数,不约束注意力 logits;z-loss 约束输出归一化常数,不约束查询与键的范数;预热改变初期更新大小,却不直接限制最终增长。
QK 归一化直接控制查询和键的尺度,但可学习增益意味着上界并非单位 RMS 向量的固定 \sqrt{d_h}。应从实测表格判断其收益,不能预设对任意架构和学习率都有效。干预可扩大可用范围,而更低学习率仍可能更好。换种子重复实验,检验各差距是否稳定。
进一步尝试
- 记录训练中各头注意力熵,比较熵下降与损失、logit 增长。只看最后一步最大值,会漏掉塌缩发生时间。
- 去掉权重衰减并延长训练。固定 QK 归一化,比较有无 z-loss 时的平均输出对数归一化常数。
- 在宽度 256 重复,比较最优学习率。超参数迁移应跨宽度测试,不能从单次成功训练推断。
实验 4 — 预算和内存计算器
目标。 将模型结构换算为训练预算和内存估计,比较 ZeRO 阶段、激活检查点、micro-batch 大小、流水线气泡和检查点间隔。不需数据集、模型下载或 GPU。公式只是保留明确假设的估算;通过估算的配置仍需实测。
步骤一:参数计数
采用无偏置、RMSNorm、SwiGLU 解码器。假想案例配置与 第 07 模块 相同;其他行用于核对已发布结构及两种计划中的小型训练结构。
import math
import numpy as np

np.random.seed(0)


def params(L, d, n_h, n_kv, d_ff, V, tied=False):
    assert d % n_h == 0 and n_h % n_kv == 0
    attention = 2 * d * d + 2 * d * n_kv * (d // n_h)
    ffn = 3 * d * d_ff
    norms = 2 * d
    blocks = L * (attention + ffn + norms)
    embeddings = V * d * (1 if tied else 2)
    total = blocks + embeddings + d
    return dict(total=total, blocks=blocks, attention=L * attention, ffn=L * ffn,
                norms=L * norms + d, embeddings=embeddings,
                lookup=0 if tied else V * d)


case = dict(L=36, d=4096, n_h=32, n_kv=8, d_ff=15360, V=152064)
llama3 = dict(L=32, d=4096, n_h=32, n_kv=8, d_ff=14336, V=128256)
recipe = dict(L=12, d=768, n_h=12, n_kv=12, d_ff=2048, V=32000, tied=True)
laptop = dict(L=6, d=256, n_h=8, n_kv=8, d_ff=688, V=4096, tied=True)
for name, cfg in (("case study", case), ("Llama-3 shape", llama3),
                  ("small recipe", recipe), ("laptop shape", laptop)):
    c = params(**cfg)
    rule = 12 * cfg["L"] * cfg["d"] ** 2
    print(f"{name:15s} total {c['total']:>13,}, blocks {c['blocks']:>13,}, "
          f"12Ld^2 {rule:>13,}")
assert params(**case)["total"] == 9_550_729_216
assert params(**llama3)["total"] == 8_030_261_248
assert params(**recipe)["total"] == 109_529_856
assert params(**laptop)["total"] == 5_795_072
case study      total 9,550,729,216, blocks 8,305,016,832, 12Ld^2 7,247,757,312
Llama-3 shape   total 8,030,261,248, blocks 6,979,584,000, 12Ld^2 6,442,450,944
small recipe    total   109,529,856, blocks    84,953,088, 12Ld^2    84,934,656
laptop shape    total     5,795,072, blocks     4,746,240, 12Ld^2     4,718,592
小型方案的块有 84,953,088 个参数,共享嵌入有 24,576,000 个,最终归一化再加 768,总量 109,529,856。若漏掉最终归一化,则为 109,529,088。笔记本模型一行仅计算结构,不需要其他实验的检查点。
第 2 步:训练计算和经过的时间
第 06 模块,第 11 节 给出 FLOP 约定。这里写成函数:不计仅查表的输入嵌入,加入因果平均注意力,再乘训练 token 数。简化公式则计入全部参数、不计注意力。
def train_flops(cfg, tokens, length=8192):
    c = params(**cfg)
    weight = 6 * (c["total"] - c["lookup"])
    attention = 6 * cfg["L"] * cfg["d"] * length
    return (weight + attention) * tokens, 6 * c["total"] * tokens


def compute_for(cfg, tokens, length):
    c = params(**cfg)
    return (6 * (c["total"] - c["lookup"])
            + 6 * cfg["L"] * cfg["d"] * length) * tokens


def gpu_time(compute, sustained, n_gpus):
    gpu_hours = compute / sustained / 3600
    return gpu_hours, gpu_hours / n_gpus


for tokens, gpus in ((2e12, 80), (2e9, 8)):
    compute, quick = train_flops(case, tokens)
    gpu_hours, hours = gpu_time(compute, 4e14, gpus)
    print(f"{tokens:.0e} tokens, {gpus} GPUs: {compute:.3e} FLOPs, "
          f"{gpu_hours:,.1f} GPU-hours, {hours:.2f} hours ({hours / 24:.2f} days)")
    print(f"  6 N_total D shortcut: {quick:.3e} FLOPs, {quick / compute - 1:.1%}")
for mfu in (0.30, 0.40, 0.50):
    compute = compute_for(case, 2e12, 8192)
    _, hours = gpu_time(compute, 989e12 * mfu, 80)
    print(f"assumed MFU {mfu:.0%}: {hours / 24:.1f} days on 80 GPUs")
small_compute = compute_for(recipe, 2.5e9, 2048)
print(f"small recipe: {small_compute:.3e} FLOPs including attention")
2e+12 tokens, 80 GPUs: 1.216e+23 FLOPs, 84,465.3 GPU-hours, 1055.82 hours (43.99 days)
  6 N_total D shortcut: 1.146e+23 FLOPs, -5.8%
2e+09 tokens, 8 GPUs: 1.216e+20 FLOPs, 84.5 GPU-hours, 10.56 hours (0.44 days)
  6 N_total D shortcut: 1.146e+20 FLOPs, -5.8%
assumed MFU 30%: 59.3 days on 80 GPUs
assumed MFU 40%: 44.5 days on 80 GPUs
assumed MFU 50%: 35.6 days on 80 GPUs
small recipe: 1.926e+18 FLOPs including attention
峰值 989 TFLOP/s 和持续 4\times10^{14} FLOP/s 是此计算的假设输入。MFU 的分子分母必须采用一致运算约定。这些时间不含停机,并假设持续速率已反映所选实现的通信和重计算开销。
步骤 3:分片下的模型状态
假设权重 2 字节、梯度 2 字节、fp32 主权重及两个 Adam 矩共 12 字节。纯数据并行复制全部 16 字节。ZeRO-1 分片 12 字节优化器状态,ZeRO-2 再分片梯度,ZeRO-3 再分片权重。实际系统可能采用不同梯度类型或主权重策略。
def model_states(N, replicas, stage):
    assert replicas >= 1
    if stage == "DP":
        return N * 16
    if stage == 1:
        return N * (4 + 12 / replicas)
    if stage == 2:
        return N * (2 + 14 / replicas)
    if stage == 3:
        return N * 16 / replicas
    raise ValueError("stage must be DP, 1, 2 or 3")


N = params(**case)["total"]
for replicas in (8, 64, 80):
    sizes = [model_states(N, replicas, stage) / 1e9 for stage in ("DP", 1, 2, 3)]
    print(f"{replicas:2d} GPUs: DP, ZeRO-1, ZeRO-2, ZeRO-3 GB "
          + ", ".join(f"{size:.1f}" for size in sizes))
 8 GPUs: DP, ZeRO-1, ZeRO-2, ZeRO-3 GB 152.8, 52.5, 35.8, 19.1
64 GPUs: DP, ZeRO-1, ZeRO-2, ZeRO-3 GB 152.8, 40.0, 21.2, 2.4
80 GPUs: DP, ZeRO-1, ZeRO-2, ZeRO-3 GB 152.8, 39.6, 20.8, 1.9
ZeRO-3 的常驻权重分片不是峰值分配。计算一层时需聚集其权重,通信缓冲区和重叠聚集还要额外内存。下方容量表是组成项估算,不是分配器保证。
第 4 步:激活、logits 与容量
采用融合注意力时,保存激活的近似预算为 BTL(12d+4n_{\text{kv}}d_{\text{head}}+6d_{\text{ff}}) 字节。完整检查点保存 bf16 层输入,并留出一层重算工作区。Logits 单列估算,每个词表 logit 为 fp32 损失保留 4 字节。融合损失可能用得更少,若额外生成概率张量则可能更多。
def activations(cfg, T, micro_batch, checkpoint=False, flash=True):
    L, d = cfg["L"], cfg["d"]
    kv_width = cfg["n_kv"] * (d // cfg["n_h"])
    layer = micro_batch * T * (12 * d + 4 * kv_width + 6 * cfg["d_ff"])
    if not flash:
        layer += 2 * micro_batch * cfg["n_h"] * T * T
    if checkpoint:
        return 2 * micro_batch * T * d * L + layer
    return L * layer


def logits_bytes(cfg, T, micro_batch):
    return 4 * micro_batch * T * cfg["V"]


print(f"case activations: {activations(case, 8192, 1) / 1e9:.2f} GB")
print(f"case checkpointed: {activations(case, 8192, 1, True) / 1e9:.2f} GB")
print(f"case logits: {logits_bytes(case, 8192, 1) / 1e9:.2f} GB")
probabilities = 2 * case["L"] * case["n_h"] * 8192 ** 2
print(f"additional dense bf16 attention probabilities: {probabilities / 1e9:.1f} GB")


def fit(name, cfg, replicas, stage, T, micro_batch, checkpoint, capacity):
    states = model_states(params(**cfg)["total"], replicas, stage)
    acts = activations(cfg, T, micro_batch, checkpoint)
    logits = logits_bytes(cfg, T, micro_batch)
    total = (states + acts + logits) / 1e9
    print(f"{name:27s} states {states / 1e9:5.2f}, acts {acts / 1e9:5.2f}, "
          f"logits {logits / 1e9:4.2f}, total {total:5.2f} GB; "
          f"under {capacity} GB: {total < capacity}")
    return total


fit("case ZeRO-3, 8 GPUs", case, 8, 3, 8192, 1, False, 80)
fit("case ZeRO-3, checkpointed", case, 8, 3, 8192, 1, True, 80)
fit("case ZeRO-1, 80 GPUs", case, 80, 1, 8192, 1, False, 80)
for micro_batch in (16, 32):
    fit(f"small recipe batch {micro_batch}", recipe, 1, "DP", 2048,
        micro_batch, False, 24)
case activations: 42.88 GB
case checkpointed: 3.61 GB
case logits: 4.98 GB
additional dense bf16 attention probabilities: 154.6 GB
case ZeRO-3, 8 GPUs         states 19.10, acts 42.88, logits 4.98, total 66.97 GB; under 80 GB: True
case ZeRO-3, checkpointed   states 19.10, acts  3.61, logits 4.98, total 27.69 GB; under 80 GB: True
case ZeRO-1, 80 GPUs        states 39.64, acts 42.88, logits 4.98, total 87.50 GB; under 80 GB: False
small recipe batch 16       states  1.75, acts  9.66, logits 4.19, total 15.61 GB; under 24 GB: True
small recipe batch 32       states  1.75, acts 19.33, logits 8.39, total 29.47 GB; under 24 GB: False
数值未包含分配器碎片、通信缓冲区、临时聚集权重及其他框架分配。应留余量并测峰值。减小 micro-batch、增加梯度累积,可保持全局 token batch 同时降低激活需求,却不降低常驻优化器状态。
第五步:流水线气泡和恢复间隔
理想均衡流水线有 p 阶段、m 个 micro-batch,简单气泡比例为 (p-1)/(m+p-1)。实际调度、不均衡层及交错会改变它。检查点写入耗时 \delta、平均中断间隔 M 时,近似开销为 \delta/\tau+\tau/(2M)。对间隔 \tau 求导,得到 \tau^*=\sqrt{2\delta M}。
def bubble(stages, micro_batches):
    return (stages - 1) / (micro_batches + stages - 1)


def young_interval(write_seconds, mtbf_seconds):
    return math.sqrt(2 * write_seconds * mtbf_seconds)


for stages, micro_batches in ((4, 4), (4, 16), (8, 8), (8, 64)):
    print(f"pipeline p={stages}, m={micro_batches}: "
          f"bubble {bubble(stages, micro_batches):.1%}")
for mtbf_hours in (3.09, 633):
    interval = young_interval(60, mtbf_hours * 3600)
    overhead = 60 / interval + interval / (2 * mtbf_hours * 3600)
    print(f"MTBF {mtbf_hours:.2f} hours: checkpoint every {interval / 60:.1f} minutes "
          f"({interval / 3600:.2f} hours), estimated overhead {overhead:.1%}")
pipeline p=4, m=4: bubble 42.9%
pipeline p=4, m=16: bubble 15.8%
pipeline p=8, m=8: bubble 46.7%
pipeline p=8, m=64: bubble 9.9%
MTBF 3.09 hours: checkpoint every 19.3 minutes (0.32 hours), estimated overhead 10.4%
MTBF 633.00 hours: checkpoint every 275.6 minutes (4.59 hours), estimated overhead 0.7%
中断率是假设情景。按独立单设备故障扩展只是粗略规划模型;共享网络与存储故障未必遵循它。间隔公式忽略重启时间,假设检查点完整可恢复。长期运行前,测试优化器、调度、RNG 及加载器状态恢复。
第 6 步:重现五行简化估算表
此表与上方考虑架构的估算分开。全部采用舍入后的 9.5B 参数及 6ND,对应第 1 节的快速估算。这些是规划情景,不是已完成训练的记录。
shortcut_rows = [
    ("9.5B / 190B", 9.5e9, 190e9, 16),
    ("9.5B / 2T", 9.5e9, 2e12, 80),
    ("9.5B / 15T", 9.5e9, 15e12, 80),
    ("1B / 20B", 1e9, 20e9, 4),
    ("9.5B CPT / 2B", 9.5e9, 2e9, 8),
]
print("Shortcut scenario   FLOPs       GPU-hours GPUs     days")
for name, N, D, gpus in shortcut_rows:
    compute = 6*N*D
    gpu_hours, hours = gpu_time(compute, 4e14, gpus)
    print(f"{name:18} {compute:9.3e} {gpu_hours:11,.1f} "
          f"{gpus:4d} {hours/24:8.2f}")
Shortcut scenario   FLOPs       GPU-hours GPUs     days
9.5B / 190B        1.083e+22     7,520.8   16    19.59
9.5B / 2T          1.140e+23    79,166.7   80    41.23
9.5B / 15T         8.550e+23   593,750.0   80   309.24
1B / 20B           1.200e+20        83.3    4     0.87
9.5B CPT / 2B      1.140e+20        79.2    8     0.41
相同持续吞吐量下,2T token 简化估算为 41.2 天,而本系列计数为 44.0 天。舍入参数和忽略注意力是两种不同近似;将结果写入预算时应保留计数标签。
第 7 步:训练分配与等损失投资回收
采用模块 07 引用的已发表参数定律,参数和 token 使用原始计数。其预算变量为 C_6=6ND,不用考虑架构的 FLOP 函数。在固定 C_6 下,比较解析拟合最小值与每参数二十 token 的点。再求最小训练预算,使其拟合最优模型达到案例预测损失。
等损失最优方案可降低训练成本,却增加每服务 token 成本。用相同近似服务成本 2N,解 C_6+2NS=C'_6+2N'S,得到服务 token 的盈亏平衡点。固定预算最小值的损失不同,不适合回答等质量问题。
def chinchilla_loss(N, D):
    return 1.69 + 406.4/N**.34 + 410.7/D**.28

def chinchilla_optimum(C):
    N = (.34*406.4/(.28*410.7))**(1/(.34+.28))*(C/6)**(.28/(.34+.28))
    return N, C/(6*N)

def equal_loss_payback(N, D):
    target = chinchilla_loss(N, D)
    lo, hi = 15.0, 28.0
    assert chinchilla_loss(*chinchilla_optimum(10**lo)) > target
    assert chinchilla_loss(*chinchilla_optimum(10**hi)) < target
    for _ in range(80):
        middle = (lo+hi)/2
        minimum = chinchilla_loss(*chinchilla_optimum(10**middle))
        if minimum > target:
            lo = middle
        else:
            hi = middle
    Cprime = 10**((lo+hi)/2)
    Nprime, Dprime = chinchilla_optimum(Cprime)
    assert abs(chinchilla_loss(Nprime,Dprime)-target) < 1e-10
    if N < Nprime*(1-1e-8):
        status = "positive served-token break-even"
        served = (6*N*D-Cprime)/(2*(Nprime-N))
    elif N > Nprime*(1+1e-8):
        status = "original allocation costs more to train and serve"
        served = None
    else:
        status = "already at the fitted equal-loss optimum"
        served = None
    return dict(N=Nprime,D=Dprime,C=Cprime,served=served,status=status)

N = params(**case)["total"]
D = 2e12
C6 = 6*N*D
Nopt,Dopt = chinchilla_optimum(C6)
N20 = math.sqrt(C6/120)
D20 = 20*N20
for name,n,tokens in [("case study",N,D), ("fixed-budget fitted",Nopt,Dopt),
                      ("fixed-budget 20/token",N20,D20)]:
    print(f"{name:23} N {n/1e9:7.3f}B; D {tokens/1e12:6.3f}T; "
          f"loss {chinchilla_loss(n,tokens):.6f}")
payback = equal_loss_payback(N,D)
print(f"Equal-loss fitted: N {payback['N']/1e9:.3f}B; "
      f"D {payback['D']/1e12:.3f}T; C6 {payback['C']:.3e}")
print("Status:",payback["status"])
if payback["served"] is not None:
    print("Served-token break-even:",f"{payback['served']:.3e}")
case study              N   9.551B; D  2.000T; loss 2.001990
fixed-budget fitted     N  15.526B; D  1.230T; loss 1.998483
fixed-budget 20/token   N  30.904B; D  0.618T; loss 2.005373
Equal-loss fitted: N 15.018B; D 1.182T; C6 1.065e+23
Status: positive served-token break-even
Served-token break-even: 7.439e+11
这些是外推预测,参数规模和 token 数都超出原始拟合实验。盈亏平衡比较模型运算量,不含注意力、量化、容量、batch 和价格,也不表示两模型在团队安全案例评估上得分相同。对应交互规划器明确展示相同假设。
预期观察
2T token 基座计划约需 1.22\times10^{23} 模型 FLOP,2B token 继续预训练为其千分之一。八张 GPU 上,DP 与 ZeRO 阶段 1–3 的每 GPU 状态估计依次为 152.8、52.5、35.8、19.1 GB。完整检查点将激活从约 42.9 降至 3.61 GB,代价是重算;这些数值未计入全部运行时分配。
进一步尝试
- 扫描 micro-batch 大小,绘制有无检查点的总内存。对实测临时分配和通信分配单独标出余量。
- 改用 fp32 梯度,再加入一个与 fp32 logits 同大小的损失中间张量,观察哪些原本看似可容纳的配置超限。
- 将 FFN 换成八专家、top-2 路由。区分全部存储权重与激活计算参数;分片及容量必须计入所有专家,包括未选中的专家。
实验 5 — 有无回放的继续预训练
目标。 在本实验内训练小型故事基座模型,适配到合成安全案例文本,测量回放比例和学习率对领域适配及遗忘的影响。用训练前固定的验收门槛比较各次运行。
使用相同固定版本 10 MB TinyStories,未缓存则下载。本实验自行训练分词器和基座模型,不读实验 2 检查点。CPU 预计需几分钟,也可用免费 Colab GPU。生成的工程语句都是虚构训练文本,其证据和完整性目标也是假设,不能证明任何真实系统满足安全要求。
独立定义基座模型
为独立运行,再次定义模型:宽度 128、四层、四头、前馈宽度 352、上下文 128。分词器仅用通用故事训练,适配过程中保持固定。
import math
import time
import json
from pathlib import Path
from contextlib import nullcontext
import numpy as np
import pandas as pd
import torch
from torch import nn
from torch.nn import functional as F
import matplotlib.pyplot as plt
from tokenizers import Tokenizer, models, trainers, pre_tokenizers, decoders
from huggingface_hub import hf_hub_download

torch.set_num_threads(4)
torch.manual_seed(0)
np.random.seed(0)
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
use_bf16 = device.type == "cuda" and torch.cuda.is_bf16_supported()

def precision():
    return (torch.autocast("cuda", dtype=torch.bfloat16) if use_bf16
            else nullcontext())

revision = "f54c09fd23315a6f9c86f9dc80f725de7d8f9c64"
path = hf_hub_download(
    "roneneldan/TinyStories",
    "data/validation-00000-of-00001-869c898b519ad725.parquet",
    repo_type="dataset", revision=revision,
)
stories = pd.read_parquet(path)["text"].tolist()
order = np.random.default_rng(0).permutation(len(stories))
train_texts = [stories[i] for i in order[1000:]]
valid_texts = [stories[i] for i in order[:1000]]

def train_tokenizer(texts):
    tokenizer = Tokenizer(models.BPE())
    tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=False)
    tokenizer.decoder = decoders.ByteLevel()
    trainer = trainers.BpeTrainer(
        vocab_size=4096, special_tokens=["<|endoftext|>"],
        initial_alphabet=pre_tokenizers.ByteLevel.alphabet(), show_progress=False,
    )
    tokenizer.train_from_iterator(texts, trainer=trainer)
    return tokenizer

tokenizer = train_tokenizer(train_texts)
eos = tokenizer.token_to_id("<|endoftext|>")

def pack(texts, tok=tokenizer):
    ends = tok.token_to_id("<|endoftext|>")
    encoded = tok.encode_batch(texts)
    lengths = [len(item.ids)+1 for item in encoded]
    stream = np.fromiter(
        (token for item in encoded for token in [*item.ids, ends]),
        dtype=np.uint16, count=sum(lengths),
    )
    return torch.from_numpy(stream.astype(np.int64)), lengths

train_data, lengths = pack(train_texts)
valid_data, _ = pack(valid_texts)
print("Device:", device, "bf16 autocast:", use_bf16)
print("Stories:", len(train_texts), "train;", len(valid_texts), "validation")
print("Vocabulary:", tokenizer.get_vocab_size(), "EOS:", eos)
print("Tokens:", len(train_data), "train;", len(valid_data), "validation")
Device: cpu bf16 autocast: False
Stories: 20990 train; 1000 validation
Vocabulary: 4096 EOS: 0
Tokens: 4650186 train; 228958 validation
class RMSNorm(nn.Module):
    def __init__(self, width):
        super().__init__()
        self.weight = nn.Parameter(torch.ones(width))

    def forward(self, x):
        return F.rms_norm(x, (x.shape[-1],), self.weight, eps=1e-5)

class Attention(nn.Module):
    def __init__(self, d, heads, context, qk_norm=False):
        super().__init__()
        self.heads, self.dh = heads, d//heads
        self.qkv = nn.Linear(d, 3*d, bias=False)
        self.out = nn.Linear(d, d, bias=False)
        self.qnorm = RMSNorm(self.dh) if qk_norm else nn.Identity()
        self.knorm = RMSNorm(self.dh) if qk_norm else nn.Identity()
        angles = torch.outer(torch.arange(context),
                             10000**(-torch.arange(0, self.dh, 2)/self.dh))
        self.register_buffer("cos", angles.cos(), persistent=False)
        self.register_buffer("sin", angles.sin(), persistent=False)
        self.probe = False
        self.max_logit = 0.0

    def rotate(self, x):
        pairs = x.reshape(*x.shape[:-1], self.dh//2, 2)
        a, b = pairs.unbind(-1)
        cos = self.cos[:x.shape[-2]].to(x.dtype)
        sin = self.sin[:x.shape[-2]].to(x.dtype)
        return torch.stack((a*cos-b*sin, a*sin+b*cos), -1).flatten(-2)

    def forward(self, x):
        B,T,d = x.shape
        q,k,v = self.qkv(x).chunk(3, -1)
        q,k,v = [y.view(B,T,self.heads,self.dh).transpose(1,2)
                 for y in (q,k,v)]
        q,k = self.rotate(self.qnorm(q)), self.rotate(self.knorm(k))
        if self.probe:
            with torch.no_grad():
                scores = q.float() @ k.float().transpose(-2,-1)/math.sqrt(self.dh)
                causal = torch.ones(T,T,device=x.device,dtype=torch.bool).tril()
                self.max_logit = scores.masked_select(causal).abs().max().item()
        y = F.scaled_dot_product_attention(q,k,v,is_causal=True)
        return self.out(y.transpose(1,2).contiguous().view(B,T,d))

class Block(nn.Module):
    def __init__(self, d, heads, ff, context, qk_norm=False):
        super().__init__()
        self.n1, self.n2 = RMSNorm(d), RMSNorm(d)
        self.attn = Attention(d,heads,context,qk_norm)
        self.gate = nn.Linear(d,ff,bias=False)
        self.up = nn.Linear(d,ff,bias=False)
        self.down = nn.Linear(ff,d,bias=False)

    def forward(self, x):
        x = x + self.attn(self.n1(x))
        y = self.n2(x)
        return x + self.down(F.silu(self.gate(y))*self.up(y))

class GPT(nn.Module):
    def __init__(self, V=4096, d=256, layers=6, heads=8, ff=688,
                 context=256, qk_norm=False):
        super().__init__()
        assert d%heads == 0 and (d//heads)%2 == 0
        self.context = context
        self.embedding = nn.Embedding(V,d)
        self.blocks = nn.ModuleList(
            [Block(d,heads,ff,context,qk_norm) for _ in range(layers)])
        self.norm = RMSNorm(d)
        self.head = nn.Linear(d,V,bias=False)
        self.head.weight = self.embedding.weight
        for param in self.parameters():
            if param.ndim >= 2:
                nn.init.normal_(param,std=.02)
        for block in self.blocks:
            nn.init.normal_(block.attn.out.weight,std=.02/math.sqrt(2*layers))
            nn.init.normal_(block.down.weight,std=.02/math.sqrt(2*layers))

    def forward(self, tokens):
        x = self.embedding(tokens)
        for block in self.blocks:
            x = block(x)
        return self.head(self.norm(x))

def make_optimizer(model, lr):
    matrices = [p for p in model.parameters() if p.ndim >= 2]
    norms = [p for p in model.parameters() if p.ndim < 2]
    return torch.optim.AdamW(
        [{"params": matrices, "weight_decay": .1},
         {"params": norms, "weight_decay": 0.0}],
        lr=lr, betas=(.9,.95), eps=1e-8,
    )

def batch(stream, generator, T, B=16):
    starts = torch.randint(len(stream)-T, (B,), generator=generator)
    indices = starts[:,None] + torch.arange(T+1)
    windows = stream[indices].to(device)
    return windows[:,:-1], windows[:,1:]

@torch.no_grad()
def evaluate(model, batches):
    was_training = model.training
    model.eval()
    losses = []
    for x,y in batches:
        with precision():
            logits = model(x)
            loss = F.cross_entropy(logits.float().flatten(0,1), y.flatten())
        losses.append(loss.item())
    model.train(was_training)
    return float(np.mean(losses))

def learning_rate(step, steps, warmup, peak):
    if step < warmup:
        return peak*(step+1)/warmup
    fraction = (step-warmup)/max(1,steps-1-warmup)
    return peak*(.1 + .9*(1+math.cos(math.pi*fraction))/2)

@torch.no_grad()
def generate(model, prompt, count=60, temperature=.8, seed=0):
    was_training = model.training
    model.eval()
    ids = tokenizer.encode(prompt).ids
    generator = torch.Generator().manual_seed(seed)
    for _ in range(count):
        tokens = torch.tensor([ids[-model.context:]],device=device)
        with precision():
            logits = model(tokens)[0,-1].float().cpu()
        next_id = torch.multinomial((logits/temperature).softmax(-1),
                                    1,generator=generator).item()
        if next_id == eos:
            break
        ids.append(next_id)
    model.train(was_training)
    return tokenizer.decode(ids)
生成领域文本并检查分词器适配程度
八个玩具系统提供不同工程词汇,第一个为案例中的泄压系统。随机组合原因、缓解措施、证据标签和时间声明,形成共享模板的不同文本。留出 300 篇不同文档,明确排除跨划分精确重复。共享模板使适配较容易,留出损失却不检验所生成论证是否合理。
systems = [
    ("the pressure-relief system","a chemical plant","SIL 3",
     ["overpressure of the reactor vessel","a relief valve that fails to open",
      "a blocked vent line"]),
    ("a braking controller","a road vehicle","ASIL D",
     ["loss of braking","unintended braking","a stuck brake actuator"]),
    ("a reactor protection system","a power station","SIL 3",
     ["failure to shut down","a missed trip signal","a sensor disagreement"]),
    ("a flight control computer","an aircraft","DAL A",
     ["loss of control","an erroneous command","a frozen input"]),
    ("a railway interlocking","a railway station","SIL 3",
     ["a conflicting route","a wrong signal aspect","an unlocked point"]),
    ("a battery management system","a road vehicle","ASIL B",
     ["thermal runaway","overcharging","an isolation fault"]),
    ("a robot arm controller","a factory","SIL 2",
     ["unexpected motion","a trapped operator","an overspeed condition"]),
    ("a ventilator","a hospital","a specified integrity target",
     ["loss of airflow","excess pressure","a missed alarm"]),
]
causes = ["a stuck sensor","a corrupted message","a timing fault",
          "a failed actuator","an incorrect configuration","a software defect",
          "a disconnected cable","a power interruption"]
mitigations = ["a hardware watchdog that forces a safe state",
               "an independent shutdown channel","a checked redundant sensor",
               "a monitored interlock","a periodic diagnostic test",
               "a fail-safe actuator","a range and timing check"]
evidence = ["Fault tree analysis","Failure modes and effects analysis",
            "An integration test","A requirements review",
            "A fault-injection test","An independent assessment"]
rng = np.random.default_rng(0)
documents, seen = [], set()
while len(documents) < 3300:
    index = len(documents)%len(systems)
    system,environment,target,hazards = systems[index]
    hazard = hazards[0] if not documents else str(rng.choice(hazards))
    cause = str(rng.choice(causes))
    mitigation = str(rng.choice(mitigations))
    proof = str(rng.choice(evidence))
    delay = int(rng.choice([10,20,50,100,200,500,1000]))
    document = "\n".join([
        f"Context C1: The system is {system} operating in {environment}.",
        f"Goal G1: {system.capitalize()} is acceptably safe in its environment.",
        f"Context C2: The illustrative integrity target is {target}.",
        f"Strategy S1: Argue over identified hazards and their mitigations.",
        f"Goal G2: The hazard of {hazard} is acceptably mitigated.",
        f"Assumption A1: A single fault such as {cause} can initiate the hazard.",
        f"Strategy S2: Use {mitigation} and independent diagnostic coverage.",
        f"Goal G3: The fault is detected and a safe state reached within {delay} ms.",
        f"Solution Sn1: {proof} shows that {mitigation} detects the fault "
        f"within {delay} ms.",
        "Justification J1: The claimed evidence must be checked against the "
        "requirements, operating assumptions and configuration of the system.",
        "Context C3: This is synthetic tutorial text; the evidence is not real.",
    ])
    if document not in seen:
        documents.append(document)
        seen.add(document)
domain_train,domain_valid = documents[:3000],documents[3000:]
assert not set(domain_train)&set(domain_valid)
domain_data,_ = pack(domain_train)
domain_valid_data,_ = pack(domain_valid)
print(documents[0])
print("Domain tokens:",len(domain_data),"train;",len(domain_valid_data),"validation")

def tokens_per_word(tok,texts):
    encoded = tok.encode_batch(texts)
    return sum(len(x.ids) for x in encoded)/sum(len(x.split()) for x in texts)

mixed_texts = train_texts[:12000]+domain_train
mixed_tokenizer = train_tokenizer(mixed_texts)
fraction = sum(map(len,domain_train))/sum(map(len,mixed_texts))
fit = {}
for name,tok in [("story tokenizer",tokenizer),("mixed tokenizer",mixed_tokenizer)]:
    general = tokens_per_word(tok,valid_texts)
    domain = tokens_per_word(tok,domain_valid)
    fit[name] = dict(general=general,domain=domain)
    print(f"{name:16}: general {general:.3f}; domain {domain:.3f} tokens/word")
print(f"Domain character share of mixed-tokenizer training: {fraction:.1%}")
Context C1: The system is the pressure-relief system operating in a chemical plant.
Goal G1: The pressure-relief system is acceptably safe in its environment.
Context C2: The illustrative integrity target is SIL 3.
Strategy S1: Argue over identified hazards and their mitigations.
Goal G2: The hazard of overpressure of the reactor vessel is acceptably mitigated.
Assumption A1: A single fault such as a disconnected cable can initiate the hazard.
Strategy S2: Use a periodic diagnostic test and independent diagnostic coverage.
Goal G3: The fault is detected and a safe state reached within 20 ms.
Solution Sn1: A requirements review shows that a periodic diagnostic test detects the fault within 20 ms.
Justification J1: The claimed evidence must be checked against the requirements, operating assumptions and configuration of the system.
Context C3: This is synthetic tutorial text; the evidence is not real.
Domain tokens: 1075107 train; 107470 validation
story tokenizer : general 1.296; domain 2.535 tokens/word
mixed tokenizer : general 1.304; domain 1.329 tokens/word
Domain character share of mixed-tokenizer training: 20.4%
混合数据分词器仅用于诊断。直接替换故事基座模型的 token ID,会改变嵌入和输出行含义。修改分词器需明确转换嵌入并追加训练;本实验保持原词表,隔离回放与学习率的影响。
训练小型基座模型并固定基线
在故事上训练 400 步,采用预热加余弦衰减、仅矩阵权重衰减及梯度裁剪。分别用十个固定 batch 评估通用和领域验证损失。此时就为玩具实验写定门槛:领域损失至少下降 1 奈特,通用损失最多上升 0.20 奈特。这是诊断门槛,不是真实案例的任务验收规则。
config = dict(V=4096,d=128,layers=4,heads=4,ff=352,context=128)
torch.manual_seed(0)
base = GPT(**config).to(device)
print("Base parameters:",sum(p.numel() for p in base.parameters()))
optimizer = make_optimizer(base,3e-3)
generator = torch.Generator().manual_seed(0)
general_generator = torch.Generator().manual_seed(123)
domain_generator = torch.Generator().manual_seed(456)
general_batches = [batch(valid_data,general_generator,128) for _ in range(10)]
domain_batches = [batch(domain_valid_data,domain_generator,128) for _ in range(10)]
start = time.perf_counter()
for step in range(400):
    lr = learning_rate(step,400,30,3e-3)
    for group in optimizer.param_groups:
        group["lr"] = lr
    x,y = batch(train_data,generator,128)
    optimizer.zero_grad(set_to_none=True)
    with precision():
        logits = base(x)
        loss = F.cross_entropy(logits.float().flatten(0,1),y.flatten())
    loss.backward()
    nn.utils.clip_grad_norm_(base.parameters(),1.0)
    optimizer.step()
    if (step+1)%100 == 0:
        print(f"Base step {step+1}: training loss {loss.item():.4f}")
baseline = dict(general=evaluate(base,general_batches),
                domain=evaluate(base,domain_batches))
base_state = {key:value.detach().cpu().clone()
              for key,value in base.state_dict().items()}
print(f"Base time {time.perf_counter()-start:.1f}s; "
      f"general {baseline['general']:.4f}; domain {baseline['domain']:.4f}")
print("Gate fixed: domain reduction >= 1.00 nat; general rise <= 0.20 nat")
Base parameters: 1328256
Base step 100: training loss 4.5289
Base step 200: training loss 4.0240
Base step 300: training loss 3.6192
Base step 400: training loss 3.5745
Base time 31.2s; general 3.5098; domain 7.0185
Gate fixed: domain reduction >= 1.00 nat; general rise <= 0.20 nat
从相同权重继续,改变回放与峰值学习率
每次继续训练采用新的 Adam 状态,预热 10 步,总更新 100 步。每条序列完全来自通用或领域数据;回放按序列做 Bernoulli 抽样,而非强制每 batch 精确比例。各次运行采用同一采样器种子,对齐候选窗口。重新评估相同留出 batch,再应用已定门槛。
def continue_run(replay,peak):
    torch.manual_seed(0)
    model = GPT(**config).to(device)
    model.load_state_dict(base_state)
    optimizer = make_optimizer(model,peak)
    sampler = torch.Generator().manual_seed(0)
    actual_general = 0
    for step in range(100):
        mask = torch.rand(16,generator=sampler) < replay
        gx,gy = batch(train_data,sampler,128)
        dx,dy = batch(domain_data,sampler,128)
        mask_device = mask[:,None].to(device)
        x,y = torch.where(mask_device,gx,dx),torch.where(mask_device,gy,dy)
        actual_general += mask.sum().item()
        lr = learning_rate(step,100,10,peak)
        for group in optimizer.param_groups:
            group["lr"] = lr
        optimizer.zero_grad(set_to_none=True)
        with precision():
            logits = model(x)
            loss = F.cross_entropy(logits.float().flatten(0,1),y.flatten())
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(),1.0)
        optimizer.step()
    general = evaluate(model,general_batches)
    domain = evaluate(model,domain_batches)
    rise = general-baseline["general"]
    reduction = baseline["domain"]-domain
    return model,dict(replay=replay,peak=peak,general=general,domain=domain,
                      general_rise=rise,domain_reduction=reduction,
                      actual_replay=actual_general/1600,
                      passes_gate=rise<=.20 and reduction>=1.00)

conditions = [("low / 0%",0,3e-4),("low / 10%",.1,3e-4),
              ("low / 30%",.3,3e-4),("high / 0%",0,3e-3),
              ("high / 30%",.3,3e-3)]
results, samples = {}, {}
print("Condition     general  domain  general rise  domain reduction  passes gate")
for name,replay,peak in conditions:
    adapted,result = continue_run(replay,peak)
    results[name] = result
    print(f"{name:12} {result['general']:8.3f} {result['domain']:7.3f} "
          f"{result['general_rise']:13.3f} {result['domain_reduction']:17.3f} "
          f"{str(result['passes_gate']):>12}")
    if name in ("low / 0%","low / 30%"):
        samples[name] = {prompt:generate(adapted,prompt)
                         for prompt in ("Goal G1:","Once upon a time")}
    del adapted

samples["base"] = {prompt:generate(base,prompt)
                   for prompt in ("Goal G1:","Once upon a time")}
Path("lab5-metrics.json").write_text(
    json.dumps(dict(config=config,baseline=baseline,tokenizer_fit=fit,
                    results=results,samples=samples),indent=2),encoding="utf8")
fig,ax = plt.subplots(figsize=(7.2,3.6))
colors = ["#D55E00","#E69F00","#009E73","#CC79A7","#0072B2"]
for (name,result),color in zip(results.items(),colors):
    ax.scatter(result["domain_reduction"],result["general_rise"],color=color,
               s=60,label=name)
ax.axhline(.20,color="gray",linestyle="--",label="General-loss gate")
ax.axvline(1.00,color="gray",linestyle=":")
ax.set(xlabel="Domain loss reduction (nats/token)",
       ylabel="General loss rise (nats/token)",
       title="Continued pretraining: adaptation and forgetting")
ax.legend(fontsize=8)
fig.tight_layout()
plt.show()
Condition     general  domain  general rise  domain reduction  passes gate
low / 0%        4.554   2.331         1.044             4.688        False
low / 10%       3.779   2.466         0.269             4.553        False
low / 30%       3.643   2.706         0.133             4.312         True
high / 0%       9.191   0.117         5.681             6.902        False
high / 30%      3.797   0.176         0.287             6.843        False
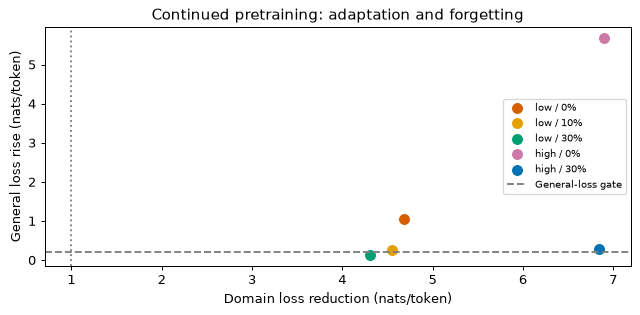
将文本与定量测试进行比较
各提示和模型采用相同采样种子、温度及 token 上限。少量样本展示文本类型,比较则依靠留出损失和预定门槛。看似可信的安全论证仍可能包含伪造证据或无依据声明。
for name in ("base","low / 0%","low / 30%"):
    for prompt,text in samples[name].items():
        print(name,"|",prompt,"|",text.replace("\n"," / "))
base | Goal G1: | Goal G1:!" /  / The squirrel was so sad. She knew that he was scared and she looked down and wanted it. He was very angry and felt sad. He decided to do the stick and it shared it up. They soon smiled and said, "Look, that!" Lila thought for a while.
base | Once upon a time | Once upon a time, there was a little girl named Tim. Timmy loved to play with her friends. /  / She wanted to work his mommy. She went to the rope and decided to do the stick. The boy was very brave and soon he was always tired. So she could have to play with a toy,
low / 0% | Goal G1: | Goal G1: The its for me shoots anarely and a safe inone seArtped. / Context CSt: The red ms end. / Gooretate magfj. / LYor The Thidries in itstose a chegetstate
low / 0% | Once upon a time | Once upon a time, there was a little girl named Tim. / Tf€� was raining, Jane looked at the garden in a zoom ugg in a clxtion accidentally string. / Gooretate Snmet: The dist soon the stles Thaigss the clrate of a safe tra
low / 30% | Goal G1: | Goal G1: The its for me shoots a loud noise and a safe in a scared day. / Goed G1: A fauggor over 1: The end. /  Everyone had a smile and a great time. He thanked the bird and helped her mom that it was hurt. /  / "
low / 30% | Once upon a time | Once upon a time, there was a little girl named Tim. Timmy loved to play with her friends. One day, she saw a big storm old boy named Lily. Timmy loved to play with her friends. One morning, they went to the frog's house,ign. Lily was so happy to find a long time
预期观察
本次基座模型通用/领域损失为 3.510/7.019。低峰值学习率下,请求回放为 0%、10%、30% 时,通用损失分别上升 1.044、0.269、0.133,领域损失最终为 2.331、2.466、2.706,只有最后一个通过门槛。高峰值下,无回放使通用损失上升 5.681,领域降至 0.117;30% 回放将通用增幅降为 0.287、领域为 0.176,但仍超过 0.20 奈特上限。由于抽样,实际回放比例为 10.75%、31.0%。门槛判断发生在查看生成样本之前。
故事分词器将陌生工程词拆成多个片段。领域感知 BPE 可改善压缩,却不能直接替代基座 token 映射。继续训练可降低共享领域模板损失;无回放时,更新可能损害通用留出损失。回放与学习率表展示取舍,包括未通过的条件。
更大学习率可在相同步数预算内更快适配,也更远离基座模型。回放提供保留原分布的梯度,降低学习率则限制移动幅度;两者都不保证保留全部能力。这里采用固定分词器,检查点间损失可比较;跨分词器还需每字节比特数等共同单位。
进一步尝试
- 先确定门槛,再提高回放比例。选择实际适配方案前,换种子重复,并在独立领域模板上评估。
- 给仅领域训练的检查点增加通用数据恢复阶段,再测两类损失。恢复也可能抹去适配收益。
- 用有记录的中英教程文本训练小型 BPE,保留两种语言的混合比例和测试文本。比较压缩,并解释已有基座模型采用任一新映射之前所需的嵌入转换。
练习
采用十进制 GB,并明确本系列的计算约定。缩放定律问题使用原始参数量和 token 数,拟合预算为 C_6=6ND;案例硬件预算则计入随上下文变化的注意力项。
列出预训练前应确定的四项决策:后续改变它们需要放弃已有工作、迁移或修改计划。再举一项可在未来更新中改变的决策,解释两者区别。
查看解答
分词器确定各嵌入/输出行及分片 token 的含义,新映射需重新分词及转换嵌入。模型结构确定张量尺寸和连接,改变宽度、深度或词表需迁移权重或建立新模型,不能原样加载同一检查点。过滤和去重决定已见数据对权重的影响,事后删文档不能撤销更新。预热加余弦调度的终点决定衰减时机;延长训练需主动制定新调度,提前结束则可能未完成退火。
未来的数据混合权重可在有记录的阶段边界改变。Batch 大小、检查点间隔和并行布局也可在适当状态迁移后改变。区别在于修改是否只涉及未来工作,还是使已完成工作的假设失效。前四项都不是禁止后续改变,而是带来必须计入计划的成本。
预算为 C_6=10^{21} FLOP,每参数训练二十 token,计算 N、D 及 1.69+406.4/N^{0.34}+410.7/D^{0.28} 给出的损失。再计算规模缩至四分之一、token 增至四倍的模型。它在推理阶段带来什么收益?
查看解答
代入 D=20N 得到 C_6=120N^2,因此
两个可约减损失项为 0.24684、0.39840,拟合损失为 1.69+0.24684+0.39840=2.33524 奈特/token。替代方案为 N'=7.2169\times10^8、D'=2.3094\times10^{11},保持相同 6N'D',两项变为 0.39547、0.27024,得到 2.35571,比原方案差 0.02047 奈特,约为原总损失的 0.88%;预测困惑度约高 e^{0.02047}-1=2.07\%。
按近似 2N 服务成本,每 token 模型运算量为四分之一,相同权重精度下存储也为四分之一。注意力、batch 和带宽会改变实际延迟关系。每参数二十 token 是经验分配;此预算下,拟合定律自己的最小值约为 1.82B 参数、91.4B token,损失 2.329。这些损失对应拟合分布和分词器,不是保证任务的得分。
团队可使用 64 张 H100 共 30 天,假设每 GPU 密集 bf16 峰值 989 TFLOP/s、MFU 38%。精确案例结构在 8,192 上下文下可训练多少 token?采用 N=9{,}550{,}729{,}216、N_{\text{matmul}}=8{,}927{,}875{,}072、L=36、d=4096,每 token 6N_{\text{matmul}}+6LTd FLOP。使用 6N 简化公式会造成什么调度错误?
查看解答
可用模型计算为
每 token 权重项为 6N_{\text{matmul}}=53{,}567{,}250{,}432,注意力项为 6(36)(8192)(4096)=7{,}247{,}757{,}312 FLOP,合计 60,815,007,744。用总计算预算除以每 token 成本,得到 D=1.02514\times10^{12} token,即每参数 107.34 token,约为 2T token 计划的一半。
简化公式给出 D_6=C/(6N)=1.08795\times10^{12},多估约 6.13% token。按假设持续速率训练这些 token 需 31.84 天。因此,计划在 D_6 结束的余弦调度,会在第 30 天被迫停止,未达到最终衰减点。应按考虑架构的计数规划,再监测实际吞吐量、停机和已完成 token。
推导每带 r 行、共 b 个带的理想 MinHash-LSH 候选概率。最多使用 128 个哈希,找出全部整数配置,使 J\ge0.85 的检出概率至少 0.95,J\le0.5 的候选概率至多 0.05。哪个配置使用最少哈希?
查看解答
理想独立 MinHash 行以概率 J 一致,一带全部 r 行一致的概率为 J^r。各带互不重叠且独立,没有任何匹配带的概率为 (1-J^r)^b,因此
概率随 J 单调增加,故只需检查两个边界相似度。枚举有限整数搜索空间:
def probability(J,b,r):
    return 1-(1-J**r)**b

feasible = [(b,r) for r in range(1,129) for b in range(1,129//r+1)
            if probability(.85,b,r)>=.95 and probability(.5,b,r)<=.05]
print(feasible)
print("Fewest hashes:",min(feasible,key=lambda pair:pair[0]*pair[1]))
可行配置为 (10,8),(11,8),(12,8),(13,8),(12,9),(13,9),(14,9)。最短签名含 80 项,即 b=10,r=8,在 0.85 时概率 0.95847,0.5 时为 0.03838。若低相似度边界改为 0.6,同样搜索在 128 个哈希内没有可行解。这是理想概率结论,不保证实验 1 的近似通用哈希实现对每对文档都如此。
C4 清理删除含花括号的页面。为什么这会删除大量源代码?希望教模型代码的语料应如何处理?
查看解答
花括号用于代码块、JSON、CSS 和模板,因此一概删除会连同网页脚本和模板删除有用代码。将代码作为独立管理来源,采用适合仓库的规则,检查来源许可、文件类型、生成或压缩文件、长度、秘密信息及重复。明确选择其混合权重。修改流程后审计代码损失和任务表现;英文正文过滤器并不自动适合代码。部分语言用缩进而非花括号,因此该规则还引入语言相关选择偏差。
2T token 训练给一个 15B token 的数学来源分配 3%。该来源重复多少次?权重加倍后怎样变化?给出三种增加数学知识的替代方案。
查看解答
该来源贡献 0.03(2\times10^{12})=60B token,为其 15B 大小的四倍。份额加倍后为 120B token,即八轮。Muennighoff 等的数据受限实验发现,重复数据的额外价值递减,早期重复比后期更有用。四轮只是粗略实验范围,不是学习停止的普遍阈值。八次使用不提供八倍独立信息,却可能增加记忆。
获取更多来源和使用权兼容的唯一数学文本;生成额外问题并验证解答;或把额外权重集中在较短末期阶段,限制追加重复。相关代码与科学文本也可能提供迁移收益。测量留出数学损失及任务表现,防止同题家族跨训练和评估。
证明 logits 同加常数不改变交叉熵。推导 \lambda(\log Z)^2 的梯度,解释其为何有助数值稳定。每次 bf16 训练都必须用这个辅助损失吗?
查看解答
目标为 y 时,交叉熵为 -z_y+\log\sum_j e^{z_j}。用 z_j+c 替代各 z_j 后得到 -(z_y+c)+c+\log\sum_j e^{z_j},损失及概率保持不变。这种对称性不能固定 logits 整体水平。由于 \partial\log Z/\partial z_j=p_j,
\log Z 为正时,梯度下降降低归一化常数;为负时方向反转。bf16 间距随数值幅度增大,30 附近为 0.125,因此漂移可能丢掉有意义的小差值。稳定 log-sum-exp 避免直接指数溢出,却无法恢复已舍入的差值。z-loss 针对整体漂移,是应测试的方案选择,并非全部 bf16 训练的必需条件,也不约束模型内部注意力 logits。
从 \Delta\mathcal L_{\text{opt}}(B)=\Delta\mathcal L_{\max}/ (1+B_{\text{noise}}/B) 出发,推导达到固定损失的步数与 token 取舍。B_{\text{noise}}=3M token 时,计算 batch 为 1M、6M token 的 S/S_{\min}、D/D_{\min}。
查看解答
每步最优进展减少给定因子时,所需步数为 S=S_{\min}(1+B_{\text{noise}}/B)。Token 数为 D=SB,故 D=S_{\min}(B+B_{\text{noise}})。用小 batch 极限定义 D_{\min}=S_{\min}B_{\text{noise}},于是
1M 时,步数比为 1+3/1=4、token 比为 1+1/3=1.333;6M 时分别为 1+3/6=1.5、1+6/3=3。在这个局部模型下,更大 batch 使用更少更新,却需要更多 token。实际耗时还取决于硬件利用率、通信及可用学习率;训练中的噪声尺度也会改变。
Llama 3 8B 结构采用 N=8{,}030{,}261{,}248、L=32、d=4096、h_{\text{kv}}=1024、d_{\text{ff}}=14336、V=128256。在八张 80 GB GPU、每张一条 8,192 token 序列下,计算 DP/ZeRO 模型状态、有无完整检查点的激活及 fp32 logits。哪些总量估计可容纳?
查看解答
按每参数 16 字节的 Adam 约定,状态为 16N、4N+12N/8、2N+14N/8、16N/8。每层每 token 激活为 12(4096)+4(1024)+6(14336)=139264 字节,乘以 8192(32) 得 36.508 GB。完整检查点保存 2dTL=2.147 GB 层输入,并需 139264(8192)=1.141 GB 重算单层,总计 3.288 GB;fp32 logits 为 4TV=4.203 GB。
| 布局 | 状态(GB) | 无检查点总量 | 有检查点总量 |
|---|---|---|---|
| DP | 128.484 | 169.194 | 135.975 |
| ZeRO-1 | 44.166 | 84.876 | 51.657 |
| ZeRO-2 | 30.113 | 70.823 | 37.605 |
| ZeRO-3 | 16.061 | 56.770 | 23.552 |
无检查点时,ZeRO-2、ZeRO-3 通过简化的 80 GB 限制;有检查点时三个阶段均通过,DP 始终超限。运行时缓冲区、通信和内存余量可能使接近上限的配置失效。案例模型的 FFN 更宽,参数和词表也更大,使 ZeRO-2 无检查点约为 83.7 GB,超过限制。因此分片阶段名称本身不能确定模型是否放得下。
GPipe 调度有三分之一总时间处于理想化流水线气泡。给出三种减少气泡的修改及各自成本。
查看解答
增加 micro-batch 数 m,降低空闲比例 (p-1)/(m+p-1);但更小 micro-batch 可能降低 kernel 效率,增大全局 batch 又可能超出有用噪声范围。GPipe 还保存很多激活直到反向,1F1B 可减轻内存负担。采用交错虚拟阶段,可按虚拟阶段数缩小理想气泡,但增加消息和调度复杂度。减少物理阶段 p,则每 GPU 保存和计算更多层,需靠分片、检查点或 TP 解决内存。公式假设阶段均衡,应先修复慢阶段,再期待调度实现理想收益。
训练损失每 1,000 步呈锯齿变化,记录的学习率调度没有该周期。给出两个合理原因及廉价检查方法。
查看解答
第一,有序加载器可能循环分布不同的分片。记录分片 ID、偏移、来源、文档长度和采样位置,与损失周期对齐,再通过跨分片打乱或随机分片顺序测试。第二,定期评估或检查点操作可能改变训练状态,例如未退出 model.eval()、消耗训练生成器或重置加载器。记录 model.training、采样器状态哈希及周期操作前后偏移;另在非计划步骤执行一次作对照。这些只是待检验假设,不是仅凭曲线的诊断。还应确认日志中的学习率就是各参数组实际采用的值。
检查点写入需两分钟。为什么固定每 5,000 步保存忽略了故障率?在 Young 近似下,集群增大十倍且故障率随 GPU 数增长时,最优间隔怎样改变?异步检查点又改变什么?
查看解答
设阻塞写入耗时 \delta,检查点间隔 \tau,作业平均故障间隔 M,近似开销比例为
第一项为写入时间,第二项为每次故障平均丢失半个间隔的工作。求导得 -\delta/\tau^2+1/(2M)=0,即 \tau^*=\sqrt{2\delta M}。应按时间而非步数设置,因为每步时长可能变化。若 M'=M/10,则 \tau'^*=\tau^*/\sqrt{10},约为原间隔的 0.316。最优 H^*=\sqrt{2\delta/M} 下,最小开销增大 \sqrt{10}。
异步写入可减小 \delta 的阻塞部分,从而缩短优选间隔。但状态快照必须一致,恢复只能使用最近完整持久化的检查点。后台写入延迟、带宽竞争和写入未完成时故障仍属于运行模型;仅改用主机复制耗时只是初步近似。
从 0.5 开始,向 bf16 权重加 10^{-3},再试 3\times10^{-3}。连续直接向 bf16 加十次 10^{-3},与在 fp32 主权重中加十次再复制为 bf16,分别得到什么?
查看解答
在 [0.5,1) 中,间距为 0.5(2^{-7})=2^{-8}=0.00390625,半间距为 0.001953125。因此 0.501 舍入为 0.5,0.503 舍入为 0.50390625。十次小更新每次都从 bf16 值消失,最终仍为 0.5;fp32 主权重累积约到 0.510000,其 bf16 副本为 0.51171875,误差小于半个 bf16 间距。直接 bf16 累积则丢掉全部预期更新。用实际张量运算验证:
import torch
weight = torch.tensor(.5,dtype=torch.bfloat16)
master = torch.tensor(.5,dtype=torch.float32)
print(float(weight+.001),float(weight+.003))
for _ in range(10):
    weight += .001
    master += .001
print(float(weight),float(master),float(master.to(torch.bfloat16)))
若做减法,低于二进制边界 0.5 后间距会变化;本题指定加法,避免另一种舍入计算。fp32 更新及主权重解决累积误差;随机舍入或补偿也可能可用,但需要独立验证。
继续预训练使领域困惑度降低 20%,通用损失增加 0.15 奈特,通用基准组下降三个百分点。提出两项方案调整、预期效果及验收决定。
查看解答
增加通用回放,让通用梯度抑制遗忘,但固定 token 预算下领域 token 更少,领域收益可能变小。降低峰值学习率或缩短训练,减少权重移动以限制通用退步,但适配更慢。这些假设需在留出分布及任务组上检验;基准变化需配对不确定性估计。
按训练前声明的限制作判断。分词器相同,困惑度降低 20% 对应领域损失改善 -\log(0.8)=0.2231 奈特。若通用验收门槛禁止三个百分点退步,就不应接受。若所有方案都未通过,保留原检查点,在模块 09 考虑更窄适配或针对任务的 SFT。
在笔记本规模:(a) 对实验 2 的 FULL 运行每 25 步记录固定 batch 验证,在前半段拟合 \mathcal L(D)=\mathcal L_\infty+aD^{-\gamma},比较最终预测和实测损失。(b) 做两个 QUICK 对照:正常运行,以及 10% 窗口来自固定 5,000 token 训练片段的运行。比较验证与片段损失。计算耗时不计入本题操作时间。
查看解答
(a) 设实验 2 为 QUICK = False,把验证频率从每 150 步改成每 25 步,保留二十个固定 batch 与专用训练采样器,运行完整实验并保存 lab2-metrics.json。(b) 在新进程重建实验 2 的数据、模型及配置。下方对照循环使用五个固定验证 batch;两组从相同种子开始,抽取相同候选窗口,仅重复条件替换部分窗口。固定片段属于训练数据,其损失测重复拟合,而非留出泛化。重复比例按序列 Bernoulli 抽样,打印实际值。
from scipy.optimize import least_squares

def experiment(total_steps,duplicate_share=0.0):
    torch.manual_seed(0)
    model = GPT(**config).to(device)
    optimizer = make_optimizer(model,3e-3)
    sampler = torch.Generator().manual_seed(0)
    vg = torch.Generator().manual_seed(123)
    fixed_valid = [batch(valid_data,vg,T) for _ in range(5)]
    sg = torch.Generator().manual_seed(456)
    fixed_slice = [batch(train_data[:5000],sg,T) for _ in range(5)]
    rows,duplicates = [],0
    warmup = 60 if total_steps==600 else 30
    for step in range(total_steps):
        x,y = batch(train_data,sampler,T)
        sx,sy = batch(train_data[:5000],sampler,T)
        mask = torch.rand(16,generator=sampler)<duplicate_share
        duplicates += mask.sum().item()
        x = torch.where(mask[:,None].to(device),sx,x)
        y = torch.where(mask[:,None].to(device),sy,y)
        for group in optimizer.param_groups:
            group["lr"] = learning_rate(step,total_steps,warmup,3e-3)
        optimizer.zero_grad(set_to_none=True)
        with precision():
            logits = model(x)
            loss = F.cross_entropy(logits.float().flatten(0,1),y.flatten())
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(),1)
        optimizer.step()
        if (step+1)%25==0:
            rows.append(((step+1)*16*T,evaluate(model,fixed_valid)))
    result = dict(curve=rows,validation=evaluate(model,fixed_valid),
                  slice_loss=evaluate(model,fixed_slice),
                  duplicate_share=duplicates/(16*total_steps))
    print(total_steps,duplicate_share,result["validation"],
          result["slice_loss"],result["duplicate_share"])
    return result

# Point this to the FULL metrics saved in (a), in that run's working directory.
full = json.loads(Path("lab2-metrics.json").read_text(encoding="utf8"))
assert not full["quick"] and len(full["validation"]) >= 24
clean = experiment(150)
duplicated = experiment(150,.10)
curve = np.array([(row["tokens"],row["loss"]) for row in full["validation"]])
early = curve[curve[:,0]<=300*16*T]
scale = 1e6

def law(tokens,parameters):
    floor,amplitude,gamma = parameters
    return floor+amplitude*(tokens/scale)**(-gamma)

starts = [[floor,amplitude,gamma] for floor in (0,1,2)
          for amplitude in (1,3,10) for gamma in (.1,.5,1)]
fits = [least_squares(lambda p:law(early[:,0],p)-early[:,1],start,
                      bounds=([0,0,.001],[early[:,1].min(),100,3]))
        for start in starts]
fit = min(fits,key=lambda result:np.sum(result.fun**2))
prediction = law(curve[-1,0],fit.x)
print("Fitted parameters:",fit.x)
print("Final prediction, measurement, error:",prediction,curve[-1,1],
      prediction-curve[-1,1])
fig,ax = plt.subplots(figsize=(7.2,3.6))
ax.loglog(curve[:,0],curve[:,1],"o",label="Measured validation")
ax.loglog(curve[:,0],law(curve[:,0],fit.x),label="First-half fit extrapolated")
ax.axvline(300*16*T,color="gray",linestyle="--",label="Fitting boundary")
ax.set(xlabel="Training tokens seen",ylabel="Cross-entropy (nats/token)")
ax.legend()
plt.show()
查看最终结果前,只用早期测量拟合。应报告误差,不能保证预测准确:短曲线难以确定渐近值和指数,余弦退火又改变后期轨迹。稳定学习率阶段更便于比较 token 缩放。上述有约束多起点拟合明确展示假设,不是不确定性区间。
当前环境中,FULL 标准曲线前半段拟合预测最终损失 2.9551,实测 2.8327,误差 +0.1224 奈特。拟合渐近值、百万 token 处振幅和指数分别为 2.1897、1.1679、0.4700。两个 QUICK 对照实测为
| 对照 | 实际重复比例 | 留出损失 | 固定训练片段损失 |
|---|---|---|---|
| 正常 | 0% | 3.7984 | 3.8140 |
| 重复 | 9.958% | 4.3431 | 4.0267 |
重复组的片段损失比其验证损失低 0.3164 奈特,正常组两项则相近。但重复组的绝对片段损失仍高于正常组,重复没有改善全部指标。此种子下,留出损失恶化 0.5447 奈特。两个对照消耗采样器的方式与实验 2 普通循环不同,评估也用五个而非二十个 batch,所以应彼此比较。
重复比较中,应观察片段损失是否比通用验证下降更多。150 步使用 614,400 token,固定 5,000 token 片段按 10% 回放,约相当于 12.3 次 token 等价使用;窗口可重叠,并非按顺序完整遍历十二次。运行和测量噪声可使验证改善或恶化,归因小变化前应换种子重复。记录实际比例,并比较正常组的片段损失:即使不刻意回放,常见故事模式也容易预测。
自测题
每题选择一个答案,作答后阅读解释;错误选项对应不同核算错误。
论文导读
重点阅读实验比较及核算假设。接受某个训练方案之前,先重现一项结果或计算。
阅读目的。 了解有明确记录、包含过滤和去重消融的网络数据流程,特别是初始方案未改善模型的那些决策。
阅读范围。 阅读引言、文本提取、基础过滤、去重(包括逐快照的结论)及 FineWeb-Edu 标注和分类器部分。略读自定义启发式过滤及与其他数据集比较;跳过附录。
阅读时要回答的问题。
- 为什么作者使用 trafilatura 从 WARC 文件中提取文本而不是使用 WET 文本,他们如何证明它很重要?
- 对全部快照一起去重出现了什么问题?作者改用什么方案?为何全局去重可能偏向较旧、较低质量文本?
- 教育质量分类器如何构建,包括标注者、评分尺度、标注样本数和模型?哪个阈值得到 FineWeb-Edu?
- 数据消融使用多大模型、多少 token?这说明如何测试数据决策?
阅读目的。 理解每参数 16 字节及三个分片阶段的来源,第 8、9 节推导这些阶段,FSDP 实现对应机制。
阅读范围。 阅读引言及内存图、模型状态和剩余状态的内存分析、三个 ZeRO-DP 阶段及通信分析。略读 ZeRO-R,跳过实现和评估部分。
阅读时要回答的问题。
- 重现论文中 7.5B 参数模型在 64 GPU 上的每 GPU 内存:基线和三个阶段分别为 120、31.4、16.6、1.9 GB。
- 为什么参数分片的成本仅为数据并行通信的 1.5 倍而不是更多?
- 什么是“剩余状态”?本模块哪些技术分别处理这些状态?
阅读目的。 论文表明,大训练的不稳定可在高学习率小模型上重现和修复。实验 3 采用同样方法;论文也提供 QK-norm、z-loss 和 AdamW epsilon 建议的证据。
阅读范围。 阅读引言、qk-layernorm 与注意力 logit 增长、z-loss 与输出 logit 发散,以及学习率敏感性定义。略读其他干预措施:预热、独立权重衰减、muParam、AdamW epsilon;跳过附录。
阅读时要回答的问题。
- 什么是学习率敏感性?为什么它比最佳损失更有助概括训练表现?
- 什么证据将注意力 logit 增长与发散联系起来?qk-layernorm 如何改变敏感性曲线?与实验 3 实测比较。
- z-loss 为什么能修复输出 logit 发散?不用时 logits 如何变化?
- 随模型增大,作者对 AdamW epsilon 有什么发现和建议?
小结
- 主训练投入之前确定分词器、结构、数据策略和调度终点;记录所有后续阶段变化。
- 训练计算包含矩阵权重及随上下文变化的注意力;规划 token、时间和 MFU 时采用一致约定。
- 数据清理是会误删的策略,每篇被删文档都应留下可审计原因。
- 精确指纹、MinHash-LSH 候选生成及精确重叠验证,分别回答不同的重复检测问题。
- 混合权重决定来源使用次数;重复 token 提供的新信息递减,也可能增加记忆。
- 打包避免填充浪费,但须明确 EOS 边界、跨文档注意力及验证划分策略。
- 学习率调度、batch 大小和优化器矩影响训练轨迹,应监测实际学习率及裁剪前梯度。
- 分别诊断注意力 logit 增长与输出 logit 漂移;裁剪、QK 归一化和 z-loss 作用于不同量。
- 选择分片、检查点或并行之前,先计算模型状态、保存激活、logits 及运行时余量。
- 恢复必须还原优化器和采样器状态,只能采用已完整写入的检查点。
- 评估固定留出分布及配对任务结果;仅训练损失下降或小幅通用基准改善并不足够。
- 继续预训练在领域适配与通用保留之间取舍,查看结果前必须声明验收门槛。
保留的基座检查点是一个分布模型。第 09 模块 通过监督微调和偏好训练,把它转向指令遵循。案例团队只有在领域及通用门槛都通过时,才采用继续预训练检查点;否则保留已发布检查点。
关键术语
| English | 中文 |
|---|---|
| pretraining, base model | 预训练,基座模型 |
| compute budget | 算力预算 |
| model FLOPs utilisation (MFU) | 模型算力利用率 |
| compute-optimal, over-training | 计算最优,过度训练 |
| corpus, data mixture | 语料,数据配比 |
| quality filter | 质量过滤器 |
| language identification | 语种识别 |
| deduplication, near-duplicate | 去重,近似重复 |
| MinHash, locality-sensitive hashing (LSH) | 最小哈希,局部敏感哈希 |
| contamination, decontamination | 数据污染,去污染 |
| tokenizer training | 分词器训练 |
| sequence packing | 序列打包 |
| mixture of experts, expert parallelism | 混合专家,专家并行 |
| load balancing, capacity factor | 负载均衡,容量因子 |
| warmup, cosine decay | 预热,余弦衰减 |
| warmup-stable-decay (WSD) schedule | 预热-稳定-衰减(WSD)调度 |
| critical batch size | 临界 batch 大小 |
| gradient clipping | 梯度裁剪 |
| mixed precision (bf16), loss scaling | 混合精度(bf16),损失缩放 |
| loss spike, divergence | 损失尖峰,发散 |
| activation checkpointing (gradient checkpointing) | 激活检查点(梯度检查点) |
| data / tensor / pipeline parallelism | 数据 / 张量 / 流水线并行 |
| sequence / context parallelism | 序列并行 / 上下文并行 |
| ZeRO, fully sharded data parallel (FSDP) | 零冗余优化器,全分片数据并行 |
| all-reduce | 全归约 |
| pipeline bubble | 流水线气泡 |
| silent data corruption | 静默数据损坏 |
| mid-training, context extension | 中期训练,上下文扩展 |
| continued pretraining, replay | 继续预训练,回放 |
| catastrophic forgetting | 灾难性遗忘 |
参考文献
- Hoffmann, J. et al. “Training compute-optimal large language models.” NeurIPS, 2022. Chinchilla: the L(N, D) fit and the 20-tokens-per-parameter rule used in s1.
- Kaplan, J. et al. “Scaling laws for neural language models.” arXiv, 2020. The 6N-per-token approximation and the insensitivity of loss to model shape at fixed N.
- Besiroglu, T., Erdil, E., Barnett, M., You, J. “Chinchilla scaling: A replication attempt.” arXiv, 2024. Re-analysis of the Chinchilla parametric fit.
- Rae, J. W. et al. “Scaling language models: Methods, analysis and insights from training Gopher.” arXiv, 2021. The Gopher quality and repetition filters.
- Raffel, C. et al. “Exploring the limits of transfer learning with a unified text-to-text transformer.” JMLR, 2020. C4 and its line-level cleaning rules.
- Dodge, J. et al. “Documenting large webtext corpora: A case study on the Colossal Clean Crawled Corpus.” EMNLP, 2021. What C4’s blocklist removed, and from whom.
- Penedo, G. et al. “The FineWeb datasets: Decanting the web for the finest text data at scale.” NeurIPS Datasets and Benchmarks Track, 2024. A documented public web pipeline and FineWeb-Edu.
- Li, J. et al. “DataComp-LM: In search of the next generation of training sets for language models.” NeurIPS Datasets and Benchmarks Track, 2024. DCLM and its fastText quality classifier.
- Barbaresi, A. “Trafilatura: A web scraping library and command-line tool for text discovery and extraction.” ACL System Demonstrations, 2021. Boilerplate removal.
- Joulin, A., Grave, E., Bojanowski, P., Mikolov, T. “Bag of tricks for efficient text classification.” EACL, 2017. fastText, the basis of common language-identification models.
- Broder, A. Z. “On the resemblance and containment of documents.” Compression and Complexity of Sequences, 1997. MinHash.
- Leskovec, J., Rajaraman, A., Ullman, J. D. Mining of Massive Datasets, Chapter 3. Cambridge University Press. Shingling, MinHash and LSH banding with the S-curve.
- Lee, K. et al. “Deduplicating training data makes language models better.” ACL, 2022.
- Hernandez, D. et al. “Scaling laws and interpretability of learning from repeated data.” arXiv, 2022. The cost of a small fraction of heavily repeated data.
- Brown, T. et al. “Language models are few-shot learners.” NeurIPS, 2020. GPT-3; 13-gram decontamination.
- Muennighoff, N. et al. “Scaling data-constrained language models.” NeurIPS, 2023. How much repeated data is worth.
- Xie, S. M. et al. “DoReMi: Optimizing data mixtures speeds up language model pretraining.” NeurIPS, 2023. Learned mixture weights.
- Xue, L. et al. “mT5: A massively multilingual pre-trained text-to-text transformer.” NAACL, 2021. Temperature sampling of languages.
- Ding, H. et al. “Fewer truncations improve language modeling.” ICML, 2024. Best-fit packing.
- Eldan, R., Li, Y. “TinyStories: How small can language models be and still speak coherent English?” arXiv, 2023. The dataset of Labs 1, 2, 3 and 5.
- Touvron, H. et al. “Llama 2: Open foundation and fine-tuned chat models.” arXiv, 2023. A published recipe: learning rates, schedule, batch, clipping.
- Grattafiori, A. et al. “The Llama 3 herd of models.” arXiv, 2024. Annealing, context extension, document masking and interruption statistics at scale.
- Chowdhery, A. et al. “PaLM: Scaling language modeling with Pathways.” JMLR, 2023. Rewind-and-skip for loss spikes; the MFU definition.
- Fedus, W., Zoph, B., Shazeer, N. “Switch Transformers: Scaling to trillion parameter models with simple and efficient sparsity.” JMLR, 2022. Load-balancing loss and capacity factor.
- Lepikhin, D. et al. “GShard: Scaling giant models with conditional computation and automatic sharding.” ICLR, 2021. Expert parallelism.
- Jiang, A. Q. et al. “Mixtral of experts.” arXiv, 2024.
- Dai, D. et al. “DeepSeekMoE: Towards ultimate expert specialization in mixture-of-experts language models.” ACL, 2024. Fine-grained and shared experts.
- DeepSeek-AI. “DeepSeek-V3 technical report.” arXiv, 2024. Auxiliary-loss-free load balancing; FP8 training with fine-grained scaling.
- DeepSeek-AI. “DeepSeek LLM: Scaling open-source language models with longtermism.” arXiv, 2024. Fitted scaling of learning rate and batch size with compute.
- Yang, G. et al. “Tensor Programs V: Tuning large neural networks via zero-shot hyperparameter transfer.” NeurIPS, 2021. muP.
- Loshchilov, I., Hutter, F. “Decoupled weight decay regularization.” ICLR, 2019. AdamW.
- McCandlish, S., Kaplan, J., Amodei, D. et al. “An empirical model of large-batch training.” arXiv, 2018. The gradient noise scale and the critical batch size.
- Hägele, A. et al. “Scaling laws and compute-optimal training beyond fixed training durations.” NeurIPS, 2024. Warmup-stable-decay against cosine.
- Hu, S. et al. “MiniCPM: Unveiling the potential of small language models with scalable training strategies.” arXiv, 2024. The WSD schedule.
- Micikevicius, P. et al. “Mixed precision training.” ICLR, 2018. Loss scaling and fp32 master weights.
- Micikevicius, P. et al. “FP8 formats for deep learning.” arXiv, 2022. E4M3 and E5M2.
- Dehghani, M. et al. “Scaling vision transformers to 22 billion parameters.” ICML, 2023. QK normalisation against attention-logit growth.
- Wortsman, M. et al. “Small-scale proxies for large-scale Transformer training instabilities.” ICLR, 2024. Instabilities reproduced at small scale; QK-norm, z-loss, AdamW epsilon.
- Chen, T., Xu, B., Zhang, C., Guestrin, C. “Training deep nets with sublinear memory cost.” arXiv, 2016. Activation (gradient) checkpointing.
- Korthikanti, V. et al. “Reducing activation recomputation in large transformer models.” MLSys, 2023. The activation-memory count, sequence parallelism, selective recomputation.
- Dao, T. et al. “FlashAttention: Fast and memory-efficient exact attention with IO-awareness.” NeurIPS, 2022.
- Rajbhandari, S., Rasley, J., Ruwase, O., He, Y. “ZeRO: Memory optimizations toward training trillion parameter models.” SC, 2020.
- Zhao, Y. et al. “PyTorch FSDP: Experiences on scaling fully sharded data parallel.” VLDB, 2023.
- Shoeybi, M. et al. “Megatron-LM: Training multi-billion parameter language models using model parallelism.” arXiv, 2019. Tensor parallelism.
- Narayanan, D. et al. “Efficient large-scale language model training on GPU clusters using Megatron-LM.” SC, 2021. Interleaved pipeline schedules and 3D parallelism.
- Huang, Y. et al. “GPipe: Efficient training of giant neural networks using pipeline parallelism.” NeurIPS, 2019.
- Liu, H., Zaharia, M., Abbeel, P. “Ring attention with blockwise transformers for near-infinite context.” ICLR, 2024. Context parallelism.
- Jacobs, S. A. et al. “DeepSpeed Ulysses: System optimizations for enabling training of extreme long sequence Transformer models.” arXiv, 2023.
- Young, J. W. “A first order approximation to the optimum checkpoint interval.” Communications of the ACM, 1974.
- Dixit, H. D. et al. “Silent data corruptions at scale.” arXiv, 2021.
- Chen, S. et al. “Extending context window of large language models via positional interpolation.” arXiv, 2023.
- Peng, B. et al. “YaRN: Efficient context window extension of large language models.” ICLR, 2024.
- Gururangan, S. et al. “Don’t stop pretraining: Adapt language models to domains and tasks.” ACL, 2020. Domain- and task-adaptive continued pretraining.
- Gupta, K. et al. “Continual pre-training of large language models: How to (re)warm your model?” arXiv, 2023.
- Ibrahim, A. et al. “Simple and scalable strategies to continually pre-train large language models.” TMLR, 2024. Re-warming, re-decaying and replay.