序列及其上的任务
泵上的一路振动信号、数字孪生的观测序列、一份维护日志、一个句子、延时摄影的各帧:在每一种数据里,元素的顺序都承载着含义。把一段振动记录的采样点打乱,它所记录的共振就消失了。有三个性质把这类数据与模块 01 至 03 中固定大小的向量区分开来。顺序承载含义:同样的值换一种顺序,就是另一个信号。长度可变:一段记录持续十分钟,下一段持续十小时。依赖存在于不同的滞后上:一个振动采样点既依赖于几个采样点之前的激励,也依赖于几小时前设定的运行工况。
在工程实践中,一台受监测设备或其数字孪生的观测流(来自许多传感器的温度、振动和压力)是多元时间序列;一次试验的响应曲线,或基于智能体的组织仿真中一次运行的细胞计数,是一条较短的一元序列;而当 ODE 求解器太慢、无法在优化循环中调用时,循环代理模型要学会模仿的正是它的轨迹。
序列记作 \mathbf{x}_{1:T} = (\mathbf{x}_1, \dots, \mathbf{x}_T),其中 \mathbf{x}_t \in \R^{d_{\text{in}}},T 随样本而变。目标可以每步一个,即 \mathbf{y}_t,也可以每条序列一个。一个 batch 的形状是 (B, T, d),较短的序列经过填充并加掩码(第 7 节)。
四种任务形态
这些形态的区别在于输出位于何处,因而损失在何处计算(图 4.1)。
- 多对一。把一段十分钟的泵记录分类为健康、气蚀或不对中;损失只在最后一个输出上计算。
- 对齐的多对多。每步一个输出:把每一秒标为正常或故障,或在每一步预测下一个值;损失对各步求和。
- 序列到序列,长度不同。把一条自由文本的维护记录转换为故障代码,或翻译一个句子。输出位置与输入位置不对齐,这需要第 10 节的编码器-解码器。
- 一对多。从一个初始条件生成一条合成记录,或从一个起始符号生成一行日志,每个输出都作为下一个输入反馈回去。
四种任务形态并排,每种都是一行输入框 \mathbf{x}_1 \dots \mathbf{x}_T(底部)、循环单元(中部)和输出(顶部)。多对一:最后一个单元上方有一个输出,“故障类别”。对齐的多对多:每个单元上方都有一个输出,“下一个值”或“正常/故障”。序列到序列:一行编码器送入一行长度不同的解码器,“记录 → 故障代码”。一对多:一个输入,输出反馈为下一个输入,“生成一条记录”。每种形态下方的标签写着“因果”或“离线”。
在线与离线
\mathbf{y}_t 可以依赖 t 之后的输入吗?在线(online)任务,也称因果(causal)任务,必须在时刻 t 仅凭 \mathbf{x}_{1:t} 作答:预测,以及监测正在运行的机器。离线(offline)任务先拿到整条记录好的序列:事后标注一次已记录的试验,给一个完整句子中的词加标签。只有离线任务可以双向读取序列(第 6 节的双向网络)。一个见过未来的模型,在因果任务上评估,就是一次验证指标极好的泄漏(第 8 节)。
预测下一个元素
概率的链式法则可以精确地分解序列上的任意分布:
因此,一个给定过去预测下一个元素的模型就是一个完整的生成模型:采样 \mathbf{x}_1,反馈回去,采样 \mathbf{x}_2,依此类推。极大似然训练它的方式是:对符号把每步的交叉熵相加,对带高斯噪声的实数值把每步的平方误差相加(模块 01)。这就是模块 07 的语言建模目标,也是第 8 节的一步预测。
为什么固定窗口不够
显而易见的替代方案是把最后 w 个值送入模块 02 的多层感知机。它是值得拟合的基线,但有三个缺陷。窗口是一种猜测:更早的一切都看不见。每个窗口位置有自己的权重,所以在位置 3 学到的模式必须在位置 7 重新学一遍。而且第一层随 w 线性增长。
一个窗口 MLP 读取一元信号最后 w = 64 个值,送入 32 个隐藏单元,它有
一个 d_{\text{in}} = 1、H = 32 的循环层(第 2 节)给每个单元来自上一状态的 32 个权重、来自输入的一个权重和一个偏置:
PyTorch 的 nn.RNN(1, 32) 报告 1,120 个,因为它保留了两个直接相加的偏置向量(第 2 节)。
两种归纳偏置
循环内置了平稳性(stationarity):每一步使用同一条更新规则,所以权重在时间上共享,这对应于模块 03 中卷积的平移等变性。它还内置了一个状态(state),即迄今所见一切的固定大小摘要 \mathbf{h}_t。一维卷积同样在时间上共享权重,但每个输出看到的是一个固定窗口,只随深度增长;而循环的感受野在原则上是无界的。训练能否利用这一点,是第 3 节和第 4 节的主题。
从工程师的角度看,\mathbf{h}_t = f(\mathbf{h}_{t-1}, \mathbf{x}_t)、\mathbf{y}_t = g(\mathbf{h}_t) 就是控制论中的离散时间非线性状态空间模型 \mathbf{x}_{k+1} = f(\mathbf{x}_k, \mathbf{u}_k),只是把状态改名为 \mathbf{h},把输入改名为 \mathbf{x}。写过卡尔曼滤波器的人,都曾根据已知模型手写过一个循环;循环网络从数据中学习 f 和 g,代价是放弃了已知线性高斯模型的保证。第 12 节完成这一比较:
| 模型 | 感受野 | 在时间上共享权重 | 串行步数 |
|---|---|---|---|
| 窗口 MLP | 固定,w | 否 | 1 |
| 一维 CNN / TCN | 随深度和空洞增长 | 是 | 每层 1 |
| RNN | 原则上无界 | 是 | T |
| 注意力 | 整个序列 | 是 | 每层 1(第 12 节) |
一个模型必须在飞行结束后,把一段已记录的飞行试验振动记录的每一秒标为正常或颤振。这是哪种任务形态?\mathbf{y}_t 可以依赖之后的输入吗?
查看答案
对齐的多对多,也就是序列标注。这个任务是离线的,所以 \mathbf{y}_t 可以依赖之后的输入,允许使用双向模型。
为什么把 MLP 预测器的窗口加倍,它的第一层参数也加倍,而循环层的参数量不变?
查看答案
MLP 对每个窗口位置都有单独的权重;循环层在每一步应用同样的权重,所以它的参数量与读取多少步无关。
循环神经网络
最简单的循环网络是 Elman 网络(Elman network,Elman 1990),它保存一个状态向量,每一步用一个层更新一次:
各形状为 \mathbf{h}_t \in \R^{H}、\mathbf{x}_t \in \R^{d_{\text{in}}}、\mathbf{W}_h \in \R^{H \times H}、\mathbf{W}_x \in \R^{H \times d_{\text{in}}}、\mathbf{W}_y \in \R^{d_{\text{out}} \times H}、\mathbf{b} \in \R^{H} 和 \mathbf{c} \in \R^{d_{\text{out}}};\mathbf{z}_t 是预激活。初始状态 \mathbf{h}_0 为零或一个学习得到的向量。非线性 \phi 默认为 \tanh,理由有三:它有界,所以无论序列多长,状态都不会无限增长;它以零为中心;它在原点的导数为 1,所以较小的状态几乎线性地通过。每个隐状态(hidden state)\mathbf{h}_t 都通过这一串更新,成为整个前缀 \mathbf{x}_{1:t} 的函数。
batch 形式
框架把一个 batch 存为 (B, T, d),每个样本占一行,所以同样的方程用行向量和转置的权重来写。记 \mathbf{X}_t \in \R^{B \times d_{\text{in}}} 为第 t 步的输入,\mathbf{H}_t \in \R^{B \times H} 为状态(粗体 \mathbf{H}_t 是矩阵,斜体 H 是它的宽度),则
对 t 做一个循环,每步两次矩阵乘法:
import torch

def rnn_forward(X, W_h, W_x, b, h0):
    """X: (B, T, d_in); h0: (B, H). Returns all states, (B, T, H)."""
    pre_in = X @ W_x.T + b          # input part for every step at once: (B, T, H)
    h, states = h0, []
    for t in range(X.shape[1]):     # the recurrent part must run one step at a time
        h = torch.tanh(h @ W_h.T + pre_in[:, t])
        states.append(h)
    return torch.stack(states, dim=1)
输入投影不依赖于状态,所以在循环之前用一次大的乘法对所有步一起算出;只有与 \mathbf{W}_h 的乘积必须等待上一步。优化过的实现也是这样做的。
展开
每一步的权重都相同。画出自环时,网络是一个小单元;沿 T 步画开,即按时间展开(unrolled in time),它是一个 T 层的前馈网络,每一层的权重都相同(图 4.2)。训练就是在这个展开的计算图上做反向传播,这是第 3 节的主题。
左:折叠的循环单元,一个标有 tanh 的方框,下方是输入 \mathbf{x}_t,上方是输出 \mathbf{y}_t,一条标有 \mathbf{W}_h 的自环把 \mathbf{h}_{t-1} 送回。右:同一个单元展开为四步,\mathbf{h}_0 从左侧进入,箭头为 \mathbf{h}_1 \to \mathbf{h}_2 \to \mathbf{h}_3 \to \mathbf{h}_4。每条水平箭头都标为 \mathbf{W}_h,每条竖直输入箭头标为 \mathbf{W}_x,每条输出箭头标为 \mathbf{W}_y,处处标签相同,以表示共享。每个输出上方的每步损失 \mathcal{L}_t 汇入总和 \mathcal{L}。
参数与损失
数一数上面的矩阵和向量,
PyTorch 的 nn.RNN 保留两个偏置向量 bias_ih_l0 和 bias_hh_l0,二者直接相加;第二个是为了兼容 NVIDIA 的 cuDNN kernel 而存在的,并不增加表达能力。因此它的循环层有 H(H + d_{\text{in}} + 2) 个参数。
对于对齐的任务,损失是每步损失之和 \mathcal{L} = \sum_t \mathcal{L}_t(\mathbf{y}_t, \text{目标}_t),通常对步数和 batch 取平均,使学习率不依赖于 T 或 B。对于多对一任务,只使用 \mathcal{L}_T。
状态的作用
状态的行为在单个单元上最容易看清。
取 h_t = \tanh(w h_{t-1} + u x_t),u = 1,无偏置,h_0 = 0,输入脉冲 \mathbf{x} = (1, 0, 0)。
w = 0.5。
对脉冲的记忆大约每步减半。每一步的局部导数 \partial h_t / \partial h_{t-1} = w(1 - h_t^2) 为
w = 2。
状态锁存在 1 附近:脉冲被记住了,但靠的是一个处于饱和的单元。局部导数为 2(1 - 0.7616^2) = 0.840、2(1 - 0.9093^2) = 0.347 和 2(1 - 0.9487^2) = 0.200,随着单元饱和而下降。
两种设置给出的局部因子都小于 1。小权重会遗忘,大权重会饱和,无论哪种,第 3 节要连乘的那些因子都已经在缩小。
字符级语言模型
实验 1 训练这个网络,预测一份合成维护日志的下一个字符,日志的各行形如 F2 pres 4.0 bar night shift ok /F2。词表有 V 个字符。输入 \mathbf{x}_t 是一个独热(one-hot)向量,除当前字符的索引处为 1 外全为零,所以 \mathbf{W}_x\mathbf{x}_t 就是 \mathbf{W}_x 中对应该字符的那一列:这个乘法实现为按列查表,而这正是嵌入层的本质。输出 \mathbf{y}_t \in \R^{V} 保存下一个字符的 logits,softmax 把它们变成概率,损失是相对于实际出现的下一个字符的平均交叉熵,单位为每字符奈特(nats)(除以 \ln 2 得到比特)。
初始化时,输出权重很小,logits 接近零,softmax 接近均匀分布,每个字符都是 1/V,所以第一个损失应当接近 -\ln(1/V) = \ln V。这就是模块 02 的合理性检查:第一个损失远离 \ln V,说明在任何训练发生之前就已经有 bug。(模块 07 把这个量转换为困惑度;本模块始终使用每字符奈特。)
V = 37 个字符,H = 128 个状态单元,一个偏置向量:
| 张量 | 形状 | 参数 |
|---|---|---|
| \mathbf{W}_x | 128 \times 37 | 4,736 |
| \mathbf{W}_h | 128 \times 128 | 16,384 |
| \mathbf{b} | 128 | 128 |
| \mathbf{W}_y | 37 \times 128 | 4,736 |
| \mathbf{c} | 37 | 37 |
| 合计 | 26,021 |
公式与之一致:128(128 + 37 + 1) + 37(128 + 1) = 21{,}248 + 4{,}773 = 26{,}021。第一个损失应为 \ln 37 = 3.611 奈特每字符。
带温度的采样
训练好的模型按第 1 节的一对多形态生成文本:送入一个起始字符,从预测的分布中抽取下一个字符,把它反馈回去,重复。温度(temperature)\tau 在 softmax 之前去除 logits,所以下一个字符从 \softmax(\mathbf{y}_t / \tau) 中抽取。\tau < 1 时,分布向最可能的字符锐化;\tau > 1 时,分布变平。对 logits (2, 1, 0),\tau = 1 时概率为 (0.665, 0.245, 0.090),\tau = 0.5 时为 (0.867, 0.117, 0.016),\tau = 2 时为 (0.506, 0.307, 0.186)。低温度给出重复但格式良好的文本;高温度给出多样性,也带来更多错误。实验 1 对两者都做了测量。
由来
这类循环网络在整个 1990 年代都有研究,它们的训练问题(第 4 节的主题)在那个十年的中期就已为人理解。它们的复兴发生在 2013–2015 年:门控循环网络生成了令人信服的手写笔迹和字符级文本(Graves 2013),Karpathy 2015 年关于字符级模型的文章展示了一个小网络逐字符写出看似合理的散文、源代码和标记文本。那些字符模型是模块 07 中语言模型的直接祖先。
一个 RNN 的 d_{\text{in}} = 10、H = 64,有一个偏置向量。它的循环层有多少个参数?序列长度加倍时,这个数如何变化?
查看答案
64 \times (64 + 10 + 1) = 64 \times 75 = 4{,}800。它不变:每一步都应用同样的权重,所以参数量与序列长度无关。
一个刚初始化的、作用于 37 个符号的字符模型报告第一个损失为 7.2 奈特。这说明什么?
查看答案
存在 bug 或初始化不当。一个没有任何信息的模型应当得到接近 \ln 37 = 3.61 奈特。损失为 7.2 意味着输出层一开始就自信地出错,通常是因为它的初始权重太大,或者损失是对各步求和而不是取平均。
随时间反向传播
展开后,循环网络是一个各层共享权重的深层前馈网络。训练它就是模块 02 的反向传播,只是把层换成时间步,但有一处要紧的差别:因为每一步都使用同样的权重,每个权重的梯度要从每一步收集一份贡献。这就是随时间反向传播(backpropagation through time,BPTT)。
设定与约定
取第 2 节的网络,损失对各步求和:
梯度是与变量形状相同的列向量。雅可比矩阵 \partial\mathbf{a}/\partial\mathbf{b} 的 (i, j) 元素等于 \partial a_i/\partial b_j,所以梯度的链式法则写作 \partial\mathcal{L}/\partial\mathbf{b} = (\partial\mathbf{a}/\partial\mathbf{b})^\top\, \partial\mathcal{L}/\partial\mathbf{a}。下文各因子的顺序由这一约定决定,不能随意调换。
反向递推
定义 \boldsymbol{\delta}_t = \partial\mathcal{L}/\partial\mathbf{h}_t,即整个损失对第 t 步状态的全导数。状态 \mathbf{h}_t 沿两条路径影响损失:经由 \mathbf{y}_t 进入 \mathcal{L}_t,以及经由 \mathbf{z}_{t+1} 进入之后发生的一切。多元链式法则把两条路径相加:
两个雅可比矩阵可以直接从方程读出:\partial\mathbf{y}_t/\partial\mathbf{h}_t = \mathbf{W}_y,\partial\mathbf{z}_{t+1}/\partial\mathbf{h}_t = \mathbf{W}_h。由于 \phi 逐元素作用,它的雅可比矩阵是对角矩阵 \operatorname{diag}(\phi'(\mathbf{z}_t)),对预激活的梯度是一个逐元素乘积。记为 \mathbf{g}_t:
在 t = T 处第二项不存在,因为之后再没有任何步。从 t = T 向下运行到 t = 1,这就是模块 02 反向传播中的误差信号,只不过是沿时间向后传递,而不是沿层向下传递(图 4.3,左)。
参数梯度是对时间的求和
设想第 t 步有循环矩阵的一份自己的副本 \mathbf{W}_h^{(t)}。损失通过每一份副本依赖于共享的 \mathbf{W}_h,所以它的梯度是对各副本梯度之和。在第 t 步内,副本只通过 \mathbf{z}_t = \mathbf{W}_h^{(t)}\mathbf{h}_{t-1} + \dots 进入,由此得到模块 02 的外积 \mathbf{g}_t\mathbf{h}_{t-1}^\top。因此
展开递推式
递推式掩盖了梯度由什么构成。把循环一步的雅可比矩阵写成
仅经由状态,对 s > t 有 \partial\mathbf{h}_s/\partial\mathbf{h}_t = \mathbf{J}_s\mathbf{J}_{s-1}\cdots\mathbf{J}_{t+1}。为求梯度取转置会反转顺序,所以第 s 步的损失对第 t 步状态处梯度的贡献是
离损失最近的因子 \mathbf{J}_s^\top 最先作用于梯度。矩阵乘法不可交换,所以把各因子按别的顺序写,或写成 \operatorname{diag}(\phi')\,\mathbf{W}_h^\top,得到的是不同的矩阵,除非每个 \phi' 都相同。
代入参数梯度,它就变成一个二重和,一重是产生损失的步 s,另一重是使用过 \mathbf{W}_h 的每个更早的步 t \le s:
其中 t = s 时乘积为空(即单位矩阵)。每一项带有 s - t 个雅可比因子。s - t 较小的项是短程项:它们教网络一个输入如何影响接下来的几个输出。s - t 较大的项是长程项,只有它们能教网络学会跨越许多步的依赖。第 4 节讨论许多雅可比矩阵的乘积能有多大。递推式通过复用部分乘积,在一次反向扫描中算出整个二重和;逐项单独计算则需要 O(T^2) 次矩阵-向量乘积。
取第 2 节的标量网络:w = 0.5,u = 1,无偏置,h_0 = 0,\mathbf{x} = (1, 0, 0),所以 h = (0.7616, 0.3634, 0.1797)。在最后一个状态上放一个损失,\mathcal{L} = \tfrac12(h_3 - 0.5)^2 = \tfrac12(-0.3203)^2 = 0.0513。
反向。\tanh' = 1 - h^2,第 1 步和第 2 步没有损失,所以递推式为 g_t = (1 - h_t^2)\,w\,g_{t+1}:
参数梯度,对各步求和:
唯一非零的输入在损失之前两步进入,所以它的梯度经过了两个雅可比因子 J_3 = w(1 - h_3^2) = 0.484 和 J_2 = w(1 - h_2^2) = 0.434,二者之积为 0.21。在 float64 中取 \epsilon = 10^{-6} 做中心差分 (\mathcal{L}(w + \epsilon) - \mathcal{L}(w - \epsilon))/2\epsilon,得到 -0.21506 和 -0.028243,在所示位数上完全一致。
代价
每一层的前向传播在循环乘积上约花费 B \cdot T \cdot H^2 次乘加(输入部分另有 B \cdot T \cdot H \cdot d_{\text{in}} 次)。反向传播约为其两倍:一次与 \mathbf{W}_h^\top 的乘积把 \mathbf{g}_{t+1} 传回,一次外积累加 \mathbf{g}_t\mathbf{h}_{t-1}^\top。它和前向传播一样在 t 上是串行的。它还需要前向传播的每一个 \mathbf{h}_t 和 \mathbf{z}_t,所以内存为 O(B \cdot T \cdot H):与序列长度成正比。
还有一种前向模式的替代方案。实时循环学习(real-time recurrent learning,RTRL;Williams 和 Zipser 1989)把灵敏度 \partial\mathbf{h}_t/\partial\mathbf{W}_h 随状态一起向前传递,并在每一步更新它,所以它不存储任何过去的东西,并能在线地在每一步给出梯度。灵敏度是一个 H \times H^2 的数组,更新它需要一个 H \times H 矩阵与之相乘:每步 O(H^4) 的工作量,而 BPTT 是 O(H^2)。在 H = 128 时,每条序列每步需要 2.7 \times 10^8 次乘加,每条序列要存储 210 万个数,这就是 RTRL 不在大规模上使用的原因。
截断的随时间反向传播
一条长数据流无法作为一个展开的计算图放进内存。截断的随时间反向传播(truncated BPTT)把它切成 k 步的块。状态从一个块传到下一个块,梯度却不传:计算图在每个块的边界处被切断(图 4.3,右)。在 PyTorch 中,切断只需一次调用 detach():
h = torch.zeros(1, B, H)
for X, Y in chunks:              # consecutive k-step pieces of the same B streams
    h = h.detach()               # keep the value, cut the graph behind it
    out, h = rnn(X, h)
    loss = loss_fn(head(out), Y)
    opt.zero_grad()
    loss.backward()
    opt.step()
内存从 O(B \cdot T \cdot H) 降到 O(B \cdot k \cdot H)。代价是,长于 k 步的依赖永远得不到直接的梯度。信息仍然可以通过传递的状态向前流动,所以网络可能用上它碰巧携带的长依赖,但损失中没有任何东西告诉它去学这样的依赖。一种常见的变体每 k_1 步更新一次,反向传播 k_2 \ge k_1 步(Williams 和 Peng 1990)。
本模块中的内存大小采用十进制:1 kB = 10^3 B,1 MB = 10^6 B,1 GB = 10^9 B。二进制单位写作 KiB、MiB 和 GiB(1 GiB = 2^{30} B),在大小为 2 的幂或在其他模块中再次出现时,在括号中给出。
一条 T = 100{,}000 个传感器采样点的数据流,一个 batch 有 B = 32 条流,H = 256 个状态单元,float32(4 字节)。完整 BPTT 保存每一个 \mathbf{h}_t 需要
而这还只是状态。LSTM(第 5 节)每步要保存约六个这样大小的张量(它的各个门、细胞状态和输出),约 6 \times 3.28 \approx 20 GB。截断为 k = 200 步的块时,同样的缓冲区是
小 500 倍,代价是超过 200 步就没有直接的梯度。
左:图 4.2 的展开计算图,前向箭头为灰色,反向箭头为红色:\boldsymbol{\delta}_t 从 \mathcal{L}_t(竖直方向)以及从 \boldsymbol{\delta}_{t+1} 经过 \phi' 和 \mathbf{W}_h^\top(水平方向)到达。其下方的一条带状图把 \partial\mathcal{L}/\partial\mathbf{W}_h 表示为每步外积 \mathbf{g}_t\mathbf{h}_{t-1}^\top 之和。右:一条长数据流被切成 k 步的块,边界处画着剪刀:灰色的状态箭头穿过每个切口继续(前向),红色的梯度箭头在切口处停止(“detach”)。
检验梯度
手写的反向传播按模块 02 的方法检验:在 float64 下的一个小模型上,把每个参数的几个元素扰动 \pm\epsilon(\epsilon = 10^{-5}),构造中心差分,并用相对误差 |a - n| / \max(|a|, |n|) 与解析梯度比较。误差在 10^{-6} 到 10^{-9} 左右说明反向传播是对的;高于 10^{-4} 的都是 bug。实验 1 在训练之前做这一检验。一个典型的循环网络 bug,即漏掉 \mathbf{W}_h^\top\mathbf{g}_{t+1} 项,在 T = 1 时能通过检验,在 T = 4 时就会失败,所以要用多步来检验。
为什么 RNN 的参数梯度是对时间步的求和?
查看答案
同样的 \mathbf{W}_h、\mathbf{W}_x 和 \mathbf{b} 在每一步都被使用。损失通过每一次使用依赖于每个权重,多元链式法则把每次使用的贡献相加。
用 k = 25 步的截断 BPTT,模型能利用 50 步之前的信息吗?
查看答案
它可以把这些信息携带在状态中,因为状态会跨越块边界传递,但没有任何梯度告诉它这样做。长于 k 的依赖即便能学到,也只能间接学到。实验 1 中的闭合标签必须重复 18 到 36 个字符之前的起始标签,就是一个具体的例子。
梯度消失与梯度爆炸
第 3 节中的每个长程项都包含 n 个雅可比矩阵的乘积,n 是权重的一次使用与它所影响的损失之间的距离。这样的乘积随 n 几何地缩小或增长,几乎从不保持在 1 的量级。正是这一点,而不是容量不足,使普通循环网络学不会长依赖。
一个单元,没有非线性
对线性标量循环 h_t = wh_{t-1} + ux_t,每个雅可比都等于 w,所以 \partial h_T/\partial h_{T-n} = w^n:
| w | n = 10 | n = 50 | n = 100 |
|---|---|---|---|
| 0.5 | 9.8 \times 10^{-4} | 8.9 \times 10^{-16} | 7.9 \times 10^{-31} |
| 0.9 | 0.349 | 5.2 \times 10^{-3} | 2.7 \times 10^{-5} |
| 0.99 | 0.904 | 0.605 | 0.366 |
| 1.01 | 1.10 | 1.64 | 2.70 |
| 1.1 | 2.59 | 117 | 1.4 \times 10^{4} |
| 2 | 1.0 \times 10^{3} | 1.1 \times 10^{15} | 1.3 \times 10^{30} |
把比值 10^{-3} 当作有用学习信号的边界。它在滞后 n = \ln 10^{-3} / \ln w 处达到:
即便 w = 0.99 也会耗尽:0.99^{500} = 6.6 \times 10^{-3}。在另一侧,1.01^{100} = 2.70 无害,1.1^{50} = 117 就有害了,而 2^{50} = 1.1 \times 10^{15} 会毁掉任何一次更新。对 w = 0.5,这个因子在 n = 126 处达到 float32 的最小正规数 2^{-126} \approx 1.2 \times 10^{-38}。只有 |w| = 1 附近的一个窄带能把信号传过数百步。
多个单元,仍然线性
没有非线性时,梯度每向后一步就乘以 \mathbf{W}_h^\top。若 \mathbf{W}_h = \mathbf{Q}\boldsymbol{\Lambda}\mathbf{Q}^{-1} 可对角化,则 (\mathbf{W}_h^\top)^n = \mathbf{Q}^{-\top}\boldsymbol{\Lambda}^n\mathbf{Q}^\top:在坐标 \mathbf{a} = \mathbf{Q}^\top\mathbf{g} 下,每个分量乘以 \lambda_i^n。|\lambda_i| < 1 的分量消失,|\lambda_i| > 1 的分量爆炸,最终最大的 |\lambda_i| 占主导,所以无论梯度来自哪个输出,它都指向同一个方向。长期的速率是谱半径(spectral radius)\rho(\mathbf{W}) = \max_i |\lambda_i|;Gelfand 公式 \lVert\mathbf{W}^n\rVert^{1/n} \to \rho(\mathbf{W}) 使这一点在任何范数下都成立,无论是否可对角化。
\mathbf{W}_h = \begin{pmatrix} 0.8 & 0.3 \\ 0.3 & 0.8 \end{pmatrix} 是对称矩阵,特征值为 0.8 \pm 0.3:沿 (1, 1)/\sqrt2 的 \lambda_1 = 1.1,沿 (1, -1)/\sqrt2 的 \lambda_2 = 0.5。向后送入 \mathbf{g} = (1, 0) = \tfrac12(1, 1) + \tfrac12(1, -1):
- n = 1:(0.55 + 0.25,\ 0.55 - 0.25) = (0.8, 0.3)。
- n = 20:\tfrac12(1.1)^{20} = 3.364,\tfrac12(0.5)^{20} = 4.8 \times 10^{-7},所以得到 (3.364, 3.364),范数 4.76。
- n = 50:(58.70, 58.70),范数 83.0。
0.5 分量已经消失(0.5^{20} = 9.5 \times 10^{-7}),梯度指向 (1, 1)。现在把单元换成 tanh,两者都处在 |h| \approx 0.6,所以每一步 \tanh' = 1 - 0.6^2 = 0.64。沿 (1, 1) 的每步因子是 1.1 \times 0.64 = 0.704:0.704^{20} = 8.9 \times 10^{-4},0.704^{50} = 2.4 \times 10^{-8}。非线性把一个爆炸的方向变成了消失的方向。
由奇异值给出的界
特征值描述长期行为;奇异值则约束每一步。由于 \mathbf{J}_k^\top = \mathbf{W}_h^\top\operatorname{diag}(\phi'(\mathbf{z}_k)),
其中 \gamma = \sup|\phi'|(tanh 和 ReLU 为 1,logistic sigmoid \sigma 为 1/4),\sigma_{\max} 是最大奇异值。因此(Pascanu、Mikolov 和 Bengio 2013),\gamma\sigma_{\max} < 1 是梯度消失的充分条件,\gamma\sigma_{\max} > 1 是梯度爆炸的必要条件:它允许增长,但并不强制增长。
非正规矩阵先增长后衰减。\mathbf{N} = \begin{pmatrix} 0.5 & 1 \\ 0 & 0.5 \end{pmatrix} 的 \rho = 0.5,但 \sigma_{\max} = 1.207;n = 1 到 5 时 \lVert\mathbf{N}^n\rVert 依次为 1.207、1.059、0.770、0.508、0.316,n = 10 时为 0.0196。PyTorch 默认的 nn.RNN 初始化就属于这一类。它从 [-1/\sqrt H, 1/\sqrt H] 中均匀抽取 \mathbf{W}_h,元素方差为 1/(3H);这种随机矩阵的特征值填满半径约为 1/\sqrt3 = 0.58 的圆盘,而它的最大奇异值趋近 2/\sqrt3 = 1.15。实验 2 对 H = 64 测得 \rho \approx 0.57、\sigma_{\max} \approx 1.10。
非线性带来了什么
在 \mathbf{J}_k = \operatorname{diag}(\phi'(\mathbf{z}_k))\mathbf{W}_h 中,tanh 的导数 1 - \tanh^2 z 只在 z = 0 处为 1:z = 1 时为 0.42,z = 2 时为 0.071,z = 3 时为 0.0099。每个离开线性区的单元都向乘积中乘入一个小因子,所以即使是正交的 \mathbf{W}_h(每个奇异值都恰好为 1)也会丢失梯度。爆炸需要 \rho 远大于 1,因为大的增益会把单元推入饱和,从而部分地抵消自身。
一次仿真给出具体的大小:H = 32,正交的 \mathbf{W}_h 缩放到半径 \rho,tanh,每一步向预激活加入标准差为 \sigma_x 的独立输入,从最后一步向后送入一个随机的单位梯度。在 \rho = 1、\sigma_x = 1 时,一次抽样在滞后 10、50 和 100 处给出的比值为 1.8 \times 10^{-2}、5.5 \times 10^{-11} 和 5.1 \times 10^{-21},而线性网络恰好保持为 1。\sigma_x = 0.1 时,滞后 100 处仍有 1.3 \times 10^{-3};\rho = 1.5 时为 1.3 \times 10^{-7};只有 \rho = 3 才会爆炸(5.5 \times 10^{8})。换一次抽样,这些值会变化几倍,但数量级不变。
为什么梯度消失比看起来更糟
梯度的长程项比短程项指数级地小,所以总梯度看起来很健康,损失在下降,网络学到了短程相关;长依赖的贡献被埋没在这些项和 mini-batch 噪声之下。网络从未被告知这个依赖存在。Hochreiter 在他 1991 年的毕业论文(Diplom)中发现了这一点;Bengio、Simard 和 Frasconi(1994)用要求在不断增长的延迟上锁存一个比特的网络展示了它,并证明:以稳定状态附近的收缩动力学稳健地存储一个比特,恰恰就是让梯度消失的条件。第 2 节中锁存的单元就是一个小例子:它的局部因子降到了 0.347 和 0.200。
在实验 1 中,后果体现在行为上。RNN 学会了日志的每一条局部规则,包括一个数值阈值,但在温度 0.5 下,它的样本只有大约五分之一会用 18 到 36 个字符之前开启这一行的标签来闭合这一行(实验 1 的运行中为 21%,实验 2 的普通 RNN 为 14% 到 25%),而在八个设备标签中随机猜测为 12.5%。实验 2 的 LSTM 学会了它。
悬崖与裁剪
在雅可比乘积很大的地方,损失曲面上有一堵近乎竖直的墙(图 4.4)。在墙脚处按巨大梯度成比例地迈一步,会把参数抛到很远:损失尖峰或 NaN,常常发生在数千次平静的更新之后。
循环网络的损失沿一个参数的一维切片:一道缓坡的山谷被一堵近乎竖直的墙,即悬崖,打断。从墙脚的一点出发,未裁剪的梯度步跳出图外很远,而沿同一方向、长度有界的裁剪步则留在山谷中。仿照 Pascanu、Mikolov 和 Bengio(2013)中的图。
按全局范数做的梯度裁剪(gradient clipping)在 \lVert\mathbf{g}\rVert > c 时把 \mathbf{g} 替换为 (c/\lVert\mathbf{g}\rVert)\,\mathbf{g}:方向保持不变,步长有界。对循环网络,c 通常取 1 到 5(模块 02 给出了一般规则)。对每个分量单独裁剪,即按值裁剪(value clipping),会改变方向。
\mathbf{g} = (3, 4) 的范数为 5;裁剪到 c = 1 得到 (0.6, 0.8),方向相同。\mathbf{g} = (30, 0.4) 偏离第一个坐标轴 \arctan(0.4/30) = 0.8^\circ。按值裁剪到 [-1, 1] 得到 (1, 0.4),角度为 \arctan 0.4 = 21.8^\circ。按范数裁剪除以 30.003,得到 (0.99991, 0.01333),仍是 0.8^\circ。
裁剪能治好梯度爆炸,对梯度消失却毫无作用:它从不放大梯度。
初始化,以及结构上的修正
正交的 \mathbf{W}_h(Saxe、McClelland 和 Ganguli 2014)让每个奇异值从 1 开始。用 ReLU 单元配合单位矩阵初始化(Le、Jaitly 和 Hinton 2015)与之类似,而在整个训练过程中保持的酉约束(Arjovsky、Shah 和 Bengio 2016)走得更远。它们都无法消除非线性带来的因子,而且只有约束能阻止训练改变 \mathbf{W}_h。结构上的修正是一条加性路径,梯度在这条路径上不会每一步都乘以 \mathbf{W}_h 和 \phi':这就是第 5 节的 LSTM,与模块 03 中跨越深度的残差连接是同一种补救。
使用 tanh 单元、且 \mathbf{W}_h 的最大奇异值为 0.8 时,梯度会爆炸吗?
查看答案
不会。每个雅可比矩阵的范数至多为 1 \times 0.8,所以 n 步上的乘积至多为 0.8^n。
为什么正交的 \mathbf{W}_h 不能防止 tanh RNN 中的梯度消失?
查看答案
雅可比矩阵中还含有 \operatorname{diag}(\tanh'(\mathbf{z}_k)),它至多为 1,且只在 z = 0 处等于 1。只要单元离开线性区,每一步都会乘入小于 1 的因子。
梯度裁剪和正交初始化,各自针对哪种失效?
查看答案
裁剪约束每一次更新:针对梯度爆炸。正交初始化让奇异值从 1 开始,在训练早期有助于对抗梯度消失。一旦 tanh 饱和,两者都无法修正梯度消失。
LSTM:一条加性的记忆路径
第 4 节以一个诊断结束。朴素循环的逐步雅可比矩阵 \operatorname{diag}(\phi'(\mathbf{z}_k))\,\mathbf{W}_h 是一个固定矩阵乘以一个至多为 1 的导数,这样的因子连乘很多次,无论怎样初始化都会消失。补救办法是结构上的:给梯度第二条路径,它的逐步因子是网络在每一步自行选择、并且可以保持在接近 1 的一个数。这条路径就是长短期记忆网络(long short-term memory,LSTM)的细胞状态(cell state)。
方程
细胞保存两个宽度为 H 的向量:细胞状态 \mathbf{c}_t 和隐状态 \mathbf{h}_t。在每一步,它读取拼接向量 [\mathbf{h}_{t-1}; \mathbf{x}_t](长度为 H + d_\text{in}),计算三个门(gate)和一个候选值:
每个矩阵都是 H \times (H + d_\text{in}) 的,即 \mathbf{W}_f \in \mathbb{R}^{H\times(H+d_\text{in})}。门是一个取值在 (0, 1) 内的向量,逐元素地乘到另一个量上:一个由当前输入和上一步输出设定的软开关。遗忘门(forget gate)决定每个已存储的值保留多少,输入门(input gate)决定候选值写入多少,输出门(output gate)决定记忆读出多少。\mathbf{c}_t 是记忆;它在步与步之间从不被压缩,所以其分量可以超过 1。\mathbf{h}_t 是输出和工作状态,被 tanh 限定在有界范围内;下一层、输出头和下一步的门看到的都是它。图 4.5 画出了这个细胞。
LSTM 细胞。顶部一条水平线把 \mathbf{c}_{t-1} 送到 \mathbf{c}_t,途经一个乘法节点(\times\,\mathbf{f}_t)和一个加法节点(+\,\mathbf{i}_t\odot\tilde{\mathbf{c}}_t),这条线画得较粗,并以“加性路径”突出显示。它下方四个小方框 \sigma、\sigma、tanh、\sigma 从 [\mathbf{h}_{t-1};\mathbf{x}_t] 计算 \mathbf{f}_t、\mathbf{i}_t、\tilde{\mathbf{c}}_t 和 \mathbf{o}_t;作用于 \mathbf{c}_t 的 tanh 再乘以 \mathbf{o}_t 得到 \mathbf{h}_t。一条红色虚线箭头沿顶线从右向左,标注为 \partial\mathbf{c}_t/\partial\mathbf{c}_{t-1} = \operatorname{diag}(\mathbf{f}_t)。
细胞路径为什么能保住梯度
对细胞更新关于 \mathbf{c}_{t-1} 求导。项 \mathbf{f}_t\odot\mathbf{c}_{t-1} 直接依赖于它;各个门和候选值则通过 \mathbf{h}_{t-1} = \mathbf{o}_{t-1}\odot\tanh(\mathbf{c}_{t-1}) 依赖于它。记 \mathbf{W}_f^{h} 为 \mathbf{W}_f 中与 \mathbf{h}_{t-1} 相乘的那个 H\times H 块(其余矩阵同理),由乘积法则和链式法则得
其中,例如 \partial\mathbf{f}_t/\partial\mathbf{h}_{t-1} = \operatorname{diag}(\mathbf{f}_t\odot(1-\mathbf{f}_t))\,\mathbf{W}_f^{h},以及 \partial\mathbf{h}_{t-1}/\partial\mathbf{c}_{t-1} = \operatorname{diag}(\mathbf{o}_{t-1}\odot(1-\tanh^2\mathbf{c}_{t-1}))。方括号里的各项与朴素循环的雅可比矩阵形状相同,都是一个权重块乘以饱和函数的导数,它们的长连乘会因第 4 节所述的原因而消失。
第一项则不同。从第 t 步到第 T 步只跟踪这一项:
这个乘积是对角的:单元 j 的梯度在第 k 步乘以 f_{k,j},除此之外不乘任何东西。这里没有矩阵的幂,所以不会有小于 1 的特征值把信号缩小;没有 tanh 的导数,所以饱和不起作用;每个因子都是网络根据数据逐步设定的门值,在单元 j 需要记住时保持在 1 附近,不需要时就降下来。当 \mathbf{f}\approx\mathbf{1} 时,梯度可以原样穿过许多步:这就是 Hochreiter 和 Schmidhuber 所说的恒定误差传送带(constant error carousel)。
总梯度是所有路径之和,间接路径仍然可能消失;它们负责短程的功劳分配。细胞路径负责长程的功劳分配,告诉网络某个遥远的输入曾经起过作用。这与模块 03 中跨越深度的残差连接是同一种补救:一条在每一级都不经过权重矩阵的梯度路径。
取 H = 1、c_{t-1} = 1.0,预激活分别为 2(遗忘门)、0(输入门)、1(候选值)和 0(输出门)。
各门:f_t = \sigma(2) = 1/(1+e^{-2}) = 0.8808;i_t = \sigma(0) = 0.5; \tilde c_t = \tanh(1) = 0.7616;o_t = \sigma(0) = 0.5。
细胞更新:c_t = 0.8808\cdot 1.0 + 0.5\cdot 0.7616 = 0.8808 + 0.3808 = 1.2616。
输出:h_t = 0.5\cdot\tanh(1.2616) = 0.5\cdot 0.8515 = 0.4258。
沿直接路径,\partial c_t/\partial c_{t-1} = f_t = 0.8808。细胞现在存着一个大于 1 的值,这是受 tanh 限定的状态做不到的;输出门读出了其中约三分之一。
简史
Hochreiter 和 Schmidhuber 1997 年的 LSTM 有输入门和输出门,以及一个权重固定为 1 的细胞自连接:也就是那条传送带,但无法清空,所以在很长的数据流上细胞会被填满。遗忘门由 Gers、Schmidhuber 和 Cummins(2000)加入;上面的形式就是如今人人所说的“LSTM”。窥视孔连接(peephole connection,即也读取 \mathbf{c} 的门)不久之后出现,如今已很少使用。Greff 等人(2017)比较了八种变体,发现没有一种显著优于标准细胞;最重要的是遗忘门和输出激活函数。
遗忘门偏置
在初始化时权重很小,所以每个遗忘门都位于 \sigma(b_f) 附近:这是每一步的默认记忆。经过 n 步,细胞路径把梯度乘以约 \sigma(b_f)^n;对 n 解 \sigma(b_f)^n = 0.5,就得到默认记忆的半衰期(half-life):
由于 1-\sigma(b) = 1/(1+e^{b}),保留率为 f = \sigma(b_f) 的记忆,其时间常数 1/(1-f) 恰好是 1 + e^{b_f} 步:偏置每增加一个单位,时间尺度约乘以 e。当 b_f = 0 时,门从 0.5 起步,半衰期只有一步。来自 20 步之外目标的梯度到达时只剩原来的百万分之一,网络必须从这样的信号中发现记忆是值得的;它可能在最初的一千次更新里把一切都忘掉。
计算 f = \sigma(b_f),再计算 f^{20}、f^{100} 和半衰期 \ln 0.5/\ln f:
| b_f | f = \sigma(b_f) | f^{20} | f^{100} | 半衰期(步) |
|---|---|---|---|---|
| 0 | 0.5000 | 9.5\times10^{-7} | 7.9\times10^{-31} | 1.0 |
| 1 | 0.7311 | 1.9\times10^{-3} | 2.5\times10^{-14} | 2.2 |
| 2 | 0.8808 | 0.079 | 3.1\times10^{-6} | 5.5 |
| 3 | 0.9526 | 0.378 | 7.8\times10^{-3} | 14.3 |
| 4 | 0.9820 | 0.696 | 0.163 | 38.2 |
| 5 | 0.9933 | 0.874 | 0.511 | 103 |
手算验证一行:\sigma(3) = 1/(1+e^{-3}) = 1/1.0498 = 0.9526;\ln 0.9526 = -0.04859; 20\times(-0.04859) = -0.9717,e^{-0.9717} = 0.378;半衰期为 -0.6931/(-0.04859) = 14.3 步。把 b_f 从 0 调到 3,滞后 20 步处的梯度因子就从 10^{-6} 变成了 0.4。
训练会改变偏置,但起始值决定了早期能有哪些梯度到达。Jozefowicz、Zaremba 和 Sutskever(2015)发现,遗忘偏置取 1 就弥补了他们所测得的 LSTM 与 GRU 之间的大部分差距。Chrono 初始化(Tallec 和 Ollivier,2018)根据依赖长度的预期范围,按时间常数关系设定每个单元的 b_f:要记住约 T 步,取 b_f \approx \ln(T-1)。把遗忘偏置设为 1 或 2,是最有用的一条 LSTM 技巧。
在 PyTorch 中
nn.LSTM 把四个门的权重在每一层堆成一个矩阵:weight_ih_l0 的形状为 (4H, d_in),weight_hh_l0 的形状为 (4H, H),顺序是 i、f、g、o,其中 g 是 PyTorch 对候选值 \tilde{\mathbf{c}} 的称呼。偏置向量有两个,bias_ih_l0 和 bias_hh_l0,二者直接相加,所以实际的遗忘偏置是 bias_ih_l0[H:2*H] + bias_hh_l0[H:2*H]。每个权重和偏置都从 U(-1/\sqrt{H}, 1/\sqrt{H}) 初始化,所以默认遗忘偏置约为 0:正是表中半衰期为一步的情形。设置它只需几行:
import torch
import torch.nn as nn

def set_forget_bias(lstm: nn.LSTM, value: float) -> None:
    """Make the effective forget-gate bias equal `value` in every layer and direction."""
    H = lstm.hidden_size
    with torch.no_grad():
        for name, p in lstm.named_parameters():
            if name.startswith("bias_ih"):
                p[H:2 * H].fill_(value)      # gates are stacked i, f, g, o
            elif name.startswith("bias_hh"):
                p[H:2 * H].zero_()           # the two bias vectors add

lstm = nn.LSTM(input_size=1, hidden_size=32, batch_first=True)
set_forget_bias(lstm, 1.0)
参数量与计算量
四个 H\times(H+d_\text{in}) 的矩阵加四个偏置,共 4H(H + d_\text{in} + 1) 个参数;PyTorch 的两个偏置向量使它变成 4H(H + d_\text{in}) + 8H,是同宽度朴素循环层的四倍。每一步计算四次大小为 H\times(H + d_\text{in}) 的矩阵-向量乘积:把一次乘加算作两次运算,每条序列每一步约 8H(H + d_\text{in}) 次浮点运算。
nn.LSTM(1, 32):4\cdot 32\cdot(32 + 1) + 8\cdot 32 = 4{,}224 + 256 = 4{,}480。
两层预测器 nn.LSTM(1, 32, num_layers=2):第二层读取第一层 32 维的输出,所以它有 4\cdot 32\cdot(32 + 32) + 256 = 8{,}192 + 256 = 8{,}448 个参数。整个堆叠合计 4{,}480 + 8{,}448 = 12{,}928;一个 Linear(32, 1) 输出头再加 32 + 1 = 33,得到 12{,}961,也就是实验 3 打印的数字。
细胞学到了什么
Karpathy、Johnson 和 Fei-Fei(2016)检查了在文本和代码上训练的字符级 LSTM,发现少数细胞跟踪着可解释的量,例如在一行中的位置,或是否处于引号之内:一个保持在 1 附近的遗忘门,加上一个遇到某个字符就打开的输入门,让这些都很容易实现。大多数细胞则找不到这样的解读。
实验展示了什么
在实验 2 中,遗忘偏置为 0 时,LSTM 的梯度随滞后衰减的方式与朴素网络相同;偏置为 3 或 5 时,梯度比值一直到滞后 100 都保持在约 0.14 到 0.4 之间。在实验 1 的维护日志上,经过 2,500 次更新后,闭合标签(位于开始标签之后 18 到 36 个字符处)的正确率,朴素 RNN 为 14% 到 25%,接近随机猜测的 12.5%;遗忘偏置为 0 和 1 的 LSTM 为 64% 到 96%(实验 2 的运行和另一个随机种子)。两个 LSTM 中哪个领先随种子而变;门控细胞与朴素细胞之间的差距则不变。
沿 LSTM 的细胞路径,梯度在每一步乘以遗忘门,这是一个由网络选择、可以保持在 1 附近的数,而不是一个固定矩阵和一个 tanh 导数。
沿 LSTM 的直接路径,\partial\mathbf{c}_t/\partial\mathbf{c}_{t-1} 是什么?它为什么不会像 \mathbf{W}_h^n 那样消失?
查看答案
它是 \operatorname{diag}(\mathbf{f}_t):由网络逐步、逐单元设定、并且可以保持在 1 附近的门值。其中既没有 tanh 的导数,也没有被反复求幂的固定矩阵。
你把 nn.LSTM 的 bias_ih_l0[H:2*H] 设为 1,bias_hh_l0 保持默认。实际的初始遗忘偏置是多少?
查看答案
约为 1,再加上一个从 U(-1/\sqrt{H}, 1/\sqrt{H}) 抽取的逐单元小量,因为两个偏置向量相加。要让它恰好为 1,还要把 bias_hh_l0[H:2*H] 置零。
GRU、堆叠与双向网络
Cho 等人(2014)的门控循环单元(gated recurrent unit,GRU)用一个状态和两个门构建了同样的加性路径。本节先把它与 LSTM 比较,再讨论组合循环层的两种方式:在深度上堆叠,以及在两个方向上运行。
GRU
更新门逐单元决定把状态向候选值移动多远。重置门决定候选值能看到多少旧状态;当 \mathbf{r}_t\approx\mathbf{0} 时,单元只从输入重新开始。像第 5 节那样对最后一行求导,得到 \partial\mathbf{h}_t/\partial\mathbf{h}_{t-1} = \operatorname{diag}(1-\mathbf{z}_t),再加上经过各门和候选值的项:沿直接路径,梯度每步乘以 1-z_{k,j},只要让更新门保持在 0 附近,它就保持在 1 附近。这是 LSTM 的技巧,只是用一个状态代替了两个。图 4.6 画出了这个细胞。
GRU 细胞,画法与图 4.5 相同。\mathbf{h}_{t-1} 进入后分成两路:一路被 (1-\mathbf{z}_t) 缩放;另一路经过重置门 \mathbf{r}_t 进入 tanh 候选值 \tilde{\mathbf{h}}_t,再被 \mathbf{z}_t 缩放。两路相加得到 \mathbf{h}_t。(1-\mathbf{z}_t) 这一路作为加性路径突出显示。
\mathbf{z} 的符号约定并不统一。Cho 等人(2014)和 PyTorch 写作 \mathbf{h}_t = (1-\mathbf{z}_t)\odot\mathbf{n}_t + \mathbf{z}_t\odot\mathbf{h}_{t-1},所以他们的 \mathbf{z} 表示保留;本模块用它表示更新。二者是同一个模型,只是把 \mathbf{z} 换成了 1-\mathbf{z},但用来偏向记忆的偏置必须取对符号:在 PyTorch 中,正的更新门偏置偏向记忆。PyTorch 还把重置门放在隐状态矩阵乘法之后,\mathbf{n}_t = \tanh(\mathbf{W}_{in}\mathbf{x}_t + \mathbf{b}_{in} + \mathbf{r}_t\odot(\mathbf{W}_{hn}\mathbf{h}_{t-1} + \mathbf{b}_{hn})),这是一个小变体;它的门按 r、z、n 的顺序堆叠。
工程视角:一个学出来的低通滤波器
让更新门保持为常数 z。那么 h_t = (1-z)\,h_{t-1} + z\,\tilde h_t 就是候选值的指数移动平均,即一阶低通滤波器的离散形式。它的冲激响应按 (1-z)^n 衰减,所以其记忆半衰期为 \ln 0.5/\ln(1-z) 步;若采样间隔为 \Delta t,则由 1 - z = e^{-\Delta t/\tau} 定义其时间常数 \tau。GRU 就是一组这样的滤波器,其时间常数由输入逐单元、逐步设定:一个单元可以在平稳的一段里缓慢积分,然后在门打开时迅速跳到新值。
更新门恒为 z = 0.1 时,每一步保留状态的 1 - z = 0.9。半衰期为 \ln 0.5/\ln 0.9 = -0.6931/(-0.10536) = 6.58 步;20 步之后剩下原值的 0.9^{20} = 0.12。在 100 Hz 采样率下,这是一个时间常数为 \tau = -0.01/\ln 0.9 = 0.095 s 的滤波器。
参数量,以及证据
三个块而不是四个,每块一个偏置时共 3H(H + d_\text{in} + 1) 个参数,在 PyTorch 中为 3H(H + d_\text{in}) + 6H:是同宽度 LSTM 的四分之三,每步的计算量也省下同样的比例。
nn.GRU(1, 32):3\cdot 32\cdot 33 + 6\cdot 32 = 3{,}168 + 192 = 3{,}360 个参数,而 nn.LSTM(1, 32) 为 4{,}480。
在大多数任务上,两者不相上下。Chung 等人(2014)发现,在音乐和语音建模上 GRU 与 LSTM 相当,两者都远远领先朴素的 tanh 循环。Jozefowicz、Zaremba 和 Sutskever(2015)搜索了数千种循环架构,发现把 LSTM 的遗忘偏置设为 1 就弥补了 LSTM 与 GRU 之间的差距。在需要精确计数或长时间精确记忆的地方,LSTM 仍占优势:Weiss、Goldberg 和 Yahav(2018)表明,LSTM 能学会 a^n b^n 这类计数语言,而 GRU 在实践中学不会,因为 LSTM 无界的细胞可以充当计数器,而 GRU 的状态只是在有界的值之间插值。实用的规则是:默认用 LSTM,参数或速度吃紧时用 GRU。朴素的 tanh 循环是教科书里的模型;实践中所说的“RNN”指的是门控细胞。
堆叠
循环层像 MLP 的各层一样堆叠:第 l 层读取第 l-1 层的整个隐状态序列 \mathbf{h}^{(l-1)}_1, \dots, \mathbf{h}^{(l-1)}_T。典型的是两到四层,层间加 dropout(nn.LSTM 的 dropout 参数做的正是这件事,只有一层时它什么也不做)。更深的堆叠在层间加残差连接后训练得更好,
\mathbf{h}^{(l)}_t \leftarrow \mathbf{h}^{(l)}_t + \mathbf{h}^{(l-1)}_t:Google 2016 年的翻译系统使用了带残差连接的八层 LSTM 堆叠(Wu 等人,2016)。
双向网络
双向循环神经网络(bidirectional RNN,Schuster 和 Paliwal,1997)在同一序列上运行两个循环层,一个向前、一个向后,并把它们的状态拼接起来, [\overrightarrow{\mathbf{h}}_t; \overleftarrow{\mathbf{h}}_t],宽度为 2H,这样每个位置都能看到它的过去和未来。这正是序列标注所需要的(一段录音的第 340 秒是否为故障起始,取决于它后面的内容),它也是第 11 节注意力模型的标准编码器。但它不能用于预测、监测或任何在线任务:反向方向读过了未来,而在部署时未来尚不存在。图 4.7 展示了一个堆叠的双向网络。
一个跨五个时间步的堆叠双向网络:两层,每层有一行前向细胞(箭头从左到右)和一行反向细胞(箭头从右到左)。每一步把两个状态拼接起来(一个小的连接符号),再向上传给下一层。右侧,一个“预测 x_{t+1}”方框上打着红叉,说明文字为“反向一行已经读过 x_{t+1}”。
nn.LSTM(16, 64, num_layers=2, bidirectional=True),H = 64。
第 1 层在每个方向上读取 16 个输入: 4\cdot 64\cdot(16 + 64) + 8\cdot 64 = 20{,}480 + 512 = 20{,}992 每个方向,所以共 2\times 20{,}992 = 41{,}984。
第 2 层读取拼接后的输出,宽度为 2H = 128: 4\cdot 64\cdot(128 + 64) + 512 = 49{,}152 + 512 = 49{,}664 每个方向,所以共 2\times 49{,}664 = 99{,}328。
合计 41{,}984 + 99{,}328 = 141{,}312。第二层的开销是第一层的两倍多,因为双向性使它的输入宽度翻了一倍。
在建立于双向层之上的多对一模型中,概括整个序列的状态是真实最后一步的前向状态和第一步的反向状态。那个诱人的选择,即拼接输出的最后一个位置,错了两次:它的反向一半只看到了一个 token,而如果 batch 经过填充,它的前向一半还跑过了填充部分。使用打包序列时(第 7 节),PyTorch 返回的 h_n 恰好存着正确的两个状态,h_n[-2](前向,最后一层)和 h_n[-1](反向,最后一层)。实验 4 的编码器用的就是它们。
双向 GRU 能预测明天的轴承温度吗?
查看答案
不能。它的反向传递读取的是被预测时刻之后的输入;训练时这些输入是有的,模型也学会了利用它们,但在部署时它们还不存在。
在双向的多对一模型中,哪些状态概括了整个序列?
查看答案
前向方向在真实最后一步的状态,以及反向方向在第一步的状态。输出的最后一个位置,其反向一半只看到了一个 token。
循环网络的训练实践
训练不起来的循环网络,通常是出于少数几个原因之一:填充泄漏进了损失或状态,状态被带到了不该带去的地方,使用了默认初始化,dropout 放错了位置,或者没有做裁剪。本节汇集了避免这些问题的做法。优化器和一般的调试方法属于模块 02;下面的内容是循环网络所特有的。
变长序列:填充、掩码、打包
把不同长度的序列组成 batch,最简单的办法是把每条序列用零填充(pad)到 batch 中的最大长度,并保留一个掩码(mask),真实步上为 1,填充处为 0。此后每个需要求和的逐步量都必须加掩码;对损失来说只需一行:
loss = (per_step_loss * mask).sum() / mask.sum() # mean over real steps only
掩码还必须作用到其他任何对位置求和的量上,例如第 11 节的注意力分数。掩码使损失正确,但每个填充步仍然要计算。打包(packing)则不然:PyTorch 的 pack_padded_sequence 重新安排 batch,使每个时间步只计算仍在运行的序列,pad_packed_sequence 再把输出变回填充过的张量,每条序列长度之后为零。图 4.8 画出了一个填充后的 batch、它的掩码以及它的打包形式。
对双向层来说,打包是必需的,而不仅仅是为了省计算。反向方向必须从每条序列的真实最后一步开始;在填充而未打包的 batch 上,它先读到一串零,所以它在真实 token 上的状态取决于这个 batch 碰巧需要多少填充。另外两个习惯也有帮助。分桶(bucketing,把长度相近的序列放进同一个 batch)可以减少花在填充上的浪费。对于多对一任务,要取每条序列真实最后一步的状态,而不是最后一列:
from torch.nn.utils.rnn import pack_padded_sequence, pad_packed_sequence

lengths = torch.tensor([50, 120, 200])
packed = pack_padded_sequence(x, lengths, batch_first=True, enforce_sorted=False)
out_packed, (h_n, c_n) = lstm(packed)                 # x: (3, 200, d_in), padded
out, _ = pad_packed_sequence(out_packed, batch_first=True)
last = out[torch.arange(len(lengths)), lengths - 1]  # equals h_n[-1] for one direction
长度为 50、120 和 200 的三条序列填充到 200,占据 3\times 200 = 600 个位置,其中 50 + 120 + 200 = 370 个是真实的。其余 230 个,即 230/600 = 38\% 的计算量,花在了填充上。若用不加掩码的平均损失,这 230 个位置会被当作数据来训练(模型学会在零之后预测零),并稀释短序列的真实步。用加掩码的损失,370 个真实步承担全部权重;再加上打包,网络也只执行这 370 步。
上:一个填充后的 batch,画成 3\times 8 的网格(长度为 2、5 和 8 格,按比例对应 50、120 和 200 步);真实格子填色,填充格子画斜线,旁边是由 1 和 0 组成的掩码矩阵。中:同一个 batch 按时间步打包,画成高度递减的列(活跃序列数依次为 3、3、2、2、2、1、1、1)。下:一条长数据流被切成若干块用于有状态训练,状态箭头从一块传到下一块,每个边界处有一个“detach”标记,数据流末尾有一个“reset”标记。
状态处理
无状态(stateless)训练在每条序列开始时把状态重置为零:这是默认做法,只要序列是相互独立的样本,它就是对的。有状态(stateful)训练把一条长数据流切成连续的块,并把每块的最终状态带入下一块,这就是截断的随时间反向传播(第 3 节)。要遵守三条规则。在每个块边界处分离状态(h = h.detach())。在不同数据流之间以及评估之前重置状态。对每一块都把数据流 i 放在 batch 的第 i 行,使第 i 行的状态属于在那里延续的数据,实验 1 就是这样做的(图 4.8,下)。把状态带过互不相关的序列,教给模型的是 batch 的顺序,而不是数据。
初始化
把 \mathbf{W}_h 初始化为正交矩阵(第 4 节)。把 LSTM 的遗忘门偏置设为 1 或 2(第 5 节)。让输出权重取小值,使初始损失对 V 个类别约为 \ln V,对回归约为目标的方差;第一个损失如果远离这个值,就是 bug 最早的信号。
正则化
dropout 放在输入上和堆叠的层之间。在循环连接上,每一步都用新的掩码,会在 100 步中把状态打穿一百次,长程依赖就丢失了。在那里有效的形式是变分 dropout(variational dropout,Gal 和 Ghahramani,2016):每条序列一个掩码,在每一步重复使用。另一种做法是丢弃循环权重,即对 \mathbf{W}_h 做 DropConnect,如 Merity、Keskar 和 Socher(2018)的 AWD-LSTM。权重衰减照常使用。早停需要一个验证集划分,小语料最需要它:在六首莎士比亚十四行诗(3,715 个字符;实验 1“动手试试”的第 3 项)上训练时,在编写本模块时做的一次运行中,实验 1 的网络约在 250 次更新后达到最低验证损失,此后验证损失上升,而训练损失继续下降。
归一化
只用训练集的统计量对输入逐通道归一化(模块 01);当水平发生漂移时,按窗口归一化(第 8 节)。在细胞内部,层归一化(Ba、Kiros 和 Hinton,2016)对每一步的预激活跨单元归一化,在激活值随长序列漂移的地方有帮助。批归一化在时间维上用起来很别扭:它的统计量必须按时间步分别保存,而序列的长度又各不相同。
裁剪、优化器与速度
始终在 1 到 5 处裁剪全局梯度范数(第 4 节),并记录裁剪之前的范数:上升的趋势往往预示着爆炸,而当损失变成 NaN 时,这份日志是第一个要看的东西。对小型循环模型,学习率在 10^{-3} 到 3\times10^{-3} 的 Adam 或 AdamW 是很好的默认选择。在 GPU 上,nn.LSTM 和 nn.GRU 调用融合的 cuDNN kernel,比在 Python 中循环调用 nn.LSTMCell 快得多。在 CPU 上,小型循环模型的耗时主要在逐步的开销而不是算术上,所以要把许多序列放进一个 batch:大小为 64 的 batch,开销远小于大小为 1 的 batch 的 64 倍。
调试清单
- 把初始损失与 \ln V(或目标方差)比较。
- 过拟合一个小 batch。如果模型做不到,bug 就在模型或损失里。
- 用 float64 和中心差分对一个很小的模型做梯度检验(实验 1)。
- 画出梯度范数随滞后的变化(实验 2);如果在你的任务所需的滞后处它是 10^{-10},再怎么训练也找不到那个依赖。
一个双向编码器在补零的 batch 上训练,没有打包,然后在未填充的输入上测试,短输入突然失败了。为什么?
查看答案
训练时,反向方向先读到填充,再读到真实 token,所以它在短输入上的状态都是跟在一串零之后的状态。测试时它从一个真实 token 开始,这是它从未见过的状态。要打包序列,使反向传递从每条序列的真实最后一步开始(实验 4)。
dropout 放在 LSTM 的什么地方不会损害它的记忆?
查看答案
放在输入上和堆叠的层之间。在循环连接上只能用变分形式,即在一条序列的每一步使用同一个掩码。
诚实地做时间序列预测
预测是循环网络在工程上最常见的用途:下一小时的轴承温度,下一分钟的振动信号。它也是最容易报告出毫无意义的数字的地方。本节讨论让这个数字值得信任的评估纪律,以及那段显而易见的代码会犯的一个错误。
问题设定:窗口与预测步长
对序列 x_1, \dots, x_N,以步长 1 沿它滑动一个长度为 W 的窗口(window):输入为 x_{t-W+1}, \dots, x_t,单步预测的目标为 x_{t+1},预测步长(horizon)为 h 时目标为 x_{t+1}, \dots, x_{t+h}。其他测量通道,以及事先已知的外生(exogenous)输入(工况、设定值、生产计划),成为额外的输入通道,所以一个 batch 的形状为 (B, W, \text{通道数})。
时间上的四种泄漏
只有当每个预测都不使用在那一时刻尚不存在的任何东西时,预测才是诚实的。有四种泄漏会破坏这一点。
- 打乱的重叠窗口。 相邻窗口共享 W - 1 个值。随机打乱并划分,几乎每个测试窗口在训练集中都有一个近似副本:所谓“预测”其实是插值。
- 用整条序列做归一化。 在训练集和测试集上一起计算的统计量,会告诉模型测试数据落在哪里。
- 用未来数据计算的特征。 中心移动平均、前向-后向滤波器或双向层(第 6 节)都会读取 t 之后的值。
- 在测试期上做选择。 根据测试误差挑选超参数或停止的轮次,会让测试误差变成训练误差。
这四种泄漏都违反了模块 01 的规则:按部署时将是新的那个单位来划分。对预测器来说,这个单位就是未来。
取 W = 64、步长 1,每个窗口与每个相邻窗口共享 64 个值中的 63 个。把 3,000 个这样的窗口按 80/20 随机划分。一个测试窗口在训练集中没有共享 63 个值的近似副本,当且仅当它的两个相邻窗口也都落在测试集中,概率约为 0.2\times 0.2 = 0.04。所以约 96% 的测试窗口都有这样的副本。最近的四个窗口(共享 62 或 63 个值)都不在训练集中的概率是 0.2^4 = 0.0016。
前向滚动验证
尊重时间的替代方案是前向滚动验证(walk-forward validation),也叫滚动起点评估(rolling-origin evaluation),参见 Tashman(2000)以及 Hyndman 和 Athanasopoulos 的 Forecasting: Principles and Practice。在某个预测起点之前的全部数据上训练(用扩展窗口;如果旧数据已不再有代表性,则用滑动窗口),在它之后的一个数据块上验证,把起点向前移,重新拟合,如此重复。当 h > 1 时,在最后一个训练目标与第一个验证输入之间至少留出 h 步的间隔。报告各折上的均值和离散程度(图 4.9)。
上:一条时间轴,四个前向滚动折纵向叠放;每一折中依次是一个蓝色的扩展训练块、一小段灰色间隔,然后是一个橙色验证块,起点逐折向右移动。下,用红色划掉:一个打乱的划分,蓝色和橙色窗口沿同一条轴交错排列,其中两个重叠窗口被放大,显示它们共享的 63 个样本。
基线,以及一个内含基线的分数
一个误差值,如果没有同一数据上平凡预测器的误差作对照,就毫无意义。
- 朴素预测(naive,即持续性预测):\hat x_{t+h} = x_t,“明天等于今天”;在短预测步长上很强。
- 季节性朴素预测(seasonal naive):取早一个周期 m 的同一相位,当 h \le m 时 \hat x_{t+h} = x_{t+h-m};对周期信号在长预测步长上很强。
- 线性自回归(linear autoregression):在同样的窗口上对目标做最小二乘回归(模块 01)。它是最强的廉价基线,也是带高斯噪声的线性系统的最优预测器;一个打不过它的网络,什么非线性的东西都没有找到。
- 训练均值:一个没学到任何动态的模型会向它漂移。
平均绝对标度误差(mean absolute scaled error,MASE;Hyndman 和 Koehler,2006)把一个基线内置到分数中:
其中分母是单步朴素预测在 N 个训练值上的样本内 MAE(或季节性朴素预测的样本内 MAE,滞后为 m)。它没有单位,MASE < 1 意味着模型胜过朴素预测的样本内精度。
训练值为 (10, 14, 12, 8, 11, 15, 13, 9),周期 m = 4;接下来四个真实值为 (12, 16, 14, 10)。
朴素预测:每个预测值都是 9。误差为 3, 7, 5, 1;MAE = 16/4 = 4.0。
季节性朴素预测:预测值复制最后一个周期,(11, 15, 13, 9)。误差为 1, 1, 1, 1;MAE = 1.0。
标度:样本内单步朴素预测的误差为 |14-10|, |12-14|, \dots, |9-13| = 4, 2, 4, 3, 4, 2, 4,均值为 23/7 = 3.286。
按此标度计算 MASE:朴素预测 4.0/3.286 = 1.22,季节性朴素预测 1.0/3.286 = 0.30。知道周期的季节性朴素预测,以四倍的差距获胜。
水平漂移时按窗口归一化
用训练统计量做 z 分数标准化避免了泄漏 2,但当序列发生漂移时就会失效。网络学到的是它见过的输入范围上的一个映射;在它从未见过的水平上,它的饱和单元会变平,它也不会像线性模型那样外推。那段显而易见的代码恰恰犯了这个错误。
序列为 \sin t + 0.05t 加上标准差为 0.1 的高斯噪声,每 0.1 个时间单位采样一次,共 4,000 个点:前 3,000 个用于训练,其余用于测试,用训练统计量做 z 分数标准化,窗口 W = 64,一个两层的 nn.LSTM(1, 32, num_layers=2)(连同输出头共 12,961 个参数),用带裁剪的 AdamW 训练 15 个轮次。每一步看上去都很仔细。在编写本模块时,用随机种子 0 做的一次运行给出:
LSTM 的测试 RMSE 为 1.075;朴素预测为 0.155。比“明天等于今天”差七倍。
原因在于漂移。归一化之后,训练输入的范围是 -1.92 到 1.92,测试输入是 1.46 到 3.10。测试期的大部分落在网络从未见过的水平上,在那里它的预测偏低:以序列本身的单位计,平均误差为 -0.87。
修正办法:从每个窗口的输入中减去该窗口的最后一个值,预测变化量,再把这个值加回去。同一个模型于是得到约 0.12 到 0.14 的分数(取决于随机种子),而朴素预测为 0.155。在同样的窗口上做最小二乘线性自回归,得分为 0.099,已达噪声下限(除非碰巧,没有任何单步预测能低于噪声的标准差 0.1)。对正弦加漂移加噪声的信号,线性模型才是合适的工具。实验 3 在一个同样带漂移的非线性信号上运行同一个模型:它在那里也输给持续性预测(RMSE 0.43 对 0.36,平均误差 -0.32),修正后降到 0.13,而在那个信号上,LSTM 相对线性模型确实有所贡献。
改动只是 forward 中的三行:
    def forward(self, x):                        # x: (batch, W, 1)
        last = x[:, -1:, :]                      # each window's last value, (batch, 1, 1)
        out, _ = self.lstm(x - last)             # the network sees shape, not level
        return self.head(out[:, -1]).squeeze(-1) + last[:, 0, 0]
对序列做差分能起到同样的作用,可逆实例归一化(reversible instance normalisation,RevIN;Kim 等人,2022)也可以:它用每个输入窗口自身的均值和标准差对该窗口归一化,并在输出上做逆变换。有多条序列时,用每条序列自己的统计量对它归一化。
多步预测:递归还是直接
超过一步时有两种策略(Ben Taieb 等人 2012 对二者做了比较)。递归(recursive):反复迭代一个单步模型,把每个预测值追加到窗口中。它的误差会累积,因为它把自己的错误当作输入读入:这是第 10 节中暴露偏差在预测问题上的形式。直接(direct):每个预测步长一个模型,或一个有 h 个输出的网络,从观测到的窗口一次预测全部步长;它从不读取自己的预测。对于窗口很长的最小二乘线性模型,两者几乎一致:当窗口包含系统的全部线性状态时,迭代最优的单步线性预测器就得到最优的 h 步预测器,而这正是直接回归所估计的。对非线性模型,两者不同,而且常常差别很大。实验 3 的第 5 步画出了两种策略的误差随预测步长的变化:递归 LSTM 在 h = 1 时是最好的预测器(RMSE 0.13),而在 h = 20 时比朴素预测还差(0.78 对 0.72),远远落后于直接 LSTM 和两种线性模型(约 0.55 到 0.56;两种线性策略结果一致)。
点预测与区间
决策通常需要知道一个预测有多可信。给网络第二个输出来表示方差,并用高斯负对数似然
\tfrac12\ln\hat\sigma^2 + (y-\hat\mu)^2/(2\hat\sigma^2)(nn.GaussianNLLLoss)训练;或者用弹球损失(pinball loss)\max(\tau u, (\tau-1)u) 训练分位数输出,其中误差为
u = y - \hat y_\tau。两种做法都能给出第 9 节的阈值所需的残差尺度;但要先在留出数据上检查覆盖率。
神经预测器处于什么位置
截至 2026 年,保守地说:在长度适中的单条序列上,调好的经典方法(指数平滑、ARIMA)和线性模型仍然很难被超越。在 M4 竞赛(2018 年,100,000 条序列)中,纯机器学习的参赛方法表现不佳,获胜者是指数平滑与循环网络的混合模型(Makridakis、Spiliotis 和 Assimakopoulos,2020;Smyl,2020)。DeepAR(Salinas 等人,2020)这样的神经预测器,在有许多相关序列、外生输入和非线性动态的场合才显出价值,例如一组受监测的设备群。
一个预测数字的好坏,取决于它的划分和它的基线:在未来上评估,用过去做归一化,并在模型的误差旁边报告朴素预测、季节性朴素预测和线性模型的误差。
你的 LSTM 预测器的验证 RMSE 是朴素预测的三分之一,用的是对重叠窗口的 80/20 随机划分。你首先检查什么?
查看答案
泄漏。按时间划分(前向滚动),并且只在训练部分上计算归一化统计量。在重叠窗口下,几乎每个测试窗口在训练集中都有近似副本,所以一旦划分尊重时间,这个优势通常会缩小或消失。
为什么季节性朴素预测在长预测步长上能胜过复杂的模型?
查看答案
它的误差不随预测步长增长:无论 h 是多少,它都复制上一个周期的同一相位。向前迭代的单步模型则把自己的误差当作输入读入,并使其累积。
一个预测器的 MASE 为 0.8。这是好还是坏?
查看答案
它比朴素预测的样本内误差好 20%。这是否算好,取决于该预测所服务的决策以及其他基线:如果线性自回归在同一划分上达到 0.6,这个网络就是在输。
监测传感器数据流:基于预测残差的异常检测
在正常运行数据上训练的预测器,是一个学到了正常动态的模型。传感器报告的值与模型预测值之差,即残差(residual)
在设备的行为与训练时一致时保持很小,不一致时则变大。残差大就是异常(anomaly)。这样,第 8 节的每一个预测器都变成了一个监测器,成为数字孪生的一个组成部分:孪生体做预测,设备报告实测值,二者之间的分歧受到监视。把预测器换成物理模型,逻辑也不变:控制工程师称之为基于模型的故障检测(model-based fault detection,Isermann,2006)。
阈值来自留出的正常数据
报警阈值要设在模型没有训练过的正常数据上,绝不能设在训练残差上:模型拟合过训练数据,所以训练残差偏小,过于乐观,把阈值放在它们的尾部,投入使用后就会过于频繁地报警。
假设残差相互独立、服从标准差为 \sigma 的高斯分布,每秒采样一次:每天 86,400 个样本。双侧阈值 k\sigma 被超过的概率为 p = 2(1-\Phi(k)),其中 \Phi 是标准正态分布函数。
- k = 3:p = 2.70\times10^{-3},86{,}400\times 2.70\times10^{-3} = 233,即每天 233 次误报。
- k = 4:p = 6.33\times10^{-5},每天 5.5 次。
- k = 5:p = 5.73\times10^{-7},每天 0.05 次:每 20 天一次。
改为要求连续三次超过 3\sigma。对独立样本,某一组连续三个样本全部超过阈值的概率为 p^3 = 1.97\times10^{-8},约每天 0.0017 次:看上去比单次 3\sigma 检验好十万倍。
真实的残差同时违背这两个假设。它们是自相关(autocorrelated)的(预测器在某一步出错,下一步通常以同样的方式出错),所以连续超限远比 p^3 所说的常见;它们还是重尾(heavy-tailed)的,因为正常运行中也包含启动这类罕见事件。应把阈值设在留出残差的某个经验分位数上,按可以容忍的误报率来选取,再加上一条持续性规则(persistence rule):最近 n 个样本中有 k 次超限才报警,同样在这批数据上测定。
每种故障需要自己的检测器
不同故障在残差中的表现各不相同,为一种故障设计的检测器可能对另一种视而不见。
| 故障 | 残差的表现 | 检测器 |
|---|---|---|
| 尖峰、突发 | 一个很大的值 | 逐点检验 \lvert r_t\rvert > k\sigma |
| 动态或噪声水平改变 | 平均变大,但很少出现极端值 | r_t 的滚动均方根,或 CUSUM |
| 传感器卡死或读数不变 | 太小:常数是完全可预测的 | 滚动标准差低于下限 |
| 持续的水平偏移 | 只在开始和结束时很大 | 对照独立参考做水平检查 |
n 个样本上的滚动均方根(RMS)会把单个值平均掉,而对残差能量的持续上升作出响应。累积和(CUSUM,Page,1954)则是累积证据:S_t = \max(0,\, S_{t-1} + r_t^2/\sigma^2 - \kappa),其中 \kappa 略大于 1(r_t^2/\sigma^2 在正常情况下的均值),当 S_t 超过某个界限时报警。
最后一行需要小心。采用逐窗口归一化(第 8 节的修复办法)的预测器在一步之内就会以新的水平为中心重新对齐,所以它只在偏移开始和结束的地方看到偏移。持续的偏移需要一个不随传感器移动的参考:冗余传感器、孪生体的物理预测,或者来自一个不重新对齐的模型的更长预测步长残差。图 4.10 画出了这条流程,以及每种故障在其检测器中的特征。
上:以方框表示的监测流程:传感器数据流、预测器、残差 r_t、三个并行的检测器(逐点检验 \lvert r_t\rvert > 4\sigma;50 个样本上的滚动均方根;滚动标准差低于下限)、报警日志。下:四个小示意图,对应表中的四种故障(尖峰、持续偏移、激励增强、传感器卡死),每个都画出故障期间的残差以及能抓住它的那一个统计量,阈值为虚线,故障区间加阴影:一个高高的残差尖峰;偏移开始和结束时的两段短促的残差脉冲;一条升到界限以上的滚动均方根;一条降到下限以下的滚动标准差。
实验 3 在刚度逐渐增大的支座信号中注入四种故障:+1.5 的尖峰、+0.8 的偏移、加倍的随机激励,以及一个冻结的传感器。在正常的留出数据上,残差标准差为 \sigma = 0.131,所以逐点阈值为 4\sigma = 4\times 0.131 = 0.52。50 个样本的滚动均方根在超过其留出数据最大值的 1.1 倍时报警;20 个样本的滚动标准差在低于其留出数据最小值的一半时报警。实验的运行结果是:
- 尖峰:逐点检验立即报警,并在下一个样本上再报警一次,因为该样本的输入窗口以这个尖峰结尾。
- 偏移:逐点检验只在偏移开始前后和结束时报警(共 3 个报警样本:开始时、4 个样本之后,以及结束时)。
- 激励加倍:极端残差很少(五次逐点报警,第一次出现在 151 个样本之后),但残差均方根从 0.134 升到约 0.21;滚动均方根在变化发生 99 个样本之后报警(换一个训练种子为 85 个)。
- 传感器卡死:卡死期间没有残差报警(只在它恢复的那个样本上有一次逐点报警);方差下限检验在卡死 21 个样本之后报警,这时它的窗口已经填满了几乎不变的残差。
- 正常时段(239 个样本):三个检测器都没有误报,但这段记录太短,无法估计误报率。
评价一个监测器
评价监测器看四个数:从故障开始到第一次报警的检测延迟(detection delay);检出的事件数,按故障事件而不是按样本计数;在一段很长的正常记录上的每天误报次数;以及精确率,它会被很低的基础率摧毁(模块 01)。每天 5.5 次误报、每月一次真实故障,意味着每一次真实故障对应 30\times5.5 = 165 次误报,精确率接近 1/166 = 0.6\%。真实故障太少,无法用来测量这些指标,所以要像实验 3 那样,把每种类型的合成故障注入留出的正常数据中。
多通道
用全部通道预测每一个通道,构成残差向量 \mathbf{r}_t\in\mathbb{R}^m,再用马氏距离(Mahalanobis distance)d_t^2 = \mathbf{r}_t^\top\boldsymbol{\Sigma}^{-1} \mathbf{r}_t 给它打分,其中 \boldsymbol{\Sigma} 是正常数据上的残差协方差。即使没有哪个通道单独看起来异常,它也能抓住破坏了通道间通常相关性的模式。高斯残差给出 d_t^2 \sim \chi^2_m;实践中,阈值同样取经验分位数。Hundman 等人(2018)把这一模式用于航天器遥测,用 LSTM 做预测,并对平滑后的预测误差设阈值;它同样适用于泵、轴承和结构。对自编码器的重构误差打分是模块 05给出的另一种做法。
为什么报警阈值要设在留出的正常数据上,而不是训练残差上?
查看答案
模型拟合过训练数据,所以它的训练残差偏小,过于乐观。把阈值放在它们的尾部,对于未见过的数据上的残差就太低了,投入使用后会过于频繁地报警。
卡死的传感器不会触发任何残差阈值报警。为什么?什么能抓住它?
查看答案
常数信号是完全可预测的,所以残差不增反减。在一个短的滚动窗口上检验残差(或信号)的方差是否低于某个下限,就能抓住它。
序列到序列:编码器、解码器、教师强制与搜索
许多序列任务把一种长度的输入映射为另一种长度的输出:翻译一个句子,总结一份报告,把一段自由文本的维护记录变成结构化的记录,把一串数字反转(实验 4)。输入第 j 步与输出第 t 步之间的对齐并未给出,输出长度也无法事先知道。编码器-解码器(encoder-decoder)模型,即序列到序列(sequence to sequence,seq2seq)模型,能同时处理这两点(Sutskever、Vinyals 和 Le,2014;Cho 等人,2014)。
编码器与解码器
编码器(encoder)RNN 读取源序列 x_1, \dots, x_S,把它的最终状态保留为摘要,\mathbf{c} = \mathbf{h}_S。解码器(decoder)RNN 从这个摘要出发,一次生成一个 token,每一步都以自己的状态和上一步产生的 token 为条件:
其中 f_\text{enc} 和 f_\text{dec} 是 LSTM 或 GRU 单元,g 是一个学习得到的映射(通常是恒等映射,或者一个带 tanh 的线性层),\mathbf{y}_{t-1} 是上一个 token 的嵌入。输出由两个特殊 token 界定:解码器的第一个输入是序列开始(begin-of-sequence,BOS)token,解码器通过输出序列结束(end-of-sequence,EOS)token 来结束输出,它正是以这种方式选择输出长度的。按概率的链式法则,模型定义了整个输出序列上的分布:
用教师强制训练
训练最大化给定源序列时目标序列的对数似然:
采用教师强制(teacher forcing)时,解码器在第 t 步的输入是真实的上一个 token y_{t-1},而不是模型自己的猜测。这样,前向传播开始之前,解码器的每一个输入都是已知的:不需要采样循环,每一步都在干净的前缀上用普通的交叉熵训练。于是 Transformer 解码器可以并行计算所有位置(模块 06)。RNN 解码器仍然要循环,因为 \mathbf{s}_t 需要 \mathbf{s}_{t-1},但它的循环不生成任何东西。图 4.11 把训练和推理并排画出。
两幅图,编码器相同(一行单元依次读入数字 3 9 1 4),解码器也相同。训练:解码器的输入是 BOS、4、1、9,即真实的上一个 token,以绿色绘制,每个输出都与其目标比较。推理:解码器的输入是模型自己先前的输出,以橙色绘制;其中一个错误的 token 被突出显示,其后的输出加了阴影,表示误差在累积。
暴露偏差
测试时没有真实的上一个 token;解码器以自己的输出为条件。一个错误的 token 就会把它带入任何训练步骤都没产生过的状态,下一个预测随之变得不那么可靠,误差不断累积。Ranzato 等人(2016)把这称为暴露偏差(exposure bias):模型只接触过正确的前缀。实验 4 测量了它。对于不带注意力的模型,在长度 12 时,每一步都给定真实前缀(教师强制)时 token 准确率为 74%,模型以自己的输出运行(自由运行)时为 53%;长度 8 时为 91% 对 80%;长度 4 时差距小到可以忽略(99.7% 对 99.4%)。
计划采样(scheduled sampling,Bengio 等人,2015)以一个在训练过程中逐渐升高的概率,用模型自己的预测代替真实 token 作为输入,使模型学会从自己的错误中恢复。在模型自己的展开序列上训练,能更直接地达到同样的目的。序列级目标(sequence-level objective)给整个生成的输出打分;模块 09的强化学习方法就是它们的现代形式。无论怎样训练,都要以自由运行的方式评估:这是部署时唯一的运行方式。
解码:贪心与束搜索
模型每次给出一步的 p(y_t \mid y_{<t}, x)。为了产生输出,我们想要概率最大的序列 \argmax_{y} p(y \mid x)。贪心解码(greedy decoding)在每一步选取概率最大的 token 并把它反馈回去。它找不到概率最大的序列,因为眼下看来最好的 token 可能只能引出糟糕的后续。精确搜索又做不到:词表大小 V = 10{,}000、输出 20 个 token 时,候选有 V^{20} = 10^{80} 个。
束搜索(beam search)是一种折中。保留 k 个最好的部分序列(即束),按累积对数概率 \sum_t \ln p(y_t \mid y_{<t}, x) 打分。每一步用每个 token 扩展每个假设,给 k\cdot V 个扩展打分,保留最好的 k 个。输出 EOS 的假设已经完成:把它放到一边,继续处理其余的。当束变空或达到长度上限时停止,返回最好的已完成假设。k = 1 时它就是贪心解码;翻译中通常取 k = 4 到 10。
一个在 token \{A, B, \langle e\rangle\} 上的解码器,其中 \langle e\rangle 是 EOS。它的概率为:
- 第 1 步:A 0.5,B 0.4,\langle e\rangle 0.1;
- 在 A 之后:A 0.3,B 0.3,\langle e\rangle 0.4;
- 在 B 之后:A 0.9,B 0.05,\langle e\rangle 0.05;
- 任意两个 token 之后:以概率 1 输出 \langle e\rangle。
贪心解码。 第 1 步选 A(0.5)。在 A 之后最好的 token 是 \langle e\rangle(0.4)。输出 A\langle e\rangle,概率为 0.5\times0.4 = 0.20。
束搜索,k = 2。 第 1 步保留 A(0.5)和 B(0.4)。第 2 步给六个扩展打分:
BA:0.4\times0.9 = 0.36;A\langle e\rangle:0.5\times0.4 = 0.20;AA:0.5\times0.3 = 0.15;AB:0.15;BB:0.4\times0.05 = 0.02;B\langle e\rangle:0.02。
最好的两个是 BA(0.36)和 A\langle e\rangle(0.20)。A\langle e\rangle 已经完成,被放到一边;BA 继续,并且必然以 \langle e\rangle 结束,所以 BA\langle e\rangle 的概率为 0.36\times1 = 0.36。最好的已完成假设是 BA\langle e\rangle,其概率是贪心解码答案的 0.36/0.20 = 1.8 倍。
用对数得分表示:\ln 0.36 = -1.022,\ln 0.20 = -1.609。除以 token 长度(3 和 2):-0.341 和 -0.805。这里两种打分方式结论一致。图 4.12 画出了搜索树。
玩具示例的束搜索树。根节点有子节点 A(0.5)、B(0.4)和 \langle e\rangle(0.1);第二层显示 A 和 B 各自的三个子节点及其序列概率。每一层保留的两个假设用粗线框出,被剪掉的显示为灰色。贪心路径为蓝色虚线,终止于 A\langle e\rangle(0.20);束搜索的答案 BA\langle e\rangle(0.36)为绿色粗线。
束搜索有一个已知的偏差。每个 token 都把概率乘以一个小于 1 的数,所以对数概率之和偏爱短的输出;而更大的束搜索得更努力,会找到更多短而得分高的假设:超过某一点后,加宽束反而得到更短、更差的输出。长度归一化(length normalisation)把得分除以长度的某个幂,\ln p(y\mid x)/|y|^\alpha,其中 0 < \alpha \le 1;Wu 等人(2016)使用平滑过的除数 \big((5+|y|)/6\big)^\alpha。设置最小长度是一种更粗糙的防护。束搜索适用于只想要单个最佳输出的任务;需要多样的输出时,采样更合适(模块 07)。搜索也修复不了一个不知道答案的模型:在实验 4 中,k = 4 的束搜索与贪心解码一样,让瓶颈模型在长度 12 时 200 个字符串中一个都没答对,而它的 token 准确率还从 52.3% 降到 49.1%:束找到了模型认为概率更高的输出,但它们并没有更正确。
瓶颈
解码器对源序列所知道的一切,都要通过一个固定大小的向量。Sutskever 等人发现,把源句子的顺序反转能显著改善他们的翻译。反转使源句的头几个词紧挨着目标句的头几个词,于是解码器最先需要的依赖都很短;这样的技巧居然有用,本身就是瓶颈的一种症状。Cho、van Merriënboer、Bahdanau 和 Bengio(2014)观察到,翻译质量随句子变长而下降。实验 4 干净地测出了这一点:用摘要为 64 个数的 GRU 编码器-解码器反转数字串,序列准确率在长度 4 时约为 98%,长度 8 时为 43%,长度 12 时为 1%(一次运行;换一个种子,中间的那个值会变动几个百分点)。第 11 节消除了这个瓶颈。
编码器-解码器逐 token 地分解 p(y\mid x);它在真实前缀上训练,靠自己的输出解码,并受限于承载源序列的那一个向量。
k = 1 的束搜索是什么算法?
查看答案
贪心解码:束中只有一个假设,每一步都用它的那个概率最大的 token 来扩展。
为什么教师强制让训练更容易,却带来了暴露偏差?
查看答案
解码器的输入是已知的目标,所以没有采样循环,每一步都在正确的前缀上以干净的信号训练。但模型从未见过自己的错误,所以测试时一个错误的 token 就会把它带入训练中从未遇到过的状态,误差不断累积。
注意力:从瓶颈到软对齐
第 10 节的瓶颈是一种选择,而不是必然。编码器在每个源位置上都计算出一个状态;普通的编码器-解码器只保留最后一个,其余全部丢掉。注意力(attention,Bahdanau、Cho 和 Bengio,2015)把它们全部保留下来,让解码器在每一步计算自己的源序列摘要,并向那些对它即将产生的 token 重要的位置倾斜。
公式
把编码器状态,即注释向量(annotation),记作 \mathbf{h}_1, \dots, \mathbf{h}_S。在 Bahdanau 等人的工作中,它们来自一个双向编码器(第 6 节),\mathbf{h}_j = [\overrightarrow{\mathbf{h}}_j; \overleftarrow{\mathbf{h}}_j],所以每一个都在整个源序列的上下文中描述位置 j。在解码器的第 t 步,三个运算把它们变成一个上下文向量(context vector)\mathbf{a}_t:
得分是一个单隐藏层网络,评价注释向量 j 与解码器当前需要的匹配程度;它的参数 \mathbf{W}_a、\mathbf{U}_a 和 \mathbf{v}_a 沿用 Bahdanau 等人的命名,与第 2 节的循环矩阵不是一回事。softmax 把得分变成在 j 上为正且总和为 1 的权重;上下文就是注释向量的加权平均。然后解码器把上下文与自己的状态一起读入。按实验 4 所用的形式,
一切都是可微的,所以得分网络与其余部分一样,用同一个交叉熵训练;没有人告诉模型该看哪里。由于得分是一个经过 tanh 的和,这种注意力称为加性(additive)注意力。图 4.13 展示了其中一步。
解码器一步中的注意力。左边是一列编码器注释向量 \mathbf{h}_1, \dots, \mathbf{h}_S,每个画成上下叠放的一对(前向和后向状态)。右边是解码器状态 \mathbf{s}_{t-1}。连线从 \mathbf{s}_{t-1} 经过一个小的“得分”节点通向每个 \mathbf{h}_j;编码器那一列旁边是权重 \alpha_{t,j} 的条形图;一个求和节点产生 \mathbf{a}_t,它与 y_{t-1} 一起送入解码器单元。
形状、开销与掩码
设编码器每个方向的宽度为 H,则注释向量的宽度为 2H;解码器状态的宽度为 H;注意力的宽度为 d_a。于是 \mathbf{W}_a \in \mathbb{R}^{d_a\times H},\mathbf{U}_a\in\mathbb{R}^{d_a\times 2H},\mathbf{v}_a\in\mathbb{R}^{d_a}。乘积 \mathbf{U}_a\mathbf{h}_j 与 t 无关,所以每个源序列只需计算一次。之后解码器的每一步把 \mathbf{W}_a\mathbf{s}_{t-1} 加到 S 个预先算好的向量上,应用 tanh,与 \mathbf{v}_a 做 S 次点积,再对 S 个注释向量求加权和:工作量为 O(S(d_a + H))。T' 个 token 的输出需要 O(S\,T') 个这样的单位,即两个长度的乘积。这是注意力的二次开销第一次出现。
在填充过的 batch 中,有些源位置是填充。它们的得分在 softmax 之前被设为 -\infty(实践中取 -10^9,指数函数会把它变成精确的零),因而得不到任何权重。实验 4 这样做了;忘了这一步,解码器就会关注填充。
取 \mathbf{W}_a = \mathbf{I},\mathbf{U}_a = \begin{bmatrix}0.5 & -0.5\\ 1 & 0\end{bmatrix},\mathbf{v}_a = (1, -1),解码器状态 \mathbf{s}_{t-1} = (0.5, -0.5),三个注释向量 \mathbf{h}_1 = (1, 0),\mathbf{h}_2 = (0, 1),\mathbf{h}_3 = (1, 1)。
- \mathbf{W}_a\mathbf{s}_{t-1} = (0.5, -0.5)。
- \mathbf{U}_a\mathbf{h}_1 = (0.5, 1),\mathbf{U}_a\mathbf{h}_2 = (-0.5, 0), \mathbf{U}_a\mathbf{h}_3 = (0, 1)。
- 求和:(1, 0.5),(0, -0.5),(0.5, 0.5)。
- tanh:(0.7616, 0.4621),(0, -0.4621),(0.4621, 0.4621)。
- 得分 e_j = \mathbf{v}_a^\top(\cdot),即第一个分量减第二个分量: 0.2995,0.4621,0。
- 权重:\exp(e) = (1.3492, 1.5874, 1),总和 3.9366,所以 \alpha = (0.3427, 0.4033, 0.2540)。
- 上下文:0.3427(1,0) + 0.4033(0,1) + 0.2540(1,1) = (0.5967, 0.6573)。
权重之和为 1,只是略微偏向 \mathbf{h}_2:得分很小时,softmax 保持柔和,上下文是一种混合。
对齐
权重 \alpha_{t,j} 构成一个矩阵,每个输出步一行,每个源位置一列:这是一种软对齐(soft alignment),说明解码器在产生每个输出时看的是哪些源位置。它可以画出来。Bahdanau 等人给出的英法翻译对齐图大体是对角的,因为两种语言的语序相同,在语序不同的地方,例如形容词与名词顺序互换处,则有局部的偏离。对数字反转,对齐应当是反对角线,结果也确实如此。在实验 4 中,对一个 8 位数字的输入,每个数字所在行的 argmax 为 (7, 6, 5, 4, 3, 2, 1, 0),峰值权重在 0.63 到 0.84 之间:模型找到了“看镜像位置”的规律。实验 4 第 6 步画出了这张热图。有注意力时,序列准确率在长度 4、8 和 12 上都是 100%,没有注意力时约为 98%、43% 和 1%。
Luong 的变体,以及点积的尺度
Luong、Pham 和 Manning(2015)简化了这一设计,并给出了若干变体。他们比较了三种得分:点积(dot),\mathbf{s}_t^\top\mathbf{h}_j;一般形式(general),\mathbf{s}_t^\top\mathbf{W}\mathbf{h}_j;以及拼接(concat),即加性形式。他们用当前的解码器状态 \mathbf{s}_t 而不是 \mathbf{s}_{t-1} 计算注意力;比较了在全部源位置上的全局(global)注意力与在预测位置附近一个窗口内的局部(local)注意力;并把每一步的注意力输出作为输入送回下一步。点积得分没有参数,把注意力变成了矩阵乘积,Transformer 保留的正是这种形式。它有一个需要留意的性质:它的尺度随宽度增长。
解码器状态 \mathbf{s} = (1, 0);注释向量仍为 (1,0)、(0,1)、(1,1)。
得分 \mathbf{s}^\top\mathbf{h}_j = (1, 0, 1)。指数 (2.7183, 1, 2.7183),总和 6.4366;权重 (0.4223, 0.1554, 0.4223)。上下文 0.4223(1,0) + 0.1554(0,1) + 0.4223(1,1) = (0.8446, 0.5777)。
现在取 \mathbf{s} = (3, 0),方向相同,长度是三倍。得分 (3, 0, 3);指数 (20.086, 1, 20.086),总和 41.171;权重 (0.4879, 0.0243, 0.4879);上下文 (0.9757, 0.5121)。\mathbf{h}_2 上的权重从 0.155 降到 0.024。
得分越大,softmax 越尖锐。对于 d 个分量相互独立、均值为零、方差为 1 的向量,\operatorname{Var}(\mathbf{s}^\top\mathbf{h}) = \sum_{i=1}^{d} \mathbb{E}[s_i^2]\,\mathbb{E}[h_i^2] = d,所以典型的得分按 \sqrt d 增长,宽模型的 softmax 会饱和,梯度随之消失。模块 06 正是出于这个原因把得分除以 \sqrt{d_k}。
它为什么有效
现在每个输出到每个输入都有一条一步长的路径,信息和梯度都走这条路。没有什么需要被挤进一个向量,从某个输出到它所需的源位置的梯度,只经过一次加权求和,而不必穿过其间的每一个编码器和解码器步骤。这与 LSTM 的加性路径(第 5 节)和残差连接是同一个论证:给信号一条短路。同样的手段也可以替代多对一循环分类器中的“取最后一个状态”:用一个学习得到的查询向量,对所有状态做注意力加权平均,在时间上做池化。
从这里到模块 06
在点积形式中,解码器状态扮演查询(query)的角色,编码器状态既扮演被打分的键(key),也扮演被平均的值(value)。去掉循环,让序列中的每个位置都对同一序列中的所有其他位置发出查询,结果就是自注意力(self-attention),即 Transformer 的核心。模块 06 从这里接着讲。
对齐图不是解释。注意力权重可以大幅改变而不改变模型的预测,不同的权重模式也可以给出相同的输出(Jain 和 Wallace,2019;Wiegreffe 和 Pinter,2019 对它们何时可以提供信息给出了限定条件)。应把对齐当作诊断工具,并通过干预输入来证实所声称的依赖关系。
解码器某一步的注意力权重之和是多少?是在什么上求和?
查看答案
和为 1,在编码器位置 j = 1, \dots, S 上求和(填充位置的权重为零)。
为什么注意力能阻止准确率随源序列长度下降?
查看答案
解码器在每一步都通过加权求和读取所有编码器状态,所以没有什么需要装进一个向量,而且每个输出到每个输入的路径只有一步长,信息和梯度都是如此。
Transformer 为何取代了循环
循环网络有两项开销是其结构所固有的。更好的单元消除不了其中任何一项,二者合起来解释了为什么序列建模先转向卷积,再转向 Transformer。
两项开销
时间上无法并行。 \mathbf{h}_t 需要 \mathbf{h}_{t-1},所以一个 10,000 个 token 的序列在每一层都是 10,000 个相互依赖的步骤,无论有多少处理器可用。教师强制让每个输入都事先已知,但这无济于事:\mathbf{h}_t 非线性地依赖于 \mathbf{h}_{t-1},后者必须先算出来。跨序列的数据并行仍然可行;受影响的是每一步计算的规模。每一步对 batch 中的每个序列只是一个小的矩阵乘积,太少,不足以让现代加速器保持繁忙,而长上下文又让这条链更长。对于模块 08 所描述的那种规模的语料,这条串行链就成了瓶颈。
路径很长。 位置 j 的信息要经过 t - j 次循环才能到达位置 t,每一次都有损失(第 4 节)。注意力一步就把它们连起来;一叠空洞卷积大约需要 \log_2(t-j) 步。
卷积方案先出现
WaveNet(van den Oord 等人,2016)用一叠因果空洞一维卷积(causal dilated 1D convolution,模块 03)生成音频:每个输出只看过去,第 l 层在相邻抽头之间跳过 d_l - 1 个样本。Bai、Kolter 和 Koltun(2018)把这种设计提炼成通用的时间卷积网络(temporal convolutional network,TCN),发现它在一系列标准序列基准上达到或超过了 LSTM 和 GRU。TCN 在训练中可以在时间上并行,因为每个输出都是已知输入的卷积。卷积核大小为 k、空洞率为 d_1, \dots, d_L 时,它的感受野为 1 + (k-1)\sum_l d_l 个样本。
卷积核 k = 2,空洞率 1, 2, 4, \dots, 512:十层。感受野为 1 + 1\cdot(1 + 2 + 4 + \dots + 512) = 1 + 1{,}023 = 1{,}024 步。每增加一层,所及范围翻一倍。1,000 步之前的输入经过十层到达输出;在一个循环层中,它要经过 1,000 个相互依赖的步骤。练习 15 为与实验 3 的 64 样本窗口相匹配的六层 TCN 确定尺寸。
它的局限是固定的感受野:比感受野更早的东西不能影响输出,要覆盖更长的历史就得加层。
Transformer 的取舍,以及循环保留下来的东西
Transformer(模块 06)用少数几个大的矩阵乘积并行计算每个位置,任意两个位置之间的路径长度为 1。代价是与序列长度成二次关系的开销,因为每个位置都要给其他每个位置打分。对于在大规模语料上训练,这个取舍是对的。
到了推理时,取舍反了过来。循环网络以恒定的计算量和固定大小的状态生成每个 token。Transformer 则要存储每个过去 token 的键和值,即模块 10 推导的 KV cache,它随上下文增长。
一个 H = 1{,}024、fp32 的 4 层 LSTM 每层保存 (\mathbf{h}, \mathbf{c}):每个序列 2\times4\times1{,}024\times4\ \text{B} = 32{,}768 B = 32.8 kB(32 KiB),与上下文长度无关。
一个宽度为 2,048、不用分组查询注意力的 24 层 Transformer,为每个过去的 token 在每层存储一个键向量和一个值向量:在 16 位精度下,每个 token 2\times24\times2{,}048\times2\ \text{B} = 196{,}608 B = 196.6 kB(192 KiB)。32,768 个 token 时,这是 196{,}608\times32{,}768 = 6.44\times10^9 B = 6.44 GB(6.0 GiB)。分组查询注意力把它除以分组因子(模块 10)。
下面的比较沿用 Vaswani 等人(2017)的做法,他们给出过一张类似的表;图 4.14 画出了三种依赖图。T 是序列长度,d 是宽度,k 是卷积核大小。
| RNN | 空洞 TCN | 自注意力 | |
|---|---|---|---|
| 训练中每层的顺序操作数 | O(T) | O(1) | O(1) |
| 最大路径长度 | O(T) | O(\log T) | O(1) |
| 每层计算量 | O(T d^2) | O(k\,T d^2) | O(T^2 d) |
| 推理时每个数据流的内存 | 固定状态,O(d) | 每个空洞层级一个缓冲区 | KV cache,O(T d) |
| 感受野 | 原则上无界 | 由空洞率固定 | 整个上下文 |
八个位置上的三种依赖图。一条链(RNN),突出显示从位置 1 到位置 8 的路径:长度 7。一棵空洞二叉树(TCN),路径长度 3。一个画成全连接扇形的完全图(自注意力),路径长度 1。每张图都标出了它的最大路径长度,即它所图示的那张表的第二行。
线性注意力就是一种循环
这两类模型比表中所显示的更接近。Katharopoulos 等人(2020)用一个核特征映射 \phi 取代 softmax,于是因果注意力变成 \mathbf{y}_t = \mathbf{S}_t\phi(\mathbf{q}_t)/(\mathbf{z}_t^\top\phi(\mathbf{q}_t)),其中 \mathbf{S}_t = \mathbf{S}_{t-1} + \mathbf{v}_t\phi(\mathbf{k}_t)^\top,\mathbf{z}_t = \mathbf{z}_{t-1} + \phi(\mathbf{k}_t):一个状态为矩阵、靠加法更新的 RNN。第 13 节沿着这座桥继续往下走。
采用教师强制时,解码器的每个输入都事先已知。为什么 LSTM 仍然不能一次处理所有位置?
查看答案
\mathbf{h}_t 非线性地依赖于 \mathbf{h}_{t-1},后者必须先算出来。知道输入并不能打断这条链。
因果 TCN 和 LSTM 都可以一次处理数据流中的一个样本。谁的每流内存随它能利用的历史长度增长?
查看答案
TCN 的。每一层保存它最近的 (k-1)d_l 个输入,所以每个通道的缓冲区加起来大约等于感受野。LSTM 无论历史多长,都只保存一个固定大小的状态。
回归的东西:线性循环与状态空间模型
第 12 节的两项开销来自同一个地方:循环内部的非线性。它迫使计算成为串行循环,加上饱和,又在每一步缩小梯度。把它从循环中拿出来,改放到层与层之间(逐步的 MLP 和门),循环就变得可以并行训练,在长距离上也可以控制。
线性循环就是卷积
让状态线性地演化,取 \mathbf{h}_0 = \mathbf{0}:
把它展开:\mathbf{h}_1 = \mathbf{B}\mathbf{x}_1,\mathbf{h}_2 = \mathbf{A}\mathbf{B}\mathbf{x}_1 + \mathbf{B}\mathbf{x}_2,一般地
输出是输入与卷积核 \mathbf{K}_k 的因果卷积,而这个卷积核就是系统对单位冲激的响应。工程师熟悉这个对象:一个线性时不变系统,一个 IIR 滤波器,它的卷积核各项就是状态空间模型的马尔可夫参数。图 4.15 画出了一个标量模态的两种视角。
h_t = 0.9\,h_{t-1} + x_t,y_t = 0.5\,h_t,输入 x = (1, 2, 0, -1)。
循环:h = (1,\ 0.9 + 2 = 2.9,\ 2.61,\ 2.349 - 1 = 1.349),所以 y = (0.5, 1.45, 1.305, 0.6745)。
卷积核:K_k = 0.5\times0.9^k = (0.5, 0.45, 0.405, 0.3645)。在 t = 4 处做卷积:y_4 = 0.5(-1) + 0.45(0) + 0.405(2) + 0.3645(1) = -0.5 + 0 + 0.81 + 0.3645 = 0.6745。完全相同。
计算同一个映射的三种方式
循环模式(recurrent mode)一次更新一步状态:每一步的开销和内存都是常数,非常适合生成和流式处理。卷积模式(convolution mode)先算出一次卷积核,再通过 FFT 以 O(T\log T) 对整个序列做卷积:所有步一次完成,非常适合训练。第三种是并行扫描(parallel scan),即使系数随 t 变化也适用。把标量循环的一步写成仿射映射 h \mapsto a h + b。两步复合起来仍是一个仿射映射:
复合满足结合律,所以前缀 h_1, \dots, h_T 可以在一棵平衡树中合并,深度为 O(\log T) 层,总工作量为 O(T)(Blelloch,1990)。tanh 循环没有这样的运算:两步 \tanh(w\tanh(wh + b_1) + b_2) 并不是同一形式的一步。
长度 T = 4{,}096 的直接因果卷积,每个通道大约需要 T^2/2 = 8.4 百万次乘加。基于 FFT 的卷积填充到 2T,大约需要 3\times 2T\log_2(2T) = 3\times8{,}192 \times13 \approx 0.32 百万次(数量级估计)。循环只需要每个通道 T 次乘加,但它们是串行的。在 CPU 上,计数并不能决定胜负。实验 5 的计时(batch 为 8,N = 64,三次取最好,所示为其中一次运行)为:T = 256 时循环 4.2 ms 对 FFT 形式 3.8 ms,1,024 时 19.8 对 13.8 ms,4,096 时 79.1 对 70.0 ms。在五次运行中,FFT 形式在两个较短长度上快 1.1 到 1.7 倍,在 4,096 上为 0.7 到 1.1 倍:最多只是稍快一些,在最长的长度上则根本没有更快。卷积模式要在并行硬件能够吸收它更大的并行工作量的地方,即在 GPU 上和训练中,才划算。
循环与卷积的对偶性。左:循环 h_t = \lambda h_{t-1} + b x_t 画成一个带自环的单元,自环标为 \lambda。右:同一个系统作为卷积,t = 0 处的输入冲激,以及以杆状图画出的卷积核 K_k = c\lambda^k b,分别对应实数 \lambda = 0.9(单调衰减)和复数 \lambda = 0.95e^{i\pi/8}(周期为 16 的阻尼振荡,包络 \pm0.95^k 为虚线)。一个等号连接左右两半。
对角、复数与稳定
稠密 \mathbf{A} 的幂计算代价高,也难以控制,所以把它对角化,\mathbf{A} = \mathbf{V}\boldsymbol{\Lambda}\mathbf{V}^{-1},换元为 \tilde{\mathbf{h}} = \mathbf{V}^{-1}\mathbf{h},系统就分解成 N 个独立的标量循环,\tilde h_{t,n} = \lambda_n\tilde h_{t-1,n} + (\tilde{\mathbf{B}}\mathbf{x}_t)_n,其中 \tilde{\mathbf{B}} = \mathbf{V}^{-1}\mathbf{B}。特征值一般是复数,\lambda = re^{i\theta}:模 r 决定记忆,半衰期为 \ln 0.5/\ln r 步;辐角 \theta 决定一个周期为 2\pi/\theta 步的振荡。通过实部来看,一个复数模态就是一个阻尼振荡器。
\lambda = 0.95e^{i\pi/8},所以 \operatorname{Re}(\lambda^k) = 0.95^k\cos(k\pi/8)。对 k = 0, \dots, 8:1, 0.878, 0.638, 0.328, 0, -0.296, -0.520, -0.645, -0.663。验证 k = 2:0.9025\times\cos(\pi/4) = 0.9025\times0.7071 = 0.638。周期为 2\pi/(\pi/8) = 16 步,半衰期为 \ln 0.5/\ln 0.95 = -0.6931/(-0.05129) = 13.5 步。
稳定性由参数化本身保证。线性循环单元(Linear Recurrent Unit,LRU;Orvieto 等人,2023)写成 \lambda = \exp(-\exp(\nu) + i\theta),其中 \nu 和 \theta 是可训练的实数。于是对每个 \nu 都有 |\lambda| = \exp(-e^{\nu}) < 1:任何梯度步都不能让它爆炸。每个模态的输入乘以 \gamma = \sqrt{1-|\lambda|^2},因为对于输入为单位方差白噪声的 h_t = \lambda h_{t-1} + \gamma u_t,平稳方差满足 v = |\lambda|^2 v + \gamma^2,所以即使在单位圆附近也有 v = \gamma^2/(1-|\lambda|^2) = 1。
由 \nu 求半衰期:|\lambda| = e^{-e^\nu},所以 \ln|\lambda| = -e^\nu,半衰期为 \ln 2\cdot e^{-\nu}。取 \nu = \ln 0.001:|\lambda| = e^{-0.001} = 0.9990,半衰期为 0.6931/0.001 = 693 步。\nu 每变化相同的量,半衰期就改变相同的倍数,这使 \nu 成为一个便于训练的参数。
实验 5 从环 [0.9, 0.999] 中抽取它的 64 个模,两个端点的半衰期分别为 \ln 0.5/\ln 0.9 = 6.6 步和 \ln 0.5/\ln 0.999 = 693 步。抽到的模的范围为 0.902–0.998724,对应 6.7–543 步。在单位圆附近,小数点后第五位都很重要:0.9987 会给出 533 步。
连续时间与步长
状态空间模型常写成连续时间形式,\dot{\mathbf{h}} = \mathbf{A}\mathbf{h} + \mathbf{B}x(t),再以步长 \Delta 离散化。在每一步内保持输入不变(零阶保持,zero-order hold),并精确求解这个线性常微分方程,对一个标量模态 \lambda 得到
写成矩阵形式为 \bar{\mathbf{A}} = \exp(\Delta\mathbf{A}),\bar{\mathbf{B}} = \mathbf{A}^{-1}(\exp(\Delta\mathbf{A}) - \mathbf{I})\mathbf{B}。\Delta 是每一步经过的时间:小的 \Delta 保持状态(a\approx1),大的 \Delta 重置状态(a\approx0)。
\Delta = 1:a = e^{-0.1} = 0.9048,b = (0.9048-1)/(-0.1) = 0.9516。前向欧拉法会给出 1 + \lambda\Delta = 0.9 和 \Delta = 1.0。
\Delta = 0.1:a = e^{-0.01} = 0.990,b = 0.0995:保持状态,写入很少。
\Delta = 10:a = e^{-1} = 0.368,b = (0.368-1)/(-0.1) = 6.32:大部分遗忘,写入很多。
作为门 a_t = \exp(-\Delta_t):\Delta_t = 0.01 给出 0.990(保持),\Delta_t = 5 给出 0.0067(重置)。
S4 与对角模型
S4(Gu、Goel 和 Ré,2022)让这一切变得实用。它的 \mathbf{A} 用 HiPPO(Gu 等人,2020)初始化,这种构造使状态保存输入历史的最优多项式逼近,并且它能高效地计算长卷积核。S4 在整个 Long Range Arena 基准(Tay 等人,2021)上胜过了先前的模型,包括其中 16,384 步的 Path-X 任务,先前的模型在这个任务上一直停留在随机水平。随后,对角变体(Gupta、Gu 和 Berant 2022 的 DSS;Gu 等人 2022 的 S4D)和 LRU 表明,一个经过仔细参数化、在单位圆附近初始化的对角复数循环就足够了。LRU 论文把它的模型表述为一个被线性化和对角化的 RNN:即第 2 节的朴素循环,只是把 tanh 移到了循环之外。
Mamba:步长取决于输入
S4 的系数在每一步都相同,所以它无法根据自己读到的内容决定保留什么。Mamba(Gu 和 Dao,2023)加入了选择性(selectivity):\Delta、\mathbf{B} 和 \mathbf{C} 变成当前输入的函数,\Delta_t = \operatorname{softplus}(\text{linear}(\mathbf{x}_t))。系统不再是时不变的,所以没有固定的卷积核,也没有卷积模式;Mamba 用一种硬件感知的并行扫描来计算循环。\Delta_t 起着门的作用。大的 \Delta_t 把 a_t 推向 0、把 b_t 推高:重置状态并写入当前输入。小的 \Delta_t 保持状态并忽略输入(图 4.16)。第 5 节的遗忘门和输入门又回来了,只是位于一个线性循环之内。Mamba-2(Dao 和 Gu,2024)把选择性状态空间模型与线性注意力联系起来,与第 12 节首尾相接。
选择性循环。上:一个输入序列,其中有一个突出显示的“重要”token;一个小网络把每个 x_t 映射为 \Delta_t,以条形图画在序列下方,几乎处处很小,在重要 token 处很大。中:保持率 a_t = \exp(-\Delta_t) 和状态轨迹,状态在重要 token 处重置并存下它,然后保持住。下:八个位置上的并行扫描树,分三层合并 (a, b) 对。
实验 5 显示了什么
实验 5 构建了一个 LRU 风格的对角循环。它的循环形式和 FFT 形式在 float32 舍入误差范围内一致,相差约百万分之几到十万分之几。在延迟回忆任务上(记住 L+1 个 token 中的第一个),经过 400 次更新,它在滞后 25、100 和 200 上、在尝试过的全部五个种子上都达到 100%。朴素 RNN 只部分学会了滞后 25(五个种子上为 62% 到 87%),在滞后 100 上表现不稳定(两个种子 100%,三个种子停在随机水平)。LSTM 取决于它的遗忘门偏置:偏置为 1 时,即使在滞后 25 上也停在随机水平;偏置为 5 时,它在滞后 25 上学得最快,在五个种子中有两个学会了滞后 100,而在滞后 200 上失败。这个循环的记忆在初始化时就由它的特征值的模确定了。这是关于在给定预算内可训练性的陈述,并不证明 LSTM 无法记忆。
现状
截至 2026 年,保守地说:状态空间层和线性循环层在小规模和中等规模上可以与 Transformer 竞争,在长上下文中每个 token 的开销则低得多。它们的弱点是精确回忆任意一个较早的 token,因为固定大小的状态必须压缩过去,而注意力可以查找任何东西。在许多循环层或状态空间层中穿插少数几个注意力层的混合架构是一种常见设计(Jamba,Lieber 等人,2024,是一个已发表的例子),而最大的语言模型仍然以 Transformer 为主。xLSTM(Beck 等人,2024)重新审视了 LSTM 本身。循环这个想法并没有输;输掉的是 1997 年的那个实现。
| 情形 | 首选 |
|---|---|
| 短序列、数据少,或在小型设备上做流式处理 | GRU 或 LSTM,或以循环模式运行的小型对角循环 |
| 对整条序列做离线标注 | 双向 LSTM 或 Transformer 编码器 |
| 预测一条或少数几条序列 | 先用朴素、季节性朴素和线性基线;如果前向滚动验证的各折结果支持,再用 LSTM 或 TCN |
| 具有长程结构的超长序列 | 状态空间或线性循环的堆叠,或带高效注意力的 Transformer |
| 大规模语言建模 | Transformer 或混合架构(模块 06–08) |
对状态线性的循环就是卷积:它可以并行训练,它的记忆由特征值的模决定,而让它的步长取决于输入,又把它变回了门。
为什么 S4 式的层可以作为卷积来训练,而 Mamba 层不行?
查看答案
S4 的 \mathbf{A}、\mathbf{B}、\mathbf{C} 和 \Delta 在每一步都相同,所以卷积核 \mathbf{C}\bar{\mathbf{A}}^k\bar{\mathbf{B}} 是一个固定的序列。Mamba 的 \Delta、\mathbf{B} 和 \mathbf{C} 取决于输入,所以没有单一的卷积核;它使用并行扫描。
一个对角循环的 |\lambda| = 0.99。经过多少步之后,一个输入的影响减半?
查看答案
\ln 0.5/\ln 0.99 = -0.6931/(-0.01005) = 69 步。
固定大小的循环状态有什么弱点,促使人们采用带少数几个注意力层的混合架构?
查看答案
状态必须压缩整个过去,所以精确检索任意一个较早的 token 很难;注意力可以直接寻址任何位置。
常见问题与排查
下面每一条都给出你看到的症状、通常的原因和修复方法。其中大多数都特意在某个实验中出现过。
预测器在验证中表现出色,投入使用后却失败
症状:验证误差远低于朴素预测;投入使用后,模型并不比持续性预测好。原因:重叠的窗口在随机划分之前被打乱了,归一化又用了整条序列,所以“预测”其实是在记住的邻居之间做插值(第 8 节)。修复:按时间划分,使用前向滚动验证的各折,所有统计量只在训练部分上计算,并在训练目标与验证输入之间留出至少一个预测步长的间隔。
LSTM 输给了“明天等于今天”
症状:在最新的数据上,网络比持续性预测还差:第 8 节例题的代码得分 1.075,而朴素预测为 0.155;同一个模型在实验 3 中为 0.43 对 0.36。原因:水平漂移到了训练中从未见过的范围,而网络不会外推水平:它的预测偏向它已知的水平。修复:逐窗口归一化(减去最后一个值或窗口均值;RevIN)或对序列做差分,并且始终把朴素基线打印在模型旁边。
损失出现尖峰或变成 NaN
症状:训练正常运行了几千次更新,然后损失突然跳升或变成 NaN。原因:损失曲面上的悬崖导致梯度爆炸(第 4 节)。修复:把全局梯度范数裁剪到 1 到 5,降低学习率,并检查输入中的离群值。在裁剪之前记录范数;持续上升的趋势就是预警。
网络忽略了大约 20 步之前的一切
症状:短程结构学到了,长程结构没有学到;在实验 1 中,闭合标签大约五行中只有一行匹配,比随机猜测的八分之一高不了多少。原因:朴素 RNN 中的梯度消失,或者截断的随时间反向传播的窗口比依赖关系短(第 3 节)。修复:使用 LSTM 或 GRU、更长的截断,或者线性循环模型或注意力模型。画出梯度范数随滞后的变化(实验 2)来证实诊断。
LSTM 学得很慢,看起来没有记忆
症状:前一千次更新中损失一直平坦;几步之外的依赖都被漏掉。原因:遗忘门偏置留在了 0,所以每个门的初始值接近 \sigma(0) = 0.5,记忆每一步减半(第 5 节)。修复:把遗忘门偏置设为 1 或更大。在 PyTorch 中,各个门按 i、f、g、o 的顺序堆叠,所以遗忘门的切片是 [H:2*H],而且 bias_ih 和 bias_hh 是相加的。
短序列失败,或结果随 batch 的组成而变化
症状:测试时短序列的得分比长序列差,或者同一个输入在不同的 batch 中给出不同的输出。原因:填充时没有使用掩码或打包:损失在填充上计算,双向编码器在读到真实 token 之前先读了填充。实验 4 可选的第 7 步中未打包的编码器,在像训练时那样填充的长度 4 字符串上得分 100%,在截到真实宽度的同样字符串上得分 0%。修复:对损失加掩码,打包序列,并在每条序列真实的最后一步取状态(第 7 节)。
验证得分取决于 batch 的顺序
症状:重新排列验证 batch 会改变得分。原因:状态在互不相关的序列之间传递,或者在评估之前没有重置。修复:在相互独立的序列之间重置状态;只在同一数据流的各个分块之间传递状态(并将其 detach),并让每个数据流始终位于 batch 的同一行。
双向预测器得到好得不可能的结果
症状:预测在评估中看上去近乎完美。原因:后向方向读到了未来(第 6 节)。修复:凡是在线应用都使用因果模型。直接检验因果性:扰动预测时刻之后的输入,确认预测不变。
生成的序列在几个 token 之后就漂移或重复
症状:输出在开头几个 token 还很流畅,随后跑偏或陷入循环。原因:暴露偏差:模型只用教师强制训练过,从未见过自己的错误(第 10 节)。修复:计划采样、部分自由运行的训练,或者序列级目标。至少要以自由运行的方式评估:在实验 4 中,长度 12 时,教师强制下的 token 准确率为 74%,自由运行下为 53%。
多步预测在几步之后发散
症状:单步误差极好,更长预测步长上的误差却很差。原因:递归策略把预测作为输入反馈回去,使它们的误差不断累积;在实验 3 中,单步表现最好的模型,即递归 LSTM,在 h = 20 时比朴素预测还差(RMSE 0.78 对 0.72)。修复:训练一个直接的多输出模型,或者在递归模型自己的展开序列上训练它,并报告误差随预测步长的变化。
束搜索返回很短或空的输出
症状:输出被截断,而且束越大输出越短。原因:对数概率之和偏爱短的假设,而更宽的搜索会找到更多这样的假设。修复:用长度的某个幂对得分做归一化(第 10 节),或者设置最小长度。
监测器漏掉偏移,对卡死的传感器也从不报警
症状:传感器偏移开始时报警一次,然后就没有动静;冻结的传感器什么也不触发。原因:以最后一个值为中心重新对齐的预测器在一步之内就适应了新的水平,而平坦的信号是完全可预测的(第 9 节)。修复:加入滚动残差检验或 CUSUM 检验、方差下限检验,以及对照独立参考的水平检查。用注入的各种类型的故障测试监测器。
监测器的误报远多于计划
症状:设计时承诺每月只有几次报警,操作人员却每天收到许多次。原因:阈值设在训练残差上,或者在残差自相关且重尾的情况下按高斯尾部概率设定。修复:把阈值设在留出的正常残差的经验分位数上,要求持续(n 次中有 k 次),并在一段很长的正常记录上报告每天的误报次数。
把注意力图当作解释
症状:一份报告声称,模型之所以作出某个决定,是因为它的注意力突出显示的那些输入。原因:注意力权重未必是忠实的解释(第 11 节)。修复:把对齐当作诊断工具,并通过干预输入、观察输出的变化来证实所声称的依赖关系。
实验 1 — 用 NumPy 从零实现字符级 RNN
目标。你用纯 NumPy 实现第 2 节的前向传播和第 3 节的随时间反向传播,用数值方法检验梯度,再用截断的随时间反向传播训练网络,让它预测一份合成维护日志的下一个字符。然后你测量它学到了什么:把它与 n 元语法基线比较,在两个温度下从它采样,并逐行对照日志的规则核查样本。网络学会了每一条局部规则,包括一个数值阈值。它没有学会唯一一条需要比反向传播所及范围更长的记忆的规则:结束标签必须重复开头标签。这一失败就是第 4 节的梯度消失在行为上的表现,实验 2 会展示 LSTM 如何修复它。数据是合成的,无需下载,本实验在笔记本电脑 CPU 上约需一分钟。只需要 NumPy 和 matplotlib。
步骤 1:一份带有一条长程规则的维护日志
语料是生成出来的,因此其中的每条规则都是已知的,事后可以逐条核查。每一行的形式为
F2 pres 4.0 bar night shift ok /F2
并遵守四条规则。单位必须与物理量相符(temp 配 C,vib 配 mm/s,pres 配 bar)。状态必须与数值相符(temp \ge 75.0、vib \ge 7.1 或 pres \ge 5.0 时为 high,否则为 ok)。状态之前可以有一条可选的备注。结束标签重复开启这一行的设备标签;它的第一个字符出现在开头标签最后一个字符之后 18 到 36 个字符处(在生成的各行上测得)。其中三条规则是局部的:单位紧挨着数值,而数值和单位位于状态之前至多 24 个字符处,所以一个能看到最近 25 个字符的模型就能遵守它们。第四条在同样的意义上不是局部的:开头标签是八个之一,结束标签是它的副本,所以只有跨越整行的记忆,才能比八选一的猜测更好地预测结束标签。
第一段代码写出生成器,打印前五行以及后面各步骤要对照检验的数字,其中包括生成器自身的熵:任何模型在这份文本上所能达到的最小损失,由生成器所做的随机抽取算出。它是本实验的下限,而真实数据从不允许你算出这个下限。什么都没学到的模型输出 V 个字符上的均匀分布,所以它的损失是 \ln V;第一个训练损失必须接近这个值(第 2 节)。最后 10% 的字符留作验证文本。
import re
import time

import matplotlib.pyplot as plt
import numpy as np

np.random.seed(0)

TAGS = ["P1", "P2", "P3", "P4", "F1", "F2", "C1", "C2"]
# quantity -> (unit, low, high, threshold at which the status becomes "high")
QUANTITIES = {
    "temp": ("C", 40.0, 90.0, 75.0),
    "vib": ("mm/s", 0.5, 9.9, 7.1),
    "pres": ("bar", 1.0, 6.0, 5.0),
}
NOTES = ["after restart", "during wash", "operator check", "night shift", "", "", ""]


def make_log(n_lines, seed):
    """Generate the maintenance log; 3 of the 7 note choices are empty."""
    rng = np.random.default_rng(seed)
    lines = []
    for _ in range(n_lines):
        tag = TAGS[rng.integers(8)]
        quantity = list(QUANTITIES)[rng.integers(3)]
        unit, low, high, threshold = QUANTITIES[quantity]
        value = round(float(rng.uniform(low, high)), 1)
        note = NOTES[rng.integers(7)]
        status = "high" if value >= threshold else "ok"
        words = [tag, quantity, f"{value:.1f}", unit] + ([note] if note else [])
        lines.append(" ".join(words + [status, "/" + tag]))
    return "\n".join(lines) + "\n"


text = make_log(1500, seed=0)
chars = sorted(set(text))
V = len(chars)
stoi = {c: i for i, c in enumerate(chars)}
data = np.array([stoi[c] for c in text])
n_val = len(data) // 10
train_data, val_data = data[:-n_val], data[-n_val:]

print("\n".join(text.split("\n")[:5]))
print(f"characters {len(text):,}   V = {V}   train/val {len(train_data):,}/{len(val_data):,}")
print(f"ln V = {np.log(V):.3f} nats: the loss of a uniform guess")
ok_share = np.mean([line.split()[-2] == "ok" for line in text.strip().split("\n")])
print(f"lines with status 'ok': {ok_share:.0%}  (accuracy of always predicting ok)")

# Entropy of the generator, in nats per line: what no model can predict. The tag, the
# quantity, the value (to one decimal) and the note are random draws; the unit, the status
# and the closing tag are determined by them.
n_values = [round((hi - lo) * 10) + 1 for _, lo, hi, _ in QUANTITIES.values()]
note_p = np.array([1 / 7] * 4 + [3 / 7])  # four notes at 1/7 each, the empty note at 3/7
entropy_line = (np.log(8) + np.log(3) + np.mean(np.log(n_values))
                - np.sum(note_p * np.log(note_p)))
chars_per_line = len(text) / 1500
print(f"entropy of the generator: {entropy_line:.2f} nats per line, "
      f"{entropy_line / chars_per_line:.3f} per character")
print(f"if the closing tag is also a 1-in-8 guess: "
      f"{(entropy_line + np.log(8)) / chars_per_line:.3f} per character")
C1 vib 3.0 mm/s operator check ok /C1
P1 temp 80.7 C after restart high /P1
F2 pres 4.0 bar ok /F2
F2 vib 9.3 mm/s night shift high /F2
P3 pres 1.0 bar operator check ok /P3
characters 46,196   V = 37   train/val 41,577/4,619
ln V = 3.611 nats: the loss of a uniform guess
lines with status 'ok': 73%  (accuracy of always predicting ok)
entropy of the generator: 9.55 nats per line, 0.310 per character
if the closing tag is also a 1-in-8 guess: 0.378 per character
词表有 37 个字符:日志用到的字母和数字、空格、句点、斜杠和换行符。始终预测 ok 大约四行中能对三行,所以一个声称学会了状态规则的模型必须超过这个数字,而不是超过 50%。这就是模块 01 的规则:每一个数字都要带上它的基线。
步骤 2:n 元语法基线
在构建网络之前,先弄清楚廉价的方法能做到什么。字符 n 元语法模型(n-gram model)通过计数,由前 n-1 个字符预测下一个字符。单靠计数会给任何没见过的东西零概率,所以每一阶都用低一阶的模型来平滑:
其中 \text{ctx}' 是去掉最早一个字符后的上下文,p_1 是做了加 \alpha 平滑的一元分布。这是递归应用的加性平滑;\alpha = 0.1 使得在计数足够多的地方由计数说了算。验证文本上的交叉熵,以每字符奈特数(nats)计,就是网络必须超过的数字。5 元语法模型能看到四个字符的上下文。
from collections import Counter


def fit_ngram(train, order, alpha=0.1):
    """Return p(next | context) for an interpolated n-gram of the given order."""
    counts = [Counter() for _ in range(order)]  # counts[k]: (k-char context + next char)
    for k in range(order):
        for i in range(k, len(train)):
            counts[k][train[i - k : i + 1]] += 1
    context_counts = [Counter() for _ in range(order)]
    for k in range(order):
        for key, n in counts[k].items():
            context_counts[k][key[:-1]] += n
    total = sum(counts[0].values())

    def prob(context, char):
        p = (counts[0][char] + alpha) / (total + alpha * V)  # unigram, add-alpha
        for k in range(1, order):
            if len(context) < k:  # not enough context yet (start of the text)
                break
            ctx = context[len(context) - k :]
            p = (counts[k][ctx + char] + alpha * p) / (context_counts[k][ctx] + alpha)
        return p

    return prob


def ngram_loss(prob, order, val):
    """Mean cross-entropy (nats per character) on val; contexts do not cross into train."""
    total = 0.0
    for i in range(len(val)):
        context = val[max(0, i - (order - 1)) : i]
        total -= np.log(prob(context, val[i]))
    return total / len(val)


train_text = "".join(chars[i] for i in train_data)
val_text = "".join(chars[i] for i in val_data)
baseline = {}
for order in (1, 2, 3, 5):
    prob = fit_ngram(train_text, order)
    baseline[order] = ngram_loss(prob, order, val_text)
    print(f"order {order} (context {order - 1} chars): validation loss "
          f"{baseline[order]:.3f} nats/char")
order 1 (context 0 chars): validation loss 3.201 nats/char
order 2 (context 1 chars): validation loss 1.457 nats/char
order 3 (context 2 chars): validation loss 0.653 nats/char
order 5 (context 4 chars): validation loss 0.476 nats/char
损失从没有上下文时的每字符约 3.2 奈特(只比 \ln 37 = 3.61 略低),降到有四个字符上下文时的约 0.48。每多一个字符的上下文都有回报,而只有当上下文覆盖了局部规则中最长的依赖时,增益才会停止,但 n 元语法的计数表做不到这一点:25 个字符的上下文可能取值的数目远远多于日志的行数。5 元语法的损失就是网络要证明自己用到了四个字符以上的上下文所必须超过的数字。基线在训练文本上拟合、在验证文本上评分,这是诚实的划分;在训练文本上评分会奖励死记硬背。
步骤 3:参数
网络就是第 2 节的普通递推,其中独热输入实现为按列查表:
代码按每个矩阵连接的对象为它命名:W_xh 是正文中的 \mathbf{W}_x,W_hh 是 \mathbf{W}_h,W_hy 是 \mathbf{W}_y。初始化遵循第 2 节。循环矩阵的元素取 N(0, 1/H),使其奇异值为 1 的量级,状态在一开始既不消亡也不饱和。输入和输出权重很小(N(0, 0.01^2)),所以最初的 logits 几乎为零,第一个损失接近 \ln V。当 H = 128、V = 37 时,参数量就是第 2 节示例中的 26,021。
H = 128


def init_params(hidden, vocab, rng):
    return {
        "W_xh": rng.normal(0, 0.01, (hidden, vocab)),
        "W_hh": rng.normal(0, 1 / np.sqrt(hidden), (hidden, hidden)),
        "b_h": np.zeros(hidden),
        "W_hy": rng.normal(0, 0.01, (vocab, hidden)),
        "b_y": np.zeros(vocab),
    }


params = init_params(H, V, np.random.default_rng(0))
n_params = sum(p.size for p in params.values())
print({k: v.shape for k, v in params.items()})
print(f"parameters: {n_params:,}")
{'W_xh': (128, 37), 'W_hh': (128, 128), 'b_h': (128,), 'W_hy': (37, 128), 'b_y': (37,)}
parameters: 26,021
步骤 4:前向传播与反向传播
函数接收形状为 (B, T) 的整数数组 X 和 Y:输入字符以及紧随其后的字符。状态存为形状 (H, B) 的矩阵,batch 中每个流占一列,于是一次矩阵乘法就把全部 B 个流推进一步。
前向循环就是递推。损失是 B \cdot T 个位置上 -\ln p_t(c_{t+1}) 的均值,即实际紧随其后的字符 c_{t+1} 所得到的负对数概率;softmax 在减去最大 logit 之后计算,与模块 02 一样,这样就不会有指数溢出。
反向循环就是写成代码的第 3 节,从 t = T-1 一直运行到 0,采用第 3 节的记号:\boldsymbol{\delta}_t = \partial\mathcal{L}/\partial\mathbf{h}_t 是状态处的梯度(代码中的 dh),\mathbf{g}_t = \partial\mathcal{L}/\partial\mathbf{z}_t 是预激活处的梯度(dz),\partial\mathcal{L}/\partial\mathbf{y}_t 是 logits 处的梯度(g),它们都是列向量:
参数梯度在 t 上累加:\partial\mathcal{L}/\partial\mathbf{W}_{hh} 累加 \mathbf{g}_t\mathbf{h}_{t-1}^\top,\partial\mathcal{L}/\partial\mathbf{b}_h 累加 \mathbf{g}_t,\partial\mathcal{L}/\partial\mathbf{W}_{hy} 累加 (\partial\mathcal{L}/\partial\mathbf{y}_t)\,\mathbf{h}_t^\top,而 \mathbf{W}_{xh} 中对应输入字符 x_t 的那一列累加 \mathbf{g}_t。np.add.at 处理 batch 中几个流在第 t 步恰好是同一字符的情况。起始状态 \mathbf{h}_0 是一个参数,因为训练要把它从一个块带到下一个块;梯度不会传播进它,这正是截断的含义。
def forward_backward(p, X, Y, h0, need_grad=True):
    """Mean cross-entropy over (B, T) and, if asked, its gradients (BPTT)."""
    B, T = X.shape
    hs = np.empty((T + 1, p["W_hh"].shape[0], B), dtype=p["W_hh"].dtype)
    hs[0] = h0
    for t in range(T):  # forward: the recurrence
        z = p["W_xh"][:, X[:, t]] + p["W_hh"] @ hs[t] + p["b_h"][:, None]
        hs[t + 1] = np.tanh(z)
    logits = np.einsum("vh,thb->tvb", p["W_hy"], hs[1:]) + p["b_y"][None, :, None]
    logits -= logits.max(axis=1, keepdims=True)  # stable softmax
    probs = np.exp(logits)
    probs /= probs.sum(axis=1, keepdims=True)
    rows = np.arange(B)
    loss = -np.mean([np.log(probs[t, Y[:, t], rows]) for t in range(T)])
    if not need_grad:
        return loss, None, hs[-1]

    grads = {k: np.zeros_like(v) for k, v in p.items()}
    g = probs.copy()  # dL/dlogits = (p - onehot) / (B T)
    for t in range(T):
        g[t, Y[:, t], rows] -= 1.0
    g /= B * T
    grads["W_hy"] = np.einsum("tvb,thb->vh", g, hs[1:])
    grads["b_y"] = g.sum(axis=(0, 2))
    dh_from_output = np.einsum("vh,tvb->thb", p["W_hy"], g)
    dh_next = np.zeros_like(h0)
    for t in reversed(range(T)):  # backward through time
        dh = dh_from_output[t] + dh_next
        dz = dh * (1.0 - hs[t + 1] ** 2)  # tanh'
        grads["W_hh"] += dz @ hs[t].T
        grads["b_h"] += dz.sum(axis=1)
        np.add.at(grads["W_xh"].T, X[:, t], dz.T)  # column lookup, so scatter-add
        dh_next = p["W_hh"].T @ dz  # reaches step t-1 through the Jacobian
    return loss, grads, hs[-1]


# the first loss, on one chunk of 32 streams x 32 steps at initialisation
B0, T0 = 32, 32
X0 = train_data[: B0 * T0].reshape(B0, T0)
Y0 = train_data[1 : B0 * T0 + 1].reshape(B0, T0)
loss0, _, _ = forward_backward(params, X0, Y0, np.zeros((H, B0)))
print(f"initial loss {loss0:.3f}  (ln V = {np.log(V):.3f})")
initial loss 3.611 (ln V = 3.611)
初始损失与 \ln 37 吻合:输出层一开始不携带任何信息。如果第一个损失与此相差很远,那就说明在任何训练之前已经有了 bug。不过它只检验了前向传播;反向传播需要自己的检验。
步骤 5:检验梯度
手写的反向传播在一个 float64 的微型模型上检验,与第 3 节一样:把参数的一个元素扰动 \pm\epsilon,\epsilon = 10^{-5},构造中心差分 \big(\mathcal{L}(\theta+\epsilon) - \mathcal{L}(\theta-\epsilon)\big)/2\epsilon,再通过相对误差 |a - n|/\max(|a|, |n|, 10^{-12}) 与解析梯度比较。模型取 H = 5,batch 为 2,T = 4 步。多步很重要:漏掉 \mathbf{W}_{hh}^\top\mathbf{g}_{t+1} 项的实现,在 T = 1 时能通过检验,在 T = 4 时就会失败。每个参数随机检验五个元素。
rng_check = np.random.default_rng(42)
small = init_params(5, V, rng_check)
small["W_xh"] = rng_check.normal(0, 0.5, small["W_xh"].shape)  # larger, so the test bites
small["W_hy"] = rng_check.normal(0, 0.5, small["W_hy"].shape)
Xs = rng_check.integers(0, V, (2, 4))
Ys = rng_check.integers(0, V, (2, 4))
h0s = rng_check.normal(0, 0.1, (5, 2))
_, analytic, _ = forward_backward(small, Xs, Ys, h0s)

eps, worst = 1e-5, 0.0
for name, array in small.items():
    errors = []
    for _ in range(5):
        index = tuple(rng_check.integers(0, s) for s in array.shape)
        original = array[index]
        array[index] = original + eps
        loss_plus = forward_backward(small, Xs, Ys, h0s, need_grad=False)[0]
        array[index] = original - eps
        loss_minus = forward_backward(small, Xs, Ys, h0s, need_grad=False)[0]
        array[index] = original
        numeric = (loss_plus - loss_minus) / (2 * eps)
        a = analytic[name][index]
        errors.append(abs(a - numeric) / max(abs(a), abs(numeric), 1e-12))
    worst = max(worst, max(errors))
    print(f"{name:5s} worst relative error {max(errors):.2e}")
print(f"overall worst: {worst:.2e}  (about 1e-6 is right; above 1e-4 is a bug)")
W_xh  worst relative error 0.00e+00
W_hh  worst relative error 1.64e-09
b_h   worst relative error 7.03e-10
W_hy  worst relative error 2.61e-07
b_y   worst relative error 1.03e-09
overall worst: 2.61e-07  (about 1e-6 is right; above 1e-4 is a bug)
每个参数都与有限差分吻合到百万分之几或更好。反向传播就是前向传播的梯度,可以开始训练了。
步骤 6:用截断的随时间反向传播训练
训练文本被排成 B = 32 个并行流,每个流是日志中连续的一段。每次更新处理每个流接下来的 T = 32 个字符,一个块结束时的状态就是下一个块的起始状态。状态在数值上向前传递,在梯度上被切断,这就是截断的随时间反向传播(第 3 节)。当流用完时,状态重置为零,遍历从头开始。流 i 始终待在 batch 的第 i 列,所以某一列中的状态属于在那里继续的数据(第 7 节)。
优化器是 Adam,用四行写出(模块 02),学习率为 3\times 10^{-3}。梯度按全局范数裁剪到 5:全局范数是所有参数平方和的平方根,若它超过 5,每个梯度都乘以 5/\text{norm}(第 4 节)。每 250 次更新,脚本打印该窗口内的平均训练损失、验证损失(从 \mathbf{h} = \mathbf{0} 开始对整个验证文本做一遍)、最近一次的梯度范数和已用时间,并保留验证损失最好的参数,这就是早停。
B, T = 32, 32
stream_len = (len(train_data) - 1) // B
streams_x = train_data[: B * stream_len].reshape(B, stream_len)
streams_y = train_data[1 : B * stream_len + 1].reshape(B, stream_len)
n_chunks = stream_len // T
Xv = val_data[:-1][None, :]
Yv = val_data[1:][None, :]


def val_loss(p):
    return forward_backward(p, Xv, Yv, np.zeros((H, 1)), need_grad=False)[0]


params = init_params(H, V, np.random.default_rng(0))
adam_m = {k: np.zeros_like(v) for k, v in params.items()}
adam_v = {k: np.zeros_like(v) for k, v in params.items()}
lr, beta1, beta2, adam_eps, clip, n_updates = 3e-3, 0.9, 0.999, 1e-8, 5.0, 2000

h = np.zeros((H, B))
chunk = 0
best = {"val": np.inf, "step": 0, "params": None}
history = {"step": [], "train": [], "val": []}
window, grad_norm_log = [], []
print(f"{n_chunks} chunks of {T} characters per pass over {B} streams")
for step in range(1, n_updates + 1):
    if chunk == n_chunks:  # the streams wrapped: restart them from zero state
        chunk, h = 0, np.zeros((H, B))
    sl = slice(chunk * T, (chunk + 1) * T)
    loss, grads, h = forward_backward(params, streams_x[:, sl], streams_y[:, sl], h)
    chunk += 1  # h is carried to the next chunk: a value, with no gradient attached
    norm = np.sqrt(sum((g**2).sum() for g in grads.values()))
    scale = min(1.0, clip / (norm + 1e-12))
    for k in params:  # Adam, four lines
        g = grads[k] * scale
        adam_m[k] = beta1 * adam_m[k] + (1 - beta1) * g
        adam_v[k] = beta2 * adam_v[k] + (1 - beta2) * g * g
        params[k] -= lr * (adam_m[k] / (1 - beta1**step)) / (
            np.sqrt(adam_v[k] / (1 - beta2**step)) + adam_eps)
    window.append(loss)
    grad_norm_log.append(norm)
    if step % 250 == 0:
        v = val_loss(params)
        history["step"].append(step)
        history["train"].append(np.mean(window))
        history["val"].append(v)
        if v < best["val"]:
            best = {"val": v, "step": step, "params": {k: a.copy() for k, a in params.items()}}
        print(f"update {step:4d}  train {np.mean(window):.3f}  val {v:.3f}  "
              f"grad norm {norm:.2f}")
        window = []
print(f"best validation loss {best['val']:.3f} at update {best['step']}; "
      f"5-gram {baseline[5]:.3f}")
print(f"largest gradient norm before clipping: {max(grad_norm_log):.2f}; "
      f"updates clipped: {sum(n > clip for n in grad_norm_log)}")
40 chunks of 32 characters per pass over 32 streams
update  250  train 1.154  val 0.416  grad norm 0.22
update  500  train 0.408  val 0.391  grad norm 0.20
update  750  train 0.395  val 0.391  grad norm 0.16
update 1000  train 0.388  val 0.405  grad norm 0.27
update 1250  train 0.390  val 0.393  grad norm 0.24
update 1500  train 0.383  val 0.388  grad norm 0.21
update 1750  train 0.382  val 0.390  grad norm 0.16
update 2000  train 0.378  val 0.399  grad norm 0.27
best validation loss 0.388 at update 1500; 5-gram 0.476
largest gradient norm before clipping: 1.43; updates clipped: 0
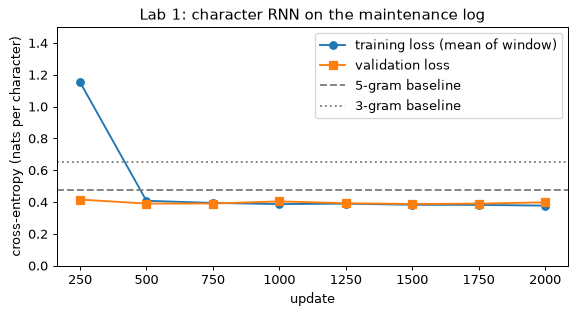
第一个窗口的平均训练损失约为 1.15,它主要由最初几十次更新决定,那时损失从 3.61 往下降;到第 500 次更新时,网络在两份文本上都达到约 0.4。此后验证损失在约 0.39 和 0.41 之间徘徊,而训练损失缓慢降到约 0.38,所以最好的检查点只是一片平坦区域中最低的那一点(具体在哪次更新,每次运行可能不同)。最好的验证损失约为每字符 0.39 奈特,明显低于 5 元语法的 0.48,所以网络用到了四个字符以外的上下文。全部 2,000 次更新中最大的梯度范数始终在 1 附近,所以阈值为 5 的裁剪从未触发:在这里它是一张安全网,而不是起作用的成分。第 7 节说要始终做裁剪,因为它没有任何代价,而它真正起作用的那一次运行,恰恰是不裁剪就会以 nan 告终的那一次。
损失有一个下限,步骤 1 已经算出了它。日志的随机性在于设备标签、物理量、数值的各位数字和备注的选择;单位、状态和结束标签都由它们决定。把各项熵相加得到每行 9.55 奈特,按每行约 31 个字符计,就是每字符 0.310 奈特:无论模型多大,在这个生成器产生的文本上都不可能得分更低。一个把每条局部规则都学对、但结束标签只能八选一去猜的模型,每行要多付 \ln 8 = 2.08 奈特,它的下限是 0.378。网络的 0.39 与这第二个下限相差不到 0.01。它几乎完美地学会了局部规则,而它的损失所剩下的部分,就是它记不住的结束标签。(这些下限是对生成器算出的;验证文本只是从中抽取的一个样本,所以两个数字只能在大约这个精度上吻合。)
fig, ax = plt.subplots(figsize=(6.5, 3.6))
ax.plot(history["step"], history["train"], "o-", label="training loss (mean of window)")
ax.plot(history["step"], history["val"], "s-", label="validation loss")
ax.axhline(baseline[5], color="grey", linestyle="--", label="5-gram baseline")
ax.axhline(baseline[3], color="grey", linestyle=":", label="3-gram baseline")
ax.set_xlabel("update")
ax.set_ylabel("cross-entropy (nats per character)")
ax.set_title("Lab 1: character RNN on the maintenance log")
ax.set_ylim(0, 1.5)
ax.legend()
plt.tight_layout()
plt.show()
步骤 7:从训练好的网络中采样
采样就是第 1 节的一对多形态。从 \mathbf{h} = \mathbf{0} 和一个换行符开始,算出 logits,除以温度 \tau,取 softmax,用设定了种子的生成器抽取一个字符,再把它反馈回去。温度的解释见第 2 节;模块 07 讨论一般的采样。\tau = 0.5 时,分布向最可能的字符锐化;\tau = 1 时,就是模型自己的分布。
def sample(p, n_chars, temperature, seed):
    rng = np.random.default_rng(seed)
    h_state = np.zeros((H, 1))
    index = stoi["\n"]
    out = []
    for _ in range(n_chars):
        z = p["W_xh"][:, [index]] + p["W_hh"] @ h_state + p["b_h"][:, None]
        h_state = np.tanh(z)
        logits = (p["W_hy"] @ h_state + p["b_y"][:, None])[:, 0] / temperature
        probs = np.exp(logits - logits.max())
        probs /= probs.sum()
        index = rng.choice(V, p=probs)
        out.append(chars[index])
    return "".join(out)


samples = {tau: sample(best["params"], 6000, tau, seed=1) for tau in (0.5, 1.0)}
for tau, generated in samples.items():
    print(f"--- temperature {tau} ---")
    print("\n".join(generated.split("\n")[1:7]))
--- temperature 0.5 ---
P4 temp 55.5 C ok /P1
P2 pres 4.0 bar after restart ok /P3
P1 pres 3.3 bar ok /P2
P2 vib 2.7 mm/s ok /P1
P1 temp 68.5 C ok /P2
P2 temp 58.9 C ok /P3
--- temperature 1.0 ---
P1 temp 58.5 C ok /C1
P4 temp 52.7 C ok /P4
P3 vib 8.4 mm/s high /F2
P2 pres 1.7 bar operator check ok /P1
C1 temp 84.8 C night shift ok /F1
C2 pres 1.9 bar night shift ok /P1
这些样本读起来像日志。单位跟着物理量走,数值是合理的数字,状态大多与数值相符(\tau = 1 时有一行,C1 temp 84.8 C night shift ok,应当是 high)。不过,看看结束标签:上面 \tau = 0.5 时的六行,每一行结束时用的标签都不是开启这一行的那个。网络学会了结束标签长什么样(一个斜杠,加上八个标签之一),却没有学会该用哪一个。计数可以定论。
步骤 8:对照规则核查样本
一个正则表达式描述了一行格式正确的日志:设备标签、物理量、一位小数的数值、单位、来自四条备注列表的可选备注、状态和结束标签。捕获各个分组,核查就可以在能解析的行上分别检验每条规则。样本的第一行和最后一行可能被截断,所以核查跳过它们。报告四个比例:格式正确的行,以及在这些行中,单位与物理量相符的、状态与数值相符的、结束标签与开头标签匹配的比例。均匀地猜测标签可以得到 1/8 = 12.5\%。
LINE = re.compile(
    r"^([PFC][1-4]) (temp|vib|pres) (\d+\.\d) (C|mm/s|bar) "
    r"(?:(?:after restart|during wash|operator check|night shift) )?"
    r"(ok|high) /([PFC][1-4])$"
)
UNIT_OF = {q: spec[0] for q, spec in QUANTITIES.items()}
THRESHOLD_OF = {q: spec[3] for q, spec in QUANTITIES.items()}


def audit(generated):
    lines = generated.split("\n")[1:-1]  # drop the possibly cut first and last lines
    parsed = [m.groups() for m in map(LINE.match, lines) if m]
    n = len(parsed)
    return {
        "lines": len(lines),
        "well-formed": n / len(lines),
        "unit agrees": sum(UNIT_OF[q] == u for _, q, _, u, _, _ in parsed) / n,
        "status agrees": sum(
            (float(v) >= THRESHOLD_OF[q]) == (s == "high")
            for _, q, v, _, s, _ in parsed) / n,
        "closing tag matches": sum(t1 == t2 for t1, _, _, _, _, t2 in parsed) / n,
    }


print(f"{'':22s}{'tau = 0.5':>10s}{'tau = 1.0':>10s}")
results = {tau: audit(g) for tau, g in samples.items()}
for key in ["lines", "well-formed", "unit agrees", "status agrees", "closing tag matches"]:
    row = [results[tau][key] for tau in (0.5, 1.0)]
    if key == "lines":
        print(f"{key:22s}{row[0]:10d}{row[1]:10d}")
    else:
        print(f"{key:22s}{row[0]:10.1%}{row[1]:10.1%}")
print("always-ok baseline for the status: about 73%;  guessing the tag: 12.5%")
                       tau = 0.5 tau = 1.0
lines                        225       193
well-formed               100.0%     95.3%
unit agrees               100.0%    100.0%
status agrees              99.1%     95.7%
closing tag matches        20.9%     12.0%
always-ok baseline for the status: about 73%;  guessing the tag: 12.5%
关于这张表还有一点:结束标签的比例在 \tau = 0.5 时由约 225 行算出,在 \tau = 1 时由 193 行算出,所以它带有约 3 个百分点的抽样误差。换一个种子重新运行 sample,就能看到它的变动。
你应该看到什么
- 第一个损失是 \ln 37 = 3.611。输出层一开始不携带信息,这是应该的。
- 梯度检验通过。在抽查的 25 个元素中,最坏的相对误差在 10^{-7} 的量级或更低。任何高于 10^{-4} 的值都意味着 bug。
- 网络胜过 5 元语法。它最好的验证损失约为每字符 0.39 奈特,而 5 元语法为 0.48,所以它用到了长于四个字符的上下文。它比“局部规则全对、结束标签靠猜”的模型的下限 0.378 高约 0.01,比还能记住标签的模型的下限 0.310 高约 0.08。梯度范数始终低于 2,所以裁剪从未触发。
- 每一条局部规则都学会了。\tau = 0.5 时基本上所有行都格式正确,每个单位都与其物理量相符。状态与数值相符的比例约为 99%,而始终预测
ok只有 73%:网络仅凭下一个字符预测,就学会了一个数值阈值,而且每个物理量的阈值各不相同。 - 结束标签没有学会。\tau = 0.5 时约五分之一的行中它与开头标签匹配,\tau = 1 时约八分之一,正是猜测的 12.5%。标签必须在递推中保持 18 到 36 步,而当两个标签落在不同的 32 字符块中时,截断的反向传播从不把它们联系起来。\tau = 0.5 时的数字略高于随机水平,可能是因为最短的间隔有时落在同一个块之内,而 18 步上的梯度还没有消失。这就是第 4 节的梯度消失在行为上的表现。损失并不能清楚地显示这一点,因为缺失的记忆只占 0.39 中的每字符 0.07 奈特;核查能显示出来。
- 温度在有效性与多样性之间权衡。\tau = 1 时约 5% 的行格式错误,约 4% 的状态与数值不符;\tau = 0.5 时几乎没有这类错误,但各行重复着最可能的模式。
动手试试
- 更长的截断窗口。在步骤 6 中设
T = 64(块数随之改变),比较结束标签的准确率。现在窗口足够长,能把大多数开头标签和结束标签装在一起,梯度可以把它们联系起来。准确率会升到 21% 以上吗?如果不会,那么限制来自梯度的消失,而不是截断。然后试试H = 256。 - 用 ReLU 代替 tanh。替换前向传播中的
np.tanh和反向传播中的1 - h**2(ReLU 的导数在输入为正处为 1,其余处为 0;保存预激活,或者使用hs > 0)。关闭裁剪后训练稳定吗?把梯度范数与 tanh 网络的比较。 - 真实文本。把 3,000 到 4,000 个字符的公有领域文本作为字符串嵌入(莎士比亚的六首十四行诗约有 3,700 个字符),在它上面训练。文本这么少,网络会死记硬背:训练损失持续下降,而验证损失很早就达到最小值然后上升,步骤 2 的二元语法和三元语法基线与网络相差无几。在准备本模块时用六首十四行诗做的一次运行中,验证损失在约 250 次更新后最低,为每字符 2.46 奈特,而二元语法模型得分 2.45,插值的三元语法模型为 2.26。限制在于数据量,而不在于架构。之所以选用日志,是因为在这个数据集上,网络有东西可找。
- 梯度与滞后。在训练好的模型的一个 32 步块内,在反向循环中记录 \lVert\partial\mathcal{L}/\partial\mathbf{h}_t\rVert,并画出它随 t 的变化。与你将在实验 2 中画出的曲线比较。
实验 2 — 观察梯度消失,以及不会消失的 LSTM
目标。实验 1 的网络学不会结束标签。这里你要测量原因,以及换成门控单元后有什么变化。你按第 5 节的方程写出 LSTM 单元,并与 PyTorch 的 nn.LSTMCell 比对。你测量最后一步的梯度有多少能到达 T 步之前的输入,作为滞后的函数,对象是不同初始化下的普通循环网络和 LSTM:第 4 节的两种失败由同一个旋钮产生,而遗忘门的偏置决定了 LSTM 能触及多远。然后你复现 \partial\mathbf{c}_{100}/\partial\mathbf{c}_0 实验,把实测的梯度与第 5 节所预测的遗忘门之积相比较。最后,你用实验 1 的截断的随时间反向传播布局,在维护日志上训练一个普通 RNN 和两个 LSTM,观察结束标签的准确率。本实验使用 PyTorch,每个模型约需半分钟 CPU 时间;整个实验在四线程 CPU 上约需两分钟。无需下载。
步骤 1:按方程写出 LSTM 单元
第 5 节的单元用一个堆叠的线性映射,由输入 \mathbf{x} 和前一状态 (\mathbf{h}, \mathbf{c}) 计算四个门:
因此 \sigma(\mathbf{z}_f) 就是第 5 节的遗忘门 \mathbf{f}_t,\sigma(\mathbf{z}_i) 是输入门,\sigma(\mathbf{z}_o) 是输出门。PyTorch 把候选值那一块称为 g(即正文中的 \tilde{\mathbf{c}} = \tanh(\mathbf{z}_g)),并按 i, f, g, o 的顺序堆叠四个块;代码中的 i, f, g, o 就是这些预激活块。代码使用带 batch 维的行向量,所以方程中的 \mathbf{W}_{ih}\mathbf{x} 在代码里写成 \mathbf{x}\mathbf{W}_{ih}^\top。PyTorch 保留两个偏置向量 \mathbf{b}_{ih} 和 \mathbf{b}_{hh},尽管只有它们的和起作用;这就是参数量为 4H(d + H) + 8H 而不是 4H(d + H + 1) 的原因(第 5 节)。当 d = 8、H = 16 时,它是 4\cdot 16\cdot 24 + 128 = 1{,}664。
import time

import matplotlib.pyplot as plt
import numpy as np
import torch
import torch.nn as nn

np.random.seed(0)
torch.manual_seed(0)


def lstm_cell(x, h, c, W_ih, W_hh, b_ih, b_hh):
    """One LSTM step in PyTorch's conventions: gate order i, f, g, o."""
    z = x @ W_ih.T + b_ih + h @ W_hh.T + b_hh
    i, f, g, o = z.chunk(4, dim=1)
    c_new = torch.sigmoid(f) * c + torch.sigmoid(i) * torch.tanh(g)
    h_new = torch.sigmoid(o) * torch.tanh(c_new)
    return h_new, c_new


reference = nn.LSTMCell(8, 16)
x = torch.randn(5, 8)
h0, c0 = torch.randn(5, 16), torch.randn(5, 16)
h_mine, c_mine = lstm_cell(x, h0, c0, reference.weight_ih, reference.weight_hh,
                           reference.bias_ih, reference.bias_hh)
h_ref, c_ref = reference(x, (h0, c0))
n_params = sum(p.numel() for p in reference.parameters())
print(f"max |dh| = {(h_mine - h_ref).abs().max().item():.1e}   "
      f"max |dc| = {(c_mine - c_ref).abs().max().item():.1e}")
print(f"parameters: {n_params:,} = 4*16*(8+16) + 2*4*16 = {4 * 16 * 24 + 2 * 4 * 16:,}")
max |dh| = 3.7e-08   max |dc| = 1.2e-07
parameters: 1,664 = 4*16*(8+16) + 2*4*16 = 1,664
两者吻合到 float32 的舍入误差:第 5 节的方程就是 nn.LSTM 所计算的,门的顺序为 i, f, g, o。这个顺序在实践中很重要:遗忘门偏置位于切片 bias_ih_l0[H:2*H],切片错开一块,就会悄无声息地设置了另一个门。
步骤 2:梯度与滞后
只有当末端损失的梯度能到达 T 步之前的输入时,循环网络才能利用这个输入。为了测量这一点,取一个形状为 (B, T, d) = (32, 200, 8) 的随机输入 batch \mathbf{x},以及一个只依赖最后隐状态的标量损失 L = \sum_b \mathbf{v}\cdot\mathbf{h}_T^{(b)},其中 \mathbf{v} 是一个固定的随机向量。执行 backward 之后,\partial L/\partial\mathbf{x}_t 的范数(对 batch 和输入特征求)衡量输入 t 对 L 的影响有多大。除以它在 t = T-1 处的值,就得到滞后 T - 1 - t 处的梯度比:滞后 0 时为 1,对于记忆完美的网络则处处为 1。输入是随机的,也没有训练:这个比值是初始化和架构的性质。对输入的梯度代替了对该步状态的梯度,后者在第 3 节中写成雅可比矩阵之积;两者每步只差一个固定的矩阵,所以一起衰减。
六个模型,每个 H = 64,构建前都调用 torch.manual_seed(1):使用 PyTorch 默认初始化的 nn.RNN;\mathbf{W}_{hh} 为正交矩阵(所有奇异值为 1)的 nn.RNN;同一个正交矩阵乘以 1.5;以及遗忘门偏置分别设为 0、3 和 5 的 nn.LSTM。默认初始化从 [-1/\sqrt H, 1/\sqrt H] 上均匀抽取 \mathbf{W}_{hh},第 4 节预测其谱半径接近 1/\sqrt{3} = 0.58,最大奇异值大于 1;代码把两者都打印出来。
B, T, d, H = 32, 200, 8, 64
torch.manual_seed(1)
inputs = torch.randn(B, T, d)
readout = torch.randn(H)  # the fixed vector v of the loss


def make_rnn(kind):
    torch.manual_seed(1)
    if kind.startswith("rnn"):
        model = nn.RNN(d, H, batch_first=True)
        with torch.no_grad():
            if kind != "rnn default":
                nn.init.orthogonal_(model.weight_hh_l0)
            if kind == "rnn orthogonal x1.5":
                model.weight_hh_l0.mul_(1.5)
        return model
    forget_bias = float(kind.split("b=")[1])
    model = nn.LSTM(d, H, batch_first=True)
    with torch.no_grad():
        model.bias_ih_l0[H : 2 * H] = forget_bias  # the forget-gate slice, order i f g o
        model.bias_hh_l0[H : 2 * H] = 0.0
    return model


def gradient_ratio(model):
    """||dL/dx_t|| / ||dL/dx_(T-1)|| for t = T-1 down to 0, i.e. indexed by lag."""
    x = inputs.clone().requires_grad_(True)
    out, _ = model(x)
    (out[:, -1, :] @ readout).sum().backward()
    norms = torch.linalg.vector_norm(x.grad.double(), dim=(0, 2))  # float64: squares of 1e-25 survive
    return (norms / norms[-1]).flip(0).numpy()


default_rnn = make_rnn("rnn default")
W = default_rnn.weight_hh_l0.detach()
radius = torch.linalg.eigvals(W).abs().max().item()
sigma_max = torch.linalg.matrix_norm(W, ord=2).item()
print(f"default W_hh: spectral radius {radius:.2f}, largest singular value {sigma_max:.2f}")

kinds = ["rnn default", "rnn orthogonal", "rnn orthogonal x1.5",
         "lstm b=0", "lstm b=3", "lstm b=5"]
ratios = {kind: gradient_ratio(make_rnn(kind)) for kind in kinds}
lags = [1, 10, 25, 50, 100, 199]
print(f"{'':22s}" + "".join(f"lag {lag:<8d}" for lag in lags))
for kind in kinds:
    print(f"{kind:22s}" + "".join(f"{ratios[kind][lag]:<12.2e}" for lag in lags))
default W_hh: spectral radius 0.57, largest singular value 1.10
                      lag 1       lag 10      lag 25      lag 50      lag 100     lag 199
rnn default           5.23e-01    1.66e-03    1.76e-07    2.38e-14    7.83e-28    0.00e+00
rnn orthogonal        1.23e+00    2.26e-01    3.08e-02    1.50e-03    1.71e-06    3.04e-12
rnn orthogonal x1.5   1.32e+00    1.74e+00    3.38e+00    9.64e+00    1.17e+02    2.02e+04
lstm b=0              5.05e-01    6.22e-03    4.83e-06    4.24e-11    2.75e-21    6.48e-41
lstm b=3              4.36e-01    3.34e-01    3.20e-01    2.84e-01    3.36e-01    7.77e+00
lstm b=5              1.85e-01    1.41e-01    1.50e-01    1.93e-01    3.85e-01    3.41e+01
默认初始化的谱半径为 0.57,最大奇异值为 1.10,正如第 4 节对以这种方式抽取的矩阵所预测的。现在来看这张表,每行一个模型。
- 默认 RNN 到滞后 10 时损失约 600 倍,到滞后 25 时比值为 2\times 10^{-7}。从滞后 10 到滞后 50,比值在 40 步内下降到原来的 1.4\times 10^{-11},即每步乘以 0.53。这接近谱半径 0.57,而与最大奇异值 1.10 相去甚远:长期的衰减率由特征值和 tanh 的导数决定,奇异值只在最初几步起作用(第 4 节关于“非正规”矩阵的说明)。在滞后 199 处,梯度低于 float32 能表示的最小数,所以打印出来恰好为 0。
- 正交的 \mathbf{W}_{hh} 减缓了衰减(滞后 10 时约 0.2,滞后 50 时为 10^{-3}),但没有阻止它。这个矩阵的每个奇异值都是 1;剩下的损失来自 tanh 的导数,只要单元不在零附近,它就小于 1。这正是第 4 节的要点:矩阵是雅可比矩阵的一个因子,激活函数是另一个。
- 正交矩阵乘以 1.5 会爆炸:比值在滞后 10、50 和 100 处依次升到 1.7、9.6 和 117,到滞后 199 时约为 2\times 10^{4},大致每步增长 5%。第 4 节的两种失败来自同一个缩放因子。这正是梯度裁剪会起作用的情形。
- 遗忘偏置为 0 的 LSTM 像普通 RNN 一样衰减。处于 \sigma(0) = 0.5 的遗忘门每一步都把细胞路径上的梯度减半,而 0.5^{50} \approx 10^{-15}。
- 遗忘偏置为 3 或 5 的 LSTM 从滞后 10 到滞后 100 都把比值保持在约 0.14 到 0.4 之间。细胞路径是遗忘门之积,偏置为 3 或 5 时,每个门在初始化时为 0.95 或 0.99。曲线在滞后 199 处上升,到 8 和 34:遗忘门几乎始终敞开,细胞对它的整个输入历史求和,最早的输入对最后状态的影响比最近的输入还大。这是另一种不完美,而不是梯度消失:这样的网络必须学会遗忘。
第 4 节的梯度流探索器画出了同样的比较。这里的数字针对随机输入和一个种子;换别的种子会改变具体数字,但不会改变数量级。
fig, ax = plt.subplots(figsize=(7, 4))
lag_axis = np.arange(T)
styles = {"rnn default": "C0-", "rnn orthogonal": "C0--", "rnn orthogonal x1.5": "C0:",
          "lstm b=0": "C3-", "lstm b=3": "C3--", "lstm b=5": "C3:"}
for kind in kinds:
    curve = np.maximum(ratios[kind], 1e-45)  # an exact 0 (float32 underflow) is drawn at the floor
    ax.semilogy(lag_axis, curve, styles[kind], label=kind)
ax.set_xlabel("lag (steps between the input and the loss)")
ax.set_ylabel("gradient ratio, relative to lag 0")
ax.set_title("Lab 2: gradient against lag at initialisation (random inputs)")
ax.set_ylim(1e-46, 1e6)
ax.legend(fontsize=8, ncol=2)
plt.tight_layout()
plt.show()
步骤 3:细胞状态的梯度
第 5 节论证说,沿着 LSTM 的细胞路径,梯度每一步都乘以遗忘门:\partial\mathbf{c}_t/\partial\mathbf{c}_{t-1} = \operatorname{diag}(\mathbf{f}_t),再加上经过 \mathbf{h}_{t-1} 的项。如果第二类项很小,\mathbf{c}_{100} 对 \mathbf{c}_0 的梯度就应当接近 100 个遗忘门之积,当每个门都处在其偏置附近时约为 \sigma(b_f)^{100}。检验方法:一个 nn.LSTMCell(8, 64),所有权重乘以 0.1(于是无论输入如何,各门都接近 \sigma(b_f)),遗忘偏置 b_f \in \{0, 2, 5, 10\},在随机输入上运行 100 步,从 \mathbf{c}_{100} 之和做反向传播,然后把对 \mathbf{c}_0 的梯度的均方根元素 \lVert\partial\mathbf{c}_{100}/\partial\mathbf{c}_0\rVert/\sqrt H 与 \sigma(b_f)^{100} 并列。作为对照,在默认的 nn.RNNCell 上做同样的测量,它的状态梯度就是第 4 节的雅可比矩阵之积。
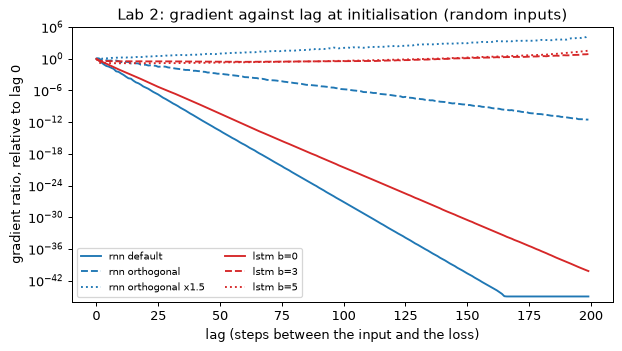
def lstm_c0_gradient(forget_bias, steps=100):
    torch.manual_seed(2)
    cell = nn.LSTMCell(8, 64)
    with torch.no_grad():
        for p in cell.parameters():
            p.mul_(0.1)
        cell.bias_ih[64:128] = forget_bias
        cell.bias_hh[64:128] = 0.0
    h = torch.zeros(1, 64)
    c = torch.zeros(1, 64, requires_grad=True)
    c_start = c
    for _ in range(steps):
        h, c = cell(torch.randn(1, 8), (h, c))
    c.sum().backward()
    return c_start.grad.double().norm().item() / np.sqrt(64)


print("LSTM cell, weights x 0.1:       ||dc_100/dc_0|| / sqrt(H)   sigmoid(b_f)^100")
for b_f in (0, 2, 5, 10):
    measured = lstm_c0_gradient(b_f)
    predicted = (1 / (1 + np.exp(-b_f))) ** 100
    print(f"  forget bias {b_f:2d}                {measured:20.2e}   {predicted:16.2e}")

torch.manual_seed(2)
rnn_cell = nn.RNNCell(8, 64)
h = torch.zeros(1, 64, requires_grad=True)
h_start = h
for _ in range(100):
    h = rnn_cell(torch.randn(1, 8), h)
h.sum().backward()
print(f"default RNNCell:                ||dh_100/dh_0|| / sqrt(H) = "
      f"{h_start.grad.double().norm().item() / np.sqrt(64):.2e}")
LSTM cell, weights x 0.1:       ||dc_100/dc_0|| / sqrt(H)   sigmoid(b_f)^100
  forget bias  0                            5.58e-30           7.89e-31
  forget bias  2                            6.62e-06           3.07e-06
  forget bias  5                            8.99e-01           5.11e-01
  forget bias 10                            1.70e+00           9.95e-01
default RNNCell:                ||dh_100/dh_0|| / sqrt(H) = 8.13e-24
实测梯度在数量级上跟随遗忘门之积,但具体数字并不一致。偏置为 2 时是 6.6\times 10^{-6} 对 3.1\times 10^{-6};偏置为 5 时是 0.90 对 0.51;偏置为 10 时是 1.7 对 0.995。它总是大于乘积,原因有二。各门并不恰好处在 \sigma(b_f),因为它们对输入和状态有少许依赖;而经过 \mathbf{h}_{t-1} 的项会叠加到直接路径上。正是第二类项使得测量值 1.7 能够大于 1:没有任何东西让各路径之和受限于其中一条路径上的乘积。与一个偏置参数在偏置 0(\approx 10^{-30})和偏置 10(约为 1)之间造成的 30 个数量级相比,这两种效应都很小。默认的 nn.RNNCell 在同样 100 步上给出 10^{-23}。
一种有用的解读是固定门值下细胞路径的半衰期:满足 \sigma(b_f)^n = 1/2 的滞后 n 为 \ln 0.5/\ln\sigma(b_f),b_f = 1 时为 2.2 步,b_f = 3 时为 14 步,b_f = 5 时为 103 步。因此偏置为 1 本身并不能把一个值保持 30 步:训练必须调高那些存储标签的单元的遗忘门。偏置让这件事变得容易,因为它使门从一个自身梯度不小的区域开始;但记忆本身并不由偏置完成。
步骤 4:再看维护日志
现在做行为检验。为了让本实验自成一体,这里重复了实验 1 的生成器;它写出同样的 46,196 个字符。数据布局与实验 1 相同:前 90% 用于训练,排成 B = 32 个并行流;后 10% 用于验证;块长 T = 32,状态在块边界处传递并分离(detach),流回绕时重置为零。正则表达式也来自实验 1;核查被简化为唯一关心的量,即格式正确的行中结束标签与开头标签匹配的比例。
import re

TAGS = ["P1", "P2", "P3", "P4", "F1", "F2", "C1", "C2"]
QUANTITIES = {"temp": ("C", 40.0, 90.0, 75.0), "vib": ("mm/s", 0.5, 9.9, 7.1),
              "pres": ("bar", 1.0, 6.0, 5.0)}
NOTES = ["after restart", "during wash", "operator check", "night shift", "", "", ""]


def make_log(n_lines, seed):
    rng = np.random.default_rng(seed)
    lines = []
    for _ in range(n_lines):
        tag = TAGS[rng.integers(8)]
        quantity = list(QUANTITIES)[rng.integers(3)]
        unit, low, high, threshold = QUANTITIES[quantity]
        value = round(float(rng.uniform(low, high)), 1)
        note = NOTES[rng.integers(7)]
        status = "high" if value >= threshold else "ok"
        words = [tag, quantity, f"{value:.1f}", unit] + ([note] if note else [])
        lines.append(" ".join(words + [status, "/" + tag]))
    return "\n".join(lines) + "\n"


text = make_log(1500, seed=0)
chars = sorted(set(text))
V = len(chars)
stoi = {ch: i for i, ch in enumerate(chars)}
data = torch.tensor([stoi[ch] for ch in text])
n_val = len(data) // 10
train_data, val_data = data[:-n_val], data[-n_val:]

BATCH, CHUNK = 32, 32
stream_len = (len(train_data) - 1) // BATCH
streams_x = train_data[: BATCH * stream_len].reshape(BATCH, stream_len)
streams_y = train_data[1 : BATCH * stream_len + 1].reshape(BATCH, stream_len)
n_chunks = stream_len // CHUNK

LINE = re.compile(
    r"^([PFC][1-4]) (temp|vib|pres) (\d+\.\d) (C|mm/s|bar) "
    r"(?:(?:after restart|during wash|operator check|night shift) )?"
    r"(ok|high) /([PFC][1-4])$"
)
print(f"characters {len(text):,}   V = {V}   train/val {len(train_data):,}/{len(val_data):,}")
characters 46,196 V = 37 train/val 41,577/4,619
模型是 Embedding(37, 32)、一个 H = 128 个单元的循环层,以及 Linear(128, 37)。嵌入层就是实验 1 的按列查表,只是输入维度更低。三个版本只在循环层上不同:nn.RNN;遗忘偏置为 0 的 nn.LSTM;以及遗忘偏置为 1 的 nn.LSTM。PyTorch 默认的 LSTM 初始化像抽取其他所有偏置一样抽取遗忘偏置,取自 0 附近的一个小区间,所以第一个 LSTM 把它设为恰好 0,第二个设为恰好 1(第 5 节给出了取 1 的理由:记忆应当是默认行为)。代码打印有效遗忘偏置,即两个偏置切片之和,以确认这一点。
每 500 次更新,循环打印验证损失,并从 \mathbf{h} = \mathbf{0} 出发以温度 0.5 采样 4,000 个字符,像实验 1 那样测量结束标签的准确率。使用 Adam,学习率 3\times 10^{-3},全局范数裁剪阈值为 5,每个模型 2,500 次更新。
class CharModel(nn.Module):
    def __init__(self, kind, forget_bias=0.0, hidden=128):
        super().__init__()
        self.kind = kind
        self.embed = nn.Embedding(V, 32)
        self.core = (nn.RNN if kind == "rnn" else nn.LSTM)(32, hidden, batch_first=True)
        self.out = nn.Linear(hidden, V)
        if kind == "lstm":
            with torch.no_grad():
                self.core.bias_ih_l0[hidden : 2 * hidden] = forget_bias
                self.core.bias_hh_l0[hidden : 2 * hidden] = 0.0

    def forward(self, tokens, state=None):
        out, state = self.core(self.embed(tokens), state)
        return self.out(out), state


def detach(state):
    if state is None:
        return None
    return tuple(s.detach() for s in state) if isinstance(state, tuple) else state.detach()


@torch.no_grad()
def val_loss(model):
    logits, _ = model(val_data[:-1][None, :])
    return nn.functional.cross_entropy(logits[0], val_data[1:]).item()


@torch.no_grad()
def sample_text(model, n_chars, temperature, seed):
    generator = torch.Generator().manual_seed(seed)
    token, state, out = torch.tensor([[stoi["\n"]]]), None, []
    for _ in range(n_chars):
        logits, state = model(token, state)
        probs = torch.softmax(logits[0, -1] / temperature, dim=0)
        token = torch.multinomial(probs, 1, generator=generator)[None, :]
        out.append(chars[token.item()])
    return "".join(out)


def tag_accuracy(generated):
    lines = generated.split("\n")[1:-1]
    parsed = [m.groups() for m in map(LINE.match, lines) if m]
    return np.mean([g[0] == g[5] for g in parsed]) if parsed else float("nan")


def train_log_model(name, kind, forget_bias=0.0, n_updates=2500):
    torch.manual_seed(0)
    model = CharModel(kind, forget_bias)
    opt = torch.optim.Adam(model.parameters(), lr=3e-3)
    state, chunk, history = None, 0, []
    for step in range(1, n_updates + 1):
        if chunk == n_chunks:
            chunk, state = 0, None
        sl = slice(chunk * CHUNK, (chunk + 1) * CHUNK)
        logits, state = model(streams_x[:, sl], state)
        state = detach(state)  # truncated BPTT: the state is a value at the boundary
        chunk += 1
        loss = nn.functional.cross_entropy(logits.reshape(-1, V), streams_y[:, sl].reshape(-1))
        opt.zero_grad()
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 5.0)
        opt.step()
        if step % 500 == 0:
            acc = tag_accuracy(sample_text(model, 4000, 0.5, seed=1))
            history.append((step, val_loss(model), acc))
            print(f"{name:12s} update {step:4d}  val {history[-1][1]:.3f}  "
                  f"closing-tag accuracy {acc:5.1%}")
    return model, history


effective = CharModel("lstm", 1.0).core
print("effective forget bias at initialisation (bias_ih + bias_hh), forget slice:",
      (effective.bias_ih_l0 + effective.bias_hh_l0)[128:256].mean().item())
histories = {}
for name, kind, bias in [("RNN", "rnn", 0.0), ("LSTM b_f=0", "lstm", 0.0),
                         ("LSTM b_f=1", "lstm", 1.0)]:
    _, histories[name] = train_log_model(name, kind, bias)
effective forget bias at initialisation (bias_ih + bias_hh), forget slice: 1.0
RNN          update  500  val 0.400  closing-tag accuracy 24.7%
RNN          update 1000  val 0.399  closing-tag accuracy 15.0%
RNN          update 1500  val 0.390  closing-tag accuracy 19.9%
RNN          update 2000  val 0.406  closing-tag accuracy 14.1%
RNN          update 2500  val 0.415  closing-tag accuracy 15.0%
LSTM b_f=0   update  500  val 0.384  closing-tag accuracy 10.9%
LSTM b_f=0   update 1000  val 0.396  closing-tag accuracy 12.2%
LSTM b_f=0   update 1500  val 0.383  closing-tag accuracy 21.8%
LSTM b_f=0   update 2000  val 0.374  closing-tag accuracy 64.6%
LSTM b_f=0   update 2500  val 0.379  closing-tag accuracy 77.5%
LSTM b_f=1   update  500  val 0.387  closing-tag accuracy 10.2%
LSTM b_f=1   update 1000  val 0.395  closing-tag accuracy 16.7%
LSTM b_f=1   update 1500  val 0.373  closing-tag accuracy 35.3%
LSTM b_f=1   update 2000  val 0.396  closing-tag accuracy 39.8%
LSTM b_f=1   update 2500  val 0.395  closing-tag accuracy 64.2%
有效遗忘偏置为 1,符合预期。每条曲线都只是一次运行,结束标签准确率是一个有噪声的测量:4,000 个字符约合 130 行,所以一个百分比的标准误约为 3 到 4 个百分点。要读的是规律,而不是单个数值。
- 普通 RNN 在整个运行中都停留在 14% 到 25%,与实验 1 的水平相当,更新次数再多也一样。它的验证损失约为 0.39 到 0.42,在第 500 次更新之后不再改善。
- 两个 LSTM 呈现相同的形态:先是在猜测水平附近的一段长平台期,然后上升。在第 2,500 次更新时,偏置为 0 的 LSTM 达到约 78%,遗忘偏置为 1 的 LSTM 约 64%。偏置为 0 时上升很突然(第 1,500 次更新时 22%,第 2,000 次时 65%),偏置为 1 时则较为平稳。之所以突然,是因为标签既需要一个存储它的单元,又需要一条读取它的输出通路:在两者都形成之前,结束标签损失的梯度很弱,而一旦其中一个开始形成,另一个就会随之出现。
- 两个 LSTM 的验证损失最好时达到 0.373 到 0.374,刚好低于实验 1 算出的“结束标签靠猜”的模型的下限 0.378,而普通 RNN 最好时为 0.390。在第 2,500 次更新时,它们分别为 0.379 和 0.395,普通 RNN 为 0.415。损失只差每字符 0.02 到 0.04 奈特,准确率却差四到五倍:损失主要由随机的数字决定,行为核查揭示了损失所掩盖的东西。
- 哪个 LSTM 领先并不稳定。在
train_log_model中改用torch.manual_seed(7)重复运行,第 2,500 次更新时偏置为 0 的 LSTM 得到 73%,偏置为 1 的 LSTM 得到 96%,与上面的顺序相反,而两者仍远高于普通 RNN 的 24%。稳健的结论是:门控单元在 2,500 次更新之内学会了标签,普通单元则没有。如步骤 3 所示,遗忘偏置在原理上有帮助,但这种规模的单次运行测不出它帮了多少。
你应该看到什么
- 手写的单元与 PyTorch 吻合到 float32 精度(差异在 10^{-7} 量级),参数量为 1{,}664 = 4\cdot 16\cdot(8 + 16) + 2\cdot 4\cdot 16。第 5 节的方程,连同门的顺序 i, f, g, o,就是
nn.LSTM所计算的。 - PyTorch 默认的 RNN 初始化是非正规的:谱半径约 0.57,最大奇异值约 1.10。它的梯度比在滞后 10 时约为 10^{-3},滞后 25 时 10^{-7},滞后 50 时 10^{-14},到滞后 199 时梯度在 float32 中下溢。
- 正交初始化有帮助,但解决不了问题。由于 tanh 的导数,比值在滞后 100 时衰减到约 10^{-6};乘以 1.5 后,它在滞后 100 时增长到约 10^{2},滞后 199 时约 10^{4}。一个旋钮就产生了第 4 节的两种失败。
- LSTM 能触及多远由遗忘偏置决定。偏置为 0 时表现得像普通 RNN;偏置为 3 或 5 时,直到滞后 100 都把比值保持在约 0.14 到 0.4 之间。门几乎始终敞开时,最早的输入会占据主导(滞后 199 处的比值远大于 1)。
- \mathbf{c}_{100} 对 \mathbf{c}_0 的梯度在数量级上跟随 \sigma(b_f)^{100},从 b_f = 0 时的约 10^{-30} 到 b_f = 10 时的约 1,与乘积相差 2 到 7 倍以内。普通单元的状态梯度约为 10^{-23}。
- 在日志上,经过 2,500 次更新,普通 RNN 的结束标签准确率停留在 14% 到 25%(猜测水平为 12.5%),而两个 LSTM 达到约 64% 和 78%。每个 LSTM 都要先在猜测水平附近停留 1,000 次或更多次更新,然后才上升。验证损失只显示出很小的差距。
- 运行时间:在准备本实验的机器上(四个 CPU 线程)每个模型约 35 秒,整个实验约 105 秒,与上面所说的时间相符。
动手试试
- 换成 GRU。在
CharModel中把nn.LSTM换成nn.GRU,比较结束标签准确率和参数量。GRU 有三个门块而不是四个,所以循环部分的参数是 LSTM 的四分之三(第 6 节)。它没有单独的细胞状态,也没有需要设置的遗忘偏置;它的两个门中,哪一个扮演遗忘门的角色?(注意第 6 节中关于 z 的约定的提醒。) - 剖析训练好的模型。用训练好的日志模型重做步骤 2 的梯度剖面,输入嵌入后的日志文本而不是随机输入。训练如何改变了普通 RNN 的曲线,以及偏置为 0 的 LSTM 的曲线?
- 观察一次爆炸。关闭裁剪,在日志上训练正交矩阵乘以 1.5 的
nn.RNN,每次更新都记录损失和梯度范数。然后重新启用阈值为 5 的裁剪,加以比较。 - 扫描偏置。以遗忘偏置 b_f \in \{-2, 0, 1, 3, 5\} 运行 LSTM,每种 2,500 次更新、两个种子,画出最终检查点上的标签准确率。是否存在某个偏置,超过它之后准确率又会下降?用步骤 2 中关于最早输入占据主导的观察来推测原因。
实验 3 — 传感器数据流的预测与监测
目标。你诚实地预测一台安装在支座上的机器上的模拟传感器,然后把预测器变成监测器。诚实包括四个方面。评估采用前向滚动验证,从不打乱。每个数字都与朴素预测、季节性朴素预测和线性自回归并列。第 8 节中那段输给朴素预测的代码会被运行,它的失败会得到解释(信号漂出了网络在训练中见过的范围),并用逐窗口归一化加以修复。多步预测会被比较,递归对直接。随后,预测器的残差被送入三个检测器,四个注入的故障表明,每一类故障都需要它自己的检测器(第 9 节)。数据是合成的,无需下载。这是本模块唯一一个较大的训练实验:QUICK = False 时在四线程 CPU 上约需两分钟,QUICK = True 约需其三分之一的时间。
步骤 1:模拟机器
信号代表一台机器的位移传感器,机器所在的支座越偏转越硬:一个受迫、有阻尼的 Duffing 振子(Duffing oscillator),
其固有频率 \omega_0 = \pi rad/s(固有周期 2 s),阻尼比 \zeta = 0.05,三次刚度 k_3 = 40,周期载荷的幅值 A = 3、周期 5 s,白噪声激励的强度 \sigma_F = 3。三次项使系统成为非线性的:支座越硬,大幅值时振荡越快。神经网络预测器能利用的正是这种非线性,而线性预测器不能。振子用半隐式欧拉法积分,dt = 0.01 s(噪声在每个子步以 \sigma_F\sqrt{dt}\,\mathcal{N}(0,1) 的形式进入),每 0.1 s 采样一次,共 8,000 个样本(800 s)。测量值加上每个样本 10^{-3} 的漂移,代表传感器漂移或磨损,以及标准差为 0.05 的噪声。周期载荷的周期为 P = 50 个样本。
第一段代码设置 QUICK,写出模拟器并画出序列。QUICK = True 只训练 4 个轮次而不是 10 个,并且只使用最后两个前向滚动折。
import time

import matplotlib.pyplot as plt
import numpy as np
import torch
import torch.nn as nn

QUICK = False  # True: 4 epochs, last two folds only; about a third of the run time
EPOCHS = 4 if QUICK else 10
np.random.seed(0)
torch.manual_seed(0)
torch.set_num_threads(4)

N, SUB, DT, P, W = 8000, 10, 0.01, 50, 64  # samples, substeps per sample, step, period, window
ZETA, OMEGA0, K3, LOAD, SIGMA_F = 0.05, np.pi, 40.0, 3.0, 3.0
DRIFT, MEAS_NOISE = 1e-3, 0.05


def simulate(seed=0, force_scale=None):
    """Duffing oscillator sampled every 0.1 s; force_scale multiplies the noise per substep."""
    rng = np.random.default_rng(seed)
    force_noise = rng.standard_normal(N * SUB)
    meas_noise = rng.standard_normal(N)
    scale = np.ones(N * SUB) if force_scale is None else force_scale
    x, v, out = 0.0, 0.0, np.empty(N)
    for k in range(N * SUB):
        acc = (-2 * ZETA * OMEGA0 * v - OMEGA0**2 * x - K3 * x**3
               + LOAD * np.sin(2 * np.pi * k * DT / 5.0))
        v += DT * acc + SIGMA_F * scale[k] * np.sqrt(DT) * force_noise[k]
        x += DT * v
        if (k + 1) % SUB == 0:
            out[(k + 1) // SUB - 1] = x
    return out + DRIFT * np.arange(N) + MEAS_NOISE * meas_noise


series = simulate(seed=0)
print(f"{N} samples, range {series.min():.2f} .. {series.max():.2f}, "
      f"standard deviation {series.std():.2f}")
print(f"first 1000 samples: mean {series[:1000].mean():.2f}; "
      f"last 1000: mean {series[-1000:].mean():.2f}")

fig, axes = plt.subplots(2, 1, figsize=(8, 5))
axes[0].plot(series, lw=0.5)
axes[0].set_title("Lab 3: simulated mount displacement (8,000 samples)")
axes[0].set_xlabel("sample (0.1 s)")
axes[0].set_ylabel("displacement")
axes[1].plot(np.arange(300), series[:300], lw=1)
axes[1].set_title("First 300 samples")
axes[1].set_xlabel("sample (0.1 s)")
axes[1].set_ylabel("displacement")
plt.tight_layout()
plt.show()
8000 samples, range -1.00 .. 9.49, standard deviation 2.38
first 1000 samples: mean 0.49; last 1000: mean 7.48
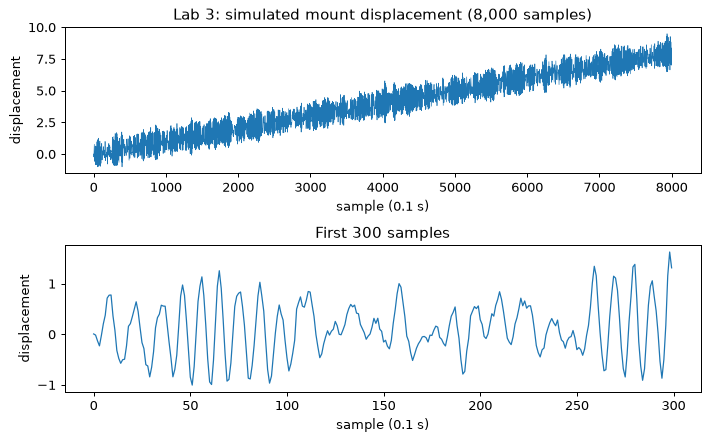
序列从前 1,000 个样本上约 0.5 的均值,升到最后 1,000 个样本上约 7.5:每个样本 10^{-3} 的漂移在 7,000 个样本上累计 7 个单位,所以序列 2.4 的标准差大部分来自漂移,振荡叠加在漂移之上。在放大图中,振荡的周期约为 11 个样本(1.1 s),大约是线性振子 2 s 固有周期的一半:在这里达到的幅值下,变硬的弹簧提高了频率;而由于随机激励不断改变幅值和相位,响应远不是一条干净的正弦曲线。(50 个样本周期的载荷只是信号中次要的一部分;接下来的步骤会展示这对季节性朴素基线意味着什么。)漂移的水平正是让第 8 节的代码失效的那个性质。
步骤 2:第 8 节的错误,照原样运行
第 8 节给出了一个看起来很仔细的预测器和划分。它使用 W = 64 个样本的窗口和单步目标,一个隐藏大小为 32 的两层 nn.LSTM,层间随机失活 0.1,最后状态上接一个线性头部。训练使用 AdamW,学习率 3\times 10^{-3},裁剪阈值 1,batch 为 128,10 个轮次(第 8 节的运行用了 15 个)。数据只用训练期的统计量做 z 分数标准化(没有泄漏),测试期就是未来:这里前 6,000 个样本用于训练,最后 2,000 个用于测试。下面的代码块恰好照此执行。它打印网络在训练和测试中看到的输入的归一化范围,然后打印 LSTM 以序列原始单位计的 RMSE、朴素预测(“下一个值等于上一个值”)的 RMSE,以及 LSTM 的平均误差。
class Forecaster(nn.Module):
    def __init__(self, hidden=32, outputs=1, per_window=False):
        super().__init__()
        self.per_window = per_window
        self.lstm = nn.LSTM(1, hidden, num_layers=2, batch_first=True, dropout=0.1)
        self.head = nn.Linear(hidden, outputs)

    def forward(self, x):  # x: (batch, W, 1), already z-scored
        if self.per_window:  # the fix: predict the change from the window's last value
            last = x[:, -1:, :]
            out, _ = self.lstm(x - last)
            return self.head(out[:, -1]) + last[:, 0]
        out, _ = self.lstm(x)
        return self.head(out[:, -1])


def windows(z, first_target, last_target, horizon=1):
    """Windows z[t-W:t] with targets z[t:t+horizon] for t in [first_target, last_target]."""
    ts = np.arange(first_target, last_target + 1)
    X = np.stack([z[t - W : t] for t in ts])
    Y = np.stack([z[t : t + horizon] for t in ts])
    return (torch.tensor(X, dtype=torch.float32).unsqueeze(-1),
            torch.tensor(Y, dtype=torch.float32))


def fit(model, X, Y, epochs=EPOCHS, seed=0):
    torch.manual_seed(seed)
    opt = torch.optim.AdamW(model.parameters(), lr=3e-3)
    model.train()
    for _ in range(epochs):
        perm = torch.randperm(len(X))
        for i in range(0, len(X), 128):
            idx = perm[i : i + 128]
            loss = nn.functional.mse_loss(model(X[idx]), Y[idx])
            opt.zero_grad()
            loss.backward()
            nn.utils.clip_grad_norm_(model.parameters(), 1.0)
            opt.step()
    model.eval()
    return model


@torch.no_grad()
def predict(model, X):
    return model(X).numpy()


def rmse(a, b):
    return float(np.sqrt(np.mean((np.asarray(a) - np.asarray(b)) ** 2)))


# Step 2: Section 8's split and its global z-scoring
ORIGIN = 6000
mu, sd = series[:ORIGIN].mean(), series[:ORIGIN].std()
z = (series - mu) / sd
X_tr, Y_tr = windows(z, W, ORIGIN - 1)  # targets inside the training period
X_te, Y_te = windows(z, ORIGIN + W, N - 1)  # test windows lie wholly in the test period
print(f"normalised inputs, training: {X_tr.min():.2f} .. {X_tr.max():.2f}   "
      f"test: {X_te.min():.2f} .. {X_te.max():.2f}")

global_model = fit(Forecaster(), X_tr, Y_tr)
pred = predict(global_model, X_te)
last_value = X_te[:, -1, 0].numpy()[:, None]
print(f"parameters {sum(p.numel() for p in global_model.parameters()):,}")
print(f"LSTM  RMSE {rmse(pred, Y_te.numpy()) * sd:.3f}   "
      f"naive RMSE {rmse(last_value, Y_te.numpy()) * sd:.3f}   "
      f"LSTM mean error {np.mean(pred - Y_te.numpy()) * sd:+.3f}")
normalised inputs, training: -2.18 .. 2.32   test: 1.02 .. 3.55
parameters 12,961
LSTM  RMSE 0.427   naive RMSE 0.361   LSTM mean error -0.317
经训练统计量归一化之后,测试窗口位于 1.02 到 3.55 之间,而网络是在 -2.18 到 2.32 之间的输入上训练的。测试期几乎全部高于网络见过的范围:漂移把水平带出了这个范围。LSTM 的 RMSE 约为 0.43,比朴素预测的 0.36 还差,平均误差为 -0.3:它系统性地预测得偏低,这正是网络的饱和单元无法表示超出训练范围的水平时的表现。模型在它见过的范围上学到了一个映射,却不会像线性模型那样把它外推出去。在准备本实验时,第二个种子(开头处 torch.manual_seed(1),fit 中 seed=1)给出 0.66,对照同样的朴素 0.36,平均误差为 -0.59,所以失败的大小随种子变化,而它的符号不变。
这就是第 8 节的失败,在一个非线性信号上复现出来。代码在通常意义上没有任何错误:没有泄漏,基线是诚实的,划分尊重时间顺序。错的是模型对这个信号的适用性。一行检查就能在任何训练之前暴露它:把测试输入的范围打印在训练输入的范围旁边。
步骤 3:三行代码的修复
用每个窗口自己的最后一个值对它做归一化。网络看到的是最近 64 个样本的形状,而不是它们的水平;它预测相对最后一个值的变化,再把最后一个值加回去。在 forward 中,这就是上面那个类的 per_window 分支:
last = x[:, -1:, :]                    # each window's last value, (batch, 1, 1)
out, _ = self.lstm(x - last)           # the network sees shape, not level
return self.head(out[:, -1]) + last[:, 0]
模型、数据和训练在其他方面都相同。训练它,并在前 150 个测试样本上比较两者。
fixed_model = fit(Forecaster(per_window=True), X_tr, Y_tr)
pred_fixed = predict(fixed_model, X_te)
print(f"fixed LSTM RMSE {rmse(pred_fixed, Y_te.numpy()) * sd:.3f}   "
      f"mean error {np.mean(pred_fixed - Y_te.numpy()) * sd:+.3f}")

fig, ax = plt.subplots(figsize=(8, 3.6))
span = slice(0, 150)
steps = np.arange(ORIGIN + W, ORIGIN + W + 150)
ax.plot(steps, Y_te.numpy()[span, 0] * sd + mu, "k", lw=1.5, label="measured")
ax.plot(steps, pred[span, 0] * sd + mu, "C3--", lw=1, label="LSTM, global z-score")
ax.plot(steps, pred_fixed[span, 0] * sd + mu, "C0-", lw=1, label="fixed LSTM (per window)")
ax.set_xlabel("sample")
ax.set_ylabel("displacement")
ax.set_title("Lab 3: one-step forecasts on the first test samples")
ax.legend(fontsize=8)
plt.tight_layout()
plt.show()
fixed LSTM RMSE 0.132 mean error +0.024
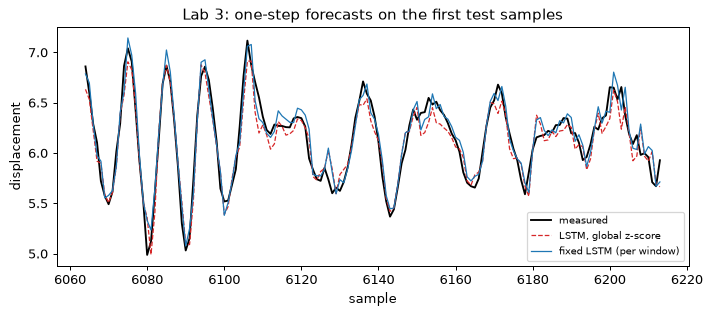
修复后模型的 RMSE 约为 0.13,平均误差接近零,是朴素误差的三分之一,也约是全局归一化模型的三分之一。图中显示了原因:全局归一化模型的预测(虚线)在峰值处略低于测量值,这就是平均误差所报告的偏差,而修复后的模型既跟上了水平,也跟上了形状。这三行改变了网络被要求学习的东西:从“给定最近 64 个水平,预测下一个水平”,变为“给定最近 64 个值的形状,预测下一个变化”。振荡的形状在任何水平上都相同,所以范围问题消失了。
对序列做差分(输入变化而不是水平)在许多场合起同样的作用,而可逆实例归一化(reversible instance normalisation)是它的推广(第 8 节)。它们都做不到的,是找回窗口中本来就不包含的信息。
步骤 4:前向滚动验证,对比三个基线
一次划分可能因为运气而抬高或压低一个模型,所以第 8 节在一系列前向滚动折上评估。取四个预测起点:4,000、5,000、6,000 和 7,000;每一折在其起点之前的全部数据上训练,在其后的 1,000 个样本上验证。z 分数标准化的统计量由每一折的训练部分重新计算。验证窗口可以回溯到训练期,因为在预测时这些值已属于过去;它的目标则永远不会。
在每一折上比较四个预测器,全部以序列的原始单位计:
- 朴素预测:最后一个值;
- 季节性朴素预测:目标之前一个周期(P = 50 个样本)的值;
- 线性自回归:在同样的 64 值窗口上做最小二乘,窗口减去最后一个值,再加一个截距(模块 01);非线性模型要证明自己的价值,就必须胜过这个基线;
- 修复后的 LSTM。
第 3 折(起点 6,000)就是步骤 3 中训练的模型;它被复用而不重新训练,所以步骤 5 和步骤 6 使用的是同一个网络。
def linear_fit(series_, origin, horizon=1):
    """Least squares on last-value-subtracted windows; returns (coef, intercept) per horizon."""
    ts = np.arange(W, origin - horizon + 1)
    Xw = np.stack([series_[t - W : t] for t in ts])
    last = Xw[:, -1:]
    design = np.hstack([Xw - last, np.ones((len(ts), 1))])
    target = np.stack([series_[t : t + horizon] for t in ts]) - last
    coef, *_ = np.linalg.lstsq(design, target, rcond=None)
    return coef


def linear_predict(coef, windows_):
    last = windows_[:, -1:]
    return last + np.hstack([windows_ - last, np.ones((len(windows_), 1))]) @ coef


origins = [6000, 7000] if QUICK else [4000, 5000, 6000, 7000]
fold_models, fold_stats, table = {}, {}, {}
for origin in origins:
    mu_f, sd_f = series[:origin].mean(), series[:origin].std()
    z_f = (series - mu_f) / sd_f
    targets = np.arange(origin, origin + 1000)
    X_val = torch.tensor(np.stack([z_f[t - W : t] for t in targets]),
                         dtype=torch.float32).unsqueeze(-1)
    y_true = series[targets]
    if origin == ORIGIN:
        model = fixed_model
    else:
        X_f, Y_f = windows(z_f, W, origin - 1)
        model = fit(Forecaster(per_window=True), X_f, Y_f)
    fold_models[origin], fold_stats[origin] = model, (mu_f, sd_f)
    raw_windows = np.stack([series[t - W : t] for t in targets])
    coef = linear_fit(series, origin)
    table[origin] = {
        "naive": rmse(raw_windows[:, -1], y_true),
        "seasonal naive": rmse(series[targets - P], y_true),
        "linear AR": rmse(linear_predict(coef, raw_windows)[:, 0], y_true),
        "LSTM": rmse(predict(model, X_val)[:, 0] * sd_f + mu_f, y_true),
    }

methods = ["naive", "seasonal naive", "linear AR", "LSTM"]
print(f"{'origin':>8s}" + "".join(f"{m:>16s}" for m in methods))
for origin in origins:
    print(f"{origin:8d}" + "".join(f"{table[origin][m]:16.3f}" for m in methods))
means = {m: np.mean([table[o][m] for o in origins]) for m in methods}
stds = {m: np.std([table[o][m] for o in origins]) for m in methods}
print(f"{'mean':>8s}" + "".join(f"{means[m]:16.3f}" for m in methods))
print(f"{'sd':>8s}" + "".join(f"{stds[m]:16.3f}" for m in methods))
gain = [1 - table[o]["LSTM"] / table[o]["linear AR"] for o in origins]
print("LSTM improvement over linear AR per fold: " + ", ".join(f"{g:.0%}" for g in gain))
  origin           naive  seasonal naive       linear AR            LSTM
    4000           0.393           0.869           0.166           0.145
    5000           0.389           0.844           0.148           0.130
    6000           0.342           0.791           0.151           0.134
    7000           0.377           0.854           0.154           0.130
    mean           0.375           0.840           0.155           0.135
      sd           0.020           0.029           0.007           0.006
LSTM improvement over linear AR per fold: 13%, 12%, 12%, 16%
每一折中的排序都相同。朴素预测的 RMSE 约为 0.375。季节性朴素预测差得多,约为 0.84,比朴素预测差两倍以上:周期 50 的载荷只是这个信号的一小部分,响应主要由随机激励和变硬的振荡决定,一个周期之前的值与现在的值几乎无关。基线必须算出来,而不能想当然;在这里,教科书上针对周期信号的选择恰恰是错的。线性自回归约为 0.155,是一个谁都不该跳过的强基线。LSTM 约为 0.135,各折之间的标准差约为 0.006,在每一折中都是最好的,在这次运行中比线性模型好 12% 到 16%(用第二个种子为 8% 到 18%)。这个优势是真实的,但不大,它就是神经网络预测器在这里所带来收益的诚实大小。
LSTM 之所以获胜,是因为弹簧是非线性的。对于带高斯噪声的线性系统,线性模型就是最优预测器(第 8 节);在由正弦波加漂移加噪声构成的信号上,它会完胜,这就是本实验使用会变硬的支座的原因。没有这种非线性,表中会显示线性模型领先或持平,而成本只是一小部分。
步骤 5:多步预测,递归还是直接
单步模型可以迭代使用,也可以训练一个模型一次预测全部 h 步(第 8 节)。从起点 6,000 开始,在 [6000, 6980] 中的每个起点 s 上预测接下来的 h = 1, \dots, 20 个样本,这样每个预测步长都在同样的 981 个预测上评分。六种方法:
- LSTM,递归:第 3 折的单步模型;把每个预测追加到窗口中,丢掉最旧的值,再次预测;
- LSTM,直接:同样的架构,配一个 20 输出的头部,在 20 步目标上训练一次;
- 线性,递归和线性,直接(用最小二乘拟合 20 个输出);
- 朴素预测和季节性朴素预测。
HMAX = 20
mu3, sd3 = fold_stats[ORIGIN]
z3 = (series - mu3) / sd3
starts = np.arange(ORIGIN, ORIGIN + 1000 - HMAX + 1)  # forecast origins s: first target at s
truth = np.stack([series[s : s + HMAX] for s in starts])  # (n, 20)
raw_start = np.stack([series[s - W : s] for s in starts])  # (n, 64), original units


@torch.no_grad()
def recursive_lstm(model, windows_z):
    window = windows_z.clone()
    steps = []
    for _ in range(HMAX):
        nxt = model(window)  # (n, 1)
        steps.append(nxt[:, 0].numpy())
        window = torch.cat([window[:, 1:, :], nxt.unsqueeze(-1)], dim=1)
    return np.stack(steps, axis=1)


def recursive_linear(coef, windows_raw):
    window, steps = windows_raw.copy(), []
    for _ in range(HMAX):
        nxt = linear_predict(coef, window)[:, 0]
        steps.append(nxt)
        window = np.hstack([window[:, 1:], nxt[:, None]])
    return np.stack(steps, axis=1)


X_start = torch.tensor(z3[np.stack([np.arange(s - W, s) for s in starts])],
                       dtype=torch.float32).unsqueeze(-1)
X_dir, Y_dir = windows(z3, W, ORIGIN - HMAX, horizon=HMAX)  # 20-step targets, all in training
direct_model = fit(Forecaster(outputs=HMAX, per_window=True), X_dir, Y_dir)
forecasts = {
    "naive": np.repeat(raw_start[:, -1:], HMAX, axis=1),
    "seasonal naive": np.stack([series[s - P : s - P + HMAX] for s in starts]),
    "linear recursive": recursive_linear(linear_fit(series, ORIGIN), raw_start),
    "linear direct": linear_predict(linear_fit(series, ORIGIN, HMAX), raw_start),
    "LSTM recursive": recursive_lstm(fold_models[ORIGIN], X_start) * sd3 + mu3,
    "LSTM direct": predict(direct_model, X_start) * sd3 + mu3,
}
rmse_by_h = {m: np.sqrt(np.mean((f - truth) ** 2, axis=0)) for m, f in forecasts.items()}
print(f"direct model trained; {len(starts)} forecast origins")
print(f"{'RMSE at h =':>18s}" + "".join(f"{h:>8d}" for h in (1, 5, 10, 20)))
for m, r in rmse_by_h.items():
    print(f"{m:>18s}" + "".join(f"{r[h - 1]:8.3f}" for h in (1, 5, 10, 20)))

fig, ax = plt.subplots(figsize=(7, 4))
for m, r in rmse_by_h.items():
    ax.plot(np.arange(1, HMAX + 1), r, marker="o", ms=3, label=m)
ax.set_xlabel("forecast horizon h (samples)")
ax.set_ylabel("RMSE")
ax.set_title("Lab 3: error against horizon, origin 6,000")
ax.legend(fontsize=8)
plt.tight_layout()
plt.show()
direct model trained; 981 forecast origins
       RMSE at h =       1       5      10      20
             naive   0.342   1.018   0.621   0.720
    seasonal naive   0.792   0.791   0.790   0.789
  linear recursive   0.151   0.400   0.526   0.551
     linear direct   0.151   0.400   0.526   0.552
    LSTM recursive   0.133   0.418   0.531   0.775
       LSTM direct   0.152   0.402   0.497   0.561
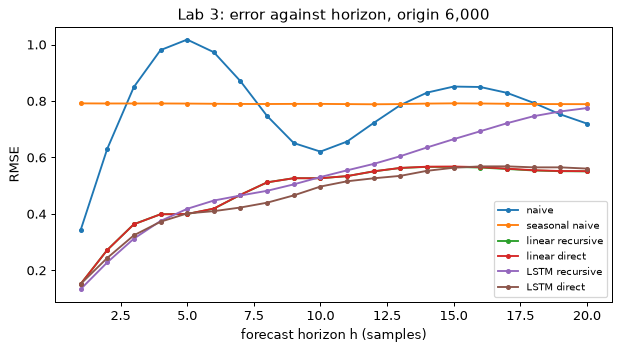
看三件事。
- 朴素预测的误差并不随 h 单调变化:在 h = 1, 5, 10, 20 处分别为 0.34、1.02、0.62 和 0.72。它跟随振荡,振荡周期约为 11 个样本:当信号转过半个周期时(这里 h 约为 5),持续性预测最差,而在接近一个完整周期时(h 约为 10 到 11)又恢复过来。季节性朴素预测平稳地保持在约 0.79,因为当 h \le P 时它的误差与 h 无关。
- 递归会累积误差。递归 LSTM 在 h = 1 时是最好的预测器(0.133),它的误差在 h = 5, 10, 20 时增长到 0.42、0.53 和 0.78,在 h = 5 时已经略逊于线性模型。它把自己的预测当作输入读入,所以把自己的误差带着向前走:这是第 8 节所说的暴露偏差在预测问题中的形式。到 h = 20 时,它比朴素预测的 0.72 还差,也远高于直接 LSTM 的 0.56。
- 对线性模型而言,两种策略是一致的。递归和直接的线性预测吻合到约三位小数(h = 20 时为 0.551 和 0.552),正如第 8 节所预测的,当窗口包含系统的全部线性状态时就会如此。直接 LSTM(0.15、0.40、0.50、0.56)在 h = 1 时比递归 LSTM 略差,因为它共享的头部还要为另外 19 个预测步长付出代价;在 h = 10 时比线性模型略好;在 h = 20 时与线性模型持平。大约在 h = 10 之后,观测窗口中没有任何东西能预测随机激励,所以直接 LSTM 和两个线性模型都趋向同一个下限,约为 0.55。
步骤 6:从预测器到监测器
第 9 节把预测器变成了监测器:较大的残差 r_t = x_t - \hat x_t 意味着传感器的行为不符合正常运行模型的预测。在模型从未见过的样本 7,000 到 7,999 中注入四个故障:
- 一个尖峰:在单个样本 7,100 上加 +1.5;
- 一个传感器偏移:在样本 7,250 到 7,349 上加 +0.8;
- 激励加倍:在样本 7,450 到 7,749 上 \sigma_F \to 2\sigma_F,代表气蚀或零件松动。它通过用同一个种子、加倍的噪声尺度重新模拟得到,所以在样本 7,450 之前,序列与干净序列完全相同,代码对此做了断言;
- 一个卡死的传感器:在样本 7,850 到 7,949 上,数值冻结在样本 7,849 的读数。
残差来自第 3 折的模型,分别在干净的留出段 6,000 到 6,999 上,以及带故障序列的 7,000 到 7,999 上计算。三个检测器,阈值只在干净的留出段上设定:
- 逐点检验,|r_t| > 4\sigma,其中 \sigma 是留出段残差的标准差;
- 残差在 50 个样本上的滚动 RMS,超过其在留出段上最大值的 1.1 倍时报警(它检测残差水平的变化);
- 20 个样本上的滚动标准差,低于其在留出段上最小值的一半时报警(它检测变化的消失)。
报警落在某个故障的 [\text{起点}, \text{终点} + 20) 之内时才计入。正常段排除每个故障之后的 70 个样本,这样仍受故障扰动的残差不会被算作误报。
FAULTS = {"spike": (7100, 7101), "offset": (7250, 7350),
          "excitation": (7450, 7750), "stuck": (7850, 7950)}

scale = np.ones(N * SUB)
scale[7450 * SUB : 7750 * SUB] = 2.0
faulty = simulate(seed=0, force_scale=scale)
assert np.array_equal(faulty[:7450], series[:7450]), "re-simulation must match before 7,450"
faulty[7100] += 1.5
faulty[7250:7350] += 0.8
faulty[7850:7950] = faulty[7849]

mu3, sd3 = fold_stats[ORIGIN]


def residuals(values, first, last):
    """One-step residuals r_t = x_t - prediction for t in [first, last)."""
    zv = (values - mu3) / sd3
    ts = np.arange(first, last)
    X_ = torch.tensor(np.stack([zv[t - W : t] for t in ts]), dtype=torch.float32).unsqueeze(-1)
    return values[ts] - (predict(fold_models[ORIGIN], X_)[:, 0] * sd3 + mu3)


res_clean = residuals(series, 6000, 7000)
res = residuals(faulty, 6000, 8000)  # index i corresponds to sample 6000 + i
sigma = res_clean.std()


def rolling(values, width, fn):
    out = np.full(len(values), np.nan)
    for i in range(width - 1, len(values)):
        out[i] = fn(values[i - width + 1 : i + 1])
    return out


rms = lambda a: np.sqrt(np.mean(a**2))
roll_rms, roll_std = rolling(res, 50, rms), rolling(res, 20, np.std)
hold = slice(0, 1000)  # the clean hold-out inside the residual array
limit_rms = 1.1 * np.nanmax(roll_rms[hold])
limit_std = 0.5 * np.nanmin(roll_std[hold])
print(f"hold-out residual sigma {sigma:.3f}; point threshold {4 * sigma:.3f}; "
      f"rolling-RMS limit {limit_rms:.3f}; rolling-std floor {limit_std:.3f}")
print(f"residual RMS on the clean hold-out {rms(res_clean):.3f}; "
      f"during the excitation fault {rms(res[1450:1750]):.3f}")

alarms = {
    "point": np.abs(res) > 4 * sigma,
    "rolling RMS": np.nan_to_num(roll_rms) > limit_rms,
    "rolling std": (~np.isnan(roll_std)) & (roll_std < limit_std),
}
alarms["point"][:1000] = alarms["rolling RMS"][:1000] = alarms["rolling std"][:1000] = False

print(f"\n{'fault':12s}" + "".join(f"{name:>22s}" for name in alarms))
for fault, (start, end) in FAULTS.items():
    cells = []
    for name, a in alarms.items():
        inside = np.flatnonzero(a[start - 6000 : end + 20 - 6000]) + start
        cells.append(f"{len(inside)} alarms, first +{inside[0] - start}" if len(inside)
                     else "none")
    print(f"{fault:12s}" + "".join(f"{c:>26s}" for c in cells))

normal = np.zeros(2000, dtype=bool)
normal[1000:] = True
for start, end in FAULTS.values():
    normal[start - 6000 : end + 70 - 6000] = False
print(f"\nnormal samples in 7,000-7,999: {normal.sum()}; false-alarm samples: " +
      ", ".join(f"{name} {int((a & normal).sum())}" for name, a in alarms.items()))

fig, axes = plt.subplots(3, 1, figsize=(9, 7), sharex=True)
xs = np.arange(6000, 8000)
for ax, (title, y) in zip(axes, [("residual (point test: dashed at 4 sigma)", res),
                                 ("rolling RMS over 50 samples", roll_rms),
                                 ("rolling std over 20 samples", roll_std)]):
    ax.plot(xs, y, lw=0.8)
    for start, end in FAULTS.values():
        ax.axvspan(start, max(end, start + 3), color="orange", alpha=0.3)
    ax.set_title(title, fontsize=9)
axes[0].axhline(4 * sigma, color="r", ls="--")
axes[0].axhline(-4 * sigma, color="r", ls="--")
axes[1].axhline(limit_rms, color="r", ls="--")
axes[2].axhline(limit_std, color="r", ls="--")
axes[2].set_xlabel("sample (faults shaded: spike, offset, excitation, stuck sensor)")
axes[0].set_ylabel("residual")
axes[1].set_ylabel("RMS")
axes[2].set_ylabel("std")
fig.suptitle("Lab 3: residual monitoring of the faulted stream")
plt.tight_layout()
plt.show()
hold-out residual sigma 0.131; point threshold 0.525; rolling-RMS limit 0.195; rolling-std floor 0.038
residual RMS on the clean hold-out 0.134; during the excitation fault 0.210

fault                        point           rolling RMS           rolling std
spike               2 alarms, first +0       21 alarms, first +0                      none
offset              3 alarms, first +0       58 alarms, first +4                      none
excitation        5 alarms, first +151     208 alarms, first +99                      none
stuck             1 alarms, first +100                      none      79 alarms, first +21

normal samples in 7,000-7,999: 239; false-alarm samples: point 0, rolling RMS 0, rolling std 0
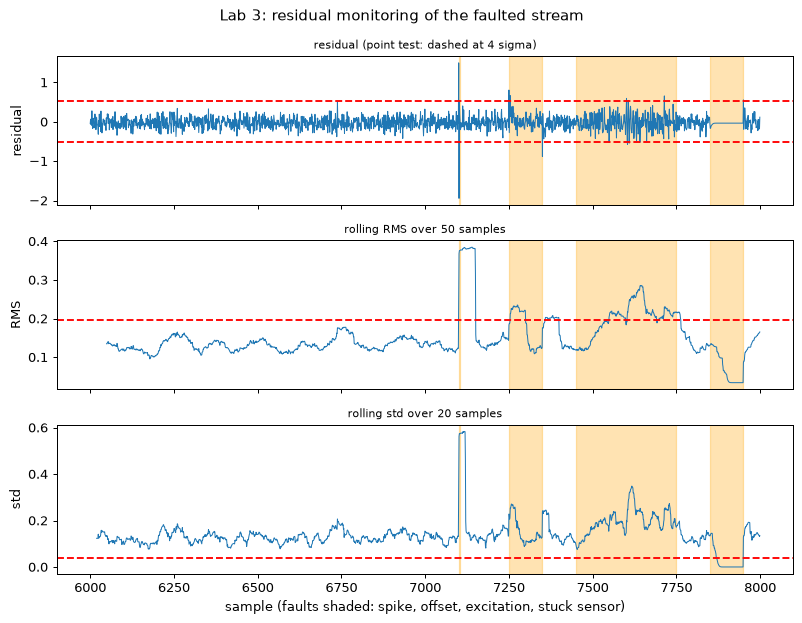
阈值只来自干净的留出段:\sigma = 0.131 给出逐点阈值 4\sigma = 0.52,两个滚动阈值分别比正常运行时的极值高 10% 和低 50%。上面带故障的残差图说明了为什么每个故障都需要它自己的检测器。
- 尖峰被逐点检验立即捕获。它触发两次报警,因为尖峰之后的那个样本是由一个以尖峰结尾的窗口预测的,误差大小大致相同、方向相反。滚动 RMS 也会报警,并且只要尖峰还在它的 50 样本窗口内,就一直高于限值;表格在报警窗口的末端截断了计数,所以完整的报警过程比显示的 21 个样本更长。
- 偏移只在开始和结束附近被逐点检验捕获(共 3 次报警:开始时、4 个样本之后,以及偏移结束的那个样本)。在这之间,残差是正常的:有了逐窗口归一化,模型在一步之内就以新的水平为中心重新对齐,所以一旦窗口被持续的偏移填满,它就看不见了(第 9 节)。滚动 RMS 也会报警,只是因为两次跳变各自停留在它的 50 样本窗口里。一个把恒定偏移视为正常的预测器,需要一个不随传感器一起移动的参照。
- 激励加倍产生的极端残差很少(这次运行中有五次逐点报警,第一次在故障开始后 151 个样本),但残差 RMS 从留出段上的 0.134 升到故障期间的约 0.21。滚动 RMS 在故障开始 99 个样本后越过其限值(第二个种子为 85,
QUICK = True时为 125)。余量很小,这就是延迟很长的原因:更小的变化需要更长时间才能检测到,或者会被漏掉。 - 卡死的传感器在卡死期间不触发任何残差报警:冻结的读数被预测时,误差很小且几乎恒定。它那一行中唯一的逐点报警位于 +100,是传感器恢复、读数从冻结值跳回来的那个样本。方差下限在 20 样本窗口被近乎恒定的残差填满后检测到故障,即开始后 21 个样本,并持续报警直到传感器恢复。
- 误报:三个检测器在 239 个正常样本中都没有报警。这个数量太小,不足以估计误报率:按“三法则”(rule of three),239 个样本中零次事件,与每个样本最高约 3/239 \approx 1.3\% 的真实误报率都是相容的。真实部署需要数天的正常数据来设定阈值并测量其误报率(第 9 节),如果你想在这里得到这个数字,就需要更长的模拟。
你应该看到什么
- 步骤 1。序列在 8,000 个样本上向上漂移约 7,上面叠加着周期约 11 个样本的振荡。
- 步骤 2:第 8 节的代码输给朴素预测。归一化后的测试输入几乎全部位于训练输入范围之上(约 1.0 到 3.6,而训练为 -2.2 到 2.3),LSTM 的 RMSE(约 0.43,朴素 0.36)比朴素预测差,并带有约 0.3 的负偏差(第二个种子为 0.66)。模型并没有训练错;它被要求做外推。
- 步骤 3:逐窗口归一化修复了它。RMSE 降到约 0.13,偏差降到约为零。
- 步骤 4:前向滚动验证。朴素约 0.375,季节性朴素约 0.84,线性约 0.155,LSTM 约 0.135,各自在各折间的离散为 0.006 到 0.03。LSTM 在每一折中都最好,比线性模型好 12% 到 16%;季节性朴素基线很差,因为随机激励压倒了周期载荷。
- 步骤 5:多步预测。误差在递归 LSTM 中累积(20 步内从 0.13 增至 0.78,在 h = 20 时比朴素预测还差);直接 LSTM 和两个线性模型最终都在 0.55 到 0.56 附近。线性的递归与直接预测相同。
- 步骤 6:监测器。逐点检验捕获尖峰和偏移的两个边缘;滚动 RMS 在 99 个样本后捕获激励故障;只有方差下限能在传感器卡死期间捕获它;在 239 个正常样本中没有误报。每一类故障都需要它自己的检测器。
- 运行时间。在准备本实验的机器上(四个 CPU 线程),
QUICK = False时约 100 秒(模拟本身远不到一秒),QUICK = True时约 35 秒,后者训练 4 个轮次且只训练最后两折;轮次更少时,步骤 2 的失败更大(0.65 对 0.36)。较慢的笔记本电脑会花更长时间。
动手试试
- 时间卷积网络。把 LSTM 换成一叠因果的一维空洞卷积,覆盖 64 个样本的窗口(模块 03;练习 15)。比较前向滚动验证的 RMSE 和训练时间。两个模型都使用步骤 3 的逐窗口归一化。
- 概率输出头部。让模型有两个输出,一个均值和一个对数方差,用
torch.nn.GaussianNLLLoss训练。在逐点检验之前,把残差除以预测的标准差。激励水平变化时,误报率会改变吗? - 第二个通道。把已知的周期载荷 \sin(2\pi t/5\,\text{s}) 作为第二个输入通道加入,比较 LSTM 相对线性模型(它也可以使用同一个通道)的领先幅度。领先会扩大吗?
- CUSUM。累加标准化后的残差平方,S_t = \max(0, S_{t-1} + r_t^2/\sigma^2 - k),参考值 k 取略大于 1(Page 1954),在某个限值处报警。在相同的误报次数下,把它在激励故障上的检测延迟与滚动 RMS 的 99 个样本相比较。
- 换一个种子。用
seed=1重新模拟并重新运行。本实验的哪些结论(四个预测器的排序、全局归一化模型的失败、检测延迟)仍然成立,数字又变动了多少?
实验 4 — 带注意力的序列到序列
目标。 你构建一个把数字串反转的 GRU 编码器-解码器,做两遍:一遍在编码器和解码器之间只传一个汇总向量(第 10 节),一遍使用 Bahdanau 的加性注意力(第 11 节)。你要测量瓶颈(序列准确率随源序列长度的变化)、教师强制下与自由运行时准确率之间的差距(暴露偏差),以及束搜索能修复什么、不能修复什么;你还要画出注意力模型在没有被告知该看哪里的情况下自己找到的对齐。一切数据都是合成的,无需下载。这个任务对人来说轻而易举,正因如此,没有注意力的模型的失败才有说服力。
步骤 1:token、batch 与 QUICK 开关
词表有 13 个 token:数字 0–9、PAD(10)、BOS(11)和 EOS(12)。源序列是一个 3 到 12 位的数字串,总是在右侧填充到 12 个位置,与训练时一致。解码器输入是 BOS 后接反转后的数字,解码器目标是反转后的数字后接 EOS;两者都填充到 13 个位置,损失会忽略 PAD。函数还返回真实长度:编码器做打包(packing)时需要它,注意力做掩码时也需要它。设 QUICK = True 时,训练从 1,500 步缩减到 400 步。
import time
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import matplotlib.pyplot as plt
from torch.nn.utils.rnn import pack_padded_sequence, pad_packed_sequence

QUICK = False                      # True: 400 training steps instead of 1,500
STEPS = 400 if QUICK else 1500
PAD, BOS, EOS, V = 10, 11, 12, 13  # digits are tokens 0-9
MAX_LEN = 12                       # longest source; the decoder emits up to 13 tokens
np.random.seed(0)
torch.manual_seed(0)

def make_batch(n, rng, minl, maxl):
    """n random digit strings; returns source, decoder input, target, true lengths."""
    lens = rng.integers(minl, maxl + 1, size=n)
    src = np.full((n, MAX_LEN), PAD, dtype=np.int64)
    dec_in = np.full((n, MAX_LEN + 1), PAD, dtype=np.int64)
    tgt = np.full((n, MAX_LEN + 1), PAD, dtype=np.int64)
    for i, L in enumerate(lens):
        digits = rng.integers(0, 10, size=L)
        src[i, :L] = digits
        dec_in[i, 0] = BOS
        dec_in[i, 1:L + 1] = digits[::-1]
        tgt[i, :L] = digits[::-1]
        tgt[i, L] = EOS
    return (torch.from_numpy(src), torch.from_numpy(dec_in),
            torch.from_numpy(tgt), torch.from_numpy(lens))

rng = np.random.default_rng(0)
src, dec_in, tgt, lens = make_batch(3, rng, 3, 12)
for i in range(3):
    print("length", int(lens[i]))
    print("  src   ", src[i].tolist())
    print("  dec_in", dec_in[i].tolist())
    print("  target", tgt[i].tolist())
length 11
  src    [2, 3, 0, 0, 0, 1, 8, 6, 9, 5, 6, 10]
  dec_in [11, 6, 5, 9, 6, 8, 1, 0, 0, 0, 3, 2, 10]
  target [6, 5, 9, 6, 8, 1, 0, 0, 0, 3, 2, 12, 10]
length 9
  src    [9, 7, 6, 5, 5, 9, 2, 8, 6, 10, 10, 10]
  dec_in [11, 6, 8, 2, 9, 5, 5, 6, 7, 9, 10, 10, 10]
  target [6, 8, 2, 9, 5, 5, 6, 7, 9, 12, 10, 10, 10]
length 8
  src    [0, 3, 8, 5, 0, 7, 7, 8, 10, 10, 10, 10]
  dec_in [11, 8, 7, 7, 0, 5, 8, 3, 0, 10, 10, 10, 10]
  target [8, 7, 7, 0, 5, 8, 3, 0, 12, 10, 10, 10, 10]
读一行来检查布局:目标是源序列的数字倒序排列,接着是 12(EOS),然后是 PAD(10)。解码器输入是目标右移一位、前面加上 BOS(11):在第 t 步,解码器看到真实的前一个 token,并且必须输出下一个。这一移位就是教师强制(teacher forcing)。
步骤 2:模型,注意力作为开关
两个实验共用一个类,这样两个模型的区别只在注意力参数上,别无其他。编码器是一个双向 nn.GRU,每个方向宽度为 H = 64。它在打包序列上运行(pack_padded_sequence,enforce_sorted=False),使反向方向从每个数字串真实的最后一位开始,而不是从填充处开始(第 7 节)。注释向量(annotation)\mathbf{h}_j 是两个方向拼接成的 128 维向量。解码器的初始状态为 \mathbf{s}_0 = \tanh(\mathbf{W}[\overrightarrow{\mathbf{h}}_S; \overleftarrow{\mathbf{h}}_1]):即真实最后位置上的前向状态与位置 0 上的反向状态,打包 GRU 的 h_n 恰好保存的就是这两个。解码器是一个 nn.GRUCell,在 Python 循环中逐步执行。
有注意力时,单元的输入是 [embedding; context],输出层读取 [s; context],与第 11 节相同。加性得分为 e_j = \mathbf{v}_a^\top\tanh(\mathbf{W}_a\mathbf{s} + \mathbf{U}_a\mathbf{h}_j);乘积 \mathbf{U}_a\mathbf{h}_j 对每个源序列只算一次,填充位置的得分设为 -10^9,使 softmax 给它们的权重恰好为零,上下文向量则是注释向量的加权和。\mathbf{W}_a、\mathbf{U}_a 和 \mathbf{v}_a 只在开启注意力时才创建。
这个类有两个方法供后面的步骤复用:encode,对每个源序列运行一次;step,让解码器前进一个 token,并同时返回注意力权重(关闭注意力时全为零)。pack 参数是为实验末尾的可选部分准备的。
class Seq2Seq(nn.Module):
    def __init__(self, attention, pack=True, emb=32, hid=64, att=64):
        super().__init__()
        self.attention, self.pack, self.hid = attention, pack, hid
        self.src_emb = nn.Embedding(V, emb)
        self.tgt_emb = nn.Embedding(V, emb)
        self.enc = nn.GRU(emb, hid, batch_first=True, bidirectional=True)
        self.init_state = nn.Linear(2 * hid, hid)
        ctx = 2 * hid if attention else 0           # context vector width
        self.cell = nn.GRUCell(emb + ctx, hid)
        self.out = nn.Linear(hid + ctx, V)
        if attention:
            self.W_a = nn.Linear(hid, att, bias=False)
            self.U_a = nn.Linear(2 * hid, att, bias=False)
            self.v_a = nn.Linear(att, 1, bias=False)

    def encode(self, src, lens):
        e = self.src_emb(src)
        if self.pack:
            packed = pack_padded_sequence(e, lens, batch_first=True, enforce_sorted=False)
            out, h_n = self.enc(packed)
            H, _ = pad_packed_sequence(out, batch_first=True, total_length=src.shape[1])
        else:
            H, h_n = self.enc(e)                    # reads the padding too
        mask = torch.arange(H.shape[1])[None, :] < lens[:, None]      # True on real digits
        s0 = torch.tanh(self.init_state(torch.cat([h_n[0], h_n[1]], dim=-1)))
        UaH = self.U_a(H) if self.attention else None   # precomputed once per source
        return H, UaH, mask, s0

    def step(self, s, y_prev, H, UaH, mask):
        """One decoder step: previous state and token -> logits, new state, weights."""
        x = self.tgt_emb(y_prev)
        if self.attention:
            scores = self.v_a(torch.tanh(self.W_a(s)[:, None, :] + UaH)).squeeze(-1)
            scores = scores.masked_fill(~mask, -1e9)          # padded positions: weight 0
            alpha = torch.softmax(scores, dim=-1)             # (batch, S)
            ctx = torch.bmm(alpha[:, None, :], H).squeeze(1)  # (batch, 2*hid)
            s = self.cell(torch.cat([x, ctx], dim=-1), s)
            logits = self.out(torch.cat([s, ctx], dim=-1))
        else:
            alpha = torch.zeros(s.shape[0], H.shape[1])
            s = self.cell(x, s)
            logits = self.out(s)
        return logits, s, alpha

    def forward(self, src, dec_in, lens):
        """Teacher forcing: the decoder reads the true previous token at every step."""
        H, UaH, mask, s = self.encode(src, lens)
        all_logits = []
        for t in range(dec_in.shape[1]):
            logits, s, _ = self.step(s, dec_in[:, t], H, UaH, mask)
            all_logits.append(logits)
        return torch.stack(all_logits, dim=1)               # (batch, 13, V)

    @torch.no_grad()
    def greedy(self, src, lens, steps=MAX_LEN + 1):
        """Free-running: the decoder reads its own previous argmax."""
        H, UaH, mask, s = self.encode(src, lens)
        y = torch.full((src.shape[0],), BOS, dtype=torch.long)
        toks, alphas = [], []
        for _ in range(steps):
            logits, s, alpha = self.step(s, y, H, UaH, mask)
            y = logits.argmax(dim=-1)
            toks.append(y)
            alphas.append(alpha)
        return torch.stack(toks, dim=1), torch.stack(alphas, dim=1)

def count(model):
    return sum(p.numel() for p in model.parameters())

print("without attention:", f"{count(Seq2Seq(False)):,}", "parameters")
print("with attention:   ", f"{count(Seq2Seq(True)):,}", "parameters")
without attention: 66,381 parameters
with attention:    104,973 parameters
注意力模型多出约 38,600 个参数。其中只有 12,352 个属于注意力网络本身(64\times64 + 128\times64 + 64);其余来自解码器单元和输出层变宽,因为两者现在都还要读取 128 维的上下文向量。手工计数是检查架构是否就是你想搭的那个的好办法:解码器 GRUCell(32, 64) 有 3\cdot64\cdot32 + 3\cdot64\cdot64 + 2\cdot3\cdot64 = 18{,}816 个参数,GRUCell(160, 64) 有 43,392 个。
步骤 3:用教师强制训练两个模型
在目标位置上计算交叉熵,忽略 PAD;Adam,学习率 3\times10^{-3};梯度范数裁剪到 1;batch 大小 64;每一步都随机生成一个长度为 3 到 12 的新 batch,因此不存在可供过拟合的有限训练集。两个模型都从 torch.manual_seed(0) 开始,看到的 batch 也相同(数据生成器的随机种子一致)。打印的损失是最后 50 步的平均值。
def train(model, steps, seed=0):
    torch.manual_seed(seed)
    data_rng = np.random.default_rng(seed)
    opt = torch.optim.Adam(model.parameters(), lr=3e-3)
    recent = []
    for step in range(1, steps + 1):
        src, dec_in, tgt, lens = make_batch(64, data_rng, 3, 12)
        logits = model(src, dec_in, lens)
        loss = F.cross_entropy(logits.reshape(-1, V), tgt.reshape(-1), ignore_index=PAD)
        opt.zero_grad()
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        opt.step()
        recent.append(loss.item())
        if step % (steps // 3) == 0:
            print(f"  step {step:4d}  loss {np.mean(recent[-50:]):.4f}")

torch.manual_seed(0)
plain = Seq2Seq(attention=False)
print("without attention")
train(plain, STEPS)
torch.manual_seed(0)
attn = Seq2Seq(attention=True)
print("with attention")
train(attn, STEPS)
without attention
  step  500  loss 0.5913
  step 1000  loss 0.4242
  step 1500  loss 0.3684
with attention
  step  500  loss 0.0149
  step 1000  loss 0.0100
  step 1500  loss 0.0002
损失是在真实目标 token 上的平均值,单位为奈特(nat)。有注意力的模型在第 500 步时已低于 0.02,基本上训练完毕。没有注意力的模型在 1,500 步之后仍在 0.37 左右:它能答对一些数字,却在串中其他位置出错,下一步会把这一点量化。
步骤 4:准确率随长度的变化,教师强制与自由运行
对每个模型、每种长度给出三个数,分别在长度为 4、8 和 12 的各 500 个新数字串上计算:
- 序列准确率:每一位数字和
EOS都正确,解码时在模型自己的输出上贪心解码(这是部署时唯一要紧的数字); - 教师强制下的 token 准确率:每一步都给定真实的前一个 token,与训练时相同;
- 自由运行时的 token 准确率:每一步都给定模型自己的前一个输出。
token 准确率统计 L+1 个真实目标位置,包括 EOS。后两者之间的差距就是暴露偏差(exposure bias)。
@torch.no_grad()
def evaluate(model, length, n=500, seed=123):
    rng = np.random.default_rng(seed + length)
    src, dec_in, tgt, lens = make_batch(n, rng, length, length)
    real = tgt != PAD                                          # the L+1 real positions
    forced = model(src, dec_in, lens).argmax(-1)
    free, _ = model.greedy(src, lens)
    tf_acc = ((forced == tgt) & real).sum().item() / real.sum().item()
    fr_acc = ((free == tgt) & real).sum().item() / real.sum().item()
    seq_acc = (((free == tgt) | ~real).all(dim=1)).float().mean().item()
    return seq_acc, tf_acc, fr_acc

results = {}
print("model         length  sequence  teacher-forced  free-running")
for name, model in [("no attention", plain), ("attention", attn)]:
    model.eval()
    for length in (4, 8, 12):
        seq_acc, tf_acc, fr_acc = evaluate(model, length)
        results[(name, length)] = seq_acc
        print(f"{name:12s} {length:6d}  {100*seq_acc:7.1f}%  {100*tf_acc:13.1f}%  {100*fr_acc:11.1f}%")
model         length  sequence  teacher-forced  free-running
no attention      4     98.4%           99.7%         99.4%
no attention      8     42.6%           91.4%         80.3%
no attention     12      1.0%           74.1%         52.7%
attention         4    100.0%          100.0%        100.0%
attention         8    100.0%          100.0%        100.0%
attention        12    100.0%          100.0%        100.0%
三点观察,每一点都是正文中的一个论断,现在你可以检验它。
- 瓶颈。 没有注意力时,序列准确率随长度急剧下降:在这次运行中,长度 4 时约为 98%,长度 8 时为 43%,长度 12 时为 1%。一个由 64 个数组成的向量必须按顺序携带最多 12 位数字,而一个用梯度下降训练了 1,500 次更新的 64 维状态做不到这一点。大部分损伤发生在串的远端:长度 8 时 token 准确率(教师强制)为 91%,长度 12 时为 74%,所以模型能答对许多位数字,却几乎从不能全部答对。
- 暴露偏差。 没有注意力时,自由运行的 token 准确率低于教师强制下的准确率,而且差距随长度扩大:长度 4 时几乎没有差距,长度 8 时相差 11 个百分点(91.4% 对 80.3%),长度 12 时相差 21 个百分点(74.1% 对 52.7%)。一位错误的数字会把解码器推入一个它在训练中从未见过的状态,之后的预测随之受损。
- 注意力消除了这两个问题。 有注意力时,两种模式下每种长度的准确率都是 100%,所以根本找不到差距:解码器能读取它需要的那位数字,引发误差累积的那些错误也就不会出现。
步骤 5:束搜索对贪心解码
更好的搜索能挽救瓶颈模型吗?下面的束搜索(beam search)遵循第 10 节:按累积对数概率保留 k = 4 个最好的部分序列,某个假设输出 EOS 时就把它放到一边,其余的继续扩展,当没有剩余假设或满 13 步时停止。它一次处理一个样本。在 200 个长度为 12 的数字串上运行它,并在同样的数字串上与贪心解码比较。
@torch.no_grad()
def beam_search(model, src, lens, k=4, steps=MAX_LEN + 1):
    """Beam search for one example (src has shape (1, S)); returns the best token list."""
    H, UaH, mask, s0 = model.encode(src, lens)
    beams = [(0.0, [], s0)]                        # (cumulative log-prob, tokens, state)
    finished = []
    for _ in range(steps):
        cands = []
        for score, toks, s in beams:
            y = torch.tensor([toks[-1] if toks else BOS])
            logits, s_new, _ = model.step(s, y, H, UaH, mask)
            logp = torch.log_softmax(logits, dim=-1)[0]
            top_lp, top_tok = logp.topk(k)
            for lp, tok in zip(top_lp.tolist(), top_tok.tolist()):
                cands.append((score + lp, toks + [tok], s_new))
        cands.sort(key=lambda c: c[0], reverse=True)
        beams = []
        for cand in cands[:k]:
            (finished if cand[1][-1] == EOS else beams).append(cand)
        if not beams:
            break
    pool = finished if finished else beams
    return max(pool, key=lambda c: c[0])[1]

rng = np.random.default_rng(7)
src, dec_in, tgt, lens = make_batch(200, rng, 12, 12)
plain.eval()
greedy_toks, _ = plain.greedy(src, lens)
greedy_ok = beam_ok = greedy_tok = beam_tok = 0
for i in range(200):
    want = tgt[i].tolist()                         # 12 reversed digits, then EOS
    g = greedy_toks[i, :13].tolist()
    b = beam_search(plain, src[i:i + 1], lens[i:i + 1])
    b = b + [PAD] * (13 - len(b))                  # a hypothesis that stopped early
    greedy_ok += g == want
    beam_ok += b == want
    greedy_tok += sum(x == y for x, y in zip(g, want))
    beam_tok += sum(x == y for x, y in zip(b, want))
print(f"greedy   {greedy_ok:3d}/200 correct strings, token accuracy {100 * greedy_tok / 2600:.1f}%")
print(f"beam k=4 {beam_ok:3d}/200 correct strings, token accuracy {100 * beam_tok / 2600:.1f}%")
greedy     0/200 correct strings, token accuracy 52.3%
beam k=4   0/200 correct strings, token accuracy 49.1%
束搜索并没有挽救这个模型:两种方法在 200 个数字串中都一个也没答对,token 准确率还从 52.3% 降到了 49.1%。(这里贪心解码给出 52.3%,而步骤 4 中自由运行为 52.7%,是因为这是另一组 200 个数字串。)搜索本身完成了它的任务。在修订本文时做的一次检查中(同一次运行,用模型自己的对数概率给每个输出打分),对全部 200 个数字串,束搜索的答案都至少与贪心的答案一样可能,而且在 12 位数字中答对的略多一些,为 49.9% 对 48.6%。token 准确率更低来自最后一个位置:束搜索在它的 EOS 处停止,代码把其余位置填充掉;它在 122 个数字串上提前一到两个 token 停止,贪心解码则是 114 个;而贪心解码总是运行满 13 步,只要它在那个位置输出 EOS,即使之前已经输出过一次,该位置也算它对。一个错误模型给出的更可能的输出,并不是更准确的输出。没有注意力的模型并不知道答案,对它的输出做任何搜索都无法提供它从未得到过的信息。当模型的分布是对的、只是贪心路径不走运时,搜索才有帮助,就像第 10 节的玩具例子那样;它无法修复一个错误的分布。
步骤 6:读出对齐
注意力权重是模型对自己看了哪里的陈述,但要附上第 11 节的那条告诫。用注意力模型解码一个 8 位数字串,把权重向量堆叠成一个 9\times8 矩阵(行:输出步,包括 EOS;列:源位置),并以数字作为刻度标签画出来。由于源序列被填充到了 12,权重被切片到 8 个真实位置;填充位置的权重按构造恰好为零,最后一行打印会确认这一点。右图画出步骤 4 的序列准确率。
attn.eval()
rng = np.random.default_rng(11)
src, dec_in, tgt, lens = make_batch(1, rng, 8, 8)
toks, alphas = attn.greedy(src, lens)
A = alphas[0, :9, :8].numpy()                      # rows: 8 digits + EOS; columns: source
digits = src[0, :8].tolist()
print("source :", digits)
print("output :", toks[0, :9].tolist(), "(12 = EOS)")
print("argmax of each row:", A.argmax(axis=1).tolist())
print("peak weights:      ", [f"{w:.2f}" for w in A.max(axis=1)])
print("weight on padding: ", f"{alphas[0, :9, 8:].sum().item():.6f}")

fig, axes = plt.subplots(1, 2, figsize=(10, 4.2))
im = axes[0].imshow(A, cmap="viridis", vmin=0, vmax=1)
axes[0].set_xticks(range(8))
axes[0].set_xticklabels(digits)
axes[0].set_yticks(range(9))
axes[0].set_yticklabels([str(t) if t != EOS else "EOS" for t in toks[0, :9].tolist()])
axes[0].set_xlabel("source digit (position left to right)")
axes[0].set_ylabel("output token (step top to bottom)")
axes[0].set_title("Attention weights for an 8-digit reversal")
fig.colorbar(im, ax=axes[0], label="weight")

width = 0.38
lengths = (4, 8, 12)
for off, name in [(-width / 2, "no attention"), (width / 2, "attention")]:
    axes[1].bar(np.arange(3) + off, [100 * results[(name, L)] for L in lengths],
                width, label=name)
axes[1].set_xticks(range(3))
axes[1].set_xticklabels([f"length {L}" for L in lengths])
axes[1].set_ylabel("sequence accuracy (%)")
axes[1].set_title("Whole-string accuracy, greedy decoding")
axes[1].legend()
plt.tight_layout()
plt.show()
source : [1, 1, 7, 4, 5, 6, 7, 0]
output : [0, 7, 6, 5, 4, 7, 1, 1, 12] (12 = EOS)
argmax of each row: [7, 6, 5, 4, 3, 2, 1, 0, 0]
peak weights:       ['0.84', '0.75', '0.66', '0.71', '0.65', '0.79', '0.63', '0.68', '0.26']
weight on padding:  0.000000
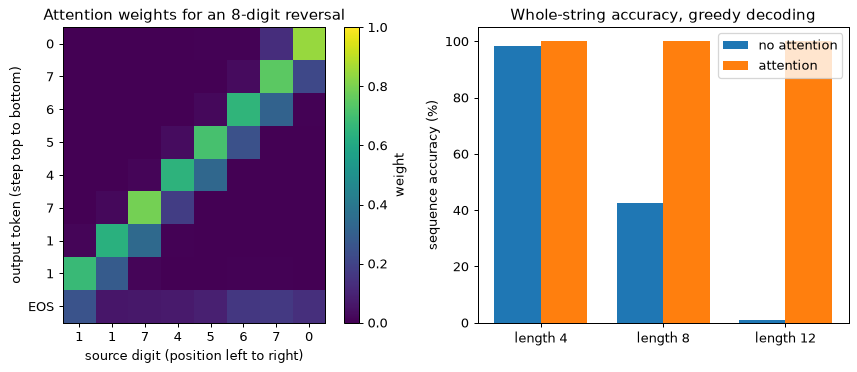
对齐是反对角线:为了输出第一位数字,解码器看源序列的最后一位,接着看它前面那一位,依此类推,输出 EOS 时看第一个位置。模型从未被告知这一点;唯一的信号是输出的交叉熵。八个数字行上的峰值权重在 0.63 到 0.84 之间;EOS 行最不确定,峰值为 0.26,落在位置 0 上,而最后一位输出数字正来自这个位置。一条明亮的反对角线,就是这个任务的正确解的样子。
步骤 7(可选):故意重现打包错误
第 7 节警告过,双向编码器在未打包的填充输入上,与在未填充输入上的表现不同。下面就是这种失败。用 pack=False 在填充后的 batch 上训练一个注意力模型(步数更少),然后用两种方式在长度为 4 的数字串上测试它:像训练时那样填充到 12,以及截到真实宽度 4。同样训练的打包模型也用相同方式测试。
def width_test(model, length, padded, n=500):
    rng = np.random.default_rng(900 + length)
    src, _, tgt, lens = make_batch(n, rng, length, length)
    if not padded:
        src = src[:, :length]                      # the real digits only, no padding
    free, _ = model.greedy(src, lens)
    real = tgt != PAD
    return (((free == tgt) | ~real).all(dim=1)).float().mean().item()

bug_steps = 400 if QUICK else 800
torch.manual_seed(0)
unpacked = Seq2Seq(attention=True, pack=False)
print("unpacked encoder")
train(unpacked, bug_steps)
torch.manual_seed(0)
packed = Seq2Seq(attention=True, pack=True)
print("packed encoder")
train(packed, bug_steps)
for name, model in [("unpacked", unpacked), ("packed", packed)]:
    model.eval()
    print(f"{name:9s} length 4: padded to 12 {100 * width_test(model, 4, True):5.1f}%"
          f"   cut to 4 {100 * width_test(model, 4, False):5.1f}%")
unpacked encoder
  step  266  loss 0.0273
  step  532  loss 0.0194
  step  798  loss 0.0105
packed encoder
  step  266  loss 0.0128
  step  532  loss 0.0083
  step  798  loss 0.0054
unpacked  length 4: padded to 12 100.0%   cut to 4   0.0%
packed    length 4: padded to 12 100.0%   cut to 4 100.0%
未打包的编码器学会了在到达第一位数字之前先读填充 token;给它一个没有这些填充的数字串,它的反向状态就是训练中从未产生过的状态,于是它失败了。打包的编码器无论周围是什么,都从真实的最后一位数字开始反向方向,所以它的答案不取决于 batch 是怎样填充的。实践中的教训是:无论用哪种方式填充,都要严格按训练时的方式测试;只要某一层是反向读取的,就要打包。
你应该看到什么
- 参数量。 没有注意力时 66,381 个,有注意力时 104,973 个;其差值中,注意力网络本身占 12,352 个。
- 训练。 注意力模型的损失在几百步内接近零;没有注意力的模型在 1,500 步之后仍远高于此。
- 瓶颈。 没有注意力时,序列准确率在长度 4 时约为 98%,长度 8 时为 43%,长度 12 时为 1%。有注意力时三者都是 100%。(这是本次运行的数字;换一个随机种子,中间那个数会变动几个百分点。)
- 暴露偏差。 没有注意力时,自由运行的 token 准确率落后于教师强制下的 token 准确率,长度 4 时落后 0.3 个百分点,长度 8 时 11 个,长度 12 时 21 个。有注意力时两者都是 100%。
- 搜索。 k = 4 的束搜索与贪心解码一样,让瓶颈模型在长度 12 时 200 个数字串中仍是 0 个正确,token 准确率从 52.3% 降到 49.1%(束搜索稍微更常提前在
EOS处停止):搜索无法提供模型不知道的东西。 - 对齐。 热图的第 t 行在源位置 7 - t 处达到峰值(
EOS在位置 0 处),数字行上的峰值权重为 0.63 到 0.84。 - 错误。 未打包的模型在像训练时那样填充的数字串上很准确,在截到真实宽度的数字串上失败;打包的模型两者都能处理。
具体数字取决于随机种子和所用的 BLAS 库,任何百分比的最后一位在你的机器上都可能不同。规律不应改变。
动手试试
- 计划采样。 在
forward中,以一个在训练过程中从 0 线性升到 0.5 的概率,输入模型自己的前一个 argmax,而不是真实 token。把没有注意力的模型的自由运行准确率与上表比较。两列中哪一列变了,差距缩小了吗? - 换一种得分。 把加性得分换成 Luong 的点积:用一个线性层把 128 维的注释向量投影到 64 维,并用 \mathbf{s}^\top\mathbf{h}_j 给每个位置打分。比较第 500、1,000 和 1,500 步的训练损失。
- 超出训练长度。 在训练中从未见过的长度 13 到 16 上测试注意力模型(源宽度和
MAX_LEN必须随之增大)。反对角线在哪里断开?模型需要知道什么才能把它延伸下去? - 非单调的对齐。 用 Python 的
datetime生成日期对('14 March 2026'到'2026-03-14'),按字符处理,并在其上训练注意力模型。对齐不再是一条反对角线,而是在三个字段之间跳转的一组块。
实验 5 — 对角线性循环对 LSTM
目标。 你按线性循环单元(Linear Recurrent Unit,LRU)的风格实现一个对角复数线性循环(第 13 节),确认它的循环形式和卷积形式计算的是同一个映射,给两者计时,然后在长滞后的回忆任务上把这个线性循环与普通 RNN 和 LSTM 比较。你会看到一个由初始化时特征值的模决定的记忆长度,以及 LSTM 的遗忘门偏置要做多少工作才能与之匹敌。一切数据都是合成的,无需下载。
步骤 1:这一层
这一层有 N = 64 个复数模态。每个模态有一个特征值 \lambda_n = \exp(-e^{\nu_n} + i e^{\vartheta_n}),其中 \nu_n 和 \vartheta_n 是实参数(代码中的 nu_log 和 theta_log),所以对参数的任何取值都有 |\lambda_n| = \exp(-e^{\nu_n}) < 1:一次梯度步不可能让循环变得不稳定。初始化时,模在圆环 [r_{\min}, r_{\max}] = [0.9, 0.999] 上均匀抽取(按 |\lambda|^2 均匀),相位在 [0, \pi/10] 中均匀抽取。对于模:若 u\sim U(0,1),则 |\lambda|^2 = u(r_{\max}^2 - r_{\min}^2) + r_{\min}^2,而由 |\lambda| = e^{-e^\nu} 可得 \nu = \ln(-\tfrac12\ln|\lambda|^2);代码正是这样做的。
batch 维记作 batch,输入矩阵记作 B_in(符号 B 在本模块其他地方表示 batch 大小),这一层计算
其中 \gamma 对每个模态做归一化,使其状态在白噪声输入下保持单位方差(第 13 节)。它有两个必须一致的前向函数。
forward_loop是循环形式,一次一步:内存恒定,是生成时使用的形式。forward是卷积形式。展开得到 h_t = \sum_{k\ge0}\lambda^k\,\gamma\mathbf{B}_\text{in}x_{t-k},所以 N 个模态中的每一个,都是其驱动 u_t = \gamma\mathbf{B}_\text{in}x_t 与卷积核 (\lambda^0, \lambda^1, \dots, \lambda^{T-1}) 的因果卷积。FFT 把这个卷积变成乘积;把两者都填充到长度 2T 可以避免循环卷积的环绕,前 T 个输出就是因果的那部分。
两个函数共用驱动 u,这样计时比较的只是混合时间维度的两种方式。
import time
import math
import numpy as np
import torch
import torch.nn as nn
import matplotlib.pyplot as plt

np.random.seed(0)
torch.manual_seed(0)

class DiagLinearRecurrence(nn.Module):
    """Diagonal complex linear recurrence (Linear Recurrent Unit style), batch-first."""
    def __init__(self, d_in, d_out, N=64, r_min=0.9, r_max=0.999, max_phase=math.pi / 10):
        super().__init__()
        u = torch.rand(N)                                     # modulus, uniform in |lambda|^2
        self.nu_log = nn.Parameter(torch.log(-0.5 * torch.log(
            u * (r_max ** 2 - r_min ** 2) + r_min ** 2)))
        self.theta_log = nn.Parameter(torch.log(max_phase * torch.rand(N)))   # phase
        self.B_re = nn.Parameter(torch.randn(N, d_in) / math.sqrt(2 * d_in))
        self.B_im = nn.Parameter(torch.randn(N, d_in) / math.sqrt(2 * d_in))
        self.C_re = nn.Parameter(torch.randn(d_out, N) / math.sqrt(N))
        self.C_im = nn.Parameter(torch.randn(d_out, N) / math.sqrt(N))
        self.D = nn.Parameter(torch.randn(d_out, d_in) / math.sqrt(d_in))

    def log_lambda(self):
        return torch.complex(-torch.exp(self.nu_log), torch.exp(self.theta_log))

    def drive(self, x):
        """u_t = gamma * (B_in x_t), shape (batch, T, N), complex."""
        lam_abs = torch.exp(-torch.exp(self.nu_log))
        gamma = torch.sqrt(1.0 - lam_abs ** 2)
        B_in = torch.complex(self.B_re, self.B_im) * gamma[:, None]
        return x.to(torch.complex64) @ B_in.T

    def readout(self, h, x):
        C = torch.complex(self.C_re, self.C_im)
        return (h @ C.T).real + x @ self.D.T

    def forward_loop(self, x):
        u, lam = self.drive(x), torch.exp(self.log_lambda())
        h = torch.zeros(u.shape[0], u.shape[2], dtype=torch.complex64)
        states = []
        for t in range(u.shape[1]):
            h = lam * h + u[:, t]                        # the recurrence
            states.append(h)
        return self.readout(torch.stack(states, dim=1), x)

    def forward(self, x):
        u, T = self.drive(x), x.shape[1]
        k = torch.arange(T, dtype=torch.float32)[:, None]
        kernel = torch.exp(k * self.log_lambda()[None, :])        # lambda^k, (T, N)
        h = torch.fft.ifft(torch.fft.fft(u, n=2 * T, dim=1)
                           * torch.fft.fft(kernel, n=2 * T, dim=0)[None], dim=1)[:, :T]
        return self.readout(h, x)

torch.manual_seed(0)                                   # first draw is torch.rand(64)
layer = DiagLinearRecurrence(d_in=4, d_out=3, N=64)
lam_abs = torch.exp(-torch.exp(layer.nu_log)).detach()
half_life = math.log(0.5) / torch.log(lam_abs)
print("parameters:", sum(p.numel() for p in layer.parameters()))
print(f"|lambda| range: {lam_abs.min():.6f} to {lam_abs.max():.6f}")
print(f"half-lives (steps): {half_life.min():.1f} to {half_life.max():.1f}")
parameters: 1036
|lambda| range: 0.902329 to 0.998724
half-lives (steps): 6.7 to 542.8
64 个模态的模分布在 0.902–0.9987 之间,所以这一层一开始就具有半衰期 \ln 0.5/\ln|\lambda| 从几步到几百步不等的记忆。圆环的两个端点对应 6.6 步和 693 步;64 次随机抽取达不到端点。模有意打印到小数点后六位:在单位圆附近,半衰期取决于小数点后第五位(0.9987 对应 533 步,0.998724 对应 543 步)。在这里,记忆在任何训练之前就由一个你能读出来的数决定了。
步骤 2:一个映射,两种算法
检验第 13 节的论断:循环和 FFT 卷积是同一个线性时不变系统。对 T = 256、1,024 和 4,096(batch 大小 8,4 个输入通道,3 个输出),在关闭梯度的情况下,打印两个输出之间的最大差值,以及各自三次墙钟时间中的最好成绩。
def best_of(fn, repeats=3):
    times = []
    for _ in range(repeats):
        t0 = time.perf_counter()
        fn()
        times.append(time.perf_counter() - t0)
    return min(times) * 1e3                            # milliseconds

Ts, t_loop, t_fft = [256, 1024, 4096], [], []
print("   T   max|loop - fft|   loop ms   fft ms   speed-up")
with torch.no_grad():
    for T in Ts:
        x = torch.randn(8, T, 4)
        y_loop, y_fft = layer.forward_loop(x), layer(x)
        err = (y_loop - y_fft).abs().max().item()
        t_loop.append(best_of(lambda: layer.forward_loop(x)))
        t_fft.append(best_of(lambda: layer(x)))
        print(f"{T:5d}   {err:13.2e}   {t_loop[-1]:8.1f}  {t_fft[-1]:7.1f}   "
              f"{t_loop[-1] / t_fft[-1]:6.1f}x")

plt.figure(figsize=(5.5, 4))
plt.loglog(Ts, t_loop, "o-", label="recurrent loop")
plt.loglog(Ts, t_fft, "s-", label="FFT convolution")
plt.xlabel("sequence length T")
plt.ylabel("time per forward pass (ms)")
plt.title("One linear recurrence, two algorithms (CPU)")
plt.legend()
plt.grid(True, which="both", alpha=0.3)
plt.tight_layout()
plt.show()
   T   max|loop - fft|   loop ms   fft ms   speed-up
  256        3.10e-06        4.2      3.8      1.1x
 1024        1.29e-05       19.8     13.8      1.4x
 4096        1.41e-05       79.1     70.0      1.1x
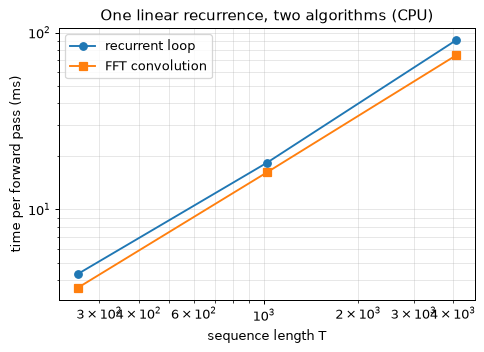
两个输出在 float32 舍入误差范围内一致,在量级为 1 的输出上约为 10^{-5} 量级;T 越长差值略大,因为卷积核 \lambda^k 是用 float32 计算的,其相位误差随 k 增长:这是用两种方式计算的同一个函数,而不是彼此近似的两个函数。循环需要 T 个顺序步,所以它的时间随 T 线性增长。在 CPU 上的如实结论是:FFT 形式最多只是略快一些,而在最长的长度上优势就消失了:在准备本实验所用的机器上跑五次,它在 T = 256 时快 1.1 到 1.7 倍,在 T = 1{,}024 时快 1.2 到 1.6 倍,在 T = 4{,}096 时为 0.7 到 1.1 倍,五次中有三次比循环还慢。这并不矛盾。FFT 做 O(T\log T) 的工作,但常数很大(64 个模态中的每一个都要做三次长度为 2T 的变换),循环做 O(T) 个小运算,而只有几个核心的 CPU 几乎没有可供 FFT 形式利用的并行度。卷积形式在存在并行度的地方才划算:在 GPU 上,循环那些微小的顺序步让硬件闲置,而变换能把硬件填满;在训练中,需要一次得到整个序列的梯度。在生成时,循环仍然是正确的形式,因为它每个通道只需要 N 个数的状态,每个 token 的工作量恒定。计时取决于机器以及机器上同时运行的其他程序;预期顺序相同,数字不同。
步骤 3:一个需要长记忆的回忆任务
延迟回忆。 一个序列的长度为 L+1。它的第一个 token 是 8 个符号(0–7)之一;其余 L 个 token 是空白(token 8)。目标是第一个符号,在最后一步读出。随机水平为 12.5%。只有当关于 token 0 的信息在 L 步之后仍然保留时,模型才能成功,而前向信号和梯度都需要这种保留(第 4 节)。除此之外没有别的可学,这使该任务成为衡量记忆所及范围的干净指标。L 就是滞后(lag)。
四个模型,每个都由一个 Embedding(9, 16)、一个宽度为 64 的循环核心,以及一个读取最后一步的输出层组成:
nn.RNN(16, 64),一个普通的 tanh 网络;nn.LSTM(16, 64),遗忘门偏置为 1(初始化时半衰期为 2.2 步);- 同上,但遗忘门偏置为 5(半衰期为 103 步;见第 5 节中的表);
DiagLinearRecurrence(16, 64, N=64),之后接 GELU 和Linear(64, 8)。
遗忘门偏置的切片是 bias_ih_l0[H:2*H] 和 bias_hh_l0[H:2*H],与第 5 节相同:把前者设为该值,后者置零,使两者之和等于该值。
class Recall(nn.Module):
    def __init__(self, kind, forget_bias=1.0):
        super().__init__()
        self.kind = kind
        self.emb = nn.Embedding(9, 16)
        if kind == "rnn":
            self.core, self.head = nn.RNN(16, 64, batch_first=True), nn.Linear(64, 8)
        elif kind == "lstm":
            self.core, self.head = nn.LSTM(16, 64, batch_first=True), nn.Linear(64, 8)
            H = 64
            with torch.no_grad():
                self.core.bias_ih_l0[H:2 * H].fill_(forget_bias)
                self.core.bias_hh_l0[H:2 * H].zero_()
        else:
            self.core = DiagLinearRecurrence(16, 64, N=64)
            self.head = nn.Sequential(nn.GELU(), nn.Linear(64, 8))

    def forward(self, tokens):
        e = self.emb(tokens)
        out = self.core(e) if self.kind == "lin" else self.core(e)[0]
        return self.head(out[:, -1])                   # predict from the last step

def recall_batch(batch, lag, gen):
    first = torch.randint(0, 8, (batch,), generator=gen)
    x = torch.full((batch, lag + 1), 8, dtype=torch.long)    # 8 is the blank
    x[:, 0] = first
    return x, first

def run_recall(kind, lag, forget_bias=1.0, updates=400, seed=0):
    torch.manual_seed(seed)
    model = Recall(kind, forget_bias)
    gen = torch.Generator().manual_seed(seed + 1)
    opt = torch.optim.AdamW(model.parameters(), lr=3e-3)
    losses, solved = [], None
    for update in range(1, updates + 1):
        x, y = recall_batch(64, lag, gen)
        loss = nn.functional.cross_entropy(model(x), y)
        opt.zero_grad()
        loss.backward()
        nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        opt.step()
        losses.append(loss.item())
        if solved is None and update >= 10 and np.mean(losses[-10:]) < 0.05:
            solved = update
    test_gen = torch.Generator().manual_seed(12345)
    x, y = recall_batch(1000, lag, test_gen)
    with torch.no_grad():
        acc = (model(x).argmax(-1) == y).float().mean().item()
    return acc, solved, losses

x, y = recall_batch(2, 5, torch.Generator().manual_seed(0))
print(x.tolist(), "->", y.tolist())
print("untrained LSTM output shape:", tuple(Recall("lstm")(x).shape))
[[4, 8, 8, 8, 8, 8], [7, 8, 8, 8, 8, 8]] -> [4, 7]
untrained LSTM output shape: (2, 8)
步骤 4:在三种滞后下训练
每个模型在滞后 25、100 和 200 下各训练 400 次更新(batch 大小 64,AdamW,学习率 3\times10^{-3},梯度范数裁剪到 1)。普通 RNN 只在 25 和 100 下运行:它在 200 时很慢,而在 100 时,它在某些随机种子上成功,在另一些上停留在随机水平。表中报告在 1,000 个新序列上的测试准确率,以及最近 10 次更新的平均损失首次降到 0.05 以下时的更新序号(如果从未发生,则为一条短横线)。随机水平的准确率为 12.5%,初始损失接近 \ln 8 = 2.08。
configs = [("vanilla RNN", "rnn", 0.0), ("LSTM, forget bias 1", "lstm", 1.0),
           ("LSTM, forget bias 5", "lstm", 5.0), ("diagonal linear", "lin", 0.0)]
lags = [25, 100, 200]
table, curves = {}, {}
print(f"{'model':21s}" + "".join(f"  lag {L:<3d}: acc  solved" for L in lags))
for name, kind, fb in configs:
    row = f"{name:21s}"
    for lag in lags:
        if kind == "rnn" and lag == 200:
            row += f"  {'skipped':>10s}  {'':>6s}"
            continue
        acc, solved, losses = run_recall(kind, lag, fb)
        table[(name, lag)], curves[(name, lag)] = (acc, solved), losses
        row += f"  {100 * acc:9.1f}%  {str(solved) if solved else '-':>6s}"
    print(row)
model                  lag 25 : acc  solved  lag 100: acc  solved  lag 200: acc  solved
vanilla RNN                 77.2%       -      100.0%       -     skipped
LSTM, forget bias 1         11.8%       -       11.8%       -       11.8%       -
LSTM, forget bias 5        100.0%      74       12.6%       -       12.6%       -
diagonal linear            100.0%     124      100.0%     238      100.0%       -
每个条目都来自一次训练运行,从 torch.manual_seed(0) 开始。换一个随机种子,表中哪个格子成功就可能改变,在模型记忆所及范围的边缘尤其如此。在用随机种子 1 到 4 做的运行中(run_recall(..., seed=s),在修订本文时完成),遗忘门偏置为 5 的 LSTM 在四次中有两次学会了滞后 100,普通 RNN 在一次(随机种子 2)中达到滞后 100 下的 100%,在另外三次中停留在随机水平。读这张表要看它的规律,而不是任何单个格子。规律是:由初始化时特征值的模决定的记忆,在每个随机种子上都能覆盖全部三种滞后;由门偏置决定的记忆,所及范围大约就是该设置所允许的那么远(偏置 5 总能学会滞后 25,从不能学会滞后 200),而偏置为 1 的 LSTM 从未脱离随机水平。普通 RNN 是这次运行中的异类:在滞后 100 下为 100%,在滞后 25 下却只有 77%;而在滞后 100 下,它的损失在 400 次更新后仍约为 1.1,所以它是很晚才找到答案,还不够自信。在五个随机种子中有三个,它从未找到答案。一个起初只有短记忆的模型可以在预算内找到长记忆,但能否找到要看运气。“solved”一列中的短横线表示平均损失从未降到 0.05 以下,这在测试准确率为 100% 时也可能发生,即 logits 已经正确但还不够自信,就像这里的普通 RNN 一样。
步骤 5:查看学习曲线
准确率表掩盖了训练的过程。画出每个模型在滞后 100 下的损失:成功的模型会先出现一段停留在 \ln 8 = 2.08 的平台,然后下降;失败的模型则一直停在平台上。平台的长度就是寻找一个可以跟随的梯度所花的时间。在所示的运行中,线性循环在约 100 次更新后离开平台,而普通 RNN 要到约 200 次之后才离开,而且不稳定,到第 400 次更新时仍接近 1.1。
plt.figure(figsize=(7, 4.2))
for name, _, _ in configs:
    if (name, 100) in curves:
        k = 10                                         # smooth over 10 updates
        smooth = np.convolve(curves[(name, 100)], np.ones(k) / k, mode="valid")
        plt.plot(np.arange(k, len(smooth) + k), smooth, label=name)
plt.axhline(math.log(8), color="grey", linestyle=":", label="chance (ln 8)")
plt.xlabel("update")
plt.ylabel("cross-entropy loss (mean of 10 updates)")
plt.title("Delayed recall at lag 100")
plt.legend()
plt.grid(alpha=0.3)
plt.tight_layout()
plt.show()
你应该看到什么
- 相等。 在 float32 下,循环和 FFT 卷积的结果一致,差异只有 10^{6} 分之几到 10^{5} 分之几。
- 速度。 在 CPU 上,FFT 形式最多只比循环略快(五次运行中,T = 256 和 1,024 时快 1.1 到 1.7 倍),在 T = 4{,}096 时并不更快(0.7 到 1.1 倍);计时噪声很大。卷积模式的理由在于并行度,而 GPU 提供了并行度。
- 由初始化决定的记忆。 64 个模分布在 0.902–0.998724 之间,半衰期约为 6.7 到 543 步。正是这个范围,而不是任何学到的东西,使线性循环能够触及第一个 token。
- 回忆。 400 次更新后,线性循环在全部三种滞后下都达到 100%(随机种子 0 到 4 在准确率上全部一致;损失首次降到 0.05 以下的更新序号有所不同,在滞后 200 下,五个随机种子中有三个在预算之内)。普通 RNN 只部分学会了滞后 25(五个随机种子上为 62–87%),在滞后 100 下表现飘忽:随机种子 0 和 2 上为 100%,其余三个为随机水平(11–14%)。遗忘门偏置为 1 的 LSTM 即使在滞后 25 下也停留在随机水平,每个随机种子都如此。遗忘门偏置为 5 的 LSTM 在滞后 25 下学得最快(全部五个随机种子上都在 56–83 次更新后达到 100%),在五个随机种子中有两个学会了滞后 100(第三个为 73%),在滞后 200 下为随机水平。随机种子 1 到 4 在修订本文时用
run_recall(..., seed=s)各跑了一次;你可以试试。 - 这说明了什么,没说明什么。 它说明的是在预算内的可训练性:一种是在初始化时直接设定的记忆长度,另一种是 LSTM 必须通过门偏置去寻找的记忆长度。它并没有说明 LSTM 无法保持长记忆;有了更长的预算、chrono 初始化(第 5 节)或更大的偏置,原则上它可以做到。
表中的数字来自你机器上的运行;最后几位数字,尤其是更新序号,会随库版本而变化。
动手试试
- 干扰符号。 把空白换成从另一组 8 个干扰符号中随机抽取的 token。在一次试运行中,线性循环仍然学会了滞后 25 和 100:它的嵌入学会把干扰符号映射到零附近,这是在输入处对内容的过滤。当保留什么取决于上下文时,选择性就很重要了。构建选择性复制的变体,即要回忆的符号是随机位置上一个标记 token 之后的那个符号,并比较各个模型。
- 并行扫描。 用结合算子 (a_1, b_1) 之后接 (a_2, b_2) \mapsto (a_1a_2,\ a_2b_1 + b_2) 在 \log_2 T 轮内计算这个循环,并与
forward_loop对照检查。 - 初始圆环就是记忆。 把圆环收窄到 [0.9, 0.95],重新运行滞后 100 和 200。先预测哪一个会失败:|\lambda| = 0.95 的半衰期是 13.5 步。
- 一个最简单的选择性循环。 让步长依赖于输入,\lambda_t = \exp(\Delta_t\log\lambda),其中 \Delta_t = \operatorname{softplus}(\mathbf{w}^\top x_t + c),并用循环计算它。在第 1 项的干扰符号任务上,它能在没有嵌入帮助的情况下学会忽略干扰符号吗?
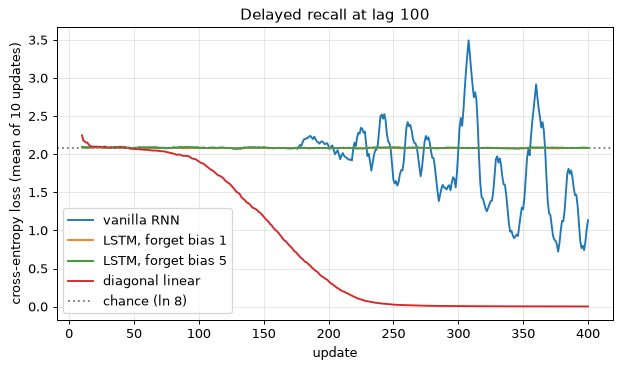
练习
十五道练习按它们所练习的各节顺序排列,并按工作量分级:★ 是概念题,约 5 分钟,除了读出一个比值之外不需要计算;★★ 是推导或计算,这里约 10 分钟;★★★ 是编程,约 25 分钟。第一类有七道,第二类七道,第三类一道,合计约 130 分钟。解答默认折叠,打开之前,先在纸上定下一个答案:先读解答,所学远不如亲自尝试练习。
没有一道练习重复例题或正文检查题的数字或场景。各节在一组数字上讲授一种方法;这里把同一种方法用到另一组数字上,使能迁移的是方法而不是答案。解答中的每个数字都先手算,再用脚本核对。解答中的代码是完整的,在 CPU 上用 Python 3.11、NumPy 2.x 和 PyTorch 2.x 运行过;打印输出的最后几位以及所有计时,在你的机器上可能不同。除非写作 KiB,内存大小均为十进制(1 kB = 10^3 B)。
对下面每个任务,指出任务的形态(多对一、对齐的多对多、序列到序列或一对多),并说明第 t 步的输出能否依赖于 t 之后的输入。
(a) 每 10 分钟一次,根据一台风力发电机最近一周的传感器读数,预测其齿轮箱一小时之后的油温。
(b) 对一条实时管道压力数据流的每个样本,在下一个样本到达之前判断是否正在发生压力骤升,以便关闭阀门。
(c) 把一次机组跳闸期间触发的报警代码序列,变成交接班日志中的一句话摘要。
(d) 一个点焊完成之后,根据它完整的电流曲线判断是否合格。
(e) 给定一栋建筑的建筑面积和用途,生成一周看起来合理的逐小时用电需求,用来测试一种控制策略。
查看解答
每种情形由两个问题决定(第 1 节)。损失放在哪里:一个输出上、每一步一个输出上,还是一个有自己长度的新序列上?以及,在必须做出决策的时候,其余的输入是否已经存在?第二个问题决定了能否使用双向网络。
(a) 对齐的多对多,或按窗口的多对一;因果。每 10 分钟一个读数,一周就是 7\times24\times6 = 1{,}008 个样本,“一小时之后”是 6 个样本。在数据流的每一步都输出一个预测的网络是对齐的多对多;把每个 1,008 样本的窗口映射为一个数的网络是多对一。训练哪一种,是把损失放在哪里的选择,而不是另一个问题。无论哪种,t 时刻的输出都只能使用截至 t 的读数:做预测时,未来的读数还不存在;在验证中让模型看到它们,就是泄漏(第 8 节)。
(b) 对齐的多对多(每个样本一个标签);因果。答案必须在下一个样本到达之前给出,所以不能使用 t 之后的任何输入,双向网络被排除。这与事后给同一条压力曲线打标签不同,后者是离线的,可以双向读取(第 6 节)。截止时间也约束了每一步的计算量,而循环神经网络的每步计算量是恒定的(第 12 节)。
(c) 序列到序列。输入(报警代码)和输出(一句话)长度不同,也没有逐步的对齐,这正是第 10 节的编码器-解码器所要处理的。跳闸已经结束,所以编码器可以读取整个代码序列,也可以是双向的:在这个意义上答案是肯定的,每个输入对每个输出都可用。解码器在它自己的输出上仍然是因果的:摘要的第 t 个词依赖于它之前的词,而不是之后的词。
(d) 多对一;离线。决策来自整条曲线,而曲线已经完整,所以允许双向读取,输出可以依赖于每一个输入。
(e) 一对多,生成。条件输入(建筑面积和用途)是一个固定的向量;输出是 168 个逐小时值,每个值都作为下一步的输入反馈回去。每个生成的值只能依赖于条件输入和已经生成的值,所以答案是否定的。“看起来合理”要求在每一步从模型的分布中带噪声地采样,而不是在每一步取最可能的值,后者会给出平滑得不真实的一周(关于采样,见第 2 节)。
规律是:模型必须随数据到达而作答的任务((a)、(b))禁止前瞻;在已完成的记录上运行的任务((c)、(d))允许前瞻;而在每个生成任务中,解码器在它自己的输出上都是因果的。
考虑标量 RNN h_t = \tanh(w\,h_{t-1} + u\,x_t),其中 h_0 = 0,损失在 T = 3 步之后为 L = \tfrac12(h_3 - y)^2。
(a) 把 \partial L/\partial w 写成三项之和。在每一项中显式写出雅可比矩阵之积 \partial h_3/\partial h_k = \prod_j w(1-h_j^2)。
(b) 对 w = 0.9、u = 0.5、x = (1, 0, 1) 和 y = 0.5 计算所有的量,包括 \partial L/\partial u。比较 x_1 和 x_3 对 \partial L/\partial u 的贡献。
(c) 对线性循环(把 tanh 换成恒等映射),分别对 w = 0.8 和 w = 1.25 计算 \partial h_{50}/\partial h_0,并说明各自对学习意味着什么。
查看解答
准备。记 z_t = w\,h_{t-1} + u\,x_t,h_t = \tanh z_t。由于 \tanh' = 1 - \tanh^2,有 \partial h_t/\partial z_t = 1 - h_t^2。状态 h_{t-1} 以系数 w 进入 z_t,所以单步雅可比是标量
这是第 3 节的雅可比矩阵 \operatorname{diag}(\phi'(\mathbf{z}_t))\,\mathbf{W}_h 的标量情形。
(a) 参数 w 在每一步都被使用,所以它的梯度是对各步的求和(第 3 节)。第 k 步的使用使 z_k 改变 h_{k-1}\,\mathrm{d}w,从而使 h_k 改变 (1 - h_k^2)\,h_{k-1}\,\mathrm{d}w。这一变化经由 \partial h_3/\partial h_k 传到 h_3,再经由 \partial L/\partial h_3 = h_3 - y 传到损失。把三步加起来:
逐项写出:
- k = 3:乘积为空,\partial h_3/\partial h_3 = 1,该项为 (1 - h_3^2)\,h_2。
- k = 2:\partial h_3/\partial h_2 = w(1 - h_3^2),该项为 w(1 - h_3^2)(1 - h_2^2)\,h_1。
- k = 1:\partial h_3/\partial h_1 = w(1 - h_3^2)\cdot w(1 - h_2^2),该项为 w(1 - h_3^2)\,w(1 - h_2^2)\,(1 - h_1^2)\,h_0。
因子 (1 - h_3^2) 是三项共有的,所以
第 k 项带着从第 k 步到第 3 步的雅可比之积:滞后越长,因子越多,而每个因子通常都小于 1(第 4 节)。这里 h_0 = 0 使最后一项为零,但正是这一项承载对初始状态的依赖。
要算数值,更方便的做法是对误差信号 g_k = \partial L/\partial z_k 运行第 3 节的递推。由于 z_{k+1} 以系数 w 依赖于 h_k,
(b) 先做前向传播,因为每个因子都需要这些状态:
- h_1 = \tanh(0.9\cdot0 + 0.5\cdot1) = \tanh 0.5 = 0.4621;
- h_2 = \tanh(0.9\cdot0.4621 + 0.5\cdot0) = \tanh 0.4159 = 0.3935;
- h_3 = \tanh(0.9\cdot0.3935 + 0.5\cdot1) = \tanh 0.8541 = 0.6932;
- L = \tfrac12(0.6932 - 0.5)^2 = 0.01867。
导数因子为 1 - h_3^2 = 0.5194、1 - h_2^2 = 0.8452 和 1 - h_1^2 = 0.7864。误差信号为:
- g_3 = (0.6932 - 0.5)(0.5194) = 0.10037;
- g_2 = g_3\cdot w(1 - h_2^2) = 0.10037\times0.7607 = 0.07635;
- g_1 = g_2\cdot w(1 - h_1^2) = 0.07635\times0.7078 = 0.05404。
于是
输入 x_1 和 x_3 都等于 1,但 x_1 的贡献只有 x_3 的 0.05404/0.10037 = 0.538 倍。原因在于路径:第 3 步的误差要先经过两个局部因子 w(1 - h_2^2) = 0.761 和 w(1 - h_1^2) = 0.708 才能到达 z_1,二者之积为 0.538。仅线性部分会给出 0.9^2 = 0.81;另一个因子 0.538/0.81 = 0.66 是 tanh 导数的贡献,只要单元不在零点,这些导数就小于 1。非线性只会让衰减更严重,绝不会使之减轻(第 4 节)。
下面的脚本重复了这些算术,并用中心差分核对两个梯度。
import numpy as np

w, u, y = 0.9, 0.5, 0.5
x = [1.0, 0.0, 1.0]

def forward(w, u):
    h = [0.0]                                    # h_0 = 0
    for xt in x:
        h.append(np.tanh(w * h[-1] + u * xt))
    return h

def loss(w, u):
    return 0.5 * (forward(w, u)[3] - y) ** 2

h = forward(w, u)
g3 = (h[3] - y) * (1 - h[3] ** 2)                # dL/dz_3
g2 = g3 * w * (1 - h[2] ** 2)                    # dL/dz_2
g1 = g2 * w * (1 - h[1] ** 2)                    # dL/dz_1
dw = g3 * h[2] + g2 * h[1] + g1 * h[0]
du = g1 * x[0] + g2 * x[1] + g3 * x[2]
eps = 1e-6
dw_fd = (loss(w + eps, u) - loss(w - eps, u)) / (2 * eps)
du_fd = (loss(w, u + eps) - loss(w, u - eps)) / (2 * eps)
print("h:", [f"{v:.4f}" for v in h[1:]], f" L = {loss(w, u):.5f}")
print(f"g3, g2, g1 = {g3:.5f}, {g2:.5f}, {g1:.5f}")
print(f"dL/dw = {dw:.5f} (central difference {dw_fd:.5f})")
print(f"dL/du = {du:.5f} (central difference {du_fd:.5f})")
print(f"contribution of x_1 / x_3 = {g1 / g3:.3f}")
print(f"0.8^50 = {0.8 ** 50:.3e}, 1.25^50 = {1.25 ** 50:.3e}, "
      f"1 / 0.8^50 = {0.8 ** -50:.0f}")
h: ['0.4621', '0.3935', '0.6932']  L = 0.01867
g3, g2, g1 = 0.10037, 0.07635, 0.05404
dL/dw = 0.07477 (central difference 0.07477)
dL/du = 0.15440 (central difference 0.15440)
contribution of x_1 / x_3 = 0.538
0.8^50 = 1.427e-05, 1.25^50 = 7.006e+04, 1 / 0.8^50 = 70065
(c) 去掉 tanh 后,h_t = w\,h_{t-1} + u\,x_t,每个雅可比都是 w,所以 \partial h_{50}/\partial h_0 = w^{50}。
- w = 0.8:0.8^{50} = 1.4\times10^{-5}。50 步之前的输入到达损失时,梯度比新输入小约 70,000 倍。这一依赖关系的梯度信号低于其他所有项的噪声,所以这种依赖实际上永远学不到。梯度裁剪无济于事,因为梯度是太小,而不是太大。
- w = 1.25:1.25^{50} = 7.0\times10^{4},是反方向的同一个因子,因为 1.25 = 1/0.8。除非对梯度进行裁剪,沿这个方向的一次更新就会大 70,000 倍,把权重抛到远离模型原本正常工作的区域。
恢复 tanh 后,每个因子都是 w(1 - h^2) \le w。非线性只会让梯度消失更严重,而一旦单元饱和,它又会给爆炸设上限,这就是为什么梯度爆炸往往以偶发的悬崖形式出现,而不是稳定地增长(第 4 节)。
用三四句话解释:为什么全局范数梯度裁剪能治愈梯度爆炸,却治不了梯度消失;为什么把每个分量裁剪到 [-c, c] 比裁剪范数更糟。以 \mathbf{g} = (0.6, -45) 和 c = 1 为例;不需要计算角度。
查看解答
全局范数裁剪把 \mathbf{g} 替换为 \mathbf{g}\min(1, c/\lVert\mathbf{g}\rVert):范数超过 c 的梯度被缩放到范数恰好为 c,所以步长有界而方向不变,损失曲面上的悬崖再也不能把参数抛到远处。梯度消失是相反的情形,梯度太小而不是太大:裁剪从不放大梯度,所以长程依赖的贡献仍然被短程依赖淹没,要治愈它,需要结构上的改变,例如 LSTM 的门控加性通路(第 5 节)。把每个分量裁剪到 [-c, c] 会改变更新的方向,因为它缩小大的分量,而对小的分量不加改动。裁剪范数把每个分量除以同一个数,所以方向不变。
数值上:\lVert\mathbf{g}\rVert = \sqrt{0.6^2 + 45^2} = \sqrt{2025.36} = 45.004。
- 范数裁剪乘以 1/45.004,得到 (0.0133, -0.9999)。两个分量之比仍为 0.6 : 45 = 1 : 75。
- 分量裁剪得到 (0.6, -1)。大分量被削减了 45 倍,小分量毫无变化,所以比值变成 3 : 5,更新指向了别处:原本梯度很小的那个参数被赋予了大得多的权重。
(作为参考,\mathbf{g} 与分量裁剪后的向量之间的余弦为 0.864,约 30^\circ;范数裁剪后的向量余弦恰好为 1。)实践中的陷阱也是同一个:各分量不能互换,所以独立地裁剪它们会改变哪些参数在移动。梯度裁剪的来龙去脉见第 4 节,它所服务的优化器见模块 02。
(a) 由第 5 节的 LSTM 方程推导 \partial\mathbf{c}_t/\partial\mathbf{c}_{t-1},并指出不经过 \mathbf{h}_{t-1} 的那一项。
(b) 固定各个门(忽略经过 \mathbf{h} 的路径),当遗忘门等于 \sigma(b_f)、b_f = 1.5、2.5 和 4.5 时,计算每个单元的 \partial c_{60}/\partial c_0。与每步因子为 0.7 的普通 tanh RNN 比较。
(c) 多大的遗忘门偏置能给出 250 步的记忆半衰期?
(d) 要应用它,必须设置哪些 PyTorch 张量的哪一段切片?
查看解答
(a) 细胞更新为 \mathbf{c}_t = \mathbf{f}_t\odot\mathbf{c}_{t-1} + \mathbf{i}_t\odot\tilde{\mathbf{c}}_t。\mathbf{c}_{t-1} 从哪里进入它?
- 直接地,作为与 \mathbf{f}_t 相乘的因子。
- 间接地,经由 \mathbf{h}_{t-1} = \mathbf{o}_{t-1}\odot\tanh(\mathbf{c}_{t-1}),它输入门 \mathbf{f}_t、\mathbf{i}_t 和候选值 \tilde{\mathbf{c}}_t。(门 \mathbf{o}_{t-1} 由 \mathbf{h}_{t-2} 计算得到,不依赖于 \mathbf{c}_{t-1}。)
直接路径的导数为 \operatorname{diag}(\mathbf{f}_t)。对间接路径,经由 \mathbf{h}_{t-1} 应用链式法则,并利用 \sigma' = \sigma(1-\sigma) 和 \tanh' = 1 - \tanh^2。设 \mathbf{W}^h_f、\mathbf{W}^h_i、\mathbf{W}^h_c 为权重矩阵中与 \mathbf{h}_{t-1} 相乘的 H\times H 块。于是
相乘并加上直接项,
不经过 \mathbf{h}_{t-1} 的那一项是 \operatorname{diag}(\mathbf{f}_t)。它不含权重矩阵,也不含压缩函数的导数:门的值就是整个因子,网络在每一步设定它,并且可以让它保持在 1 附近。其余各项含有 \mathbf{W}^h 和小于 1 的导数,正是第 4 节中那个趋于消失的乘积的组成部分。
(b) 忽略经过 \mathbf{h} 的路径,每个单元有 \partial c_t/\partial c_{t-1} = f,所以 60 步的因子为 f^{60}。先求 f = \sigma(b_f) = 1/(1 + e^{-b_f})。以 b_f = 2.5 为例手算:e^{-2.5} = 0.0821,所以 f = 1/1.0821 = 0.9241;\ln f = -0.07889;60\ln f = -4.733;e^{-4.733} = 8.8\times10^{-3}。半衰期为 \ln 0.5/\ln f(第 5 节)。
| b_f | f = \sigma(b_f) | f^{60} | 半衰期(步) | 60 步合多少个半衰期 |
|---|---|---|---|---|
| 1.5 | 0.8176 | 5.6\times10^{-6} | 3.4 | 17.4 |
| 2.5 | 0.9241 | 8.8\times10^{-3} | 8.8 | 6.8 |
| 4.5 | 0.9890 | 0.515 | 62.7 | 0.96 |
| 普通 RNN,因子 0.7 | 0.7 | 5.1\times10^{-10} | 1.9 | 31 |
只有最大的偏置能把可用的梯度传到 60 步的滞后:b_f = 4.5 传过去约一半,因为 60 步大约是一个半衰期(0.96 个)。另外两个只传过去百万分之一和百分之一。与普通 RNN 的因子相比,b_f = 4.5 大 0.515/5.1\times10^{-10} \approx 10^{9} 倍。需要注意的仍是题目中的那个限定:这只是沿细胞通路、在门固定时的乘积。在训练好的网络中,门随输入变化,所以 f^{60} 是一个单元在 60 步内把遗忘门保持在 f 附近时所能保留的梯度。
(c) 解 f^{250} = 0.5:f = 0.5^{1/250} = e^{-\ln 2/250} = e^{-0.002773} = 0.99723。对 sigmoid 求逆:b_f = \ln\dfrac{f}{1-f} = \ln\dfrac{0.99723}{0.00277} = \ln 360.2 = 5.887。半衰期很长时 1 - f \approx \ln 2/t_{1/2},由此得到捷径
前三位数字相同。这就是 chrono 初始化的逻辑(第 5 节):时间常数 1/(1-f) = 1 + e^{b_f} 随偏置每增加一个单位而增长 e 倍,所以约为 6 的偏置就设定了几百步的记忆。之所以这样做,是因为在初始化时权重很小,偏置是唯一决定门值的参数。
(d) PyTorch 按 i, f, g, o 的顺序堆叠四个门,其中 g 是候选值,所以遗忘门是行的第二块。对第 0 层,这是两个偏置向量 bias_ih_l0 和 bias_hh_l0 的切片 [H:2*H]。两个偏置在门内相加,所以把其中一个设为该值,另一个置零(或者把两者一并考虑)。下面的脚本同时核对这一做法和 (b) 小题。它把所有参数置零,使每个门只取决于自己的偏置;这时输入门为 \sigma(0) = 0.5,候选值为 \tanh(0) = 0,所以恰好有 c_t = f\,c_{t-1}。从 c_0 = 1 出发,最终的细胞状态就是记忆 f^{n}。
import math
import torch
import torch.nn as nn

H = 4

def memory_after(steps, forget_bias):
    """Zero all weights so each gate depends on its bias alone; start with c_0 = 1."""
    lstm = nn.LSTM(1, H, batch_first=True)
    with torch.no_grad():
        for p in lstm.parameters():
            p.zero_()
        lstm.bias_ih_l0[H:2 * H] = forget_bias   # slice 1 of the stacked i, f, g, o
    x = torch.zeros(1, steps, 1)
    h0, c0 = torch.zeros(1, 1, H), torch.ones(1, 1, H)
    with torch.no_grad():
        _, (_, c_n) = lstm(x, (h0, c0))
    return float(c_n[0, 0, 0])

for b in (1.5, 2.5, 4.5):
    f = 1 / (1 + math.exp(-b))
    print(f"b_f = {b}: c_60 = {memory_after(60, b):.3e}, "
          f"sigmoid(b_f)^60 = {f ** 60:.3e}")
b_250 = math.log(0.5 ** (1 / 250) / (1 - 0.5 ** (1 / 250)))
print(f"b_f = {b_250:.3f}: c_250 = {memory_after(250, b_250):.4f} "
      f"(half-life 250 -> 0.5)")
print(f"chrono shortcut ln(250 / ln 2) = {math.log(250 / math.log(2)):.3f}")
b_f = 1.5: c_60 = 5.645e-06, sigmoid(b_f)^60 = 5.645e-06
b_f = 2.5: c_60 = 8.797e-03, sigmoid(b_f)^60 = 8.797e-03
b_f = 4.5: c_60 = 5.154e-01, sigmoid(b_f)^60 = 5.154e-01
b_f = 5.887: c_250 = 0.5000 (half-life 250 -> 0.5)
chrono shortcut ln(250 / ln 2) = 5.888
如果切片错了([0:H] 是输入门),无论偏置是多少,遗忘门都会停留在 \sigma(0) = 0.5,每一行都会打印 0.5^{60} = 8.7\times10^{-19}(最后一行则是 0.5^{250})。这就是它的失效方式:索引错误的偏置抬高了错误的门,而且不会报错。
对 d_\text{in} = 8、H = 64 的循环层,分别统计普通 RNN、LSTM 和 GRU 的参数量,先按每个门一个偏置向量计,再按 PyTorch 的方式计。然后逐层统计 nn.GRU(8, 64, num_layers=2, bidirectional=True) 的参数量,并解释为什么它的第二层更大。
查看解答
每个门一个偏置向量。普通的循环层有一个循环矩阵 \mathbf{W}_h(H\times H)、一个输入矩阵 \mathbf{W}_x(H\times d_\text{in})和一个偏置(H):
LSTM 有四个这样的块(三个门和一个候选值),所以是 4\times4{,}672 = 18{,}688;GRU 有三个(两个门和一个候选值),所以是 3\times4{,}672 = 14{,}016(第 5 节和第 6 节)。
按 PyTorch 的方式计。PyTorch 每个块保存两个偏置向量 bias_ih 和 bias_hh,二者在门内相加。这使每个块多出 H 个参数,所以总数为 g\,H(H + d_\text{in}) + 2gH,其中块数 g = 1, 4, 3:
- RNN:64\times72 + 2\times64 = 4{,}608 + 128 = 4{,}736;
- LSTM:4\times64\times72 + 8\times64 = 18{,}432 + 512 = 18{,}944;
- GRU:3\times64\times72 + 6\times64 = 13{,}824 + 384 = 14{,}208。
双向两层 GRU。双向层是两个相互独立的 GRU,每个方向一个,输出拼接在一起。第 1 层读取 8 个原始特征,所以每个方向就是刚才算出的 14,208;两个方向共 28{,}416。第 2 层读取第 1 层拼接后的输出,宽度为 2H = 128,而不是 8:
总数为 28{,}416 + 74{,}496 = 102{,}912。第二层是第一层的 74{,}496/28{,}416 = 2.6 倍,因为它的输入矩阵是 3H\times128 = 192\times128,即 24,576 个元素,而不是 192\times8 = 1{,}536。循环矩阵(每个方向 192\times64 = 12{,}288)和偏置在两层中相同。这正是第 6 节的结论:在堆叠网络中,尤其是在双向堆叠中,参数量由上层的输入矩阵主导。
import torch.nn as nn

count = lambda m: sum(p.numel() for p in m.parameters())
for name, cls, gates in (("RNN", nn.RNN, 1), ("LSTM", nn.LSTM, 4), ("GRU", nn.GRU, 3)):
    one_bias = gates * 64 * (64 + 8 + 1)
    print(f"{name:5s} one bias {one_bias:6,d}   PyTorch {count(cls(8, 64)):6,d}")

gru = nn.GRU(8, 64, num_layers=2, bidirectional=True)
layer = lambda l: sum(p.numel() for n, p in gru.named_parameters() if f"_l{l}" in n)
print(f"two-layer bidirectional GRU: layer 1 {layer(0):,}, layer 2 {layer(1):,}, "
      f"total {count(gru):,}")
print("weight_ih_l0:", tuple(gru.weight_ih_l0.shape), " weight_ih_l1:",
      tuple(gru.weight_ih_l1.shape))
RNN   one bias  4,672   PyTorch  4,736
LSTM  one bias 18,688   PyTorch 18,944
GRU   one bias 14,016   PyTorch 14,208
two-layer bidirectional GRU: layer 1 28,416, layer 2 74,496, total 102,912
weight_ih_l0: (192, 8)  weight_ih_l1: (192, 128)
一个 batch 中有三条传感器序列,长度分别为 30、90 和 240,用零填充到 240,送入一个单向 LSTM 分类器。分类器使用第 240 个位置的输出,另有一个逐步的辅助损失,在全部 720 个位置上取平均。列出哪里出了问题,以及相应的修正方法。
查看解答
先计数:这个 batch 有 3\times240 = 720 个位置,其中真实的有 30 + 90 + 240 = 360 个。半个 batch 是填充。由此产生四个问题(第 7 节)。
- 对短序列,分类器读到的是错误的状态。对长度为 30 和 90 的序列,第 240 个位置的输出位于 210 步和 150 步零输入之后,所以这个状态是网络在这段时间内对零输入的响应,而不是序列的概括。修正:在每条序列真正的最后一步读取输出(按长度取出,
out[b, length_b - 1]),或者对 batch 打包,使最后的输出就是真正的那一个。 - 辅助损失在填充上训练。720 个位置中有一半(360 个)是填充,所以一半的损失在教模型预测填充目标,真实位置所占的梯度份额被减半。修正:对损失加掩码,在真实位置上求和并除以它们的个数,即 \sum_{\text{真实}}\ell/360,而不是除以 720。
- 一半的计算被浪费。每个填充位置的开销与真实位置一样。修正:对序列打包,或者按长度对 batch 分桶,使长度相近的序列共享一个 batch。
- 双向层会更糟。反向方向会从第 240 个位置开始,所以对长度为 30 的序列,它在读到任何数据之前要先读 210 步填充,即使每次读出都取在正确的位置,它的最终状态也已被污染。修正:打包(
pack_padded_sequence),使反向方向从每条序列真正的末尾开始。
在右侧填充和单向网络下,真实位置上的状态是精确的:它们在读到任何填充之前就已算出。所以在这种情况下,问题 1 和问题 2 关乎你读取哪些位置、对哪些位置计分,打包主要是节省计算。下面的脚本在一个随机 LSTM 上展示问题 1 及其修正。
import torch
import torch.nn as nn
from torch.nn.utils.rnn import pack_padded_sequence, pad_packed_sequence

torch.manual_seed(0)
lens = torch.tensor([30, 90, 240])
T = 240
lstm = nn.LSTM(1, 16, batch_first=True)
x = torch.zeros(3, T, 1)                     # zero padding after each real sequence
for b, n in enumerate(lens):
    x[b, :n, 0] = torch.randn(int(n))

with torch.no_grad():
    out, _ = lstm(x)
    alone = lstm(x[0:1, :30])[0][0, -1]      # sequence 0 by itself, no padding
    short_pad = lstm(x[0:1, :60])[0][0, -1]  # the same sequence padded only to 60
    pk = pack_padded_sequence(x, lens, batch_first=True, enforce_sorted=False)
    packed, _ = lstm(pk)
    unpacked, _ = pad_packed_sequence(packed, batch_first=True, total_length=T)

gap = lambda a, b: f"{(a - b).norm():.4f}"
print("norm of the true last output of sequence 0  :", gap(alone, torch.zeros(16)))
print("readout at position 240 vs true last output :", gap(out[0, -1], alone))
print("readout at position 60 vs true last output  :", gap(short_pad, alone))
print("gathered at the true length vs true output  :", gap(out[0, lens[0] - 1], alone))
print("packed, gathered at true length vs true     :",
      gap(unpacked[0, lens[0] - 1], alone))
mask = torch.arange(T)[None, :] < lens[:, None]
print("real positions:", int(mask.sum()), "of", mask.numel())
norm of the true last output of sequence 0  : 0.3512
readout at position 240 vs true last output : 0.0670
readout at position 60 vs true last output  : 0.0670
gathered at the true length vs true output  : 0.0000
packed, gathered at true length vs true     : 0.0000
real positions: 360 of 720
填充后的读出与真实输出相差 0.067,而输出的范数是 0.351,误差为其大小的 19%。它在第 60 个位置和第 240 个位置相同,是因为这个小型随机网络在几步之内就落到了它的零输入不动点上;训练好的网络可能漂移得更远或更近。不论大小如何,这个读出描述的是填充而不是序列,而按长度取出(或打包)能精确地消除这一误差。
一位同事为振动预测器搭建的流水线:
- 对整个两年的序列做 z 分数标准化;
- 以步长 1 切出 128 个样本的窗口;
- 打乱窗口,按 80/20 随机划分;
- 在那 20% 上用早停进行训练;
- 报告同一个 20% 上的 RMSE。
找出每一处泄漏,并给出修正后的流水线。
查看解答
四处泄漏,用第 8 节的术语来说。
- 第 1 步用到了未来。整个序列的均值和标准差包含了测试时段。部署时,未来的统计量是未知的。在存在漂移时,这处泄漏还掩盖了一个真实的困难:处于新水平的测试时段被重新缩放,看起来与训练数据相似。修正:只在训练部分上计算统计量,或者用每个窗口自身的最后一个值或均值对它归一化。
- 第 2 步和第 3 步合在一起泄漏了目标。步长为 1 的 128 样本窗口与每个相邻窗口共享 127 个值。每个测试目标都是之后至多 128 个窗口中的一个输入值,而在随机的 80/20 划分下,这 128 个窗口全部落入测试集的概率为 0.2^{128} \approx 3\times10^{-90}。所以训练集几乎包含了每一道测试题的答案,得分衡量的是插值,而不是预测。单独任何一步都是无害的(重叠窗口用于训练没有问题;把已经从训练块中切出的窗口打乱也没有问题)。必须尊重时间的是划分。
- 第 4 步和第 5 步重复使用了测试集。那 20% 先选定停止的轮次,再报告得分,所以得分因选择而偏乐观。用于选择的数据集与用于报告的数据集必须不同。
- 没有基线。没有任何参照的预测 RMSE 说明不了什么:应在同一数据上报告朴素预测、季节性朴素预测和线性基线(模块 01:每一个数字都要带上它的基线)。
修正后的流水线。按时间顺序划分:对两年的数据,比如说第 1 到 16 个月用于训练,第 17 到 20 个月用于验证(早停和超参数),第 21 到 24 个月用于测试,测试只用一次。任何训练窗口的目标都不能落在训练块结束之后;验证窗口和测试窗口可以读取更早的样本作为输入,因为在预测时这些是已知的。对多步预测范围 h,块与块之间至少留出 h 的间隔。只在训练块上(或逐窗口)拟合归一化。如果单个测试块给出的估计太单薄,就使用带内层验证块的前向滚动验证的多个折(第 8 节),报告每一折的得分以及各折的均值和离散程度,并附上同样各折上的基线。
一个预测器在留出的正常数据上的一步残差,标准差为 \sigma = 0.2,近似服从高斯分布;传感器以 10 Hz 采样。
(a) 对 3.5\sigma、4.5\sigma 和 5.5\sigma 的双侧阈值,计算每天预期的误报次数。
(b) 如果残差相互独立,要求连续多少次超过 3.5\sigma,才能使误报少于每月一次?
(c) 给出两个理由,说明实际的误报率为什么会高于 (a) 的预测,并说明应当如何设定阈值。
(d) 出现了一个 +1.2 的传感器偏移,并一直保持。对一个减去每个窗口最后一个值的预测器,4\sigma 的逐点检验会标记多少个样本?你会增加什么?
查看解答
(a) 每秒 10 个样本,一天就是 10\times86{,}400 = 864{,}000 个样本。k\sigma 处的双侧阈值被超过的概率为 p = 2\,(1 - \Phi(k)),其中 \Phi 是标准正态分布函数;预期误报次数为 864{,}000\,p(第 9 节)。
| 阈值 | p | 每天误报次数 |
|---|---|---|
| 3.5\sigma | 4.65\times10^{-4} | 402 |
| 4.5\sigma | 6.80\times10^{-6} | 5.87 |
| 5.5\sigma | 3.80\times10^{-8} | 0.033(约每月一次) |
p 的值来自正态分布的尾部(查表或用 scipy.stats.norm.sf)。k 每增加 1,误报率降低约 70 到 180 倍,这就是为什么提高阈值的代价很低。
(b) 如果残差相互独立,长度为 n 的连续超限从某个给定样本开始的概率为 p^{n},所以每天预期的连续超限次数为 864{,}000\,p^{n}(各次连续超限重叠的情况很少,这样计数已足够准确)。取 p = 4.65\times10^{-4}:
- n = 2:p^2 = 2.17\times10^{-7},所以每天 0.187 次,即每月 5.6 次:太多;
- n = 3:p^3 = 1.01\times10^{-10},所以每天 8.7\times10^{-5} 次,即每月 0.0026 次:远少于一次。
答案是连续三次超限。代价是两个样本的延迟(10 Hz 下为 0.2 s),在这里微不足道;以及漏掉任何短于三个样本的故障,所以单样本的尖峰不再能被这条规则捕获。这就是每种故障类型都需要自己的检测器的原因(第 9 节)。
(c) 两个理由,都来自第 9 节。残差是自相关的:在某一步出错的预测器往往在下一步以同样的方式出错,所以超限成串出现,p^n 过于乐观。残差还是重尾的:正常运行中包含罕见的瞬态(启动、负荷变化),高斯尾部描述不了它们。第三个理由是 \sigma 本身随运行状态变化。应当改为根据一段很长的留出正常记录上残差的经验分位数来设定阈值,并应用持续性规则,然后在这段记录上实测每天的误报次数。10 Hz 下每月一次的误报率,相当于 30\times864{,}000 = 25.9 百万个样本中出现一次,所以要测出它,需要大约一个月的正常数据,最好是几个月:一天的数据无法区分 10^{-8} 和 10^{-6}。
(d) 跳变为 1.2/0.2 = 6\sigma,所以起始样本会被 4\sigma 检验标记,偏移消失时的末尾样本也会被标记。跳变之后,预测器已经重新居中:它把下一个值预测为最后一个值加上对变化量的预测,所以水平误差一步之后就消失了,偏移再也不会作为水平被看到。剩下的是回波,因为窗口中现在包含一个模型在训练中从未见过的阶跃。所以答案是“起始处一个,再加上阶跃穿过窗口期间的几个”,而不是持续的报警。作为参照,实验 3 注入了 +0.8 的偏移,在那里同样约为 6\sigma(\sigma = 0.131),它的 4\sigma 逐点检验发出 3 次报警,分别在起始处、4 个样本之后和偏移结束处,中间一次也没有。逐点检验只看得到边沿。
要增加的是:对照独立参照的水平检查,这个参照不随传感器移动:冗余传感器、孪生模型的物理预测,或者对照已知运行范围的量程检查。另一种做法是,对一个不会重新居中的模型(预测范围更长的预测器,或不做逐窗口归一化的预测器)的残差做 CUSUM(累积和),累积水平有误的证据。
from scipy.stats import norm

samples_per_day = 10 * 86_400                    # 10 Hz
for k in (3.5, 4.5, 5.5):
    p = 2 * norm.sf(k)                           # two-sided tail probability
    print(f"{k}σ: p = {p:.3e}, false alarms/day = {p * samples_per_day:.3f}")
p = 2 * norm.sf(3.5)
for n in (1, 2, 3):
    per_day = samples_per_day * p ** n           # expected starts of a run of n
    print(f"{n} in a row: {per_day:.3e} per day, {30 * per_day:.4f} per month")
3.5σ: p = 4.653e-04, false alarms/day = 401.983
4.5σ: p = 6.795e-06, false alarms/day = 5.871
5.5σ: p = 3.798e-08, false alarms/day = 0.033
1 in a row: 4.020e+02 per day, 12059.4915 per month
2 in a row: 1.870e-01 per day, 5.6108 per month
3 in a row: 8.702e-05 per day, 0.0026 per month
解释为什么教师强制使 RNN 解码器可以不经采样就得到训练,以及什么是暴露偏差。利用实验 4 中无注意力模型在长度 12 下的数字(教师强制下的 token 准确率为 74%,自由运行下为 53%),解释两者之间的差距,并提出两种补救办法。
查看解答
为什么训练不需要采样。在教师强制下,解码器第 t 步的输入是真实的前一个 token y_{t-1},它可以从数据中得知。因此解码器的每个输入在前向传播开始之前都已可用,每一步的损失都是针对已知目标、在正确前缀上计算的普通交叉熵。不需要先生成什么再去评分,每一步都得到干净的学习信号(第 10 节)。
暴露偏差。在测试时没有真实的前一个 token,所以解码器以它自己的输出为条件。模型只接触过正确的前缀。一个错误的 token 就会把它带进任何训练步骤都没有产生过的状态;它的下一次预测比模型在正确前缀上的准确率所显示的更不可靠,错误会逐步累积。
差距。教师强制下 74% 的准确率意味着,在前缀正确的条件下,26% 的 token 是错的。自由运行下 53% 的准确率意味着 47% 是错的,是前者的 47/26 = 1.8 倍。多出来的错误,是那些跟在先前错误之后的错误:两种测量之间没有其他任何差别。差距随长度增大(长度 4 时基本没有,99.7% 对 99.4%;长度 8 时 91% 对 80%;长度 12 时 74% 对 53%),因为输出越长,前面可能出错的 token 就越多。差距的出现还需要错误能够累积:有注意力时,两种准确率在每个长度上都是 100%,对一个从不出错的模型,暴露偏差没有任何代价。
补救办法。
- 计划采样(scheduled sampling,Bengio 等人 2015):训练时,以一个随训练进程上升的概率,用模型自己的前一个预测代替真实 token 作为输入,使解码器学会从自己的错误中恢复。
- 在模型自己的生成轨迹上训练,或使用序列级目标,对完整生成的输出评分(模块 09 中的强化学习方法)。
- 降低错误率本身:对这个任务,最好的修正是注意力(第 11 节),它消除了导致最初那些错误的瓶颈。
无论采用哪种补救办法,都要以自由运行的方式评估,这是部署时唯一的模式。
一个在 \{A, B, \langle e\rangle\} 上的解码器有 p(y_1) = (A\ 0.45,\ B\ 0.35,\ \langle e\rangle\ 0.20)、p(y_2\mid A) = (A\ 0.40,\ B\ 0.35,\ \langle e\rangle\ 0.25) 和 p(y_2\mid B) = (A\ 0.10,\ B\ 0.75,\ \langle e\rangle\ 0.15)。输出两个 token 之后,它总是输出 \langle e\rangle。
(a) 贪心解码输出什么?概率是多少?
(b) 像第 10 节那样逐步运行 k = 2 的束搜索(在所有扩展中保留最好的 k 个;保留下来的假设若已结束,就放到一边),列出保留的假设及其对数概率。
(c) 按概率对所有完整序列排序。束搜索在这里是精确的吗?一般情况下是精确的吗?
(d) 计算概率最高的三个序列的长度归一化得分(对数概率除以长度,\langle e\rangle 计入长度)。排序是否改变?
查看解答
(a) 贪心解码在每一步取最可能的 token。第 1 步:A(0.45)。在 A 之后:A(0.40)。两个 token 之后:\langle e\rangle(概率 1)。输出为 AA\langle e\rangle,概率为 0.45\times0.40\times1 = 0.18。
(b) 先取对数:\ln 0.45 = -0.799,\ln 0.35 = -1.050,\ln 0.20 = -1.609。
第 1 步。空前缀的三个扩展是 A(-0.799)、B(-1.050)和 \langle e\rangle(-1.609)。保留最好的两个,A 和 B;空输出 \langle e\rangle 被剪掉。
第 2 步。用每个 token 扩展 A 和 B,按累积概率给这六个扩展打分:
| 扩展 | 概率 | \ln p |
|---|---|---|
| BB | 0.35\times0.75 = 0.2625 | -1.338 |
| AA | 0.45\times0.40 = 0.18 | -1.715 |
| AB | 0.45\times0.35 = 0.1575 | -1.848 |
| A\langle e\rangle | 0.45\times0.25 = 0.1125 | -2.185(已结束) |
| B\langle e\rangle | 0.35\times0.15 = 0.0525 | -2.947(已结束) |
| BA | 0.35\times0.10 = 0.035 | -3.352 |
保留最好的两个:BB 和 AA。两者都没有结束。
第 3 步。每个都只能输出 \langle e\rangle(概率 1),所以 BB\langle e\rangle 的 \ln p = -1.338,AA\langle e\rangle 为 -1.715。两者都结束,束变空。最好的已结束假设是 BB\langle e\rangle,概率为 0.2625,是贪心解码答案的 0.2625/0.18 = 1.46 倍。贪心解码在第 1 步选定了 A,因为它的首 token 概率更高;以 B 开头的序列有好得多的后续,而 k = 2 的束搜索能看到这一点。
(c) 全部七个完整序列,由上面的概率以及单独的 \langle e\rangle(0.20)得到:
| 名次 | 序列 | 概率 |
|---|---|---|
| 1 | BB\langle e\rangle | 0.2625 |
| 2 | \langle e\rangle | 0.2000 |
| 3 | AA\langle e\rangle | 0.1800 |
| 4 | AB\langle e\rangle | 0.1575 |
| 5 | A\langle e\rangle | 0.1125 |
| 6 | B\langle e\rangle | 0.0525 |
| 7 | BA\langle e\rangle | 0.0350 |
它们之和为 1,理应如此。束搜索在这里找到了最好的序列,因为它的首 token B 在第 1 步位列前二。它一般并不精确:它在第 1 步剪掉了概率第二高的序列,即空输出 \langle e\rangle;任何序列,只要它的前缀在某一步掉出前 k 名,就永远丢失了,无论它的后续有多好。在 k = 1(贪心)时,它在这里丢掉了最好的序列。(如果一种实现不把已结束的假设计入束的名额,就会把 \langle e\rangle 保留为一个已结束的候选。它仍会返回 BB\langle e\rangle,但按前缀剪枝的原理是一样的。)
(d) 把对数概率除以以 token 计的长度,\langle e\rangle 计入长度:
- BB\langle e\rangle:-1.338/3 = -0.446;
- \langle e\rangle:-1.609/1 = -1.609;
- AA\langle e\rangle:-1.715/3 = -0.572。
排序改变了:空输出在这三个序列中从第二位降到第三位(在全部七个序列中降到最后一位,-1.609,而其他序列在 -0.446 到 -1.473 之间)。对数概率之和偏向短输出,因为每个 token 都把概率乘以一个小于 1 的数;按长度归一化纠正了这一偏向(第 10 节)。它是不是正确的纠正,取决于任务:空输出可能恰恰就是想要的。
import math

# p(next token | prefix); after two tokens the decoder always emits <e> (written "e")
P = {"": {"A": 0.45, "B": 0.35, "e": 0.20},
     "A": {"A": 0.40, "B": 0.35, "e": 0.25},
     "B": {"A": 0.10, "B": 0.75, "e": 0.15}}

def next_probs(prefix):
    return P[prefix] if len(prefix) < 2 else {"e": 1.0}

def beam_search(k, show=False):
    beam, finished = [("", 0.0)], []
    while beam:
        cand = [(s + t, lp + math.log(p))
                for s, lp in beam for t, p in next_probs(s).items()]
        cand = sorted(cand, key=lambda c: -c[1])[:k]         # keep the k best of all
        if show:
            print("  kept:", ", ".join(f"{s} {lp:.3f}" for s, lp in cand))
        finished += [c for c in cand if c[0].endswith("e")]  # set finished ones aside
        beam = [c for c in cand if not c[0].endswith("e")]
    return max(finished, key=lambda c: c[1])

for k in (1, 2):
    print(f"k = {k}")
    seq, lp = beam_search(k, show=True)
    print(f"  best finished: {seq}  p = {math.exp(lp):.4f}  ln p = {lp:.3f}")
k = 1
  kept: A -0.799
  kept: AA -1.715
  kept: AAe -1.715
  best finished: AAe  p = 0.1800  ln p = -1.715
k = 2
  kept: A -0.799, B -1.050
  kept: BB -1.338, AA -1.715
  kept: BBe -1.338, AAe -1.715
  best finished: BBe  p = 0.2625  ln p = -1.338
k = 1 的运行就是贪心解码,重现了 (a);k = 2 的运行重现了 (b)。
编码器状态为 \mathbf{h}_1 = (1, 1)、\mathbf{h}_2 = (2, 0)、\mathbf{h}_3 = (0, -1)。
(a) 用点积打分,解码器状态 \mathbf{s} = (1, 0),计算得分、注意力权重和上下文向量。
(b) 对 \mathbf{s} = (3, 0) 重做一遍。什么变了?为什么这对训练很重要?
(c) 把 (b) 与模块 06 中的 1/\sqrt{d_k} 因子联系起来。
(d) 用加性注意力,\mathbf{W}_a = \mathbf{I}、\mathbf{U}_a = \begin{bmatrix}1 & 0\\ 0.5 & -0.5\end{bmatrix}、\mathbf{v}_a = (1, 0.5),\mathbf{s}_{t-1} = (-0.5, 0.5),计算权重和上下文。
查看解答
(a) 注释向量 j 的得分是点积 e_j = \mathbf{s}^\top\mathbf{h}_j:e_1 = 1\cdot1 + 0\cdot1 = 1,e_2 = 1\cdot2 + 0 = 2,e_3 = 0。所以 e = (1, 2, 0)。softmax:\exp(e) = (2.7183,\ 7.3891,\ 1),和为 11.1073,所以
上下文是各注释向量的加权平均(算术以全精度进行,所以用舍入后的权重重新计算,最后一位可能不同):
(b) 当 \mathbf{s} = (3, 0) 时,得分为 (3, 6, 0),是原来的三倍。于是 \exp(e) = (20.086,\ 403.43,\ 1),和为 424.51,所以
方向相同、长度变为三倍,使分布尖锐得多:95% 的权重落在 \mathbf{h}_2 上,而原来是 67%。把每个得分乘以 3,等同于把 softmax 的温度除以 3。这对训练很重要,因为 softmax 会饱和:权重对得分的敏感度为 \partial\alpha_j/\partial e_j = \alpha_j(1 - \alpha_j),在 (a) 中为 (0.185,\ 0.223,\ 0.082),在 (b) 中为 (0.045,\ 0.047,\ 0.0024)。对第三个注释向量,梯度缩小了 35 倍。饱和的 softmax 几乎不向打分网络或产生这些得分的状态传递梯度,训练就会停滞。
(c) 对宽度为 d_k 的查询和键,若各分量相互独立、均值为零、方差为 1,则点积 \sum_i q_ik_i 的方差为 \sum_i\mathbb{E}[q_i^2]\,\mathbb{E}[k_i^2] = d_k。因此典型的得分按 \sqrt{d_k} 增长,宽模型在初始化时就处于 (b) 那样的饱和区,梯度趋于消失。把得分除以 \sqrt{d_k},无论宽度如何都能恢复单位方差(模块 06)。对 20,000 个随机对的模拟给出 d = 4、64 和 1,024 时的方差分别为 4.0、64.5 和 1,023.5(脚本见下),而像这里这样宽度为 2 时,得分的标准差只有 \sqrt2,所以要显现这一效应,需要像因子 3 这样的夸大。
(d) 加性注意力为 e_j = \mathbf{v}_a^\top\tanh(\mathbf{W}_a\mathbf{s}_{t-1} + \mathbf{U}_a\mathbf{h}_j)(第 11 节)。分步计算:
- \mathbf{W}_a\mathbf{s}_{t-1} = \mathbf{s}_{t-1} = (-0.5, 0.5),因为 \mathbf{W}_a = \mathbf{I}。
- \mathbf{U}_a\mathbf{h}_j:对 \mathbf{h}_1 = (1, 1),为 (1,\ 0.5 - 0.5) = (1, 0);对 \mathbf{h}_2 = (2, 0),为 (2, 1);对 \mathbf{h}_3 = (0, -1),为 (0, 0.5)。(这些乘积与 t 无关,所以实际实现中对每个源序列只计算一次。)
- 激活前的值,即两者之和:(0.5, 0.5)、(1.5, 1.5)、(-0.5, 1.0)。
- 经过 tanh 之后:(0.4621, 0.4621)、(0.9051, 0.9051)、(-0.4621, 0.7616)。
- 得分 e_j = \tanh_1 + 0.5\tanh_2:0.4621 + 0.2311 = 0.6932;0.9051 + 0.4526 = 1.3577;-0.4621 + 0.3808 = -0.0813。
- softmax:\exp(e) = (2.0000,\ 3.8873,\ 0.9219),和为 6.8093,所以 \alpha = (0.2937,\ 0.5709,\ 0.1354)。
- 上下文:0.2937\,(1, 1) + 0.5709\,(2, 0) + 0.1354\,(0, -1) = (0.2937 + 1.1418,\ 0.2937 - 0.1354) = (1.4355,\ 0.1583)。
权重之和为 1,上下文位于各注释向量之间,理应如此。
import numpy as np

H = np.array([[1, 1], [2, 0], [0, -1]], float)         # rows are h_1, h_2, h_3

def softmax(e):
    e = np.exp(e - e.max())
    return e / e.sum()

for s in ([1, 0], [3, 0]):
    s = np.array(s, float)
    e = H @ s                                          # dot-product scores
    a = softmax(e)
    print(f"s = {s}: e = {e}, alpha = {a.round(4)}, context = {(a @ H).round(4)}, "
          f"alpha(1-alpha) = {(a * (1 - a)).round(4)}")

W_a, U_a, v_a = np.eye(2), np.array([[1, 0], [0.5, -0.5]]), np.array([1, 0.5])
s_prev = np.array([-0.5, 0.5])
pre = H @ U_a.T + W_a @ s_prev                        # U_a h_j + W_a s_{t-1}
e = np.tanh(pre) @ v_a
a = softmax(e)
print("additive: e =", e.round(4), " alpha =", a.round(4),
      " context =", (a @ H).round(4))

rng = np.random.default_rng(0)
for d in (4, 64, 1024):
    q, k = rng.standard_normal((20000, d)), rng.standard_normal((20000, d))
    print(f"d = {d:4d}: variance of q.k = {(q * k).sum(axis=1).var():.1f}")
s = [1. 0.]: e = [1. 2. 0.], alpha = [0.2447 0.6652 0.09  ], context = [1.5752 0.1547], alpha(1-alpha) = [0.1848 0.2227 0.0819]
s = [3. 0.]: e = [3. 6. 0.], alpha = [0.0473 0.9503 0.0024], context = [1.948 0.045], alpha(1-alpha) = [0.0451 0.0472 0.0024]
additive: e = [ 0.6932  1.3577 -0.0813]  alpha = [0.2937 0.5709 0.1354]  context = [1.4355 0.1583]
d =    4: variance of q.k = 4.0
d =   64: variance of q.k = 64.5
d = 1024: variance of q.k = 1023.5
各用两句话回答:为什么循环神经网络不能在时间上并行训练,而 Transformer 可以?然后,不必计算大小:生成过程中,一条序列从 4,096 个 token 增长到 32,768 个 token。LSTM 每条序列的状态增长多少倍?Transformer 的 KV cache 增长多少倍?这对一个加速器的显存能同时容纳的序列数意味着什么?
查看解答
循环神经网络。状态 \mathbf{h}_t 是 \mathbf{h}_{t-1} 的非线性函数,所以第 t 步必须等第 t-1 步完成后才能开始。教师强制使输入提前已知,但并不能打破这条链:无论有多少处理器空闲,这 T 步仍是一个相互依赖的序列(第 12 节)。
Transformer。在一层之内,每个位置依赖的是该层的输入,而教师强制使这些输入已知;它不依赖于同一层其他位置的输出。因此所有位置可以一起计算,每层一次带掩码的矩阵运算(模块 06)。
状态与缓存。LSTM 每层保存一个固定的 (\mathbf{h}, \mathbf{c}),无论上下文多长:倍数为 1。KV cache 为每个过去的 token 存储一个键和一个值,所以它与上下文成正比增长:倍数为 $32{,}768/4{,}096 = $ 8。在第 12 节的例子中,缓存在 4,096 个 token 时为 0.81 GB,在 32,768 个 token 时为 6.44 GB。
后果。对于存放权重之后剩余的固定显存预算,同时处理的序列数等于预算除以每条序列的状态。LSTM 在任何长度下都能容纳同样多的序列。如果缓存占主导,Transformer 在 32,768 个 token 时能容纳的序列数只有 4,096 个 token 时的八分之一。这就是第 12 节的权衡:Transformer 在训练中得到的好处,要在推理时付出代价,模块 10 推导了它对部署服务的影响。
(a) 对 h_t = 0.8\,h_{t-1} + x_t、y_t = 2h_t、h_0 = 0 和 x = (2, -1, 0, 1),先用递推、再用与卷积核 K_k = c\,a^k b 的卷积计算 y;说明两者一致。
(b) 连续系统 \mathrm{d}h/\mathrm{d}t = -0.5\,h + x(t) 用步长为 \Delta 的零阶保持进行离散化。对 \Delta = 0.1、1 和 5 计算 a 和 b,在 \Delta = 1 和 \Delta = 5 时与前向欧拉法比较,并解释 \Delta 的含义。
(c) 对复模态 \lambda = 0.98\,e^{i\pi/12},给出其卷积核的半衰期和振荡周期。
(d) 为什么让 \Delta 依赖于 x_t(如 Mamba 那样)会去掉卷积形式?那么用什么来并行地计算这个递推?
查看解答
(a) 该递推有 a = 0.8、b = 1 和 c = 2。
- h_1 = 0.8\cdot0 + 2 = 2,所以 y_1 = 4;
- h_2 = 0.8\cdot2 + (-1) = 0.6,所以 y_2 = 1.2;
- h_3 = 0.8\cdot0.6 + 0 = 0.48,所以 y_3 = 0.96;
- h_4 = 0.8\cdot0.48 + 1 = 1.384,所以 y_4 = 2.768。
用卷积:展开递推得 h_t = \sum_{k=0}^{t-1}a^k b\,x_{t-k},因此 y_t = \sum_k K_k\,x_{t-k},其中 K_k = c\,a^kb = 2\times0.8^k,即 K = (2,\ 1.6,\ 1.28,\ 1.024)。于是
- y_1 = K_0x_1 = 2\cdot2 = 4;
- y_2 = K_0x_2 + K_1x_1 = -2 + 3.2 = 1.2;
- y_3 = K_0x_3 + K_1x_2 + K_2x_1 = 0 - 1.6 + 2.56 = 0.96;
- y_4 = K_0x_4 + K_1x_3 + K_2x_2 + K_3x_1 = 2 + 0 - 1.28 + 2.048 = 2.768。
两者一致,理应如此:卷积就是展开后的递推。递推每步只需一次乘加,但必须顺序执行;卷积对每个输出是一个求和,可以并行计算(卷积核很长时用 FFT),而它之所以可行,是因为 a、b 和 c 在每一步都相同(第 13 节)。
(b) 在长度为 \Delta 的一步内保持输入不变(零阶保持),求解 \mathrm{d}h/\mathrm{d}t = -\lambda h + x,其中 \lambda = 0.5:
前向欧拉法把指数换成它的一阶展开:a = 1 - 0.5\Delta,b = \Delta。
| \Delta | 零阶保持 a | 零阶保持 b | 前向欧拉 a | 前向欧拉 b |
|---|---|---|---|---|
| 0.1 | 0.9512 | 0.0975 | 0.95 | 0.1 |
| 1 | 0.6065 | 0.7869 | 0.5 | 1 |
| 5 | 0.0821 | 1.8358 | -1.5 | 5 |
在 \Delta = 0.1 时两种格式几乎一致。在 \Delta = 1 时欧拉法已经不准确(0.5 对 0.6065)。在 \Delta = 5 时欧拉法给出 a = -1.5:|a| > 1,对一个稳定的系统给出了不稳定的递推。这里欧拉法只在 \Delta < 4 时稳定(条件为 |1 - 0.5\Delta| < 1)。零阶保持对任何 \Delta 都把稳定的连续极点映射为 |a| < 1,这就是状态空间模型用它来离散化的原因。
\Delta 的含义。它是系统在两次采样之间被允许演化的时间。小的 \Delta 保留状态(a 接近 1),写入很少(b 很小);大的 \Delta 遗忘(a 接近 0),写入很多。由于 \lambda b = 1 - a,更新为 h_t = a\,h_{t-1} + (1 - a)\,(x_t/\lambda),是旧状态与缩放后输入的凸组合,遗忘的多少由 \Delta 设定:这恰好是 GRU 更新的形式(第 6 节)。\Delta 起到了门的作用。
(c) 该模态的卷积核为 \lambda^k = 0.98^k e^{ik\pi/12},其实部为 0.98^k\cos(k\pi/12)。包络 0.98^k 在 0.98^k = 0.5 时减半,即在 k = \ln0.5/\ln0.98 = 34.3 步处。余弦在 k\pi/12 = 2\pi 时重复,所以周期为 2\pi/(\pi/12) = 24 步。这个模态是一个阻尼振荡,其包络每 34.3 步减半,约合 1.4 个振荡周期,这正是学到的共振的样子(第 13 节)。
(d) 只有当 \bar A、\bar B 和 C 在每一步都相同时,才存在单一的卷积核 K_k = C\bar A^kB。当 \Delta_t 依赖于 x_t 时,\bar A_t = e^{-\lambda\Delta_t} 每一步都不同,输入 s 对输出 t 的影响是乘积 \bar A_t\bar A_{t-1}\cdots\bar A_{s+1},对每一对 (s, t) 都不同。没有哪一个 K_k 序列能描述它。不过,递推 h_t = a_th_{t-1} + b_t 仍然对 h 是线性的,而线性递推的复合满足结合律:一步就是一对 (a_t, b_t),先应用 (a_1, b_1) 再应用 (a_2, b_2) 得到 h \mapsto a_2(a_1h + b_1) + b_2,即一对 (a_2a_1,\ a_2b_1 + b_2)。满足结合律的运算可以按树的方式求值,所以并行扫描在 O(\log T) 轮内算出全部 T 个状态(第 13 节)。下面的脚本对 (a)、(b) 和 (c) 做数值核对,然后把一个 a_t 依赖于输入的扫描与顺序循环进行比较。
import numpy as np

x = np.array([2.0, -1.0, 0.0, 1.0])
a, b, c = 0.8, 1.0, 2.0
h, y_rec = 0.0, []
for xt in x:
    h = a * h + b * xt                                 # recurrence
    y_rec.append(c * h)
K = np.array([c * a ** k * b for k in range(len(x))])  # kernel K_k = c a^k b
y_conv = [sum(K[k] * x[t - k] for k in range(t + 1)) for t in range(len(x))]
print("recurrence:", np.round(y_rec, 4), " kernel:", K,
      " convolution:", np.round(y_conv, 4))

lam = 0.5                                              # dh/dt = -lam h + x(t)
for delta in (0.1, 1.0, 5.0):
    a_zoh = np.exp(-lam * delta)
    b_zoh = (1 - a_zoh) / lam
    print(f"delta = {delta}: ZOH a = {a_zoh:.4f}, b = {b_zoh:.4f}; "
          f"Euler a = {1 - lam * delta:.4f}, b = {delta:.4f}")
mode = 0.98 * np.exp(1j * np.pi / 12)
print(f"|lambda| = {abs(mode):.2f}, half-life = {np.log(0.5) / np.log(abs(mode)):.1f} "
      f"steps, period = {2 * np.pi / np.angle(mode):.1f} steps")
recurrence: [4.    1.2   0.96  2.768]  kernel: [2.    1.6   1.28  1.024]  convolution: [4.    1.2   0.96  2.768]
delta = 0.1: ZOH a = 0.9512, b = 0.0975; Euler a = 0.9500, b = 0.1000
delta = 1.0: ZOH a = 0.6065, b = 0.7869; Euler a = 0.5000, b = 1.0000
delta = 5.0: ZOH a = 0.0821, b = 1.8358; Euler a = -1.5000, b = 5.0000
|lambda| = 0.98, half-life = 34.3 steps, period = 24.0 steps
import numpy as np

def recurrence(a, b):
    """h_t = a_t h_{t-1} + b_t with h_0 = 0, one step after another."""
    h, out = 0.0, []
    for at, bt in zip(a, b):
        h = at * h + bt
        out.append(h)
    return np.array(out)

def scan(a, b):
    """Same result in ceil(log2 T) rounds; each round combines (a, b) pairs with
    (a2, b2) after (a1, b1) = (a2 * a1, a2 * b1 + b2), which is associative."""
    a, b, shift = a.copy(), b.copy(), 1
    rounds = 0
    while shift < len(a):
        a_prev = np.concatenate([np.ones(shift), a[:-shift]])    # identity pair
        b_prev = np.concatenate([np.zeros(shift), b[:-shift]])   # for t < shift
        b, a = a * b_prev + b, a * a_prev
        shift *= 2
        rounds += 1
    return b, rounds

rng = np.random.default_rng(0)
T = 37
delta = rng.uniform(0.05, 2.0, T)           # input-dependent step sizes
a = np.exp(-0.5 * delta)                    # a_t = exp(-lambda * delta_t), lambda = 0.5
b = (1 - a) / 0.5 * rng.standard_normal(T)  # b_t * x_t
h_loop = recurrence(a, b)
h_scan, rounds = scan(a, b)
print(f"max difference {np.abs(h_loop - h_scan).max():.2e} after {rounds} rounds "
      f"instead of {T} steps")
max difference 4.44e-16 after 6 rounds instead of 37 steps
六轮代替了 37 个顺序步骤;对 T = 100{,}000,将是 17 轮。
为每种情形选择一种序列模型,并用一两句话说明理由。
(a) 在一块有 64 KiB RAM 的微控制器上,根据 1 kHz 的加速度计数据在设备端检测轴承故障,依赖关系长达 2 s。
(b) 离线地把上个月 50,000 行工厂日志中的每个事件标记为常规或异常。
(c) 根据四年的历史,预测一栋建筑未来三周的每日能耗。
(d) 一个处理 100,000 个传感器样本长的序列的模型,序列在所有尺度上都有结构,在 GPU 上训练。
查看解答
决策取决于情形的四个性质:在线还是离线,每步有多少内存和计算,依赖关系有多长,以及有多少数据(第 12 节)。
(a) 一个小型 GRU 或 LSTM,或一个对角线性循环,以循环模式运行。状态是恒定的,至多几 kB(H = 64 的 fp32 GRU 保存 64\times4 = 256 B),每个样本的计算开销都同样很小。其他方案所需的内存都超过设备所有。覆盖 1 kHz 下 2 s 的时间卷积网络需要 2,000 个样本的感受野:卷积核大小为 2、空洞为 1 到 1024 时得到 1 + 2{,}047 = 2{,}048,而对它做流式处理,每层需要 (k-1)d 个样本的缓冲区,每个通道合计 2{,}047 个样本。16 个通道、fp32 时为 2{,}047\times16\times4 = 131{,}008 B,约 128 KiB,是 RAM 的两倍;int8 时为 32.8 kB,是 RAM 的一半。Transformer 在 2,000 个样本上的缓存,若有两层、宽度 32、int8,则为 2\times2\times2{,}000\times32 = 256{,}000 B,约 250 KiB。(这些都是按上述大小手算的。)普通的循环网络在 1 kHz 原始样本上学不到 2,000 步的滞后,所以还要降低速率(比如说每 20 ms 一帧的特征),或使用 |\lambda| 接近 1 的线性循环(第 13 节)。
(b) 在日志的窗口上使用双向 LSTM 或 Transformer 编码器。任务是离线的,所以每一行的标签可以利用两侧的行(第 6 节);应当先做一个基线,例如基于行特征的逻辑回归(模块 01),以弄清上下文带来多少增益。
(c) 先做基线:季节性朴素预测(以周为周期)和带日历特征的线性模型;只有当神经网络预测器在前向滚动验证的各折上胜过它们时才使用它。四年的每日数据约有 1,460 个样本,要训练一个深度模型去胜过精心选择的线性模型,数据远远不够,而三周的预测范围只能留出寥寥几个独立的测试块(第 8 节)。
(d) 状态空间模型或线性循环的堆叠,或者采用高效注意力变体的 Transformer。线性循环以卷积模式或扫描模式训练,时间与长度成线性关系,并通过具有不同 \lambda 的模态覆盖所有尺度上的结构(第 13 节)。普通的 LSTM 会是一个 100,000 步的串行循环;完全注意力每层每个头要计算 T^2 = 10^{10} 个得分(第 12 节)。
在实验 3 的预测器中,把 LSTM 换成时间卷积网络(TCN;第 12 节):卷积核大小为 2、空洞为 1、2、4、8、16、32 的因果一维卷积(模块 03),32 个通道,ReLU,层与层之间有残差连接(第一个残差用一个 1\times1 卷积把单个输入通道提升到 32 个),在最后一个时间步上接一个线性头。保留逐窗口归一化。在同样的四个前向滚动验证折上,用同样的优化器、batch 大小和轮数训练它。
报告:(a) 感受野的计算;(b) 参数量,与 LSTM 的 12,961 比较;(c) 各折一步 RMSE 的均值 \pm 标准差,与 LSTM 和线性基线比较;(d) 两个网络每折的训练时间;(e) 用一段话说明你会在什么时候选择哪一个。
查看解答
方案。设置与实验 3 相同:64 个样本的窗口和一步目标;各折的起点为 4,000、5,000、6,000 和 7,000,每折在其后的 1,000 个样本上验证;序列用每折训练部分的统计量做 z 分数标准化,再减去窗口的最后一个值。数据是实验 3 中的渐硬支座(Duffing 振子)信号,这里重复给出,使脚本自成一体。TCN 中重要的选择有两个。
- 因果性。卷积核为 2、空洞为 d 的卷积查看位置 t 和 t - d。在左侧填充 (k-1)d 个零,使输出长度保持为 64,并使 t 处的输出只依赖于 \le t 的输入。两侧都填充,会让输出读到窗口内的未来。
- 残差。每层的输出为 \text{ReLU}(\text{conv}(\cdot)) + \text{跳跃}。一旦通道数为 32,跳跃路径就是恒等映射;但第一层从 1 个通道变为 32 个,所以它的跳跃路径是一个 1\times1 卷积(即“提升”)。
(a) 感受野。卷积核为 k、空洞为 d_l 时,TCN 看到 1 + (k-1)\sum_l d_l 个样本(第 12 节)。这里 1 + 1\cdot(1 + 2 + 4 + 8 + 16 + 32) = 1 + 63 = 64,恰好是一个窗口。每一层把覆盖范围加倍。层数更少,最老的样本就用不上;第七层(空洞 64)会伸到窗口之外,只读到填充。
(b) 参数量。手算:第一个卷积有 1\times32\times2 个权重和 32 个偏置,共 96。其余五个各有 32\times32\times2 + 32 = 2{,}080,五个共 10{,}400。1\times1 提升为 1\times32 + 32 = 64。头部为 32 + 1 = 33。总数为 96 + 10{,}400 + 64 + 33 = 10{,}593,而 LSTM 为 12,961(第 5 节):少 18%。
代码。脚本在四折上运行两个网络和线性基线。SEED(第一个命令行参数)设定权重初始化和 batch 的顺序。
import math
import sys
import time

import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F

SEED = int(sys.argv[1]) if len(sys.argv) > 1 else 0
torch.set_num_threads(4)
W = 64                                           # window length, as in Lab 3


def simulate(n=8000, seed=0):
    """Stiffening mount (Duffing oscillator) under periodic + random forcing."""
    rng = np.random.default_rng(seed)
    w0, zeta, k3, amp, sig_f, dt, sub = math.pi, 0.05, 40.0, 3.0, 3.0, 0.01, 10
    kicks = rng.standard_normal(n * sub)
    x = v = 0.0
    out = np.empty(n)
    for i in range(n * sub):
        acc = (-2 * zeta * w0 * v - w0 ** 2 * x - k3 * x ** 3
               + amp * math.sin(2 * math.pi * i * dt / 5.0))
        v += dt * acc + sig_f * math.sqrt(dt) * kicks[i]
        x += dt * v
        if (i + 1) % sub == 0:
            out[(i + 1) // sub - 1] = x
    return out + 1e-3 * np.arange(n) + 0.05 * rng.standard_normal(n)


def windows(z, lo, hi):
    """Inputs z[t-W:t] and targets z[t] for every t in [lo, hi)."""
    idx = np.arange(lo, hi)
    X = np.stack([z[t - W:t] for t in idx])[:, :, None]
    X = torch.tensor(X, dtype=torch.float32)
    return X, torch.tensor(z[idx], dtype=torch.float32)


class LSTMForecaster(nn.Module):
    def __init__(self, hidden=32):
        super().__init__()
        self.lstm = nn.LSTM(1, hidden, num_layers=2, dropout=0.1, batch_first=True)
        self.head = nn.Linear(hidden, 1)

    def forward(self, x):                        # x: (B, 64, 1)
        last = x[:, -1:, :]                      # per-window normalisation
        out, _ = self.lstm(x - last)
        return self.head(out[:, -1]).squeeze(-1) + last[:, 0, 0]


class TCNForecaster(nn.Module):
    def __init__(self, channels=32, dilations=(1, 2, 4, 8, 16, 32), k=2):
        super().__init__()
        self.k, self.dilations = k, dilations
        self.convs = nn.ModuleList(
            nn.Conv1d(1 if i == 0 else channels, channels, k, dilation=d)
            for i, d in enumerate(dilations))
        self.lift = nn.Conv1d(1, channels, 1)    # 1x1 conv: skip path of layer 1
        self.head = nn.Linear(channels, 1)

    def forward(self, x):
        last = x[:, -1:, :]
        h = (x - last).transpose(1, 2)           # (B, 1, 64): channels first
        for i, (conv, d) in enumerate(zip(self.convs, self.dilations)):
            y = F.relu(conv(F.pad(h, ((self.k - 1) * d, 0))))  # left pad: causal
            h = y + (self.lift(h) if i == 0 else h)             # residual
        return self.head(h[:, :, -1]).squeeze(-1) + last[:, 0, 0]


def train(model, X, y, epochs=10, bs=128, lr=3e-3):
    gen = torch.Generator().manual_seed(SEED)
    opt = torch.optim.AdamW(model.parameters(), lr=lr)
    for _ in range(epochs):
        model.train()
        perm = torch.randperm(len(X), generator=gen)
        for i in range(0, len(X), bs):
            b = perm[i:i + bs]
            loss = F.mse_loss(model(X[b]), y[b])
            opt.zero_grad()
            loss.backward()
            nn.utils.clip_grad_norm_(model.parameters(), 1.0)
            opt.step()


def rmse(model, X, y, sd):
    model.eval()
    with torch.no_grad():
        return float((model(X) - y).pow(2).mean().sqrt()) * sd


def linear_rmse(Xtr, ytr, Xva, yva, sd):
    def feats(X):
        X = X[:, :, 0].numpy()
        return np.hstack([X - X[:, -1:], np.ones((len(X), 1))]), X[:, -1]
    Ftr, ltr = feats(Xtr)
    Fva, lva = feats(Xva)
    coef = np.linalg.lstsq(Ftr, ytr.numpy() - ltr, rcond=None)[0]
    return float(np.sqrt(((Fva @ coef + lva - yva.numpy()) ** 2).mean())) * sd


series = simulate()
dil = (1, 2, 4, 8, 16, 32)
print("receptive field:", 1 + (2 - 1) * sum(dil), "samples")
rows = []
for origin in (4000, 5000, 6000, 7000):
    mu, sd = series[:origin].mean(), series[:origin].std()
    z = (series - mu) / sd                      # statistics of the training part only
    Xtr, ytr = windows(z, W, origin)
    Xva, yva = windows(z, origin, origin + 1000)
    row = [linear_rmse(Xtr, ytr, Xva, yva, sd)]
    for cls in (LSTMForecaster, TCNForecaster):
        torch.manual_seed(SEED)
        model = cls()
        t0 = time.perf_counter()
        train(model, Xtr, ytr)
        seconds = time.perf_counter() - t0
        row += [rmse(model, Xva, yva, sd), seconds]
        n_par = sum(p.numel() for p in model.parameters())
        if origin == 4000:
            print(f"{cls.__name__}: {n_par:,} parameters")
    rows.append(row)
    print(f"origin {origin}: linear {row[0]:.3f}  LSTM {row[1]:.3f} ({row[2]:.1f} s)"
          f"  TCN {row[3]:.3f} ({row[4]:.1f} s)")
rows = np.array(rows)
mean, std = rows.mean(0), rows.std(0)
print(f"linear {mean[0]:.3f} +- {std[0]:.3f}")
print(f"LSTM   {mean[1]:.3f} +- {std[1]:.3f}   {mean[2]:.1f} s per fold")
print(f"TCN    {mean[3]:.3f} +- {std[3]:.3f}   {mean[4]:.1f} s per fold")
print(f"TCN training time is {100 * (1 - mean[4] / mean[2]):.0f}% shorter")
receptive field: 64 samples
LSTMForecaster: 12,961 parameters
TCNForecaster: 10,593 parameters
origin 4000: linear 0.166  LSTM 0.139 (8.8 s)  TCN 0.137 (5.6 s)
origin 5000: linear 0.148  LSTM 0.130 (9.0 s)  TCN 0.127 (6.6 s)
origin 6000: linear 0.151  LSTM 0.134 (10.2 s)  TCN 0.134 (8.4 s)
origin 7000: linear 0.154  LSTM 0.134 (12.8 s)  TCN 0.137 (9.4 s)
linear 0.155 +- 0.007
LSTM   0.134 +- 0.003   10.2 s per fold
TCN    0.134 +- 0.004   7.5 s per fold
TCN training time is 27% shorter
参数量 12,961 和 10,593 与手算一致。标准差只基于四折(总体形式,ddof=0),所以它描述的是各折之间的离散程度,而不是置信区间。
(c) 准确率。以信号自身的单位计,一步 RMSE 对 TCN 为 0.134\pm0.004,对 LSTM 为 0.134\pm0.003,对线性自回归为 0.155\pm0.007。TCN 与 LSTM 打成平手,比线性基线好约 14%,而要证明使用任何网络是合理的,都必须先胜过这个基线(第 8 节)。两个网络是打平而不是分出高下,这一点通过换用其他种子重复运行得到证明。种子 1 给出 TCN 0.132\pm0.004 对 LSTM 0.138\pm0.006;种子 2 给出 TCN 0.134\pm0.004 对 LSTM 0.134\pm0.006(线性基线不依赖于种子)。三个种子下两个网络之差分别为 0.000、-0.006 和 0.000,不大于各折之间的离散程度。两个网络都以在各种子间稳定的幅度胜过线性模型,因为渐硬弹簧是非线性的。你自己的数字在最后一位会有所不同。
(d) 训练时间。每折 LSTM 用时 8.8 到 12.8 s(平均 10.2 s),TCN 用时 5.6 到 9.4 s(平均 7.5 s),少 27%。在同一台机器上反复运行,RMSE 完全相同,节省的比例在约 10% 到 50% 之间,取决于机器上同时还在做什么。用时从第一折到最后一折逐渐上升,因为训练集从 3,936 个窗口增长到 6,936 个。计时取决于机器的负载,所以要看比值,而不是秒数。节省并非来自更少的算术运算。手算乘加次数,TCN 每个窗口用 64\times2\times32 + 5\times64\times2\times32\times32 + 64\times32 = 661{,}504 次,两层 LSTM 用 64\times(4\times32\times33 + 4\times32\times64) = 794{,}624 次:大致相当。节省来自结构:TCN 用一次卷积算出每层全部 64 个位置,共六次大运算,而 LSTM 每层要运行 64 个相互依赖的步骤,共 128 次小运算(第 12 节)。在 GPU 上,小运算会让硬件闲置,差距更大。
(e) 什么时候选择哪一个。当所需的依赖长度已知且有界(这里是 64 个样本,足以覆盖负载 50 个样本的周期)、训练速度很重要、并且固定长度的窗口很自然时,选择 TCN。它在时间上并行训练,通往任一输入的梯度路径至多六层长。它的局限是感受野固定,早于 64 个样本的任何内容都无法影响输出,要覆盖更长的范围就要更多层;以及流式部署更麻烦:它可以流式运行,但每个空洞层级都需要一个缓冲区。当依赖长度未知或非常长,或者模型必须以很小的恒定状态逐步运行时,例如在练习 14(a) 的微控制器上,选择 LSTM(或线性循环,第 13 节)。由于每步计算量恒定,它是实时数据流的天然监测器。在这里,两者准确率打平,决策取决于工程约束,而不是指标。
自测题
共 12 道题,每题只有一个正确答案。先不回看正文作答,再读每一条解析,包括你排除的那些选项的解析,因为每个错误选项都是人们真实会犯的错误。
nn.LSTM(10, 20) 有多少个参数?nn.GRU(10, 20),三个块:3\cdot20\cdot30 + 3\cdot20\cdot2 = 1{,}920。640 是普通的 nn.RNN(10, 20),一个块:20\cdot30 + 2\cdot20 = 640。论文导读
读论文要读两遍,而不是一遍。第一遍用五到十分钟,并不是通常意义上的阅读:读标题、摘要和引言、各节标题、每一张图及其说明,以及结论。然后用自己的话写下三件事:论文要解决什么问题,它声称做到了什么,以及哪张图或哪个表是证据。如果写不出来,说明这篇论文暂时还不值得读第二遍,或者你缺少某项前置知识;学完本模块的相关章节后再回来读。第二遍要慢,而且要主动。带着笔读读哪些部分中指明的各节,并做问题要求的小计算:一个界、一个形状、一个参数量。你亲手重算过的数字,才是你真正理解的数字。初读时跳过证明和附录,把没跟上的每一步记下来,而不是把它丢在一边。这一方案改编自 Keshav 在 “How to read a paper”(2007)中提出的三遍阅读法。
这三篇论文覆盖了本模块的主线:循环网络的梯度为什么失常,以及裁剪如何抑制梯度爆炸(第 4 节);消除了编码器-解码器瓶颈的注意力(第 11 节);以及让循环重新回归的选择性状态空间模型(第 13 节)。三篇合计 50 分钟。同一篇论文不同版本的节号和图号并不相同,所以下面的说明用主题来指明各个部分;请对应到你手上的版本。
Pascanu, R., Mikolov, T., Bengio, Y. “On the difficulty of training recurrent neural networks.” International Conference on Machine Learning (ICML), 2013.
为什么读它。 它对循环网络的梯度为何消失和爆炸做了最清晰的分析:雅可比矩阵的连乘、把网络看作动力系统的视角,以及损失曲面上悬崖的几何形状。梯度范数裁剪也起源于此,截至 2026 年,它仍是循环网络和 Transformer 训练中的标准做法。这篇论文说明了第 4 节的论断中,哪些是充分条件,哪些只是必要条件。
读哪些部分。 完整地读引言和关于梯度爆炸与梯度消失的那一节:先是其中的机制,包括梯度消失的充分条件和梯度爆炸的必要条件,然后是动力系统视角,以及附有“墙”示意图的几何解释。接着读关于缩小梯度的小节,也就是裁剪算法。略读作者为梯度消失提出的正则项和实验部分。跳过推导,它们在补充材料中。
阅读时要回答的问题。
- 用 \mathbf{W}_{\text{rec}} 的最大奇异值和激活函数导数的界 \gamma,写出梯度消失的充分条件。对 tanh 和 logistic sigmoid,\gamma 分别是多少?
- 为什么相应的梯度爆炸条件只是必要条件,而不是充分条件?
- 描述损失曲面上的“墙”,并解释当一步撞上它时,为什么重新缩放梯度的范数(而不是它的各个分量)会有帮助。
- 作者建议如何选择裁剪阈值?这与第 7 节给出的 1 到 5 的范围相比如何?
读完之后。 取第 4 节例题中的 2\times2 矩阵 \begin{pmatrix}0.8 & 0.3\\0.3 & 0.8\end{pmatrix},用论文的条件判断 tanh 单元是否保证梯度消失(它的最大奇异值为 1.1,且 \gamma = 1)。然后用两句话说明为什么答案是“不能保证”,以及尽管如此,这个例子对 tanh 的导数说明了什么。
Bahdanau, D., Cho, K., Bengio, Y. “Neural machine translation by jointly learning to align and translate.” International Conference on Learning Representations (ICLR), 2015 (arXiv:1409.0473).
为什么读它。 它引入了注意力,用来解决编码器-解码器的瓶颈。去掉循环之后,这个想法就成了 Transformer,所以模块 06 的机制正是在这篇论文中首次出现的,形式是加性注意力。
读哪些部分。 读引言、关于 RNN 编码器-解码器的背景,以及关于联合学习对齐与翻译的那一节:带对齐模型的解码器,以及产生注释向量(annotation)的双向编码器。看一看翻译质量随句子长度变化的图,以及各张对齐图。跳过实验设置和附录的大部分内容,但对齐模型的定义除外。
阅读时要回答的问题。
- “注释向量” \mathbf{h}_j 是什么?作者为什么用双向 RNN 来计算它?
- 写出他们的对齐模型 a(\mathbf{s}_{i-1}, \mathbf{h}_j),并把每个符号对应到第 11 节的记号。
- 质量随句子长度变化的图,对不带注意力和带注意力的编码器-解码器分别显示了什么?与实验 4 中数字反转的准确率比较。
- 在图中找出一个非单调的对齐,并用两种语言的语序来解释它。
读完之后。 按第 11 节的形状(注释向量宽度 2H,注意力宽度 d_a)重写论文的解码器步骤,并列出在三个矩阵中,哪些与注释向量的乘积可以对每个源句子只计算一次。然后指出把论文的打分函数变成 Luong 点积打分所需的那一处改动,以及这一改动去掉了什么。
Gu, A., Dao, T. “Mamba: Linear-time sequence modeling with selective state spaces.” arXiv:2312.00752, 2023.
为什么读它。 它让状态空间模型的参数依赖于输入,从而使循环在语言规模的序列建模上重新具有竞争力。它是第 12 节和第 13 节所讨论的权衡的最清晰的当代例子:代价恒定的循环,对比注意力的精确查找。
读哪些部分。 读摘要和引言。读关于状态空间模型的一节:连续系统、离散化、循环计算与卷积计算,以及线性时不变性。在关于选择性状态空间模型的一节中,读动机部分(把选择作为一种压缩手段,配以选择性复制和归纳头两个任务),以及对比时不变模型与选择性模型的算法。略读硬件感知扫描的描述。跳过实验部分,只需看一眼合成任务的结果。
阅读时要回答的问题。
- 作者用模型把上下文压缩进状态的程度,描述了效率与效果之间的一种权衡。写出这一权衡,并把 Transformer 和 LTI 状态空间模型分别放在它的两端。
- 在选择性模型中,哪些参数变成了输入的函数?为什么这就排除了卷积模式?
- 用一句话说明:在 GPU 上如何高效地计算选择性循环?
- 论文把 \Delta 与经典循环网络的门联系起来。写出这种联系,并与第 6 节中 GRU 的更新门比较。
读完之后。 用第 13 节的零阶保持公式,对 \Delta = 0.01 和 \Delta = 5 计算 a = e^{-\Delta},并说明每个值适合选择性复制任务中的哪一类 token。然后写出一个任务:在这个任务上,选择性模型固定大小的状态相对于注意力是一个劣势。
小结
- 循环网络在每一步都应用同一个函数 \mathbf{h}_t = \phi(\mathbf{W}_h\mathbf{h}_{t-1} + \mathbf{W}_x\mathbf{x}_t + \mathbf{b}),这使它成为一个共享权重的深层网络;一个普通的循环层有 H(H + d_{\text{in}}) + H 个参数,按 PyTorch 的双偏置约定还要再加 H 个。
- 随时间反向传播就是在展开后的网络上做普通的反向传播:对某个状态的梯度是雅可比矩阵 \mathbf{J}_k = \operatorname{diag}(\phi'(\mathbf{z}_k))\mathbf{W}_h 的连乘,共享权重的梯度是它在每一步的贡献之和;截断反向传播是用依赖范围换取内存,而有限差分可以检验任何实现。
- 梯度随时间间隔呈几何级数地消失或爆炸,因为 n 个雅可比矩阵的乘积按 \rho^n 缩放:0.9^{100} = 2.7\times10^{-5},1.1^{100} = 1.4\times10^{4};tanh 的导数使梯度消失更严重,所以在实践中,即使是正交的循环矩阵也会损失梯度。
- 裁剪全局梯度范数(通常取 1 到 5)能治梯度爆炸,仅此而已;正交初始化或单位矩阵初始化能推迟梯度消失,但不能消除它,结构上的解决办法是一条加性路径。
- LSTM 的细胞状态以加法方式更新,\mathbf{c}_t = \mathbf{f}_t \odot \mathbf{c}_{t-1} + \mathbf{i}_t \odot \tilde{\mathbf{c}}_t,所以沿着这条路径,梯度乘的是遗忘门 \mathbf{f}_t,一个网络可以保持在接近 1 的数;遗忘门偏置取 5 时,默认的半衰期约为 103 步,而偏置取 0 时只有 1 步。
- 参数量的计算是机械的:
nn.LSTM(1, 32)有 4,480 个参数,nn.GRU(1, 32)有 3,360 个;LSTM 是默认选择,模型大小或速度吃紧时选 GRU,而只有在离线拿到整个序列时,使用双向网络才是正当的。 - 在实践中训练循环网络,需要对变长序列做填充、掩码或打包,需要裁剪梯度、合理的遗忘门偏置,以及一套调试顺序:从单个小 batch 开始,模型必须能在它上面过拟合。
- 预测的好坏取决于它的划分和基线:用前向滚动验证的各折按时间划分,所有统计量都在训练部分上计算,在模型的误差旁边报告朴素预测、季节性朴素预测和线性自回归的误差(或 MASE 这样的尺度化分数),并在水平漂移时按窗口归一化,因为网络不会外推水平。
- 基于残差的监测器要在留出的正常数据上设定阈值,因为训练残差小得过于乐观;如果残差独立且服从高斯分布,1 Hz 下的 3\sigma 检验每天约有 233 次误报;每种故障类型(尖峰、噪声变化、传感器卡死、持续偏移)都需要自己的检测器。
- 编码器-解码器把 p(y \mid x) 逐个 token 地分解,训练时用教师强制,以真实前缀为条件,解码时却以自己的预测为条件(暴露偏差);束宽为 1 的束搜索就是贪心解码,更宽的束能找到概率更高的序列,但除非分数做了长度归一化,否则会偏向短序列;任何搜索都修复不了一个不知道答案的模型。
- 单个摘要向量是一个瓶颈(在实验 4 中,数字反转的整串正确率从长度 4 时的约 98% 降到长度 12 时的约 1%),注意力消除了这个瓶颈:解码器对所有编码器状态做 softmax 加权平均,使每个输出到每个输入都只有一步的路径,而这些权重构成的对齐是一种诊断手段,而不是解释。
- Transformer 取代了循环,因为非线性循环需要 T 个相互依赖的步骤,路径长度为 O(T),而注意力的路径只有一步,代价是平方级的;循环保持恒定大小的状态(宽度为 1,024 的 4 层 LSTM 为 32.8 kB,而宽度为 2,048 的 24 层 Transformer 在 32,768 个 token 时的 KV cache 为 6.44 GB),线性时不变的循环是一种可以并行训练的卷积,而 Mamba 依赖输入的步长又把它变回了一个门。
模块 05 把视野从序列扩展到其他值得了解的网络家族:自编码器与 VAE、GAN、扩散模型、图网络、物理信息网络和对比学习,其中有几种会在后续模块的大模型中再次出现。模块 06 随后取出第 11 节的注意力,彻底去掉循环,构建出 Transformer:同样的查询-键-值查找,由每个位置对其他每个位置施加,带有第 11 节所论证的缩放因子 \sqrt{d_k},以及循环原本免费提供的位置信息。
关键术语
| English | 中文 |
|---|---|
| recurrent neural network (RNN) | 循环神经网络 |
| hidden state | 隐状态 |
| unrolling in time | 按时间展开 |
| backpropagation through time (BPTT) | 随时间反向传播 |
| truncated BPTT | 截断的随时间反向传播 |
| vanishing / exploding gradient | 梯度消失 / 梯度爆炸 |
| spectral radius | 谱半径 |
| gradient clipping | 梯度裁剪 |
| long short-term memory (LSTM) | 长短期记忆网络 |
| gated recurrent unit (GRU) | 门控循环单元 |
| gate | 门(门控) |
| cell state | 细胞状态 |
| forget gate | 遗忘门 |
| bidirectional RNN | 双向循环神经网络 |
| sequence to sequence (seq2seq) | 序列到序列 |
| encoder-decoder | 编码器-解码器 |
| teacher forcing | 教师强制 |
| exposure bias | 暴露偏差 |
| greedy decoding | 贪心解码 |
| beam search | 束搜索 |
| attention, alignment | 注意力,对齐 |
| context vector | 上下文向量 |
| time series forecasting | 时间序列预测 |
| walk-forward validation (rolling-origin evaluation) | 前向滚动验证(滚动起点评估) |
| naive forecast, seasonal naive forecast | 朴素预测,季节性朴素预测 |
| anomaly detection, residual | 异常检测,残差 |
| state-space model | 状态空间模型 |
| linear recurrence, parallel scan | 线性循环(线性递推),并行扫描 |
| selective state-space model | 选择性状态空间模型 |
| temporal convolutional network (TCN) | 时间卷积网络 |
参考文献
- Elman, J. L. “Finding structure in time.” Cognitive Science, 1990. 第 2 节的简单循环网络。
- Werbos, P. J. “Backpropagation through time: what it does and how to do it.” Proceedings of the IEEE, 1990. 随时间反向传播。
- Williams, R. J., Zipser, D. “A learning algorithm for continually running fully recurrent neural networks.” Neural Computation, 1989. 实时循环学习,即前向模式的替代方案。
- Williams, R. J., Peng, J. “An efficient gradient-based algorithm for on-line training of recurrent network trajectories.” Neural Computation, 1990. 更新长度与反向传播长度分开设定的截断 BPTT。
- Hochreiter, S. “Untersuchungen zu dynamischen neuronalen Netzen.” Diploma thesis, Technische Universität München, 1991. 对梯度消失的首次分析,德文。
- Bengio, Y., Simard, P., Frasconi, P. “Learning long-term dependencies with gradient descent is difficult.” IEEE Transactions on Neural Networks, 1994. 循环网络中的梯度消失问题。
- Pascanu, R., Mikolov, T., Bengio, Y. “On the difficulty of training recurrent neural networks.” ICML, 2013. 谱条件与梯度裁剪(论文导读)。
- Saxe, A. M., McClelland, J. L., Ganguli, S. “Exact solutions to the nonlinear dynamics of learning in deep linear neural networks.” ICLR, 2014. 正交初始化。
- Le, Q. V., Jaitly, N., Hinton, G. E. “A simple way to initialize recurrent networks of rectified linear units.” arXiv, 2015. 配合 ReLU 的单位矩阵初始化。
- Arjovsky, M., Shah, A., Bengio, Y. “Unitary evolution recurrent neural networks.” ICML, 2016. 保持范数的循环。
- Hochreiter, S., Schmidhuber, J. “Long short-term memory.” Neural Computation, 1997. LSTM 与恒定误差传送带。
- Gers, F. A., Schmidhuber, J., Cummins, F. “Learning to forget: continual prediction with LSTM.” Neural Computation, 2000. 遗忘门。
- Greff, K. et al. “LSTM: a search space odyssey.” IEEE Transactions on Neural Networks and Learning Systems, 2017. 比较了八种变体。
- Jozefowicz, R., Zaremba, W., Sutskever, I. “An empirical exploration of recurrent network architectures.” ICML, 2015. 取 1 的遗忘门偏置。
- Tallec, C., Ollivier, Y. “Can recurrent neural networks warp time?” ICLR, 2018. 门偏置的 chrono 初始化。
- Cho, K. et al. “Learning phrase representations using RNN encoder-decoder for statistical machine translation.” EMNLP, 2014. GRU 与编码器-解码器。
- Cho, K., van Merriënboer, B., Bahdanau, D., Bengio, Y. “On the properties of neural machine translation: encoder-decoder approaches.” SSST-8 Workshop, 2014. 翻译质量随句子长度下降。
- Chung, J., Gulcehre, C., Cho, K., Bengio, Y. “Empirical evaluation of gated recurrent neural networks on sequence modeling.” arXiv, 2014. GRU 与 LSTM 的对比。
- Weiss, G., Goldberg, Y., Yahav, E. “On the practical computational power of finite precision RNNs for language recognition.” ACL, 2018. LSTM 能计数;GRU 在实践中不能。
- Schuster, M., Paliwal, K. K. “Bidirectional recurrent neural networks.” IEEE Transactions on Signal Processing, 1997. 双向网络。
- Gal, Y., Ghahramani, Z. “A theoretically grounded application of dropout in recurrent neural networks.” NeurIPS, 2016. 变分 dropout。
- Merity, S., Keskar, N. S., Socher, R. “Regularizing and optimizing LSTM language models.” ICLR, 2018. 作用于循环权重的 dropout(AWD-LSTM)。
- Ba, J. L., Kiros, J. R., Hinton, G. E. “Layer normalization.” arXiv, 2016. 包括循环网络。
- Graves, A. “Generating sequences with recurrent neural networks.” arXiv, 2013. 字符级生成与手写生成。
- Karpathy, A. “The unreasonable effectiveness of recurrent neural networks.” Blog post, 2015. 字符级模型写出散文、代码和标记语言。
- Karpathy, A., Johnson, J., Fei-Fei, L. “Visualizing and understanding recurrent networks.” ICLR Workshop, 2016. 可解释的 LSTM 单元。
- Sutskever, I., Vinyals, O., Le, Q. V. “Sequence to sequence learning with neural networks.” NeurIPS, 2014. 编码器-解码器与反转的源序列。
- Bengio, S., Vinyals, O., Jaitly, N., Shazeer, N. “Scheduled sampling for sequence prediction with recurrent neural networks.” NeurIPS, 2015. 暴露偏差的一种补救方法。
- Ranzato, M. et al. “Sequence level training with recurrent neural networks.” ICLR, 2016. 提出了“暴露偏差”这一名称。
- Wu, Y. et al. “Google’s neural machine translation system: bridging the gap between human and machine translation.” arXiv, 2016. 深层残差 LSTM 堆叠;束搜索中的长度归一化。
- Bahdanau, D., Cho, K., Bengio, Y. “Neural machine translation by jointly learning to align and translate.” ICLR, 2015. 加性注意力(论文导读)。
- Luong, M.-T., Pham, H., Manning, C. D. “Effective approaches to attention-based neural machine translation.” EMNLP, 2015. 乘性注意力。
- Jain, S., Wallace, B. C. “Attention is not explanation.” NAACL, 2019; with Wiegreffe, S., Pinter, Y. “Attention is not not explanation.” EMNLP, 2019. 谨慎解读注意力权重。
- Vaswani, A. et al. “Attention is all you need.” NeurIPS, 2017. Transformer,见模块 06;它的复杂度表是第 12 节那张表的蓝本。
- van den Oord, A. et al. “WaveNet: a generative model for raw audio.” arXiv, 2016. 空洞因果卷积。
- Bai, S., Kolter, J. Z., Koltun, V. “An empirical evaluation of generic convolutional and recurrent networks for sequence modeling.” arXiv, 2018. 时间卷积网络。
- Katharopoulos, A., Vyas, A., Pappas, N., Fleuret, F. “Transformers are RNNs: fast autoregressive transformers with linear attention.” ICML, 2020. 把线性注意力看作一种循环。
- Blelloch, G. E. “Prefix sums and their applications.” Technical report CMU-CS-90-190, Carnegie Mellon University, 1990. 并行扫描。
- Gu, A., Dao, T., Ermon, S., Rudra, A., Ré, C. “HiPPO: recurrent memory with optimal polynomial projections.” NeurIPS, 2020. S4 背后的初始化方法。
- Gu, A., Goel, K., Ré, C. “Efficiently modeling long sequences with structured state spaces.” ICLR, 2022. S4。
- Tay, Y. et al. “Long Range Arena: a benchmark for efficient transformers.” ICLR, 2021. 长序列基准。
- Gupta, A., Gu, A., Berant, J. “Diagonal state spaces are as effective as structured state spaces.” NeurIPS, 2022; and Gu, A., Gupta, A., Goel, K., Ré, C. “On the parameterization and initialization of diagonal state space models.” NeurIPS, 2022. DSS 与 S4D。
- Orvieto, A. et al. “Resurrecting recurrent neural networks for long sequences.” ICML, 2023. 实验 5 所采用的线性循环单元(LRU)。
- Gu, A., Dao, T. “Mamba: linear-time sequence modeling with selective state spaces.” arXiv:2312.00752, 2023. 选择性状态空间模型(论文导读)。
- Dao, T., Gu, A. “Transformers are SSMs: generalized models and efficient algorithms through structured state space duality.” ICML, 2024. Mamba-2。
- Lieber, O. et al. “Jamba: a hybrid transformer-Mamba language model.” arXiv, 2024. 一个已发表的混合模型。
- Beck, M. et al. “xLSTM: extended long short-term memory.” NeurIPS, 2024. 重新设计的 LSTM。
- Hyndman, R. J., Athanasopoulos, G. Forecasting: Principles and Practice, 3rd edition. OTexts, 2021. 可免费在线阅读;基线方法与时间序列交叉验证。
- Hyndman, R. J., Koehler, A. B. “Another look at measures of forecast accuracy.” International Journal of Forecasting, 2006. MASE。
- Tashman, L. J. “Out-of-sample tests of forecasting accuracy: an analysis and review.” International Journal of Forecasting, 2000. 滚动起点评估。
- Ben Taieb, S., Bontempi, G., Atiya, A. F., Sorjamaa, A. “A review and comparison of strategies for multi-step ahead time series forecasting based on the NN5 forecasting competition.” Expert Systems with Applications, 2012. 递归策略与直接策略的比较。
- Kim, T. et al. “Reversible instance normalization for accurate time-series forecasting against distribution shift.” ICLR, 2022. RevIN。
- Makridakis, S., Spiliotis, E., Assimakopoulos, V. “The M4 Competition: 100,000 time series and 61 forecasting methods.” International Journal of Forecasting, 2020; and Smyl, S. “A hybrid method of exponential smoothing and recurrent neural networks for time series forecasting.” International Journal of Forecasting, 2020. 这场预测竞赛,以及夺冠的混合方法。
- Salinas, D., Flunkert, V., Gasthaus, J., Januschowski, T. “DeepAR: probabilistic forecasting with autoregressive recurrent networks.” International Journal of Forecasting, 2020. 概率式循环网络预测。
- Hundman, K. et al. “Detecting spacecraft anomalies using LSTMs and nonparametric dynamic thresholding.” KDD, 2018. 用预测残差监测遥测数据。
- Page, E. S. “Continuous inspection schemes.” Biometrika, 1954. CUSUM 检验。
- Isermann, R. Fault-Diagnosis Systems. Springer, 2006. 基于模型、利用残差的故障检测。
- Keshav, S. “How to read a paper.” ACM SIGCOMM Computer Communication Review, 2007. 三遍阅读法,论文导读中两遍阅读方案的来源。