学习问题
工程师心里有一个函数,却写不出它的表达式。脚手架的下垂量是材料和几何形状的函数,求解器可以算出来,但这个求解器花了一个人一年才造好。某个危险是否可控的概率是情境的函数,根本无法计算,只能由人来估计。机器学习(machine learning)就是在示例比理论更便宜的时候,从输入输出的示例中得到这样一个函数的做法。
形式化地说,存在一个未知函数 f^\ast,以及输入输出对 (\mathbf{x}, y) 上的数据分布 P,其中输入 \mathbf{x} \in \R^d。函数 f^\ast 是由 \mathbf{x} 预测 y 的最佳可能预测;输出会围绕它散开,因为输入并不能完全决定输出。我们看到一个从 P 中抽取的样本 \mathcal{D} = \{(\mathbf{x}_i, y_i)\}_{i=1}^{N},希望得到一个函数 f,使它在没见过的输入上也能很好地由 \mathbf{x} 预测 y。最后这半句就是整个学科的核心。只会预测已有的示例,那不过是一张查找表。
期望风险与经验风险
损失(loss)\ell(f(\mathbf{x}), y) \ge 0 衡量一次预测错得有多厉害,例如平方误差 (f(\mathbf{x}) - y)^2。我们希望变小的是期望风险(expected risk),即在输入将来自的分布上的平均损失:
由于 P 未知,它无法计算。能够计算的是:对于参数为 \theta 的模型 f_\theta,经验风险(empirical risk),即样本上的平均损失:
对于在抽样之前就固定的参数,\mathcal{L}(\theta) 是 R(f_\theta) 的无偏估计:每一项的期望都是 R(f_\theta)。拟合会破坏这一性质。优化器选择 \hat\theta,使 \mathcal{L} 在这 N 个示例上变小,噪声也一并拟合进去,所以 \hat\theta 处的训练损失是偏低的。对于能找到最小值的优化器,论证分三步。把 R(f_\theta) 记作 R(\theta),并令 \theta^\circ 在模型族上使它最小。那么对每个样本都有 \mathcal{L}(\hat\theta) \le \mathcal{L}(\theta^\circ),因为 \hat\theta 使 \mathcal{L} 最小;又有 \E[\mathcal{L}(\theta^\circ)] = R(\theta^\circ),因为 \theta^\circ 不依赖于样本;还有 R(\theta^\circ) \le R(\hat\theta),因为 \theta^\circ 是最优的。串起来:
训练损失与期望风险之间的差距,是第 8 节的主题,该节度量这一差距如何随模型的灵活性增长;也是第 10 节的主题,该节讲如何估计期望风险而不自欺欺人。
三种设定
- 监督学习(supervised learning)。每个示例都给出了 y:y 连续时是回归(regression),y 取 K 个标签之一时是分类(classification)。本系列的大部分内容属于这一类。
- 无监督学习(unsupervised learning)。没有 y。任务是发现结构:聚类、低维坐标、密度。k 均值和主成分分析出现在第 11 节;它们的神经网络形式见模块 05。
- 强化学习(reinforcement learning)。同样没有 y,但在动作之后会收到奖励。模块 09用它来训练语言模型。
五个要素
从一条直线到一个语言模型,每一种学习方法都由五项选择确定。遇到任何方法,都把这五项写下来;无法这样陈述的方法,就是你还没有理解的方法。
- 数据。 \mathcal{D},以及它所来自的分布 P。第二项是人们最容易忘记的。学到的一切都是关于 P 的,所以模型的好坏,只取决于 P 与它在使用中遇到的输入之间的匹配程度。
- 模型。 以参数 \theta 为索引的一族函数 f_\theta,也称假设类(hypothesis class)。它决定了究竟能学到什么:直线有两个参数,永远只能是直线;语言模型有数十亿个参数。
- 损失。 \ell \ge 0 及其在数据上的平均,即经验风险 \mathcal{L}(\theta)。它决定哪些错误算数、算多少;第 5 节会说明,它同时也陈述了对噪声的一个假设。
- 优化器。 找到使 \mathcal{L} 变小的 \theta 的过程,几乎总是梯度下降的某个变体(第 3 节和第 4 节)。它决定损失所要求的 \theta 是否真能找到,以及代价多大。
- 评估。 衡量 f_\theta 在未参与拟合的数据上表现如何:这是对 R 的估计,而不是在 \mathcal{D} 上的损失,后者已经被优化器最小化过了。
| 要素 | 本模块的线性回归 | 模块 07–10 的语言模型 |
|---|---|---|
| 数据 | 200 行,3 个特征;标准差为 0.1 的高斯噪声 | 万亿级 token 的文本 |
| 模型 | \mathbf{w}^\top\mathbf{x} + b:4 个参数 | 一个 Transformer:约 95 亿个参数 |
| 损失 | 平方误差 | 每个位置上对词表的交叉熵 |
| 优化器 | 正规方程,或梯度下降 | AdamW |
| 评估 | 留出行上的 RMSE | 留出数据上的困惑度和任务基准 |
五个位置完全相同。参数量相差 9.5\times10^{9}/4 \approx 2.4\times10^{9} 倍,超过九个数量级。这个语言模型是模块 07–10 所跟随的假想案例研究;在那之前不需要了解它的任何内容。
| 要素 | 对一次压缩试验的新胡克拟合 |
|---|---|
| 数据 | 来自一次试验的 16 个三元组(拉伸比、应力、记录的不确定度);分布是以这种方式试验的这种凝胶的试样 |
| 模型 | 拉伸比 \lambda 下的名义应力 P = 2c_1(\lambda - \lambda^{-2}):一个参数 c_1 |
| 损失 | 以 1/\sigma_i^2 加权的平方误差,即每个点不确定度的平方的倒数 |
| 优化器 | 闭式解 |
| 评估 | 在拟合时留出的应变范围上的残差 |
符号 P 和 \lambda 只在本例和第 12 节中具有这些含义。第 12 节的主要问题就在评估这一栏:拟合应变范围内的残差可以检查,而范围之外的预测是外推,范围内的任何残差都无法为它担保。
输入是数
模型看到的是一个特征输入向量(feature vector)\mathbf{x} \in \R^d。测得的量本身就是数;类别则不是,例如材料牌号、供应商或缺陷类型。把 K 类的类别编码成独热编码(one-hot):K 个二值列,观测到的类别所在列为 1,其余为 0。绝不要把它编码成整数 1, \dots, K:线性模型会把类别当作一个量,这就强加了顺序,并且相邻编码之间间距相等。例外是真正的有序量表,例如从轻微到严重的严重程度,其顺序是真实的;即便如此,整数编码也假设各级之间等距,这是需要检验的建模选择,而不是事实。
独热编码也能解释学到的表示。独热行向量 \mathbf{e}_k^\top 乘以一张可训练的 K \times m 表,取出的是表的第 k 行,所以嵌入(embedding)就是随模型其余部分一起学习的这样一张表,它对任何类别特征(零件编号、供应商、传感器 ID)的作用方式,与对语言模型的 token 相同。模块 06 第 4 节展示了 token 嵌入如何进入 Transformer 的残差流,模块 06 第 11 节则统计了它的 V \times d 表的大小。
贯穿全模块的示例
本模块反复出现四个示例,使每个新概念都落在已经熟悉的东西上:
- 一个合成的线性回归,N = 200 行、d = 3 个特征(第 2–4 节,实验 1);
- 带噪声的 \sin(2\pi x) 样本,用多项式拟合(第 8–9 节,实验 3);
- 在 scikit-learn 自带的数据集上,把乳腺肿瘤分为恶性或良性的分类器(第 6–7 节,实验 2和实验 4);
- 拟合软水凝胶压缩试验的超弹性材料模型(第 5 节和第 12 节,实验 5)。
为什么训练损失不能衡量模型有多好?
查看答案
优化器正是在这些示例上选择 \theta 使它变小,噪声也包括在内,所以它是偏低的。只有未参与拟合的数据,才能无偏地估计期望风险。
缺陷严重程度 {轻微, 一般, 严重} 在线性模型中被编码为 1、2、3。这假设了什么,什么时候可以接受?
查看答案
它假设了顺序(这里的顺序是真实的)和等距:“一般”的效应恰好位于“轻微”和“严重”的效应正中间。只有在等距合理,或验证数据支持等距时,才保留整数编码;否则用独热编码,它不保留顺序,也不假设间距。(练习 2讨论无序的情形。)
最小二乘及其几何
线性回归是能涉及全部五个要素的最简单的模型,也是本模块中唯一一个其所有性质都能精确计算的模型。本节用闭式解来拟合它,把结果解读为一个投影,并说明问题何时是病态的,以及如何稳定地计算答案。
设定
令 f(\mathbf{x}) = \mathbf{w}^\top\mathbf{x} + b。给每个输入追加一个常数 1,把截距 b 吸收进去,于是 f(\mathbf{x}) = \mathbf{w}^\top\mathbf{x},其中 \mathbf{w} \in \R^{d+1},b 是它的最后一个分量。把输入堆叠为 \mathbf{X} \in \R^{N\times(d+1)} 的各行,其最后一列全为 1,把输出堆叠为 \mathbf{y} \in \R^N。损失是均方误差:
第 5 节会说明为什么噪声为高斯时平方误差是正确的损失;这里先把它当作已知。
梯度的推导
把范数的平方展开为内积:
两个交叉项 \mathbf{w}^\top\mathbf{X}^\top\mathbf{y} 和 \mathbf{y}^\top\mathbf{X}\mathbf{w} 是同一个标量,互为转置,系数 2 由此而来。两个恒等式可以对各项求导。对于对称矩阵 \mathbf{A},有 \nabla_{\mathbf{w}}(\mathbf{w}^\top\mathbf{A}\mathbf{w}) = 2\mathbf{A}\mathbf{w}:把求和写开,\partial_{w_k}\sum_{j,l}w_jA_{jl}w_l = \sum_l A_{kl}w_l + \sum_j w_jA_{jk} = 2(\mathbf{A}\mathbf{w})_k,最后一步用到对称性。对于常向量 \mathbf{c},有 \nabla_{\mathbf{w}}(\mathbf{c}^\top\mathbf{w}) = \mathbf{c}。取 \mathbf{A} = \mathbf{X}^\top\mathbf{X},\mathbf{c} = \mathbf{X}^\top\mathbf{y},则
梯度就是残差向量 \mathbf{X}\mathbf{w} - \mathbf{y} 经 \mathbf{X}^\top 映射回参数空间。再求一次导,得到海森矩阵(Hessian)\frac{2}{N}\mathbf{X}^\top\mathbf{X},它在每个 \mathbf{w} 处都相同。它是半正定的,因为对每个 \mathbf{v} 都有 \mathbf{v}^\top\mathbf{X}^\top\mathbf{X}\mathbf{v} = \|\mathbf{X}\mathbf{v}\|^2 \ge 0。所以 \mathcal{L} 是凸二次函数,梯度为零的每个点都是全局最小值。
正规方程
令梯度为零,得到正规方程(normal equations)
若 \mathbf{X} 列满秩,即它的 d + 1 列线性无关,则对每个 \mathbf{v} \ne \mathbf{0} 都有 \|\mathbf{X}\mathbf{v}\|^2 > 0,所以 \mathbf{X}^\top\mathbf{X} 正定且可逆,最小值点唯一:
列满秩要求至少有 d + 1 个线性无关的行:示例数不能少于参数数。这个公式是用来读的;如何计算 \mathbf{w}^\ast 见下文。
几何:正交投影
随着 \mathbf{w} 变化,\mathbf{X}\mathbf{w} 是 \mathbf{X} 各列的线性组合,扫出 \mathbf{X} 的列空间(column space),即 \R^N 中一个 d + 1 维的子空间。最小二乘选取该子空间中离 \mathbf{y} 最近的点。记残差 \mathbf{r} = \mathbf{y} - \mathbf{X}\mathbf{w}^\ast,正规方程可以写成
\mathbf{X} 的每一列与残差的内积都为零。残差垂直于(即“正规于”)列空间,这就是这组方程名称的由来,而 \hat{\mathbf{y}} = \mathbf{X}\mathbf{w}^\ast 就是 \mathbf{y} 在列空间上的正交投影(orthogonal projection):从 \mathbf{y} 向子空间作垂线的垂足,也就是最近点(图 1.1)。
把最小二乘画成三维空间中的投影。过原点的一个平面,由两个列向量 \mathbf{x}_{(1)} 和 \mathbf{x}_{(2)} 张成,是 \mathbf{X} 的列空间。数据向量 \mathbf{y} 高出平面;它在平面内的垂足是 \hat{\mathbf{y}} = \mathbf{X}\mathbf{w}^\ast;残差 \mathbf{r} = \mathbf{y} - \hat{\mathbf{y}} 是一条虚线段,与平面成直角相交。\mathbf{X}^\top\mathbf{r} = \mathbf{0} 就是正规方程。
这个投影是线性的:\hat{\mathbf{y}} = \mathbf{P}\mathbf{y},其中
即帽子矩阵(hat matrix),因为它给 \mathbf{y} 戴上了“帽子”。(统计学教材把它写作 \mathbf{H};本模块把 \mathbf{H} 留给海森矩阵。)它是对称的,并且幂等(idempotent), \mathbf{P}^2 = \mathbf{X}(\mathbf{X}^\top\mathbf{X})^{-1}(\mathbf{X}^\top\mathbf{X})(\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top = \mathbf{P}:投影两次不改变任何东西。它的迹等于它所投影到的空间的维数。利用 \operatorname{tr}(\mathbf{A}\mathbf{B}) = \operatorname{tr}(\mathbf{B}\mathbf{A}), \operatorname{tr}\mathbf{P} = \operatorname{tr}\big((\mathbf{X}^\top\mathbf{X})^{-1}\mathbf{X}^\top\mathbf{X}\big) = \operatorname{tr}\mathbf{I}_{d+1} = d + 1,即被拟合的参数个数。第 9 节把这个计数变成岭回归的有效自由度。
当 \mathbf{X} 包含全 1 的列时,有两个推论。\mathbf{X}^\top\mathbf{r} = \mathbf{0} 中对应该列的那一行写作 \sum_i r_i = 0:残差之和为零,\hat{\mathbf{y}} 与 \mathbf{y} 有相同的均值 \bar y。又因为 \bar y\mathbf{1} 也位于列空间内,\mathbf{y} - \bar y\mathbf{1} = (\hat{\mathbf{y}} - \bar y\mathbf{1}) + \mathbf{r} 把中心化后的数据分成位于列空间内的一部分和垂直于它的一部分。由勾股定理,
总平方和等于解释平方和加残差平方和。由此定义决定系数(coefficient of determination)
即拟合所解释的 \mathbf{y} 关于其均值的方差所占的比例;在训练数据上它介于 0 和 1 之间。处处预测均值,是只有截距的模型,所以 R^2 把拟合与这条基线作比较。第 7 节在留出数据上使用 R^2,那里这个恒等式不再成立,R^2 可以为负。
用 y = b + wx 拟合 x = (0, 1, 2, 3)、y = (1, 3, 2, 5)。\mathbf{X} 的各行是 (1, x_i),所以
其中 \sum x_iy_i = 0 + 3 + 4 + 15 = 22。行列式为 4\cdot14 - 6\cdot6 = 20,由克莱默法则(Cramer’s rule)得
拟合值为 \hat{\mathbf{y}} = (1.1, 2.2, 3.3, 4.4),残差为 \mathbf{r} = (-0.1, 0.8, -1.3, 0.6)。检验正规方程:\sum r_i = -0.1 + 0.8 - 1.3 + 0.6 = 0,\sum x_ir_i = 0 + 0.8 - 2.6 + 1.8 = 0,两者都精确成立。各平方和为 RSS = 0.01 + 0.64 + 1.69 + 0.36 = 2.70;由 \bar y = 2.75,TSS = 1.75^2 + 0.25^2 + 0.75^2 + 2.25^2 = 8.75;ESS = 1.65^2 + 0.55^2 + 0.55^2 + 1.65^2 = 6.05,于是 6.05 + 2.70 = 8.75,正如勾股定理所要求。因此 R^2 = 1 - 2.70/8.75 = 0.691。帽子矩阵的对角线为 (0.7, 0.3, 0.3, 0.7),迹为 2,等于参数个数。
当各列相关时
若 \mathbf{X} 的某一列是其他列的线性组合,就存在 \mathbf{v} \ne \mathbf{0} 使 \mathbf{X}\mathbf{v} = \mathbf{0};于是 \mathbf{X}^\top\mathbf{X}\mathbf{v} = \mathbf{0},\mathbf{X}^\top\mathbf{X} 是奇异的。实践中有两种情形:以 °C 计的温度旁边又放了同一温度的 °F 值,并且带有截距,因为 T_{\text{F}} = 1.8\,T_{\text{C}} + 32 使 °F 列成为 °C 列与全 1 列的组合;以及一个类别的全部 K 个独热列与截距并存,因为这 K 列之和等于全 1 列。此时每个 \mathbf{w}^\ast + t\mathbf{v} 的拟合效果都一样好。投影 \hat{\mathbf{y}} 仍然唯一,训练输入处的预测以及任何服从同一相关关系的新输入处的预测也唯一;权重则不唯一。伪逆(pseudo-inverse)解 \mathbf{X}^{+}\mathbf{y} 在所有最小值点中取范数最小的那个,np.linalg.lstsq 返回的就是它。第 9 节的岭惩罚同样能消除这种歧义。两者都不会使相关列各自的权重变得有意义。
给这四个点追加一列 2x,于是 \mathbf{X} 的各行是 (1, x_i, 2x_i),
它的第三行是第二行的两倍:行列式为 0。用 a 和 c 表示 x 和 2x 上的权重。拟合为 b + (a + 2c)x,所以只要 b = 1.1 且 a + 2c = 1.1,每种选择都会重现上一例中的直线,预测值为 (1.1, 2.2, 3.3, 4.4)。范数最小的选择,是直线 a + 2c = 1.1 上离原点最近的点,它位于该直线的法向 (1, 2) 上:(a, c) = 1.1\cdot(1, 2)/(1^2 + 2^2) = (0.22, 0.44)。np.linalg.lstsq 返回 (b, a, c) = (1.1, 0.22, 0.44),并报告秩为 2。
如何计算
绝不要显式形成 (\mathbf{X}^\top\mathbf{X})^{-1};要去解方程。条件数(condition number)\kappa(\mathbf{X}) 是 \mathbf{X} 最大奇异值与最小奇异值之比,它给出舍入误差最多会被放大多少:双精度有 16 位有效数字,一次求解大约会损失 \log_{10}\kappa 位。三种方法,稳健性依次递增:
- 对 \mathbf{X}^\top\mathbf{X} 做 Cholesky 分解。 分解 \mathbf{X}^\top\mathbf{X} = \mathbf{L}\mathbf{L}^\top,其中 \mathbf{L} 为下三角矩阵,再解两个三角方程组。它最快,但形成 \mathbf{X}^\top\mathbf{X} 会使条件数平方,\kappa(\mathbf{X}^\top\mathbf{X}) = \kappa(\mathbf{X})^2,因为 \mathbf{X}^\top\mathbf{X} 的特征值是 \mathbf{X} 的奇异值的平方。当 \kappa(\mathbf{X}) = 10^6 时,这意味着最多损失 12 位而不是 6 位。
- 对 \mathbf{X} 做 QR 分解。 写 \mathbf{X} = \mathbf{Q}\mathbf{R},其中 \mathbf{Q} 的各列标准正交,\mathbf{R} 为上三角矩阵。由于 \mathbf{Q}^\top\mathbf{Q} = \mathbf{I},正规方程化为 \mathbf{R}^\top\mathbf{R}\mathbf{w} = \mathbf{R}^\top\mathbf{Q}^\top\mathbf{y},即 \mathbf{R}\mathbf{w} = \mathbf{Q}^\top\mathbf{y},用回代法求解。这种方法直接处理 \mathbf{X} 本身,从不使 \kappa 平方。
- 奇异值分解(SVD)。 \mathbf{X} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^\top 给出 \mathbf{w} = \mathbf{V}\boldsymbol{\Sigma}^{-1}\mathbf{U}^\top\mathbf{y}。\boldsymbol{\Sigma} 对角线上的奇异值直观显示了条件状况,而只对非零奇异值求逆,就得到秩亏情形下的最小范数解。
np.linalg.lstsq 使用基于 SVD 的 LAPACK 驱动程序,是默认应当选用的方法。形成 \mathbf{X}^\top\mathbf{X} 或分解 \mathbf{X},每种方法的代价都约为 Nd^2 次运算,随后的小规模求解再约为 d^3 次。
代码,以及不可约误差
下面是用 NumPy 写出的全部内容,数据取自实验 1:200 个输入,各有三个标准正态特征,真实权重为 (1.5, -2.0, 0.5),截距为 0.7,高斯噪声的标准差为 0.1。下一节的主题是梯度下降,这里也放进来作比较。
import numpy as np

rng = np.random.default_rng(0)
N, d = 200, 3
X = rng.normal(size=(N, d))
w_true = np.array([1.5, -2.0, 0.5]); b_true = 0.7
y = X @ w_true + b_true + 0.1 * rng.normal(size=N)   # noise: the part no model recovers

Xb = np.hstack([X, np.ones((N, 1))])                 # absorb the bias

# closed form
w_closed = np.linalg.solve(Xb.T @ Xb, Xb.T @ y)

# gradient descent
w = np.zeros(d + 1); eta = 0.1
for step in range(500):
    grad = (2 / N) * Xb.T @ (Xb @ w - y)
    w -= eta * grad
print(np.round(w_closed, 3), np.round(w, 3))         # both near [1.5, -2.0, 0.5, 0.7]

# the robust default: an SVD-based solver that never forms Xb.T @ Xb
w_lstsq = np.linalg.lstsq(Xb, y, rcond=None)[0]
rss = np.sum((y - Xb @ w_lstsq) ** 2)               # residual sum of squares
print(np.round(w_lstsq, 3))
print(f"residual RMS {np.sqrt(rss / N):.4f}")
print(f"sqrt(RSS / (N - 4)) {np.sqrt(rss / (N - 4)):.4f}")
[ 1.491 -2.01   0.505  0.696] [ 1.491 -2.01   0.505  0.696]
[ 1.491 -2.01   0.505  0.696]
residual RMS 0.1000
sqrt(RSS / (N - 4)) 0.1010
正规方程、lstsq 以及 \eta = 0.1 下的 500 步梯度下降,在小数点后三位上一致:(1.491, -2.010, 0.505, 0.696),对应真实值 (1.5, -2.0, 0.5, 0.7)。与真实值的差异并不是求解器误差,而是这个特定样本的噪声:由于 \mathbf{X}^\top\mathbf{X} \approx 200\,\mathbf{I},每个权重的标准误约为 0.1/\sqrt{200} = 0.007,差异正是这个量级。残差 RMS 为 \sqrt{\text{RSS}/N} = 0.1000。改为除以 N - 4(对应四个被拟合的参数),得到 0.1010,而实际抽取的噪声的 RMS 为 0.1011:噪声水平被还原出来了。残差比噪声略小,是因为拟合用掉了 200 个自由度中的 4 个去追随噪声;第 5 节会推导这一修正。
数据中的项 0.1\cdot\mathcal{N}(0, 1) 就是不可约误差(irreducible error):\mathbf{x} 的任何函数都无法预测它,所以没有任何模型能把新数据上的期望平方误差降到它的方差 0.01 以下。残差 RMS 等于噪声水平,说明已经没有可恢复的东西剩下。训练残差远低于噪声水平的模型,是在拟合噪声,而新数据并不具有这些噪声。这就是第 8 节中心问题的第一次出现。
为什么叫正规方程?
查看答案
它们表示 \mathbf{X}^\top(\mathbf{y} - \mathbf{X}\mathbf{w}) = \mathbf{0}:残差与 \mathbf{X} 的每一列都正规,也就是垂直。
你在以 °C 计的温度旁边加入以 °F 计的温度,并且带有截距。\mathbf{X}^\top\mathbf{X} 和预测会怎样?
查看答案
\mathbf{X}^\top\mathbf{X} 变得奇异,因为 °F 列等于 1.8 倍的 °C 列加上 32 倍的截距列。权重不再唯一,但投影 \hat{\mathbf{y}},从而预测,保持不变。
为什么用 QR 或 SVD,而不是用 Cholesky 去解 \mathbf{X}^\top\mathbf{X}\mathbf{w} = \mathbf{X}^\top\mathbf{y}?
查看答案
形成 \mathbf{X}^\top\mathbf{X} 会使条件数平方,因舍入而损失的位数大致翻倍;QR 和 SVD 直接处理 \mathbf{X}。
二次函数上的梯度下降
正规方程一步就解出最小二乘。梯度下降(gradient descent)则通过迭代来解它,
其中步长 \eta > 0 称为学习率(learning rate)。已有闭式解时仍要迭代,有三个理由。代价:求解约需 Nd^2 + d^3 次运算,而一步梯度只需约 Nd 次,即两次矩阵-向量乘法。内存:求解需要同时拿到全部数据,而第 4 节的随机步只需要几行。普适性:模块 02起的所有模型都没有闭式解,训练它们的都是梯度下降。最小二乘是唯一一个能精确推导梯度下降行为的情形,所以在这里推导。经验法则:d 小时调用 lstsq;N 或 d 很大,或数据以流的形式到来时,使用第 4 节的随机梯度下降;问题病态时,先对特征重新缩放(见下文)。
二次函数的精确分析
记 \mathbf{H} = \frac{2}{N}\mathbf{X}^\top\mathbf{X},即第 2 节的海森矩阵。把 \mathbf{w} = \mathbf{w}^\ast + \mathbf{e} 代入损失并展开:
由正规方程,中间一项为零。除以 N,
其梯度为 \nabla\mathcal{L}(\mathbf{w}) = \mathbf{H}(\mathbf{w} - \mathbf{w}^\ast)。损失就是它的最小值加上一个形状由 \mathbf{H} 决定的碗。跟踪误差 \mathbf{e}_t = \mathbf{w}_t - \mathbf{w}^\ast:在更新式两边同时减去 \mathbf{w}^\ast,得到
由于 \mathbf{H} 是对称的,它有一组标准正交的特征向量基,\mathbf{H} = \mathbf{Q}\boldsymbol{\Lambda}\mathbf{Q}^\top,特征值为 \lambda_{\min} = \lambda_1 \le \dots \le \lambda_{d+1} = \lambda_{\max},全部非负。在旋转后的坐标 \tilde{\mathbf{e}} = \mathbf{Q}^\top\mathbf{e} 下,矩阵 \mathbf{I} - \eta\mathbf{H} 变成对角矩阵 \mathbf{I} - \eta\boldsymbol{\Lambda},每个分量各自独立演化:
关于二次函数上的学习率,所有该知道的都包含在这一行里了。
稳定性
只有当对每个 i 都有 |1 - \eta\lambda_i| < 1,即 0 < \eta\lambda_i < 2 时,每个分量才会从任何起点出发都收缩。最陡的方向最先达到限制:
随着 \eta 增大,观察最陡方向的因子 1 - \eta\lambda_{\max}(图 1.2 在同一个问题上展示了第一、第三和第五种情形):
- \eta < 1/\lambda_{\max}:每个因子都在 0 和 1 之间,每个分量单调收缩,不变号。
- \eta = 1/\lambda_{\max}:最陡方向的因子为 0,该分量一步就解决。
- 1/\lambda_{\max} < \eta < 2/\lambda_{\max}:最陡方向的因子为负,介于 −1 和 0 之间。该分量每一步都变号,所以迭代点在谷中来回之字形穿越,同时收敛。
- \eta = 2/\lambda_{\max}:因子为 −1,该分量永远翻转符号,既不增长也不衰减。
- \eta > 2/\lambda_{\max}:因子小于 −1,该分量按几何级数增长;损失爆炸。
边界是尖锐的。实验 1 在 2/\lambda_{\max} 的 0.99 倍和 1.01 倍处各运行 200 步,前者得到的训练 MSE 为 0.0104,后者为 3.8\times10^3。
在 \kappa = 10 的二维二次函数上做梯度下降,其特征向量相对坐标轴旋转了 30°:等高线是围绕最小值点 \mathbf{w}^\ast 的椭圆,坐标轴 w_1 和 w_2 的比例相同。三条路径从同一点出发。\eta = 0.5/\lambda_{\max} 时(陡方向的因子为 0.5,平坦方向为 0.95),路径平滑,沿着谷底缓慢爬行;\eta = 1.8/\lambda_{\max} 时(因子为 −0.8 和 0.82),路径在谷中呈之字形穿越,同时收敛;\eta = 2.1/\lambda_{\max} 时(因子为 −1.1 和 0.79),路径向外弹开并发散。图例给出了每个 \eta 及其两个因子。
速度
稳定性由最陡的方向决定;速度则由最平坦的方向决定。误差范数每步至多收缩 \rho(\eta) = \max_i|1 - \eta\lambda_i|,即绝对值最大的因子(旋转 \mathbf{Q} 保持范数)。由于 |1 - \eta\lambda| 作为 \lambda 的函数呈 V 形,它在各特征值上的最大值出现在两端之一:\rho = \max(|1 - \eta\lambda_{\min}|, |1 - \eta\lambda_{\max}|)。增大 \eta 会使第一项变小,而在超过 1/\lambda_{\max} 之后会使第二项变大。最优的固定步长使两者相等:
其中 \kappa = \lambda_{\max}/\lambda_{\min} 是 \mathbf{H} 的条件数(对于 \mathbf{H} \propto \mathbf{X}^\top\mathbf{X},按第 2 节的记号它等于 \kappa(\mathbf{X})^2)。把误差缩小为原来的 \epsilon 倍,需要 \rho^t \le \epsilon,即
这里用到 -\ln\rho^\ast = \ln(1 + 1/\kappa) - \ln(1 - 1/\kappa) \approx 2/\kappa。由 (3.1),超额损失是误差的二次函数,所以它按 \rho^{2t} 收缩。即使取最优的固定步长,步数也与 \kappa 成正比增长:这就是病态的代价。模块 02 第 7 节说明动量法如何把它降低到约 \sqrt{\kappa}。
取 \mathbf{H} = \operatorname{diag}(1, 10):\lambda_{\min} = 1,\lambda_{\max} = 10,\kappa = 10,稳定性要求 \eta < 2/10 = 0.2。数一数把误差缩小 10^6 倍所需的步数,t = \ln(10^6)/(-\ln\rho) = 13.82/(-\ln\rho),向上取整:
| \eta | 平坦方向因子 1 - \eta | 陡方向因子 1 - 10\eta | \rho | 步数 |
|---|---|---|---|---|
| 0.1 | 0.9 | 0.0 | 0.9 | 13.82/0.1054 = 131.1,即 132 |
| 0.18 | 0.82 | −0.80 | 0.82 | 13.82/0.1985 = 69.6,即 70 |
| 2/11 = 0.182 | 0.818 | −0.818 | 0.818 | 13.82/0.2007 = 68.8,即 69 |
| 0.21 | 0.79 | −1.10 | 1.10 | 发散 |
在 \eta = 0.1 时,陡方向的分量一步就消失,由平坦方向的分量决定节奏。把 \eta 提高到 0.18,步数几乎减半,代价是之字形振荡。最优值 \eta^\ast = 2/11 再省一步,其 \rho^\ast = 9/11 = (\kappa - 1)/(\kappa + 1)。刚刚越过极限,取 0.21 时,陡方向的分量每步被乘以 −1.1,50 步之后已经增长了 1.1^{50} = 117 倍。
条件数从何而来
条件数是特征的性质,可以直接从特征中读出。
单位。 若特征已中心化且互不相关,标准差为 s_j,则 \frac{1}{N}\mathbf{X}^\top\mathbf{X} 是对角矩阵:每个特征对应 s_j^2,截距对应 1,因为截距的全 1 列与每个中心化列都正交。于是 \kappa = (s_{\max}/s_{\min})^2(前提是截距的 1 介于两个极值之间)。设跨度长度以毫米计,标准差为 1000 mm,旁边是以吉帕计的弹性模量,标准差为 0.001 GPa,即批次间 1 MPa 的离散。两者的标准差相差 10^6 倍,所以 \kappa = 10^{12},即使取最优固定步长,梯度下降也需要约 (\kappa/2)\ln(10^6) \approx 6.9\times10^{12} 次迭代才能多得到六位有效数字。标准化之后 \kappa \approx 1。
偏移。 没有中心化的特征会与截距耦合。一个均值为 100、标准差为 1 的特征,与全 1 列放在一起,给出
因为非对角元是该特征的均值,右下角是它的均方,100^2 + 1^2。迹为 10002,行列式为 10001 - 10000 = 1,所以特征值约为 10002 和 1/10002 = 1.0\times10^{-4},\kappa \approx 1.0\times10^{8},而这只是来自一个尺度并不起眼的特征。当权重和截距一起变动,一个上升而另一个下降 100 倍时,损失几乎不变,这就是一个狭长平坦的山谷。仅仅中心化就能解决:减去均值,矩阵就变成单位矩阵。
相关。 两个相关系数为 r 的标准化特征,给出相关矩阵 \begin{bmatrix} 1 & r \\ r & 1 \end{bmatrix},其特征值沿 (1, 1) 为 1 + r,沿 (1, -1) 为 1 - r,所以 \kappa = (1 + r)/(1 - r):r = 0.9 时为 19,r = 0.99 时为 199。标准化解决的是单位问题,解决不了相关问题。
针对单位和偏移的补救办法是对每个特征做标准化(standardisation),x'_j = (x_j - \mu_j)/s_j,其中均值 \mu_j 和标准差 s_j 只在训练集上计算,并原样应用于验证数据、测试数据和使用中的输入。若在全部数据上计算它们,留出的行就会影响拟合:这是缩微版的泄漏,第 10 节会一般地讨论。标准化后的模型就是同一个模型换了坐标,所以它的权重可以精确地映射回去:
对于第 2 节的数据,\mathbf{H} = \frac{2}{200}\mathbf{X}^\top\mathbf{X} 的特征值为 1.711、1.922、2.126 和 2.207。标准正态特征本来就接近标准化,所以 \kappa = 2.207/1.711 = 1.29,\eta_{\max} = 2/2.207 = 0.906,\eta^\ast = 2/(2.207 + 1.711) = 0.511。从零出发做梯度下降,\eta = 0.1 时 76 步使 \|\mathbf{w} - \mathbf{w}^\ast\| 低于 10^{-6},\eta^\ast 时只要 7 步。
现在破坏单位:把第一个特征乘以 1000,仿佛米换成了毫米,并给第二个特征加上 100。条件数变为 1.0\times10^{10};单是缩放就给出 1.1\times10^{6},单是偏移就给出 1.0\times10^{8}。最大稳定步长降到 \eta_{\max} = 9.7\times10^{-7}。以 0.9\,\eta_{\max} 走了 100,000 步之后,训练 MSE 仍为 4.28,而同样的数据上 lstsq 给出 0.0100:梯度下降看上去像是没有学到东西,虽然模型本身毫无问题。用训练集统计量标准化之后,问题的 \kappa = 1.22,梯度下降在 \eta^\ast 下 6 步收敛,映射回原始单位的权重等于缩放不当那个问题的 lstsq 解。解决办法是变量替换,而不是新算法。
超越二次函数
在任何光滑的最小值点附近,损失都近似为二次函数,\mathbf{H} 是它在最小值点处的海森矩阵,所以 \eta < 2/\lambda_{\max}(\mathbf{H}) 同样决定模块 02中网络的局部稳定性。对于逻辑回归(第 6 节),曲率随 \mathbf{w} 变化,由最坏情形算出的界是充分而非必要的:在实验 2 中,损失在超过该界八倍以上的步长下仍然下降。
当 \mathbf{H} = \operatorname{diag}(2, 200) 时,最大的稳定学习率是多少,哪个坐标限制了速度?
查看答案
\eta < 2/200 = 0.01。即使在这个极限上,\lambda = 2 的坐标每步仍保留其误差的 1 - 0.01\cdot2 = 0.98,所以由它决定节奏:\kappa = 100。
为什么对特征做标准化,不能解决由特征相关造成的病态?
查看答案
标准化只是分别重新缩放每根坐标轴。相关使椭圆形的等高线沿对角线 (1, 1) 和 (1, -1) 倾斜并拉伸,而相关矩阵的特征值 1 \pm r,无论怎样缩放坐标轴,都仍然相距甚远。
在原始特征上做梯度下降“学不到东西”。说出最先要检查的两件事。
查看答案
中心化和缩放:计算 \mathbf{X}^\top\mathbf{X}/N 的 \kappa。然后检查学习率与 2/\lambda_{\max} 的关系。
随机梯度下降与小批量梯度下降
经验风险的梯度是对全部 N 个示例的平均,所以精确计算它,每一步都要遍历一遍数据。随机梯度下降(stochastic gradient descent,SGD)把它替换成对随机抽取的、含 B 个示例的mini-batch \mathcal{B} 的平均:
其中 \ell_i(\theta) = \ell(f_\theta(\mathbf{x}_i), y_i)。B = N 就是第 3 节的全 batch 梯度下降;B = 1 是 SGD 的原始形式。
无偏,方差按 1/B 下降
从 1, \dots, N 中独立、均匀地(有放回地)抽取 B 个下标。于是每个被抽中的梯度 \nabla\ell_{i_k} 都是一个随机向量,均值为 \frac{1}{N}\sum_i\nabla\ell_i = \nabla\mathcal{L},协方差为
即逐示例梯度的离散程度。由期望的线性性,\E[\mathbf{g}_{\mathcal{B}}] = \nabla\mathcal{L}:mini-batch 梯度是无偏的。独立性使 B 项的协方差相加,而因子 1/B 是以平方形式进入的:
batch 大四倍,噪声的标准差减半,代价却是四倍。无放回抽样(如对数据洗牌后依次遍历)会把协方差乘以 (N - B)/(N - 1):略小一些,并且在 B = N 时恰为零,此时 batch 就是整个数据集。
遍历一遍数据,即一个轮次(epoch),是 \lceil N/B\rceil 次更新而不是一次,对线性模型而言每次更新的代价约为 Bd 而不是 Nd 次运算。远离最小值点时,各示例的梯度大体一致,所以一步 mini-batch 更新几乎取得与完整一步相同的进展,而代价只是其一小部分;这就是 SGD 在大数据上取胜的原因。实践中:每个轮次都重新洗牌,因为按顺序存放的数据(按类别、按时间、按机器)否则会给出并非整体样本的 batch;固定随机种子以便复现运行;B 取在 32 到几千之间。语言模型用数百万 token 的 batch 来训练,原因见模块 08 第 6 节。
在 N = 50,000 个示例、B = 64 的情况下,N/B = 781.25,所以一个轮次是 \lceil 781.25\rceil = 782 次更新,最后一次的 batch 只有 50{,}000 - 781\cdot64 = 16 个示例。二十个轮次共 15,640 次更新。同样遍历二十遍数据,全 batch 梯度下降只做 20 次更新。
完成这一过程的循环,接续第 2 节的代码:
rng = np.random.default_rng(1)
w = np.zeros(d + 1); eta, B = 0.1, 32
for epoch in range(50):
    order = rng.permutation(N)                       # reshuffle every epoch
    for k in range(0, N, B):
        idx = order[k:k + B]                         # the last batch holds 8 rows
        grad = (2 / len(idx)) * Xb[idx].T @ (Xb[idx] @ w - y[idx])
        w -= eta * grad
excess = np.mean((Xb @ w - y) ** 2) - np.mean((Xb @ w_lstsq - y) ** 2)
print(np.round(w, 3), f"excess loss {excess:.1e}")
[ 1.489 -2.016 0.507 0.688] excess loss 1.3e-04
经过 350 次更新后,权重接近最小二乘解,但并未落在其上,而且在同样步长下增加轮次也不会使它们更接近。原因是本节其余部分的主题。
噪声下限
在最小值点处,完整梯度为零,但逐示例梯度不为零,所以 mini-batch 梯度也不为零,迭代点会继续移动。取一维二次函数 \mathcal{L}(\theta) = \mathcal{L}(\theta^\ast) + \frac{1}{2}\lambda(\theta - \theta^\ast)^2,把 mini-batch 梯度建模为真实梯度 \lambda(\theta - \theta^\ast) 加上噪声 \xi_t,噪声每一步重新抽取,均值为零,方差为 s^2/B,其中 s^2 是逐示例梯度的方差。更新给出
两边平方并取期望。交叉项消失,因为 \xi_t 均值为零,且独立于由先前 batch 决定的 \theta_t。令 V_t = \E[(\theta_t - \theta^\ast)^2],
对于稳定的步长 |1 - \eta\lambda| < 1,到不动点的距离 V_t - V 每步按 (1 - \eta\lambda)^2 收缩,所以 V_t 收敛到满足 V = (1 - \eta\lambda)^2V + \eta^2s^2/B 的 V。利用 1 - (1 - \eta\lambda)^2 = \eta\lambda(2 - \eta\lambda):
固定步长不会收敛。迭代点在 \theta^\ast 周围徘徊,方差为 V,期望超额损失为 \frac{1}{2}\lambda V = \eta s^2/\big(2B(2 - \eta\lambda)\big):一个正比于 \eta/B 的噪声下限(noise floor)。
取 \lambda = 1,s^2 = 1。B = 1、\eta = 0.1 时,V = 0.1/(1\cdot1\cdot1.9) = 0.0526,超额损失为 \frac{1}{2}\cdot0.0526 = 0.0263;对该递推式做 400,000 步模拟,测得 V = 0.0526。\eta = 0.01 时,V = 0.01/1.99 = 0.00503,超额损失为 0.00251。B = 10、\eta = 0.1 时,V = 0.1/(10\cdot1.9) = 0.00526。步长缩小十倍,或 batch 增大十倍,都能把下限降低约十倍:缩小步长的代价是进展变慢,增大 batch 的代价是每次更新的成本变为十倍。
降到下限以下
有两条路可以降下来。增大 batch,它把下限除以 B,代价是每次更新的成本成比例增加;或者让步长衰减。罗宾斯(Robbins)和门罗(Monro)(1951)给出了步长调度 \eta_t 使迭代点收敛的条件:
第一个条件使各步加起来可以走到任意远的距离,所以迭代点能从任何起点到达最小值点。第二个条件限制各步注入的噪声,其方差在上面的递推式中以 \eta_t^2s^2/B 的形式出现。调度 \eta_t = \eta_0/(1 + t/\tau) 同时满足两者:在最初约 \tau 次更新内它保持在 \eta_0 附近,之后表现得像 \eta_0\tau/t,其和像 \ln t 一样发散,而其平方和收敛。
回到第 3 节的小部件,把它的梯度噪声滑块 \sigma_g 调大:损失先像以前一样下降,然后在预测下限的虚线处变平。当 \kappa = 20、\sigma_g = 0.3 时,\eta = 0.1 的下限是 0.0046,把 \eta 减半到 0.05,下限也减半,为 0.0023。步长较大时,因子 2 - \eta\lambda 也会起作用:\eta = 0.5 时下限为 0.0264,\eta = 1.0 时为 0.0681。
对最小二乘而言,最优点处的逐示例梯度是 2\mathbf{x}_i(\mathbf{x}_i^\top\mathbf{w}^\ast - y_i) = -2\mathbf{x}_ir_i,其中 r_i 为残差。若残差与输入独立,方差为 \sigma^2,则其协方差为 4\sigma^2\cdot\frac{1}{N}\mathbf{X}^\top\mathbf{X} = 2\sigma^2\mathbf{H}:沿特征值为 \lambda_i 的 \mathbf{H} 的特征向量,梯度噪声的方差为 2\sigma^2\lambda_i。沿每个特征向量应用 (4.1),并对超额损失 \frac{1}{2}\lambda_iV_i 求和,
取实验 1 的 \sigma^2 = 0.0100 和第 3 节的特征值,并取 50 个轮次中后半段的平均超额训练损失作为实测值:
| B | \eta | 实测 | 预测 |
|---|---|---|---|
| 32 | 0.1 | 1.0\times10^{-4} | 1.4\times10^{-4} |
| 10 | 0.1 | 3.1\times10^{-4} | 4.4\times10^{-4} |
| 1 | 0.01 | 2.7\times10^{-4} | 4.0\times10^{-4} |
| 1 | 0.03 | 1.3\times10^{-3} | 1.2\times10^{-3} |
| 1 | 0.1 | 9.6\times10^{-3} | 4.4\times10^{-3} |
预测与实测相差在约两倍之内,并且正确给出了随 \eta/B 变化的比例关系。大多数实测下限都低于预测,因为每个洗牌后的轮次恰好使用每个示例一次,这抵消了一部分噪声;若改用独立抽取的 batch,同样的运行结果落在预测值或其上方,最多高出约一半(B = 32 时为 2.0,对应预测的 1.4\times10^{-4})。在 B = 1、\eta = 0.1 时,实测是预测的两倍,因为模型忽略了梯度噪声中随离最优点距离增大的那一部分,而这里这段距离最大。用衰减步长 \eta_t = 0.1/(1 + t/200)、B = 1,在 10,000 次更新的最后一次之后,超额损失为 3\times10^{-6},在最后一个轮次上平均约为 2\times10^{-5}:低于表中每一个固定步长的下限(图 1.3)。
实验 1 的回归中,超额训练损失 \mathcal{L}(\mathbf{w}_t) - \mathcal{L}(\mathbf{w}^\ast)(对数刻度)随更新次数(对数刻度)的变化。四条曲线:\eta = 0.1 的全 batch 梯度下降(每个轮次更新一次,平滑);\eta = 0.1、B = 32(下降很快,随后在 10^{-4} 附近变平);\eta = 0.1、B = 1(有噪声,在 10^{-2} 附近变平);以及 B = 1、\eta_t = 0.1/(1 + t/200)(持续下降,低于各固定步长的下限)。虚线水平线标出两次 B < N 的固定步长运行的预测下限。由实验 1 生成。
选择学习率
曲率已知时,例如最小二乘,从 2/\lambda_{\max} 出发,并保持在它之下留出安全系数。否则就去测量:在对数刻度上以约 3 倍的间隔,从 10^{-4} 到 1(0.0001、0.0003、0.001、……、0.3、1)做一次学习率的短扫描,每个跑几百次更新,取损失平稳下降的最大 \eta,并在整个运行中让它衰减。然后在对数刻度上读损失曲线:
- 上升,或几步之内出现 NaN:\eta 超出了稳定极限;把它除以 3 到 10;
- 笔直但平缓的下降:\eta 太小,或问题是病态的;先计算 \kappa,再考虑提高 \eta;
- 下降之后变成有噪声的平台:噪声下限;让步长衰减或增大 batch,不要把平台当作收敛。
动量法和 Adam 见模块 02 第 7 节和第 8 节,学习率范围测试和学习率调度见该模块的第 9 节。
噪声、平坦极小点与非凸损失
噪声还有第二重作用,可能是有益的:小 batch 倾向于找到更平坦的极小点,而更平坦的极小点倾向于泛化得更好。Keskar 等人(2017)观察到,大 batch 训练网络会收敛到更尖锐、泛化更差的极小点。这是一个经验观察,只有部分理论解释,而不是定律,平坦程度与泛化之间的联系仍有争论。
对于非凸模型,也就是模块 02 起的每一个模型,梯度下降找到的是局部极小点或鞍点,并不保证它是最好的那个。实践中,对于大型网络,找到的极小点通常已经足够好,困难在别处:在条件数、参数初始化和学习率上,这些由模块 02 处理。
在固定步长下把 batch 加倍:梯度噪声的方差和下限会怎样?
查看答案
两者都减半,代价是每次更新的成本加倍。
为什么 SGD 必须让步长衰减才能收敛,而全 batch 梯度下降用固定步长就能收敛?
查看答案
逐示例梯度在最小值点处并不消失,所以 mini-batch 梯度在那里是有噪声的,固定 \eta 时,迭代点保持一个正比于 \eta/B 的平稳方差。全 batch 梯度在最小值点处恰好为零,所以固定步长就能在那里稳定下来。
损失从何而来:极大似然
第 2–4 节最小化的是平方误差,却没有问过:误差为什么要取平方,而不是比如取绝对值。本节回答这个问题,而答案会把一个看似随意的选择变成可以检验的假设:损失就是数据在噪声模型下的负对数似然。本模块中的每一个损失,以及训练本系列中每一个语言模型的交叉熵(cross-entropy),都来自这一条原则。讲它之前,需要先补一点概率知识。
概率知识回顾
随机变量(random variable)是在被观测之前取值不确定的量:应变片的下一个读数,下一条被检测焊缝的标签。离散随机变量有概率质量函数(probability mass function)p(y) = P(Y = y),其取值在 0 和 1 之间,总和为 1。连续随机变量有概率密度(probability density)p(y),概率是密度曲线下的面积,P(a \le Y \le b) = \int_a^b p(y)\,dy。密度不是概率。在分布集中的地方,它可以大于 1;只有它的积分必须等于 1。
本系列主要用到四种分布:
- 高斯分布(Gaussian):\mathcal{N}(y;\mu,\sigma^2) = (2\pi\sigma^2)^{-1/2}\exp\big(-(y-\mu)^2/(2\sigma^2)\big),均值为 \mu,方差为 \sigma^2。只要 \sigma < 0.399,它的峰值密度 1/(\sqrt{2\pi}\,\sigma) 就大于 1。
- 拉普拉斯分布(Laplace):(2b)^{-1}\exp(-\lvert y-\mu\rvert/b),均值为 \mu,方差为 2b^2。与方差相同的高斯分布相比,它的峰更尖,尾部更重:在 y = \mu 处,单位方差下它的密度是 1/\sqrt2 = 0.707,高斯分布则是 0.399。
- 伯努利分布(Bernoulli),用于 y \in \{0, 1\}:p^y(1-p)^{1-y},即 y = 1 时为 p,y = 0 时为 1 - p。
- 类别分布(categorical),用于 y \in \{1, \dots, K\}:\prod_k p_k^{[y=k]},其中 [y = k] 在 y = k 时为 1,否则为 0,所以这个乘积恰好取出 p_y。
期望(expectation)\E[X] 是 X 按概率加权的平均(对质量函数求和,对密度求积分),方差(variance)是 \operatorname{Var}(X) = \E[(X - \E[X])^2]。由定义可得三条规则。对常数 a 和 c,\E[aX + c] = a\E[X] + c,\operatorname{Var}(aX + c) = a^2\operatorname{Var}(X);对独立的 X 和 Y,\operatorname{Var}(X + Y) = \operatorname{Var}(X) + \operatorname{Var}(Y)。第 8 节用它们计算拟合曲线的方差,第 12 节用它们计算拟合出的材料常数的不确定度。
当联合概率可以分解为 p(y_1, y_2) = p(y_1)\,p(y_2) 时,两个随机变量是独立的。关于数据集的标准假设是:各样本独立同分布(independent and identically distributed,i.i.d.),即每个样本都从同一个 P 中单独抽取。于是整个数据集的概率就是各样本概率的乘积。工程数据经常违背这一假设。同一个试件的十次测量共享该试件的特质;同一个传感器的连续读数共享它的漂移。把它们当作独立样本,会高估它们所含的证据量;若再把它们随机分到训练集和测试集,信息就会跨越划分泄漏(分组泄漏与时间泄漏,见第 10 节)。
似然,以及为什么取对数
设模型为每一个可能的输出赋予一个概率或密度 p(y \mid \mathbf{x};\theta)。对 i.i.d. 数据,似然(likelihood)为
它被看作 \theta 的函数,数据固定不变。它不是 \theta 上的概率分布:它对 \theta 的积分不必为 1,它说明的是每个 \theta 对数据的解释程度,而不是 \theta 本身有多大概率。极大似然估计(maximum likelihood estimation)选取使观测数据最可能出现的那个 \theta。
实践中人们转而最大化对数似然(log-likelihood)\sum_i \ln p(y_i \mid \mathbf{x}_i;\theta),原因有二。对数函数单调递增,所以最大值点不变。而且许多概率相乘会下溢:一千个 0.1 相乘得到 10^{-1000},远小于最小的双精度规格化数(约 2.2\times10^{-308}),乘积被存成 0.0,每个 \theta 看起来都同样糟糕。而对数之和 1000\ln 0.1 = -2302.6 是一个正常的数。
import numpy as np

probs = np.full(1000, 0.1)                 # a thousand events, each of probability 0.1
print(np.prod(probs))                      # the likelihood itself underflows
print(f"{np.log(probs).sum():.1f}")        # the log-likelihood is an ordinary number
0.0
-2302.6
高斯噪声给出平方误差
假设数据由 y = f_\theta(\mathbf{x}) + \varepsilon 生成,其中 \varepsilon \sim \mathcal{N}(0, \sigma^2),各样本之间相互独立。那么给定 \mathbf{x} 时 y 服从均值为 f_\theta(\mathbf{x}) 的高斯分布,对数似然为
第一项与 \theta 无关。第二项是平方误差之和乘以负常数 -1/(2\sigma^2)。因此,对 \theta 最大化对数似然,就是最小化 \sum_i (y_i - f_\theta(\mathbf{x}_i))^2,它是第 2 节中均方误差的 N 倍。\sigma 的取值会缩放并平移目标函数,却不会移动它的最大值点:在任意宽度的高斯噪声下,最小二乘都是极大似然拟合。
噪声水平本身也可以用极大似然来估计。令 v = \sigma^2,并令 r_i = y_i - f_{\hat\theta}(\mathbf{x}_i) 为拟合模型的残差,再令关于 v 的导数为零:
这个估计偏低,原因与第 1 节中训练损失偏低相同:残差是被拟合过程压小的。对于有 p 个参数的线性模型,\E[\sum_i r_i^2] = (N - p)\sigma^2,这是一个标准结果(Hastie et al. 2009,第 3.2 节),用第 2 节的帽子矩阵(hat matrix)\mathbf{P} 一行就能证明。残差为 \mathbf{r} = (\mathbf{I} - \mathbf{P})\mathbf{y} = (\mathbf{I} - \mathbf{P})\boldsymbol{\varepsilon},因为 (\mathbf{I} - \mathbf{P})\mathbf{X} = \mathbf{0},所以
(中间一步用到:\mathbf{I} - \mathbf{P} 对称且幂等,所以 \lVert(\mathbf{I} - \mathbf{P})\boldsymbol{\varepsilon}\rVert^2 = \boldsymbol{\varepsilon}^\top(\mathbf{I} - \mathbf{P})\boldsymbol{\varepsilon};还用到:对方差为 \sigma^2 的独立噪声,\E[\boldsymbol{\varepsilon}^\top\mathbf{A}\boldsymbol{\varepsilon}] = \sigma^2\operatorname{tr}\mathbf{A}。)
残差落在模型够不到的 N - p 个维度里,只有这些维度上的噪声才会体现在残差中。因此无偏估计要除以 N - p。这正是第 2 节中残差均方根 0.1000(即极大似然估计的 \hat\sigma)与 \sqrt{\text{RSS}/(N-4)} = 0.1010 之间的差别。
某模型在三个点上留下的残差为 \mathbf{r} = (0.1, -0.2, 0.3),并假设噪声的 \sigma = 0.2。
- 常数项:-3\ln(\sqrt{2\pi}\times 0.2) = -3\ln 0.5013 = -3\times(-0.6905) = 2.0715。
- 数据项:0.01 + 0.04 + 0.09 = 0.14,而 0.14/(2\times 0.04) = 1.75。
- 对数似然:2.0715 - 1.75 = 0.3215。
它是正的,因为三个密度值 1.760、1.210 和 0.648 大多高于 1;峰值为 1/(\sqrt{2\pi}\times 0.2) = 1.995。对数似然为正并不是 bug。
极大似然的噪声水平为 \hat\sigma^2 = 0.14/3 = 0.0467,所以 \hat\sigma = 0.216。代入,并利用 \sum_i r_i^2 = N\hat\sigma^2,对数似然变为 -\tfrac{3}{2}\ln(2\pi\times 0.0467) - \tfrac{3}{2} = 1.8403 - 1.5 = 0.3403:比 \sigma = 0.2 时更高,这正是最大值应有的表现。
拉普拉斯噪声给出绝对误差
如果 \varepsilon 服从拉普拉斯密度,那么单个样本的负对数似然为 \ln(2b) + \lvert y - f_\theta(\mathbf{x})\rvert/b,极大似然最小化的是 \sum_i \lvert y_i - f_\theta(\mathbf{x}_i)\rvert,即绝对误差。这两种损失的差别,在最简单的模型,即常数预测 c 上看得最清楚。对平方误差,\sum_i (y_i - c)^2 的导数为 -2\sum_i (y_i - c),在均值处为零。对绝对误差,\sum_i \lvert y_i - c\rvert 的导数为 -\sum_i \operatorname{sign}(y_i - c),当高于 c 的点与低于 c 的点一样多时为零:即在中位数处。均值对每个点的响应与其距离成正比;中位数只数两侧各有多少个点。这就是绝对误差拟合对离群值(outlier)稳健、而平方误差拟合不稳健的原因。
五个读数 y = (1.0, 1.2, 0.9, 1.1, 5.0),最后一个是故障读数。
- 平方误差选择均值:(1.0 + 1.2 + 0.9 + 1.1 + 5.0)/5 = 9.2/5 = 1.84,比五个读数中的四个都高。
- 绝对误差选择中位数,即排序后 (0.9, 1.0, 1.1, 1.2, 5.0) 的中间值:1.1。
若没有这个故障读数,两者都是 1.05。故障读数使均值移动了 0.79,使中位数只移动了 0.05。
再看一个离群值对两种模型的代价:噪声方差为 1,残差 r = 5。高斯负对数似然去掉常数项后为 r^2/(2\sigma^2) = 25/2 = 12.5。方差相同的拉普拉斯分布有 2b^2 = 1,所以 b = 1/\sqrt2,它的代价为 \lvert r\rvert/b = 5\sqrt2 = 7.07。二次代价随残差增长得更快,所以一个坏点就能拉动最小二乘拟合。
Huber 损失在残差较小时是二次的,超过阈值后是线性的,是两者之间常用的折中;模块 02 第 12 节会用到它。
每个点噪声不同:加权最小二乘
测量往往带有各自的不确定度:称重传感器在量程下端精度较差,扰动期间的读数被标记为质量不佳。如果第 i 个点的噪声标准差 \sigma_i 已知,高斯负对数似然为
第一个和式不含 \theta,所以极大似然最小化的是 \sum_i w_i (y_i - f_\theta(\mathbf{x}_i))^2,权重为 w_i = 1/\sigma_i^2。这就是加权最小二乘(weighted least squares):精确的点对拟合拉力大,不确定的点拉力小。第 12 节中水凝胶拟合的似然就是这种形式,那里每个应力读数都带有自己的不确定度。
小结配方
| 噪声模型 | 损失(负对数似然) | 最佳常数预测 |
|---|---|---|
| 高斯 | 平方误差 | 均值 |
| 拉普拉斯 | 绝对误差 | 中位数 |
| 伯努利 | 二元交叉熵 | 类别 1 的频率 |
| 类别分布 | 交叉熵 | 各类别的频率 |
按行横着读:假设高斯噪声、用平方误差拟合、用均值概括样本,这是同一个决定,而不是三个。后两行是第 6 节的分类器;它们的最佳常数用同样的办法求得,即令导数为零。
损失就是某个噪声模型下的负对数似然。选择损失,就是选择你对噪声的看法。
平均负对数似然有一个名字,它在整个系列中反复出现。对数据分布 p_\text{data} 和模型分布 p_\theta,在期望内加上再减去 \ln p_\text{data},得到
左边是交叉熵 H(p_\text{data}, p_\theta)。它分成两部分:数据的熵,任何 \theta 的选择都无法改变它;以及 Kullback–Leibler 散度(KL 散度),它永不为负,仅当 p_\theta = p_\text{data} 时为零。因此最大化似然会把模型的分布推向数据的分布。模块 07 第 1 节用困惑度(perplexity)报告语言模型的质量,它正是这个交叉熵(对留出文本、按每个 token 计算)的 \exp。
对 \theta 加上先验分布,极大似然就变成最大后验(MAP)估计,先验的对数则成为对参数的惩罚:第 9 节用这种方式推导岭回归和 Lasso 回归。
你的代码算出了 2.0 这个密度值。有问题吗?
查看答案
不一定。密度不是概率:在分布集中的地方它会超过 1(\sigma = 0.1 的高斯分布峰值为 3.99)。只有它的积分必须等于 1。
为什么高斯噪声下的极大似然 \theta 不依赖于 \sigma?
查看答案
\sigma 在对数似然中以两种方式出现:作为平方和前面的正因子 1/(2\sigma^2),以及作为与 \theta 无关的项 -N\ln(\sqrt{2\pi}\,\sigma)。两者都不会改变哪个 \theta 使平方和最小。
如果每次测试中都有少数几个大小未知的故障读数,你会选哪种损失?
查看答案
绝对误差或 Huber 损失,它们对应重尾噪声模型;或者显式地处理离群值。平方误差对故障读数的代价是其大小的平方,所以一个故障读数就能拉动整个拟合。
逻辑回归与 softmax 回归
回归预测一个数;分类预测 K 个标签之一:有缺陷还是合格,良性还是恶性,文本的下一个 token。第 5 节表中的伯努利行和类别分布行已经给出了损失。缺的是一个输出为概率的模型。本节构建线性的那种,推导它的梯度和曲率,并说明它如何失效。
由线性得分得到概率
对 y \in \{0, 1\},逻辑回归(logistic regression)的模型是
截距像第 2 节那样吸收进 \mathbf{w}。这里的 \sigma 是逻辑(sigmoid)函数,不是标准差。它把任意实数得分 z(即 logit)映射到 (0, 1)。下面要用到它的两条性质。第一,\sigma(-z) = 1 - \sigma(z)。第二,它的导数为
由 p = \sigma(z) 解出 z,得 z = \ln\big(p/(1-p)\big),即几率(odds)的对数。所以逻辑回归关于对数几率(log-odds)是线性的:\ln(p/(1-p)) = \mathbf{w}^\top\mathbf{x}。把特征 j 增加一个单位,对数几率增加 w_j,几率乘以 e^{w_j}。系数 0.7 使每个单位的几率翻倍(e^{0.7} = 2.01)。拟合出的系数就是这样解读的。
损失及其梯度
单个样本的伯努利负对数似然(令 \hat p = \sigma(z))就是二元交叉熵(binary cross-entropy)
它对 logit 的导数由链式法则分两个因子得到:
sigmoid 的导数抵消了两个分母,剩下的是预测值减观测值。由 z_i = \mathbf{w}^\top\mathbf{x}_i 得 \partial z_i/\partial\mathbf{w} = \mathbf{x}_i,所以平均损失的梯度为
与最小二乘梯度 \frac{2}{N}\mathbf{X}^\top(\mathbf{X}\mathbf{w} - \mathbf{y}) 形状相同,只是用 \hat{\mathbf{p}} 代替了 \hat{\mathbf{y}}(因子 2 来自平方)。
曲率、凸性与步长
再求一次导,\partial\hat p_i/\partial\mathbf{w} = \hat p_i(1-\hat p_i)\mathbf{x}_i,于是海森矩阵(Hessian)为
对任意 \mathbf{v},\mathbf{v}^\top\mathbf{H}\mathbf{v} = \frac{1}{N}\sum_i \hat p_i(1-\hat p_i)(\mathbf{x}_i^\top\mathbf{v})^2 \ge 0,所以 \mathbf{H} 半正定,损失是凸的:每个极小点都是全局极小点。但梯度关于 \mathbf{w} 是非线性的,令它为零没有闭式解。可选的办法有:梯度下降;牛顿法,在这里称为迭代重加权最小二乘(iteratively reweighted least squares),因为每一步牛顿迭代都在解一个以 \mathbf{S} 加权的最小二乘问题;或者拟牛顿法。scikit-learn 的默认求解器是 L-BFGS,一种拟牛顿法。
第 3 节的稳定性分析只需做一处改动就能沿用。由于 \hat p(1-\hat p) \le \tfrac14,在 \hat p = \tfrac12 处取等号,所以最大曲率满足 \lambda_{\max}(\mathbf{H}) \le \lambda_{\max}(\mathbf{X}^\top\mathbf{X}/N)/4,梯度下降在下式成立时可保证稳定:
这个界是充分条件,不是必要条件。只有当每个 \hat p_i 都接近 \tfrac12 时,曲率才达到最坏情形;随着拟合改善,大多数 \hat p_i 趋向 0 或 1,曲率远低于这个界。实验 2 算出其数据的界为 \eta < 0.59,而在它的扩展部分中,损失在 \eta = 5 时仍在下降。
为什么不用平方误差
经过 sigmoid 的平方误差 \tfrac12(\hat p - y)^2,其对 logit 的梯度为
多出来的因子 \hat p(1-\hat p) 在 \hat p 趋近 0 或 1 时会消失,这也包括模型信心十足却错了的情形,即 y = 0 而 \hat p 接近 1。此时交叉熵的梯度 \hat p - y 接近其最大值,而平方误差的梯度接近零:模型恰恰在错得最厉害的地方学得最慢(图 1.4,右)。经过 sigmoid 的平方误差关于 \mathbf{w} 也不是凸的:对 y = 0,它先上升,然后在 0.5 处变平,梯度下降可能停在平台上。一个信心十足却错了的模型必须能学得很快。练习 4 给出了这一差别的具体数字。
左:z 从 −6 到 6 的 sigmoid \sigma(z),以及它的导数 \sigma(z)(1 - \sigma(z)),导数在 z = 0 处达到峰值 0.25。右:y = 0 的单个样本的损失随 z 的变化:二元交叉熵 \operatorname{softplus}(z) = \ln(1 + e^z),它趋于斜率为 1 的直线;以及平方误差 \tfrac12\sigma(z)^2,它趋平于 0.5,斜率趋于零。z > 4 的区域被涂上阴影,并标注为“信心十足却错了”。
稳定地计算损失
把损失写成 logit 的函数更好。利用 \ln\sigma(z) = -\ln(1 + e^{-z})、\ln(1 - \sigma(z)) = \ln\sigma(-z) = -\ln(1 + e^{z}) 以及 \ln(1 + e^{-z}) = \ln(1 + e^{z}) - z,
若按朴素的方式计算,先算 \hat p = \sigma(z),再取它的对数,则在 \lvert z\rvert 很大时损失会失效。稳定的做法是计算 \operatorname{softplus}(z) = \max(z, 0) + \ln(1 + e^{-\lvert z\rvert}),其中的指数永远不会溢出;NumPy 以 np.logaddexp(0, z) 提供了它。模块 02 第 12 节把这一做法推广到多个 logit 的 log-sum-exp。
- z = 40,y = 1:\operatorname{softplus}(40) - 40 = 40 + \ln(1 + e^{-40}) - 40 = \ln(1 + 4.2\times10^{-18}) \approx 4.2\times10^{-18},在机器精度下就是 0.0。
- z = -40,y = 1:\operatorname{softplus}(-40) + 40 = 0 + \ln(1 + e^{-40}) + 40 = 40.0。
- z = 40,y = 0:\operatorname{softplus}(40) = 40.0。
按朴素方式,\sigma(40) = 1/(1 + 4.2\times10^{-18}) 在双精度下恰好舍入为 1.0。对 y = 0,损失变成 -\ln(1 - 1) = -\ln 0 = \infty,而不是 40。对 y = 1,没用到的那一项变成 0 \times \ln 0 = 0 \times (-\infty),浮点运算把它定义为 nan,于是一个正确的预测也会毒化平均损失。
import numpy as np

def sigmoid(z):
    return 1.0 / (1.0 + np.exp(-z))

def bce_naive(z, y):
    p = sigmoid(z)
    return -(y * np.log(p) + (1 - y) * np.log(1 - p))

def bce_stable(z, y):
    # softplus(z) - y*z, with softplus(z) = ln(1 + e^z) computed by logaddexp
    return np.logaddexp(0.0, z) - y * z

with np.errstate(divide="ignore", invalid="ignore"):
    for z, y in [(40.0, 1), (-40.0, 1), (40.0, 0)]:
        print(f"z = {z:5.1f}, y = {y}:  naive {bce_naive(z, y):5.1f}"
              f"  stable {bce_stable(z, y):5.1f}")
z =  40.0, y = 1:  naive   nan  stable   0.0
z = -40.0, y = 1:  naive  40.0  stable  40.0
z =  40.0, y = 0:  naive   inf  stable  40.0
决策边界
把截距再单独写出来,z = \mathbf{w}^\top\mathbf{x} + b。概率通过阈值 t 变成决策:当 \hat p \ge t 时预测 1。因为 \sigma 是递增的,\hat p \ge t 等价于 z \ge \ln\big(t/(1-t)\big)。在 t = 0.5 时,条件为 \mathbf{w}^\top\mathbf{x} + b \ge 0,而决策边界(decision boundary)\mathbf{w}^\top\mathbf{x} + b = 0 是以 \mathbf{w} 为法向量的超平面。点到它的有符号距离为 (\mathbf{w}^\top\mathbf{x} + b)/\lVert\mathbf{w}\rVert,所以 logit 等于 \lVert\mathbf{w}\rVert 乘以这个距离:\lVert\mathbf{w}\rVert 决定了点远离边界时概率变化的快慢。换一个阈值,边界会平行于自身移动,变为 \mathbf{w}^\top\mathbf{x} + b = \ln\big(t/(1-t)\big)。
无论给模型什么特征,边界在这些特征里都是平的。弯曲的边界需要弯曲的特征:加入 x_1^2、x_2^2 和 x_1x_2 后,边界可以是任意圆锥曲线,椭圆也在其中。模块 02 第 1 节中的同心圆就需要这样的特征,或者一个能学出这些特征的网络。
取 \mathbf{w} = (2, -1),b = 0.5,以及一个样本 \mathbf{x} = (1, 1),标签 y = 0。
- logit:z = 2\times1 + (-1)\times1 + 0.5 = 1.5。
- 概率:\hat p = 1/(1 + e^{-1.5}) = 1/1.2231 = 0.8176。
- 损失:-\ln(1 - 0.8176) = -\ln 0.1824 = 1.7014。
- 梯度:d\ell/dz = \hat p - y = 0.8176,所以 \nabla_{\mathbf{w}} = 0.8176\,\mathbf{x} = (0.8176, 0.8176),\partial\ell/\partial b = 0.8176。
- 取 \eta = 0.5 走一步:\mathbf{w} = (2 - 0.4088, -1 - 0.4088) = (1.5912, -1.4088),b = 0.5 - 0.4088 = 0.0912。
- 新的 logit 为 1.5912 - 1.4088 + 0.0912 = 0.2736,\hat p = 0.5680,损失为 -\ln 0.4320 = 0.8393。
这一步之前,该点位于边界错误一侧、距离为 1.5/\sqrt5 = 0.671 的地方;之后为 0.2736/2.1252 = 0.129。一步使损失减半,并把边界移过了通向该点的大半段路。
要求 \hat p \ge 0.9 才预测 1,意味着 z \ge \ln(0.9/0.1) = \ln 9 = 2.197。对上面的初始模型(\lVert\mathbf{w}\rVert = \sqrt5 = 2.236),边界从 \mathbf{w}^\top\mathbf{x} + b = 0 移到 \mathbf{w}^\top\mathbf{x} + b = 2.197:与原边界平行,并向正类一侧多移了 2.197/2.236 = 0.983。被标记的点更少了,而被标记的点信心更足。
左:二维空间中两个高斯团上的逻辑回归,图中有决策线 \mathbf{w}^\top\mathbf{x} + b = 0、\hat p = 0.1、0.5 和 0.9 处的平行等值线,以及垂直于决策线的权重向量 \mathbf{w}。右:三个团上的 softmax 回归:三个彩色的决策区域,其笔直的边界交于一点。
可分数据
假设某个超平面把两类完美分开:每个正例都有 z_i > 0,每个负例都有 z_i < 0。把 \mathbf{w} 和 b 乘以任意 c > 1。每个 logit 的绝对值变大而符号不变,每个 \hat p_i 都向其标签靠拢,每个样本的损失都下降。损失总能进一步降低,它的下确界 0 只有在 \lVert\mathbf{w}\rVert \to \infty 时才能逼近,极大似然估计不存在。梯度下降照此行事:\lVert\mathbf{w}\rVert 无限增长,概率在 0 和 1 处饱和,宣称了数据无法支持的确定性。这时需要对 \lVert\mathbf{w}\rVert 施加惩罚(第 9 节)或者早停。scikit-learn 的 LogisticRegression 默认带有 L2 惩罚(C=1.0),所以它从不出现这个问题;实验 2 去掉惩罚,观察 \lVert\mathbf{w}\rVert 从 100 步后的 3.2 增长到 100,000 步后的 51.2。
softmax 回归
对 K 个类别,模型计算 K 个 logit,\mathbf{z} = \mathbf{W}\mathbf{x},\mathbf{W} 的每一行 \mathbf{w}_k 对应一个类别,并用 softmax 把它们变成概率:
把损失对某个 logit z_k 求导。第二项给出 e^{z_k}/\sum_j e^{z_j} = \hat p_k。第一项在 k 是真实类别 y 时给出 -1,否则为 0。所以
这又是二元情形的模式:预测值减观测值,只是观测标签用独热编码表示。把预测概率堆成 \hat{\mathbf{P}}(N\times K)的各行,把独热标签堆成 \mathbf{Y} 的各行,就得到整个权重矩阵的梯度,
这是一个 K\times(d+1) 的矩阵,与 \mathbf{W} 的形状一致。
给每个 logit 加上同一个常数不会改变任何东西,因为 e^{z_k + c}/\sum_j e^{z_j + c} = e^{z_k}/\sum_j e^{z_j}。因此可以不失一般性地把某一个类别的权重固定为零。取 K = 2,
这就是权重为 \mathbf{w}_1 - \mathbf{w}_0 的逻辑回归。预测的类别是 logit 最大的那个,类别 j 与 k 在 (\mathbf{w}_j - \mathbf{w}_k)^\top\mathbf{x} + (b_j - b_k) = 0 处持平,这是一个超平面。每个决策区域都是若干半空间的交集,所以边界是分段线性的(图 1.5,右)。
logit \mathbf{z} = (2.0, 1.0, 0.1),真实类别为 0。
- 指数:e^{2.0} = 7.389,e^{1.0} = 2.718,e^{0.1} = 1.105;它们的和为 11.213。
- 概率:\hat{\mathbf{p}} = (7.389, 2.718, 1.105)/11.213 = (0.6590, 0.2424, 0.0986)。
- 损失:-\ln 0.6590 = 0.4170;等价地,-2.0 + \ln 11.213 = -2.0 + 2.4170 = 0.4170。
- 梯度:\hat{\mathbf{p}} - (1, 0, 0) = (-0.3410, 0.2424, 0.0986)。
梯度之和为零,这是平移不变性所要求的:三个 logit 一起平移不会改变损失,所以梯度在 (1, 1, 1) 方向上没有分量。
整个系列共用的一个输出层
logit、softmax 和交叉熵损失构成了本系列中每个分类器的输出层。语言模型就是这样一个分类器,它的类别是词表中的条目(几万到几十万个),在文本的每个位置上预测下一个 token(模块 07)。梯度 \hat p - y、它在可分数据上造成的过度自信,以及稳定计算对数的需要,都原样适用。
证明两类的 softmax 就是 z_1 - z_0 的 sigmoid。
查看答案
把 \hat p_1 = e^{z_1}/(e^{z_0} + e^{z_1}) 的分子和分母同除以 e^{z_1}:\hat p_1 = 1/(1 + e^{z_0 - z_1}) = 1/(1 + e^{-(z_1 - z_0)}) = \sigma(z_1 - z_0)。
在线性可分的数据上,不带正则化的逻辑回归的权重会不断增长。为什么?
查看答案
对一个分离超平面的 \mathbf{w}(连同截距)做任何正的缩放,都会降低每个样本的损失,所以损失只有在 \lVert\mathbf{w}\rVert \to \infty 的极限下才被最小化:极大似然估计不存在,梯度下降会一直沿着缩放方向前进。
度量模型:指标、阈值与校准
损失是优化器能够最小化的东西:光滑、可微、对样本取平均。指标(metric)则是决策所依赖的东西:漏掉了多少有缺陷的焊缝,报废了多少好焊缝,预测的下垂量与真实值相差多少毫米。两者很少是同一个量。分类器可能把交叉熵最小化得很好,却服务不好决策,比如决策要求在固定的假阳性率下取得高召回率时。先根据决策选指标;再选阈值,必要时选模型,去服务这个指标。
每一个报告出来的数字都要带上它的基线。 下垂量预测的 RMSE 为 0.3 mm,这本身没有意义,除非你知道预测均值得到的是 1.1 mm,而闭式求解器得到的是 0.05 mm:该模型远好于一无所知,又比物理模型差六倍。
回归指标
对 n 个留出样本上目标 y_i 的预测 \hat y_i,设它们的均值为 \bar y:
RMSE 的单位与 y 相同,并由最大的误差主导。MAE 单位相同,并且与第 5 节的中位数一样,对少数离群值稳健。R^2 来自第 2 节的勾股关系:它是模型所解释的 y 的方差占比,以预测均值为基线来度量。在带截距的训练数据上,它介于 0 和 1 之间。在留出数据上,它没有下界:比预测均值还差的模型有 \text{SS}_\text{res} > \text{SS}_\text{tot},R^2 为负。上面的下垂量模型有 R^2 = 1 - (0.3/1.1)^2 = 0.93,听上去极好,却掩盖了六倍的差距。像 \lvert y - \hat y\rvert/\lvert y\rvert 这样的百分比误差很流行,但当 y 可能接近零时就失效:微小的误差会变成巨大的百分比。
混淆矩阵
固定阈值的二分类器会产生四类结果:真阳性(TP)、假阳性(FP)、假阴性(FN)和真阴性(TN)。每个比率都是这些计数的比值:
- 准确率(accuracy)= (\text{TP} + \text{TN})/n;
- 精确率(precision)= \text{TP}/(\text{TP} + \text{FP}):在被标记的样本中,实为阳性的比例;
- 召回率(recall)= \text{TP}/(\text{TP} + \text{FN}),也称灵敏度(sensitivity)或真阳性率(TPR):在阳性样本中,被标记出来的比例;
- 特异度(specificity)= \text{TN}/(\text{TN} + \text{FP}),以及假阳性率(false-positive rate)\text{FPR} = \text{FP}/(\text{FP} + \text{TN}) = 1 - \text{特异度};
- F1 分数(F1)= 2\cdot\text{精确率}\cdot\text{召回率}/(\text{精确率} + \text{召回率}),是精确率与召回率的调和平均。
单个比率会掩盖究竟在犯哪一类错误,所以每次报告比率时都应给出混淆矩阵(confusion matrix)。F1 用调和平均而不用算术平均,是因为调和平均由较小的那个值主导:分类器无法靠牺牲精确率或召回率之一来换取另一个,从而得到好分数。
当类别不平衡时,准确率会产生误导。如果 1% 的样本是阳性,那么“一律判阴性”的规则准确率为 99%,却什么也找不到。
在 1,000 条焊缝中,有 50 条有缺陷。模型标记了 60 条,其中 40 条确有缺陷。于是 \text{TP} = 40,\text{FP} = 60 - 40 = 20,\text{FN} = 50 - 40 = 10,\text{TN} = 950 - 20 = 930。
- 准确率 (40 + 930)/1000 = 0.970;精确率 40/60 = 0.667;召回率 40/50 = 0.800。
- F1 = 2\times0.667\times0.800/(0.667 + 0.800) = 1.067/1.467 = 0.727。
- 特异度 930/950 = 0.979;FPR 20/950 = 0.021。
平凡规则“从不判有缺陷”的准确率为 0.950,召回率为 0。把每条焊缝都标记出来,召回率为 1,精确率为 0.05:它们的算术平均 0.525 会奖励这种做法,而 F1 是 2\times0.05\times1/1.05 = 0.095。
基础比率
精确率取决于阳性有多常见,贝叶斯公式确切地说明了这一点。设 \pi 为阳性率(prevalence),即阳性样本所占的比例。则
分母是被标记的概率,标记既可能来自阳性样本,也可能来自阴性样本。当 \pi 很小时,即使 FPR 很小,假标记 \text{FPR}\cdot(1-\pi) 也会在分母中占主导。对罕见事件而言,一个好的检测器会让使用者淹没在误报里。
TPR 0.95,FPR 0.05,阳性率 1%。每个样本上的真标记:0.95\times0.01 = 0.0095。假标记:0.05\times0.99 = 0.0495。精确率 = 0.0095/(0.0095 + 0.0495) = 0.161:每六个警报中有五个是假的。
阳性率 0.1%,TPR 0.90,FPR 0.01:0.0009/(0.0009 + 0.00999) = 0.083,误报与真报之比为 0.00999/0.0009 = 11 比 1。
排序:ROC 曲线与精确率-召回率曲线
输出得分的分类器可以在任何阈值下使用。把阈值从高扫到低,就描出 ROC 曲线(ROC curve),即 TPR 对 FPR 的曲线,从什么都不标记的 (0, 0) 到全部标记的 (1, 1)。它下面的面积,即 AUC,有直接的含义:它是随机选取的一个阳性样本得分高于随机选取的一个阴性样本的概率(即 Mann–Whitney 统计量,得分相同的情形按一半计)。所以可以通过数样本对来计算它。TPR 是在阳性样本中计算的,FPR 是在阴性样本中计算的,因此类别比例变化时两者都不变,AUC 也不变。这使 AUC 成为衡量模型排序能力的好指标,但在阳性稀少时具有误导性:1% 的假阳性率在 ROC 图上看起来很小,却可能占据大部分警报。
当阳性稀少时,应当看精确率-召回率曲线(precision-recall curve),即阈值扫过时精确率对召回率的曲线。它显示的是阅读警报的人将经历什么。它的汇总量平均精度(average precision)是在找到阳性样本的各召回率水平上对精确率取平均。它的基线不是二分之一:随机打分的分类器在每个召回率下的精确率都等于阳性率。
两个阳性样本得分为 0.8 和 0.6;两个阴性样本得分为 0.7 和 0.2。四个阳性-阴性样本对是 (0.8, 0.7)、(0.8, 0.2)、(0.6, 0.7) 和 (0.6, 0.2)。其中三对排序正确;(0.6, 0.7) 这一对排错了。AUC = 3/4 = 0.75。
选择阈值
阈值是一个决策,不是模型的属性。假设预测概率是校准的(定义见下文),假阳性的代价为 C_\text{FP},假阴性的代价为 C_\text{FN}。对于一个为阳性的概率是 p 的样本,标记它的期望代价为 (1 - p)\,C_\text{FP},即它实为阴性时承担的代价,而放过它的代价为 p\,C_\text{FN}。当 p\,C_\text{FN} > (1 - p)\,C_\text{FP} 时标记它,整理为
只有当两类错误的代价相同时,默认的 0.5 才是对的。另一种做法是施加约束,例如在验证数据的 ROC 曲线上读出能达到召回率不低于 0.99 的最低假阳性率。用最小化交叉熵训练出的模型,在服务于要求固定假阳性率下取得某种召回率的决策之前,仍然需要这两步之一。
当 C_\text{FN} = 20\,C_\text{FP} 时,t^\ast = C_\text{FP}/(C_\text{FP} + 20\,C_\text{FP}) = 1/21 = 0.048。缺陷概率高于 4.8% 的每条焊缝都要送去复检。
实验 2 对乳腺癌数据拟合逻辑回归,并在 143 个样本上测试,其中 53 个是恶性的(阳性类)。
- 阈值为 0.5 时:TN 90,FP 0,FN 2,TP 51。准确率 141/143 = 0.986,精确率 51/51 = 1.000,召回率 51/53 = 0.962。
- 基线:一律预测良性,得分为 90/143 = 0.629。
- 排序:AUC 0.996,平均精度 0.994。
- 要使召回率达到 1.0,需把阈值降到 0.116,这会同时标记 11 个良性样本:精确率为 53/64 = 0.828。
校准
本节为整个系列定义校准(calibration)。当模型的概率说到做到时,它就是校准的:在被赋予 \hat p = 0.8 的样本中,80% 是阳性。形式化地说,对每个 p 都有 P(y = 1 \mid \hat p = p) = p。只要概率是被当作概率来用的,校准就很重要:用在上面的代价阈值中,用在风险估计中,或者用来决定模型何时应当弃权。
可靠性图(reliability diagram)按 \hat p 把预测分到各个分箱里,并对每个分箱画出阳性的观测比例对平均预测概率的曲线;校准良好的模型落在对角线上(图 1.6 画的是实验 2 的)。期望校准误差(expected calibration error)概括了这张图。设分箱等宽,第 b 个分箱含有 N 个预测中的 n_b 个,平均预测概率为 \text{conf}_b,阳性比例为 \text{freq}_b,则
对于 K 个类别,或者对模型对问题的回答,常用的形式是对预测类别的置信度(即其最大概率)分箱,并把它与箱内的准确率比较:
这是 Guo et al. (2017) 的 top-label 形式;模块 02、07 和 09 使用它,并回头引用此处。
有三点需要注意。第一,要说明分箱方式:通常用 10 或 15 个等宽分箱,约一百个样本的测试集用 5 个,因为 ECE 会随分箱而变:实验 2 的预测在 5 个分箱下给出 0.023,在 10 个分箱下给出 0.039。第二,ECE 在小样本上有向上的偏差。即使是完美校准的模型,各分箱的频率也会围绕其置信度波动,而绝对值把这种波动变成了正的误差。第三,ECE 衡量的是校准,不是区分能力:对每个样本都预测基础比率的模型是校准的,却毫无用处。应当把 ECE 与 AUC 和布里尔分数(Brier score)\frac1N\sum_i(\hat p_i - y_i)^2 一起报告,后者是概率的均方误差。布里尔分数是一个适当评分规则(proper scoring rule):当预测概率就是真实概率时,它的期望最小,所以它同时奖励校准和区分能力。
import numpy as np

def ece_binary(p, y, n_bins=10):
    """Binary ECE of probabilities p against labels y in {0, 1}, equal-width bins."""
    edges = np.linspace(0.0, 1.0, n_bins + 1)
    bins = np.clip(np.digitize(p, edges[1:-1]), 0, n_bins - 1)
    ece = 0.0
    for b in range(n_bins):
        in_bin = bins == b
        if in_bin.any():                       # empty bins contribute nothing
            gap = abs(y[in_bin].mean() - p[in_bin].mean())
            ece += in_bin.mean() * gap         # weight n_b / N
    return ece

# the three-bin example below: 50 cases at 0.2 (5 positive), 30 at 0.5 (15), 20 at 0.9 (14)
p = np.repeat([0.2, 0.5, 0.9], [50, 30, 20])
y = np.concatenate([np.r_[np.ones(5), np.zeros(45)],
                    np.r_[np.ones(15), np.zeros(15)],
                    np.r_[np.ones(14), np.zeros(6)]])
print(f"ECE   {ece_binary(p, y):.4f}")
print(f"Brier {np.mean((p - y) ** 2):.4f}")
ECE   0.0900
Brier 0.1750
一百个预测落入三个分箱:
| 分箱 | 预测数 | 平均置信度 | 观测频率 | 差距 |
|---|---|---|---|---|
| 低 | 50 | 0.20 | 0.10 | 0.10 |
| 中 | 30 | 0.50 | 0.50 | 0.00 |
| 高 | 20 | 0.90 | 0.70 | 0.20 |
\text{ECE} = (50\times0.10 + 30\times0 + 20\times0.20)/100 = (5 + 0 + 4)/100 = 0.09。在高分箱中,模型说的是 0.9,却只有 70% 的时候是对的:过度自信。
在实验 2 的测试集上,对 143 个样本全部预测训练集中的阳性率 159/426 = 0.373。它们全部落在同一个分箱里,该分箱的观测频率为 53/143 = 0.371,所以 ECE = \lvert 0.371 - 0.373\rvert = 0.003,低于拟合模型的 0.023。然而每个得分都相同,所以 AUC 为 0.500,而布里尔分数为 (53\times0.627^2 + 90\times0.373^2)/143 = 0.233,拟合模型则为 0.023。
长时间用交叉熵训练的模型往往过度自信,因为损失会持续奖励那些已被正确分类的训练样本上更大的 logit。补救办法是在留出数据上重新校准。普拉特缩放(Platt scaling)拟合一个从模型得分到标签的单特征逻辑回归;保序回归(isotonic regression)拟合一个非递减的阶梯函数,它更灵活,也需要更多数据。对网络而言,标准方法是温度缩放(temperature scaling),即把所有 logit 除以一个拟合出的常数(模块 02 第 11 节,模块 07 第 10 节)。误校准的方向应当测量,而不是假设:实验 2 的 L2 正则化模型,其预测类别的平均置信度为 0.956,准确率为 0.986,错的方向略有不同,是偏保守。
实验 2 的逻辑回归在其 143 个测试样本上的可靠性图,使用五个等宽分箱:纵轴 (y) 为各分箱中恶性样本的观测比例,横轴 (x) 为平均预测概率,并画出完美校准的对角线。分箱位于对角线下方,说明模型在那里给出的概率偏高;位于上方则偏低。插入的直方图显示各分箱的计数 82、7、4、3 和 47:两端的分箱落在对角线上,而中间三个分箱共只有 14 个样本,散布很大,这正是小测试集会出现的情形。标题中给出 ECE 0.023。
某模型的 AUC 为 0.95,阳性占数据的 0.1%。它在 90% 召回率下的精确率会高吗?
查看答案
不一定。AUC 不依赖于阳性率,而且即便假阳性率只有 1%,误报与真报之比也约为十一比一。应当在真实的阳性率下查看精确率-召回率曲线。
为什么 F1 用调和平均而不是算术平均?
查看答案
调和平均由两个值中较小的那个主导,所以分类器无法靠牺牲精确率或召回率之一来最大化另一个,从而得到好分数;把所有样本都标记出来,算术平均高于二分之一,而 F1 接近零。
泛化:容量、偏差-方差与交叉验证
训练损失偏低(第 1 节),所以它无法说明模型在新输入上会表现如何。本节使这一差距变得可测量:先安排好数据,让差距看得见,再推导它的来源,并给出在实践中管理它的两种工具,即验证曲线和交叉验证。
三个数据集
在做任何事之前先划分数据:
- 训练集是优化器看到的数据;
- 验证集用于在模型和设置之间做选择(次数、\lambda、k);
- 测试集只在最后碰一次,用来报告一个数字。
每一次改变了某些东西的测试集查看,无论改变的是特征、设置还是模型的选择,都会把它变成验证集,它的数字也就不再具有你要宣称的含义。第 10 节会展开讲这一纪律。
容量曲线
实验 3 的实验:y = \sin(2\pi x) + \varepsilon,其中 \varepsilon \sim \mathcal{N}(0, 0.3^2),N = 20 个训练点位于等间距网格 x_i = i/19 上,并用最小二乘拟合 0 到 15 次的多项式。多项式写在勒让德(Legendre)基 P_k(2x - 1) 下,而不是写成幂 x^k。拟合出的函数是相同的,但 15 次时勒让德设计矩阵的条件数为 47,而 2x - 1 的幂为 6.7\times10^{5},所以求解是精确的(第 2 节)。一个包含 1,000 个随机 x 点的验证集用来度量新输入上的误差。
训练 RMSE 绝不会随次数增加而上升:每一族多项式都包含前一族,所以最小二乘总能做得至少一样好。验证 RMSE 先降后升(图 1.7)。在左侧,模型欠拟合(underfit):它无法表示信号,两种误差都很高。在右侧,它过拟合(overfit):它拟合了验证集所不具有的噪声,两种误差之间的差距变大。次数是一个容量(capacity)旋钮。其他旋钮还有参数个数、树的深度、k 近邻中的 1/k 以及岭回归中的 1/\lambda。
实验 3 的训练集(种子 0),按次数列出的 RMSE:
| 次数 | 0 | 1 | 3 | 4 | 5 | 9 | 12 | 15 |
|---|---|---|---|---|---|---|---|---|
| 训练 | 0.850 | 0.655 | 0.217 | 0.217 | 0.183 | 0.173 | 0.141 | 0.112 |
| 验证 | 0.769 | 0.536 | 0.354 | 0.354 | 0.360 | 0.365 | 0.393 | 0.720 |
验证集上最好的次数是 3 或 4;两者持平。这个持平是有原因的。取 t = 2x - 1,\sin(2\pi x) = -\sin(\pi t) 是 t 的奇函数,而设计点关于 t = 0 对称。偶数次的勒让德多项式是偶函数,所以在这个设计上它们与奇的目标以及奇次多项式正交:加入偶数次项只能拟合噪声。只有加入奇数次项时偏差才会下降,所以偏差是成对下降的,先是 1 次和 2 次一起,然后是 3 次和 4 次。在 15 次时,训练误差 0.112 远低于噪声水平 0.3:拟合吸收了噪声,而验证误差 0.720 显示了代价。
左:对同一组 20 个带噪的 \sin(2\pi x) 样本拟合 1 次、3 次和 15 次多项式,每个面板一个,真实函数以虚线表示:直线欠拟合,三次曲线贴合正弦,15 次曲线几乎穿过每个点,并在两端剧烈摆动。右:训练和验证 RMSE 随 0 到 15 次的变化,纵轴为对数坐标;训练单调下降,验证呈 U 形,最小值在 3–4 次;一条虚线水平线标出 \sigma = 0.3,欠拟合和过拟合区域被涂上阴影。
偏差-方差分解
验证误差为什么呈 U 形,可由一个恒等式得出。固定一个输入 \mathbf{x}。那里的一个新观测为 y = f^\ast(\mathbf{x}) + \varepsilon,其中 \E[\varepsilon] = 0,\operatorname{Var}(\varepsilon) = \sigma^2,且 \varepsilon 与训练集 \mathcal{D} 独立。拟合出的模型依赖于 \mathcal{D},而 \mathcal{D} 是随机的。记 \hat f = \hat f_{\mathcal{D}}(\mathbf{x}) 为它在 \mathbf{x} 处的预测,\bar f = \E_{\mathcal{D}}[\hat f] 为对各训练集取平均的预测。加上再减去 \bar f 和 f^\ast:
取平方:
对 \mathcal{D} 和 \varepsilon 逐项取期望。\bar f - f^\ast 是常数,所以 \E[(\hat f - \bar f)(\bar f - f^\ast)] = (\bar f - f^\ast)\,\E_{\mathcal{D}}[\hat f - \bar f] = 0,因为 \E_{\mathcal{D}}[\hat f] = \bar f。由于 \varepsilon 与 \mathcal{D} 独立,\E[(\hat f - \bar f)\varepsilon] = \E_{\mathcal{D}}[\hat f - \bar f]\,\E[\varepsilon] = 0。而 \E[(\bar f - f^\ast)\varepsilon] = (\bar f - f^\ast)\E[\varepsilon] = 0。剩下的是
对从 P 中抽取的 \mathbf{x} 取平均,就得到期望测试误差。
偏差(bias)是模型族即使对各训练集取平均也无法表示的部分。方差(variance)是拟合结果随训练样本不同而变化的程度。噪声(noise)是不可约的:没有模型能预测 \varepsilon。简单模型偏差高、方差低;灵活的模型则相反,验证曲线是两者之和。这个分解对平方误差是精确的恒等式。对分类的 0–1 损失,没有干净的加性版本,只有同一幅图景的宽松用法。
对固定设计上的最小二乘,每个拟合值都是训练目标的线性组合:\hat f(x_g) = \sum_j S_{gj}\,y_j,其中平滑矩阵 \mathbf{S} = \boldsymbol{\Phi}_g(\boldsymbol{\Phi}^\top\boldsymbol{\Phi})^{-1}\boldsymbol{\Phi}^\top 的第 g 行把 20 个目标映射为点 x_g 处的预测(\boldsymbol{\Phi} 是训练设计矩阵,\boldsymbol{\Phi}_g 是在点 x_g 处的同样特征)。由 y_j = f^\ast(x_j) + \varepsilon_j,第 5 节的规则给出 \bar f(x_g) = \sum_j S_{gj}f^\ast(x_j) 和 \operatorname{Var}\hat f(x_g) = \sigma^2\sum_j S_{gj}^2,无需任何模拟。在 201 个等间距的点 x_g 上取平均,\sigma^2 = 0.09:
| 次数 | 0 | 1 | 3 | 5 | 9 | 12 | 15 |
|---|---|---|---|---|---|---|---|
| 偏差² | 0.4975 | 0.2051 | 0.0052 | 0.0000 | 0.0000 | 0.0000 | 0.0000 |
| 方差 | 0.0045 | 0.0086 | 0.0161 | 0.0236 | 0.0422 | 0.0754 | 0.8737 |
| 总计 | 0.5920 | 0.3037 | 0.1113 | 0.1136 | 0.1322 | 0.1654 | 0.9637 |
在 3 次时,0.0052 + 0.0161 + 0.09 = 0.1113,为最小值。实验 3 用 200 个模拟训练集检验了这些值。总计的平方根,3 次时为 0.334,15 次时为 0.982,是上面那个训练集的 RMSE 所围绕散布的值(0.354 和 0.720)。
15 次的方差值得再看一眼。在 20 个训练输入上取平均,最小二乘拟合的方差恰为 \sigma^2\operatorname{tr}(\mathbf{P})/N = \sigma^2(d+1)/N = 0.09\times16/20 = 0.072,因为第 2 节的帽子矩阵的迹为 d + 1。在整个区间上取平均,它是 0.874,大了十二倍:在靠近两端的数据点之间,15 次多项式会远远偏离数据。
由 n = 4 个噪声 \sigma = 2 的读数估计均值 \mu = 1。样本均值 \bar y 无偏,方差为 \sigma^2/n = 4/4 = 1,所以它的均方误差为 1.0。样本均值的一半 \bar y/2 的期望为 0.5,偏差为 -0.5,所以偏差² 为 0.25,方差为 \tfrac14\times1 = 0.25(第 5 节的 \operatorname{Var}(aX) = a^2\operatorname{Var}(X))。它的均方误差为 0.5,是无偏估计量的一半。接受一些偏差以换取更小的方差,正是正则化有意做出的权衡(第 9 节);练习 7 求出最佳的收缩量。
学习曲线
学习曲线(learning curve)画出固定模型的训练误差和验证误差随训练点数 N 的变化。对有 p 个参数的最小二乘,第 5 节的 \E[\text{RSS}] = (N - p)\sigma^2 说明:期望训练 MSE 等于训练点上的偏差² 加 \sigma^2(1 - p/N),低于噪声水平,而期望验证 MSE 是偏差² + 方差 + \sigma^2,高于噪声水平。随着 N 增大,方差缩小,大致按 \sigma^2 p/N,两条曲线从相反的两侧逼近偏差² + \sigma^2。
曲线的形状就是诊断。持续存在的大间隙意味着方差:更多数据会有帮助。两条曲线都很高且靠得很近意味着偏差:更多数据没有帮助,更大的容量或更好的特征才有帮助。在实验 3 的设定下(图 1.8),N = 20 时,9 次的期望训练和验证 MSE 为 0.045 和 0.132,间隙为 0.087,而 3 次为 0.078 和 0.111。到 N = 1{,}000 时,两对都已在各自极限的 0.001 以内,即 3 次的 \sigma^2 + 偏差² = 0.0946,9 次的为 0.0900,并且从约 N = 115 起,9 次是更好的模型。随着数据积累,最佳次数向右移动。
用同一区间上的 N = 200 个点重做分解。3 次:偏差² 0.0046,方差 0.0018,总计 0.0046 + 0.0018 + 0.09 = 0.0964。5 次:总计 0.0927,成为新的最小值。15 次:总计 0.0972。在 3 次时,方差从 0.0161 降到 0.0018,接近 \sigma^2(d+1)/N 所预测的十倍下降。在 15 次时,它从 0.874 降到 0.0072,降幅超过一百倍,因为在 20 个点时 15 次几乎是在插值。灵活的模型不再受到惩罚,曲线的右侧趋于平坦。
实验 3 问题的学习曲线:期望训练和验证 MSE 随训练点数 N(10 到 1,000,对数坐标)的变化,分别针对 3 次和 9 次。每一对都向其极限 \sigma^2 + 偏差² 收敛,训练从下方,验证从上方;9 次在小 N 时间隙更大,极限更低(0.0900 对 0.0946),它的验证曲线在 N = 115 附近穿到 3 次之下。
k 折交叉验证
当数据稀缺时,单个验证集会浪费数据,而且它的结论取决于它碰巧拿到了哪些点。k 折交叉验证(k-fold cross-validation)把数据分成 k 个大小几乎相等的折(fold),用其中 k - 1 折训练,在剩下的一折上验证,轮流遍历全部 k 种选择,并对 k 个验证误差取平均。每个点用于验证一次,用于训练 k - 1 次。常用的选择:k = 5 或 10,这样每次拟合能看到 80–90% 的数据,代价是要拟合 k 次;分类时用分层折,使每一折保持类别比例;对非常小的数据集用留一法(k = N)。
k 个折误差还给出了一个离散程度。它们的均值带有标准误 \text{sd}/\sqrt{k},其中 sd 是折误差的标准差。这个标准误是近似的,并且偏乐观:任意两折的训练集会重叠(k = 5 时它们共享四分之三的点),所以折误差是正相关的,它们的均值比 \text{sd}/\sqrt{k} 所暗示的波动更大。即便如此,要说明一种设置比另一种好的幅度小于噪声,这仍是唯一诚实的办法。
实验 3 的 20 个训练点,分成实验 3 的五折,每折四个点,在 3 次和 5 次下拟合。各折的均方误差:
- 3 次:0.094,0.057,0.173,0.066,0.032;均值 0.084,sd 0.054,标准误 0.054/\sqrt5 = 0.024;
- 5 次:0.060,0.102,0.094,0.028,0.030;均值 0.063,sd 0.035,标准误 0.016。
交叉验证偏好 5 次,领先 0.021,约为逐折差值的一个标准误(五个差值的标准误为 0.021),而 1,000 点的验证集偏好 3 次。二十个点无法区分这两者,标准误也是这样说的。精确的期望误差 0.1113 和 0.1136 证实,这个选择几乎无关紧要。
双下降
U 形曲线是经典的预期,对本模块的模型来说也是正确的。但它不是定律。当模型被拟合到插值的程度,并且拟合规则在众多能拟合数据的解中选取最小范数的那个时,测试误差可能在参数个数 p 达到训练点数 N 的地方(即插值阈值,interpolation threshold)达到峰值,并在越过它之后再次下降(图 1.9)。Belkin et al. (2019) 把这称为双下降(double descent);Nakkiran et al. (2020) 在深度网络中沿模型规模和训练时间两个轴发现了它。
它与分解并不矛盾,因为分解是恒等式。它改变的是方差随规模变化的方式。在 p = N 时,恰好只有一个函数能拟合数据,它必须追逐每一个噪声值。越过阈值之后,有无穷多个函数能拟合数据,偏好小范数的规则会挑出一个光滑的,它的方差随 p 增大而下降。实验 3 的设计展示了这一点。用精确公式计算,其中 19 次以上的最小范数拟合由 np.linalg.lstsq 给出,期望测试 MSE 在 15 次时为 0.96,在 19 次(p = N = 20)时约为 16,000,在 25 次时为 0.19,在 100 次时为 0.14:出现了第二次下降,但没有低于 3 次处 0.111 的经典最小值。实践上的教训是要去测量:不要假设只有单一的 U 形,也不要假设第二次下降一定胜过它。本次学习的论文导读就是 Belkin 的那篇论文。
双下降曲线示意图:测试误差随参数个数 p 的变化。左侧是经典的 U 形;在插值阈值 p = N 处有一个峰;右侧是第二次下降。各区域分别标注“经典区间”和“插值区间”,并注明右侧假设采用最小范数拟合。
一个 15 次多项式拟合 16 个点,训练误差为零。它的验证误差会怎样,为什么?
查看答案
很大。16 个参数、16 个点,多项式会连同噪声一起插值,所以拟合结果随样本不同而完全改变:方差占主导。
你的学习曲线靠在一起,验证 MSE 为 0.20,\sigma^2 = 0.05,并且随 N 增大保持平坦。你该怎么办?
查看答案
曲线已经收敛到偏差² + \sigma^2,偏差² 约为 0.15:高偏差。更多数据没有帮助;应增加容量或改进特征。
为什么交叉验证标准误 \text{sd}/\sqrt{k} 偏乐观?
查看答案
k 个折估计因训练集重叠而正相关,所以它们的均值比 \text{sd}/\sqrt{k}(它假设各估计相互独立)所暗示的波动更大。
正则化作为先验知识:岭回归、Lasso 与 MAP
第 8 节把灵活模型的失败归因于方差。正则化(regularisation)有意用一部分方差换取偏差,通常做法是给损失加上惩罚项: \mathcal{L}_\lambda(\theta) = \mathcal{L}(\theta) + \lambda\,\Omega(\theta),其中 岭回归(ridge regression)取 \Omega = \lVert\mathbf{w}\rVert_2^2,Lasso 回归(套索回归)取 \lVert\mathbf{w}\rVert_1。 这个惩罚项并不是随意添加的:它表达了你在看到数据之前对参数的信念。本节中 \lambda 是正则化强度, \mathbf{X}^\top\mathbf{X} 的特征值记作 s_i^2。
先验就是正则项
对参数应用贝叶斯公式,得到
先验(prior)p(\theta) 表示在看到数据之前哪些参数是合理的,第 5 节的似然则表示每组参数对数据的解释程度。 最大后验(maximum a posteriori,MAP)估计最大化后验的对数:
极大似然估计就是先验平坦时的 MAP。任何其他先验都会在负对数似然上加一项 -\ln p(\theta):先验就是正则项。
保留常数的岭回归 MAP 推导
取高斯噪声 y_i = \mathbf{w}^\top\mathbf{x}_i + \varepsilon_i,\varepsilon_i \sim \mathcal{N}(0, \sigma^2), 以及先验 \mathbf{w} \sim \mathcal{N}(\mathbf{0}, \tau^2\mathbf{I}):每个权重的大小被认为约为 \tau。负对数后验为
乘以正常数 2\sigma^2/N 不改变最小值的位置,并得到本模块使用的“均值损失加惩罚项”形式:
先验更紧(\tau 更小)或数据噪声更大,都会让惩罚变大。数据越多,惩罚越小:证据压过先验,数据足够多时 MAP 与极大似然一致。
取 \sigma = 0.3,\tau = 1:N = 20 时,\lambda = 0.09/(20\times1) = 0.0045;N = 200 时, \lambda = 0.09/200 = 0.00045。数据多十倍,惩罚小十倍。
闭式解总是存在
令 (9.1) 的梯度为零,如第 2 节所做,并乘以 N/2:
\mathbf{X}^\top\mathbf{X} 的特征值 s_i^2 \ge 0 是 \mathbf{X} 奇异值的平方。加上 \lambda N\mathbf{I} 相当于给每个特征值加上 \lambda N, 于是每个特征值至少为 \lambda N > 0,方程组总是可解的:有重复列、列数多于行数,任何数据都不例外。
每个方向按各自的因子收缩
对 \mathbf{X} 做瘦奇异值分解 \mathbf{X} = \mathbf{U}\boldsymbol{\Sigma}\mathbf{V}^\top (列 \mathbf{u}_i 与 \mathbf{v}_i 标准正交,奇异值为 s_i), \mathbf{X}^\top\mathbf{X} = \mathbf{V}\boldsymbol{\Sigma}^2\mathbf{V}^\top,解为 \mathbf{w}_\lambda = \mathbf{V}(\boldsymbol{\Sigma}^2 + \lambda N\mathbf{I})^{-1}\boldsymbol{\Sigma}\mathbf{U}^\top\mathbf{y}, 拟合值为
最小二乘完整保留每个分量 \mathbf{u}_i^\top\mathbf{y}:这就是第 2 节的投影。岭回归把每个分量乘以各自的收缩因子(shrinkage factor) s_i^2/(s_i^2 + \lambda N):数据变化强的方向接近 1,数据几乎不变的方向接近 0。
方差解释了原因。沿 \mathbf{v}_i 方向,最小二乘系数为 \mathbf{u}_i^\top\mathbf{y}/s_i;其噪声部分的方差为 \sigma^2/s_i^2, 所以一个数据几乎不约束的方向,其取值由噪声除以一个很小的数决定。岭回归系数 s_i\,\mathbf{u}_i^\top\mathbf{y}/(s_i^2 + \lambda N) 的方差为 \sigma^2 s_i^2/(s_i^2 + \lambda N)^2,在 s_i^2 = \lambda N 处达到峰值,且不会超过 \sigma^2/(4\lambda N)。岭回归在每个方向上都给方差设了上限,只在数据本来说不出什么的方向上付出偏差的代价。
这些因子之和 \operatorname{df}(\lambda) = \sum_i s_i^2/(s_i^2 + \lambda N) 是有效自由度(effective degrees of freedom)。 当各列线性无关时,它在 \lambda = 0 处等于列数(即帽子矩阵的迹,第 2 节),随着 \lambda 增大平滑地降到 0: 这是一个连续的容量旋钮。
\mathbf{X}^\top\mathbf{X} 的特征值为 100 和 0.01,\lambda N = 1。两个因子为 100/101 = 0.990 和 0.01/1.01 = 0.0099:确定得好的方向几乎不受影响,确定得差的方向几乎被抹去。 条件数从 100/0.01 = 10^4 降到 101/1.01 = 100。
权重衰减
对岭回归损失做一步梯度更新为
每个权重先乘以略小于 1 的 1 - 2\eta\lambda,这就是 L2 惩罚被称为权重衰减(weight decay)的原因。AdamW 的解耦版本见模块 02 第 8 节。
Lasso:拉普拉斯先验与精确的零
拉普拉斯先验 p(w_j) = \frac{1}{2b}\exp(-\lvert w_j\rvert/b) 在零点处有尖峰,尾部更重, 其负对数为 \lVert\mathbf{w}\rVert_1/b 加一个常数。按 (9.1) 同样的缩放,得到 Lasso: \frac{1}{N}\lVert\mathbf{X}\mathbf{w} - \mathbf{y}\rVert^2 + \lambda\lVert\mathbf{w}\rVert_1, 其中 \lambda = 2\sigma^2/(Nb)。它会把系数精确地压到零,因此能做特征选择。 从几何上看(图 1.10),加惩罚等价于在球 \Omega(\mathbf{w}) \le t 内最小化损失:把椭圆形的损失等高线放大,直到与球相切。 L2 球是圆的,切点处每个坐标都不为零。L1 球是菱形,角在坐标轴上,从一般方向逼近的椭圆往往先碰到某个角。
(w_1, w_2) 平面上的两个子图,各画出以无约束解为中心的最小二乘损失椭圆等高线,该中心不在任一坐标轴上。左:圆盘(L2 球), 等高线在 w_1 与 w_2 均不为零的点与之相切。右:菱形(L1 球),等高线在其位于 w_1 轴上的角点相切,因此 Lasso 的解有 w_2 = 0。
对于标准正交设计 \mathbf{X}^\top\mathbf{X} = N\mathbf{I},代数推导是精确的。此时最小二乘解为 \hat{\mathbf{w}} = \mathbf{X}^\top\mathbf{y}/N,展开平方得
问题于是分解为每个坐标一个独立的问题。
- 岭回归: 最小化 (w_j - \hat w_j)^2 + \lambda w_j^2;令 2(w_j - \hat w_j) + 2\lambda w_j = 0,得 w_j = \hat w_j/(1 + \lambda)。
- Lasso: 最小化 h(w_j) = (w_j - \hat w_j)^2 + \lambda\lvert w_j\rvert。当 w_j > 0 时, 2(w_j - \hat w_j) + \lambda = 0 给出 w_j = \hat w_j - \lambda/2,仅当 \hat w_j > \lambda/2 时自洽;对称地,若 \hat w_j < -\lambda/2,则 w_j = \hat w_j + \lambda/2。 其余情形最小值在尖点处:在 w_j = 0 处,右侧斜率为 -2\hat w_j + \lambda \ge 0, 左侧斜率为 -2\hat w_j - \lambda \le 0。合起来就是软阈值(soft-thresholding):
岭回归做缩放;Lasso 做减法并截断(图 1.11 在真实数据上展示了两者)。一般情况下 Lasso 没有闭式解, 可用坐标下降(coordinate descent)求解,即每次对一个坐标做软阈值。在强相关的特征之中,Lasso 或多或少随意地保留其中一个; 同时加上两种惩罚的弹性网络(elastic net)则会保留整组特征。
\hat{\mathbf{w}} = (3.0, 0.4, -1.2),\lambda = 1。
- 岭回归除以 1 + \lambda = 2:(1.5, 0.2, -0.6)。
- Lasso 从每个绝对值中减去 \lambda/2 = 0.5 并截断:3.0 - 0.5 = 2.5; 0.4 - 0.5 < 0,所以为 0;-(1.2 - 0.5) = -0.7。结果为 (2.5, 0.0, -0.7)。
小系数被去掉;大系数被平移了 0.5。
实践要点
- 先标准化。 惩罚对所有系数一视同仁,但系数的大小取决于其特征的单位:以毫米为单位的长度,其系数要比以米为单位时小一千倍, 于是岭回归对它的惩罚会小一百万倍。
- 不要惩罚截距。 把 \mathbf{y} 和特征中心化,或者把 b 排除在外,如实验 3 那样把 \mathbf{I} 换成 \mathbf{I}', 后者第一个对角元素为零。
- 在对数网格上选择 \lambda,用验证集或交叉验证。一倍标准误规则(Hastie 等,2009)取交叉验证误差在最优值一个标准误以内的最大 \lambda。
- 把 \lambda 对应到库的参数:把各库的目标函数除以一个常数,直到与 (9.1) 一致:
| 调用 | 它最小化的目标 | 对应本模块的 \lambda |
|---|---|---|
Ridge(alpha) |
\lVert\mathbf{y} - \mathbf{X}\mathbf{w}\rVert^2 + \alpha\lVert\mathbf{w}\rVert^2 | \alpha = \lambda N |
Lasso(alpha) |
\frac{1}{2N}\lVert\mathbf{y} - \mathbf{X}\mathbf{w}\rVert^2 + \alpha\lVert\mathbf{w}\rVert_1 | \alpha = \lambda/2 |
LogisticRegression(C) |
\frac12\lVert\mathbf{w}\rVert^2 + C\sum_i \ell_i | C = 1/(2N\lambda) |
实验 3 用 15 次勒让德多项式拟合其 20 个点,常数项不加惩罚,\lambda 取从 10^{-10} 到 10 的 23 个值。
| \lambda | \to 0 | 0.032 | 10 |
|---|---|---|---|
| 训练 RMSE | 0.112 | 0.182 | 0.832 |
| 验证 RMSE | 0.720 | 0.335 | 0.751 |
对这 20 个点做五折交叉验证选出 \lambda = 0.032,一倍标准误规则也选出同一个值;其有效自由度为 10.4(总共 16)。 在测试集上,重新拟合的模型 RMSE 为 0.324,而最佳的无正则化次数(3 次)为 0.348,无正则化的 15 次为 0.684: 收缩一个灵活的模型,胜过选择一个小模型。通过 (9.1) 把它读作先验,则每个勒让德系数的 \tau = \sigma/\sqrt{N\lambda} = 0.3/\sqrt{20\times0.032} = 0.3/0.80 \approx 0.38。
标准化后的 load_diabetes 数据(442 名患者,10 个特征)上的系数路径,横轴为本模块约定下的 \log_{10}\lambda。左:岭回归;
十个系数都平滑地向零收缩,但没有一个到达零。右:Lasso;系数逐个降到零,直到一个不剩。每个子图中的竖线标出五折交叉验证选出的 \lambda。
按 scikit-learn 的写法,岭回归子图中的 alpha 是 442\lambda,Lasso 子图中的是 \lambda/2。
其他正则化方法
早停(early stopping)通过优化器起到正则化作用。从 \mathbf{w}_0 = \mathbf{0} 出发的梯度下降, 沿 \mathbf{H} 的每个特征向量(特征值在此记为 h_i)把误差每步收缩 1 - \eta h_i(第 3 节), 所以 t 步之后,\mathbf{w}_t 的该分量等于最小二乘值乘以 1 - (1 - \eta h_i)^t。 同一组基下,岭回归的因子是 h_i/(h_i + 2\lambda),因为 h_i = 2s_i^2/N。当 h_i 大时两者都接近 1; 当 h_i 小时,它们分别约为 \eta t\,h_i 和 h_i/(2\lambda),在 \lambda \approx 1/(2\eta t) 时两者吻合。提前停止的效果大致相当于惩罚随训练推进而减弱的岭回归。 数据增强(模块 03 第 10 节),以及随机失活(dropout)和噪声注入(模块 02 第 11 节), 则用来正则化神经网络。
噪声和先验保持不变,训练点的数量翻倍。MAP 的 \lambda 会怎样变化?
查看答案
减半,因为 \lambda = \sigma^2/(N\tau^2):数据压过了先验。
为什么在岭回归或 Lasso 之前要对特征做标准化?
查看答案
惩罚对所有系数一视同仁,但系数的大小取决于其特征的单位,所以不做缩放的话,惩罚落在某些特征上会任意地更重。
Lasso 能把系数精确压到零,岭回归却不能。用一句话说明原因。
查看答案
L1 惩罚的斜率在零点处不消失,所以小系数被截断;L2 惩罚的导数 2\lambda w 在零点处为零,所以系数只是被缩放。
诚实评估:泄漏、选择与区间
只有当测试样本没有参与模型的构建、与服务中遇到的样本相似,并且读数时考虑了抽样噪声,测试得分才是第 1 节中期望风险的公平估计。 本节是本系列中关于标准误、自助法与 McNemar 检验的参考;模块 07 和 09 把它们用于语言模型的基准测试。
测试数字有多大噪声
用一个真实准确率为 p 的模型给 n 个独立样本评分。答对的个数服从二项分布, 所以观测准确率 \hat p 的方差为 p(1 - p)/n,标准误(standard error)为
根据中心极限定理,95% 区间约为 \hat p \pm 1.96\,\operatorname{SE}。 这个公式对任何比例都成立,n 是计算该比例所依据的样本数:对召回率,就是正例的个数。错误或正确少于约十个时,正态近似失效; 此时应改用自助法或精确二项区间。要为半宽 h 确定测试集的大小,把公式反过来:
p = 0.90,n = 200:\operatorname{SE} = \sqrt{0.9\times0.1/200} = \sqrt{0.00045} = 0.021, 区间为 \pm1.96\times0.021 = \pm0.042;准确率为 0.88 和 0.92 的两个模型无法区分。 n = 2{,}000 时:\sqrt{0.09/2000} = 0.0067,\pm0.013。要达到 \pm0.02: n = 3.8416\times0.09/0.02^2 = 864.4,约 865 个样本。
实验 2 的召回率 51/53 = 0.962 建立在 53 个恶性样本之上: \sqrt{0.962\times0.038/53} = 0.026。只漏掉了两个,正态近似不适用。
测试集复用与选择
测试集复用是指:看了测试数字,改动模型,再看一次;每次改动都使模型对测试集多拟合一点。补救办法在流程上: 测试集只打开一次,并在报告数字时写明打开的日期。
选择一步就对验证集造成同样的后果。每个配置的得分是其真实性能加噪声,许多得分中的最大者属于噪声最有利的那个配置, 所以即使没有任何配置更好,胜出者的得分也会向上偏。
两百个配置的真实准确率都是 0.80,每个独立地以标准误 0.01 评分。胜出者显示 0.80 + 0.01\,Z_{\max}, 其中 Z_{\max} 是 200 个标准正态变量中的最大值。把 z 对最大值的密度 200\,\phi(z)\,\Phi(z)^{199} 积分, 得到 \E[Z_{\max}] = 2.746,所以胜出者显示约 0.827,尽管没有一个配置优于 0.80。 在实验 4 的扩展中,对纯噪声数据,200 个随机五特征子集中的最优者在五折交叉验证下得分 0.67; 用嵌套交叉验证评分,同样的搜索只给出 0.56。
补救办法是嵌套交叉验证(nested cross-validation,图 1.12):在每个外层训练部分内部用一个内层循环做选择,外层折只对所选的模型评分, 因此外层得分衡量的是整个流程。它需要拟合 k_\text{outer}\times k_\text{inner}\times 配置数 次, 对二十个 \lambda 值就是 5\times3\times20 = 300 次。最终部署的模型来自在全部数据上运行一次内层选择。
嵌套交叉验证:外层是五折的环,每一轮留出一折用于评分。在每一轮的外层训练部分内部,一个更小的内层三折循环尝试每个候选 \lambda 并选出一个。 箭头表明,留出的外层折只对内层循环所选的模型评分,从不影响这一选择。
数据泄漏
泄漏(leakage)指留出标签的信息在训练期间以任何途径到达模型。它的各种形式及其对策:
- 在全部数据上拟合预处理:缩放、填补缺失值、特征选择、目标编码。用 scikit-learn 的
Pipeline在每一折内部拟合它们。 缩放通常泄漏很少;特征选择和目标编码可能泄漏很多。 - 跨划分的重复与近似重复,比如一张被保存了两次的焊缝图像。划分前先去重。
- 分组:对同一零件、试样、患者或机器的重复测量被按行划分。模型学会了识别个体。按组划分(
GroupKFold)。 - 时间:打乱的时间序列让模型在未来数据上训练。使用前向滚动划分,并在每个验证块之前留出间隔(带
gap的TimeSeriesSplit)。 - 目标泄漏:某个特征是在标签已知之后才记录的,例如故障预测器中的维修费用。检查每个特征在服务中何时可得。
- 测试集复用,见上文。
这六条背后的规则是:按部署时将是新的单位来划分(新零件、新患者、新的一天),绝不按行划分(图 1.13)。
- 在全部数据上选择特征。 100 行纯噪声,5,000 个特征。在所有行上选 20 个特征,再做交叉验证:准确率 0.87 \pm 0.05。 在流水线内部做选择:0.50 \pm 0.09,即随机水平。(\pm 是五折之间的离散程度。)
- 分组。 40 个试样,每个 10 次测量,信号微弱。按行划分:随机森林 0.95,5-NN 1.00。按试样划分:0.63 和 0.64。
- 时间。 一台泵的壳体温度,随轴承温度变化并缓慢漂移,每小时记录一次,共 120 天,用随机森林预测。打乱的折: RMSE 2.33,处在噪声下限 2.0。前向滚动:4.09。森林在相邻小时之间对漂移做了插值,却无法预测它。
- 在全部数据上缩放,用
load_breast_cancer:准确率变化不到 0.001。
四种划分方案,以行的时间线表示,蓝色为训练,橙色为验证,数据按试样分组并按时间排序。(a) 随机按行划分:每个试样的行落在两侧,造成泄漏。 (b) 按组划分:每个试样的行同色。(c) 前向滚动的时间划分:每个验证块跟在其训练行之后,中间隔着灰色间隔。 (d) 两者兼顾:验证试样被整体留出,且出现在训练时期之后。
分布偏移
测试集与训练集来自同一个 P;部署时则不然。在协变量偏移(covariate shift)下,输入变了而输入输出关系没变: 比如新的传感器供应商带来不同的偏置。在标签偏移(label shift)下,类别比例变了:工艺改进使缺陷率减半,精确率随患病率下降(第 7 节)。 在概念漂移(concept drift)下,关系本身变了:磨损改变了振动与剩余寿命之间的关系。 要在模型将遇到的条件下的数据上评估,即使这样的数据更少;在生产中则要监控输入和输出,而不只是准确率。
自助法区间
自助法(bootstrap)通过重采样估计抽样噪声:有放回地抽取 n 个测试样本,重新计算指标,重复 R = 2{,}000 次, 取第 2.5 和第 97.5 百分位数作为 95% 区间。它不需要公式,因此既适用于准确率,也适用于 AUC、F1 或 ECE。
要在同一测试集上比较两个模型,用配对自助法:每次重复只抽取一次下标,用它们给两个模型评分,取差值的区间。 由于 \operatorname{Var}(\hat a - \hat b) = \operatorname{Var}\hat a + \operatorname{Var}\hat b - 2\operatorname{Cov}(\hat a, \hat b), 而各模型认为容易和困难的样本是相同的,配对区间比两个单独区间所暗示的要窄得多。对分组数据,则对组重采样(聚类自助法)。
两点提醒。第一,在测试集上做自助只度量测试抽样的噪声,不度量重新训练带来的变化。第二,它无法凭空造出证据: 当差异只建立在寥寥几个模型意见不一的样本上时,每个重复都由这几个样本构成,百分位区间会过窄。此时应使用下面的精确检验。
McNemar 检验
在同样的 n 个样本上给分类器 A 和 B 评分。两者都答对或都答错的样本,对谁更好什么也说明不了;只有不一致样本才有信息:
只有 A 答对的有 n_{10} 个,只有 B 答对的有 n_{01} 个。如果两个模型一样好,每个不一致样本就是一枚均匀硬币,
所以 n_{10} \sim \operatorname{Binomial}(n_{10} + n_{01}, \tfrac12),精确的双侧 p 值为
\min\big(1,\; 2\,P(X \le \min(n_{10}, n_{01}))\big)(scipy.stats.binomtest)。
这就是 McNemar 检验(McNemar,1947),Dietterich(1998)推荐用它比较分类器。教科书上的统计量
与 3.84(自由度为 1 的 \chi^2 的 5% 临界值)比较,是一种大样本近似,在中等计数下过于容易拒绝原假设; 其连续性校正形式 (\lvert n_{10} - n_{01}\rvert - 1)^2/(n_{10} + n_{01}) 与精确检验较为接近。 精确检验不花任何代价,所以就用它,并同时报告 n_{10} 和 n_{01}。
实验 4 在实验 2 的 143 个测试样本上给逻辑回归和 15-NN 评分:0.986(2 个错误)和 0.951(7 个错误)。 取 R = 2{,}000 次重复,两个单独区间 [0.965, 1.000] 和 [0.909, 0.986] 重叠, 然而配对差值 0.035 的区间 [0.007, 0.070] 不含零。
有五个样本不一致,全部偏向逻辑回归(n_{10} = 5,n_{01} = 0)。 精确检验:p = 2\times0.5^5 = 0.0625,有提示意义,但在 5% 水平上不显著。(\chi^2 = 25/5 = 5.0 给出 p = 0.025;校正后 16/5 = 3.2 给出 0.074。)这些方法之所以不一致,是因为证据只有五个样本: 一次重复只有在一个都没抽到时才显示差值为零,概率为 (138/143)^{143} = 0.006,而且没有任何重复能显示 15-NN 领先。 应报告差值、计数 5 和 0 以及精确 p 值;更大的测试集能解决这个问题(图 1.14)。
实验 4 的自助分布,2,000 次重复。左:逻辑回归和 15-NN 各次重复准确率的重叠直方图。右:配对差值的直方图, 其 2.5% 与 97.5% 百分位数(0.007 和 0.070)明显离开零,零以下没有任何柱。图中的标注给出不一致计数 5 和 0, 以及 McNemar 精确检验的 p = 0.0625。
n_{10} = 24,n_{01} = 12:(24 - 12)^2/36 = 4.0 > 3.84,p = 0.046,“显著”。 精确检验给出 p = 0.065,校正后的统计量 11^2/36 = 3.36 给出 p = 0.067。
基于语言模型的应用有它们自己的评估问题;AI Agents 系列中有一个模块专门讲这些。
你在交叉验证之前用整个数据集的均值和方差做标准化。这是泄漏吗?有影响吗?
查看答案
原则上是。对缩放而言,影响通常可以忽略(实验 4 中不到 0.001),但同样的习惯用在特征选择或目标编码上,影响可能很大。 应在每一折内部拟合预处理。
30 个试样,每个测了 20 次。应当怎么划分?
查看答案
按试样划分(GroupKFold),使任何试样的行都不会同时出现在训练和验证中。
为什么用配对自助法比较两个模型,而不是看两个单独的区间?
查看答案
它们在相同的样本上评分,所以它们的错误是相关的;配对差值抵消了共同的难度,区间窄得多。
两个分类器在六个测试样本上意见不一,六个全部偏向 A。在 5% 水平上 A 更好吗?
查看答案
McNemar 精确双侧 p = 2\times0.5^6 = 0.031,所以是,勉强成立;五个这样的样本则给出 0.0625。 不一致样本不超过五个时,任何划分都达不到 5%。
超越线性:你会遇到的方法
线性模型是本模块所有思想最容易看清的地方,也常常是一个好的基线。当边界弯曲或特征之间有交互时,其他方法表现更好。 本节是一次巡览,给出足够的机理,让你知道每种方法何时适合作基线;如何判断,靠的是第 7 到 10 节的评估。
k 近邻与维数灾难
k 近邻(k-NN)通过对离查询点最近的 k 个训练点的目标取平均,或对其标签投票来预测。它没有训练过程; 一次预测要花大约 Nd 次运算来找邻居。k 是容量旋钮:k = 1 时插值训练数据,k 很大时平均范围太宽而欠拟合。 距离会把各特征混在一起,所以缩放是必需的:不缩放的话,单位最大的特征决定谁是邻居。在低维时,k-NN 是很强的基线。
在高维时它会失败,因为邻域不再是局部的。对均匀分布在单位立方体中的数据,容纳比例 r 的数据的子立方体,其边长为 r^{1/d}。
取 r = 0.01:d = 1 时边长为 0.01;d = 2 时 0.01^{1/2} = 0.10;d = 10 时 0.01^{1/10} = 0.63; d = 100 时 0.01^{1/100} = 0.955。要在 100 维中收集最近的 1% 数据,必须跨越每个特征取值范围的 95.5%:邻居并不近。
树、森林与提升
决策树(decision tree)用轴对齐的阈值 x_j \le t 递归地划分输入空间,在每个节点选择能最大程度降低两个子节点不纯度(impurity)的特征和阈值: 回归用目标的方差;分类用基尼不纯度(Gini impurity)1 - \sum_k p_k^2 或熵,其中 p_k 是节点中各类别的占比。深度就是容量。 对特征做递增的重新缩放,会移动其上的阈值,但不改变每侧落入哪些点,所以树不需要缩放。树的方差很高:数据的微小变化就可能改变第一次划分以及它之下的一切。
一个节点有 40 个次品和 60 个良品:1 - (0.4^2 + 0.6^2) = 0.48。某次划分给出子节点(30 个次品,10 个良品)和(10 个次品,50 个良品), 不纯度分别为 1 - (0.75^2 + 0.25^2) = 0.375 和 1 - ((1/6)^2 + (5/6)^2) = 0.278。按大小加权, 0.4\times0.375 + 0.6\times0.278 = 0.317:降低了 0.163。
随机森林(random forest)生成 M 棵深树,每棵在行的自助样本上训练,每次划分时只考虑随机选出的一部分特征,然后对它们取平均。 如果每棵树的预测方差为 \sigma^2,任意两棵的相关系数为 \rho,则平均的方差为
即 M 个方差加上 M(M - 1) 个协方差。更多的树只能消去第二项;第一项只有在树之间去相关时才会下降,随机特征子集正是为此而设。 每个自助样本会漏掉约三分之一的行,所以用没见过某行的那些树给每一行评分,就得到袋外(out-of-bag)误差,这是免费的验证估计。
\sigma^2 = 1,\rho = 0.3。M = 10:0.3 + 0.7/10 = 0.37。M = 100:0.3 + 0.007 = 0.307。 无论多少棵树都不会低于 0.3。
梯度提升(gradient boosting)由小树 h_m 构建加法模型 F_m(\mathbf{x}) = F_{m-1}(\mathbf{x}) + \nu\,h_m(\mathbf{x}),
每棵树拟合损失对预测值的负梯度,在 F_{m-1} 处取值。对平方误差 \tfrac12(y - F)^2,这个负梯度就是 y - F,
所以每棵树拟合的是当前的残差 y_i - F_{m-1}(\mathbf{x}_i)。这是函数空间中的梯度下降:学习率 \nu 与树的数量 M 此消彼长,
M 由在验证数据上的早停来选定。XGBoost、LightGBM 和 scikit-learn 的 HistGradientBoosting 估计器是常用的实现(截至 2026 年)。
提升不需要缩放,原生支持缺失值。在最多几十万行的表格数据上,它往往是最好的方法,也是最先该尝试的;
Grinsztajn 等(2022)给出了基准证据,表明在典型的表格数据上,树集成仍然胜过深度网络。“往往”不等于“总是”:
练习 13 在两个数据集上检验这一说法,其中一个数据集上岭回归获胜。
核函数与支持向量机
用特征映射 \phi(\mathbf{x}) 替换 \mathbf{x},其维数可以很高,并把映射后的输入堆成 \boldsymbol{\Phi} 的各行。 岭回归给出 \mathbf{w} = (\boldsymbol{\Phi}^\top\boldsymbol{\Phi} + \lambda N\mathbf{I})^{-1}\boldsymbol{\Phi}^\top\mathbf{y}。 展开相乘得到推过恒等式(push-through identity):
左乘 (\boldsymbol{\Phi}^\top\boldsymbol{\Phi} + \lambda N\mathbf{I})^{-1},右乘 (\boldsymbol{\Phi}\boldsymbol{\Phi}^\top + \lambda N\mathbf{I})^{-1}, 就变成 (\boldsymbol{\Phi}^\top\boldsymbol{\Phi} + \lambda N\mathbf{I})^{-1}\boldsymbol{\Phi}^\top = \boldsymbol{\Phi}^\top(\boldsymbol{\Phi}\boldsymbol{\Phi}^\top + \lambda N\mathbf{I})^{-1}。 因此
预测为
这里只出现内积,所以永远不必真正构造 \phi:核函数(kernel)k 直接计算内积。这就是核技巧(kernel trick), 这种方法叫核岭回归(kernel ridge regression)。RBF 核 k(\mathbf{x}, \mathbf{x}') = \exp(-\gamma\lVert\mathbf{x} - \mathbf{x}'\rVert^2) 对应一个无穷维的 \phi:在一维情形下,把 \exp(2\gamma xx') 展开成幂级数,对每个 j \ge 0 得到一个特征 e^{-\gamma x^2}\sqrt{(2\gamma)^j/j!}\,x^j。代价是 N\times N 的矩阵 \mathbf{K}: 拟合需要 O(N^3),每次预测需要 N 次核函数计算。
支持向量机(support vector machine,SVM)针对标签 y_i \in \{-1, +1\},保留 L2 惩罚, 并把平方误差换成合页损失(hinge loss)\max(0, 1 - y_i f(\mathbf{x}_i))。间隔 y_i f(\mathbf{x}_i) \ge 1 的点被正确分类, 不产生损失也不产生梯度,所以解只依赖支持向量,即位于间隔上或间隔内的点;其余各点的 \alpha_i = 0,预测只需要支持向量。 边界是惩罚所允许的最大间隔的那一个。配合 RBF 核,SVM 在深度学习出现之前是中等规模数据上的最先进方法。
高斯过程与神经网络
高斯过程(Gaussian process)在函数上放一个由核函数指定的先验分布,并在每次预测时同时返回后验均值和方差。 后验均值就是 \lambda N 等于噪声方差时的核岭回归。其代价随 N 呈三次方增长,而不确定性正是关键所在: 高斯过程是昂贵工程仿真的标准代理模型,也是贝叶斯优化的引擎。
神经网络除了最后的线性映射,还会学习特征。它的优势在图像、文本和信号上,那里好的特征并不知道,而数据又很充足; 它们是本系列其余部分的内容。
无监督的主力方法:k 均值与 PCA
k 均值(k-means)通过最小化 J = \sum_i\lVert\mathbf{x}_i - \boldsymbol{\mu}_{c(i)}\rVert^2 把数据划分为 k 个簇。 Lloyd 算法交替进行两步:把每个点分配给最近的中心,这在各种分配中最小化 J;把每个中心移到其簇的均值, 这在各种中心中最小化 J(第 5 节中平方误差下的最优常数)。两步都不会使 J 增大,所以算法会收敛, 但收敛到的局部最小值取决于初始值:应使用 k-means++ 初始化并多次重启。k 的选择依据下游用途、J 随 k 变化曲线的拐点, 或轮廓系数;先缩放。
主成分分析(principal component analysis,PCA)寻找方差最大的方向。投影 \mathbf{u}^\top\mathbf{x}(\lVert\mathbf{u}\rVert = 1) 的方差为 \mathbf{u}^\top\mathbf{C}\mathbf{u},其中 \mathbf{C} 是样本协方差;用拉格朗日乘子最大化它, 得到 \mathbf{C}\mathbf{u} = \lambda\mathbf{u},方差为 \lambda (这里 \lambda 又是特征值,如第 3 节,不是上面核函数小节中的岭回归强度)。 主方向就是 \mathbf{C} 按特征值排序的特征向量,等价于中心化数据的右奇异向量。第 i 个成分解释的方差占比为 \lambda_i/\sum_j\lambda_j,投影到前 k 个成分为 \mathbf{z} = \mathbf{V}_k^\top(\mathbf{x} - \boldsymbol{\mu})。用途:可视化、压缩、去噪,以及使特征去相关, 从而改善第 3 节的条件数。PCA 是线性的,对缩放敏感;它在神经网络中的对应物是自编码器,见模块 05 第 2 节。
协方差特征值 (4.0, 1.0, 0.5, 0.3, 0.2) 之和为 6.0。前两个成分解释 (4.0 + 1.0)/6.0 = 83.3\%:五个特征压缩为两个,代价是损失六分之一的方差。
没有免费的午餐,以及一次比较
对所有可能的问题取平均,没有任何学习方法优于其他方法(Wolpert,1996)。一种方法在某个问题上获胜, 是因为它的假设与该问题相符,这就是为什么第 7 到 10 节的评估比方法的选择更重要。
make_moons,300 个点,噪声 0.25(random_state=0),五折分层交叉验证(打乱,random_state=0),
除所列设置外所有模型都用 scikit-learn 的默认值,凡接受 random_state 的都设为 0:逻辑回归 0.827,4 层深的树 0.887,梯度提升
(HistGradientBoostingClassifier)0.947,15-NN(已缩放)0.957,随机森林 0.960。弯曲的边界让线性模型吃亏,
而在二维中,k-NN 与任何方法一样好(图 1.15)。
四种分类器在 make_moons(300 个点,噪声 0.25)上的决策边界,每个子图一种,两个类别用彩色点表示:逻辑回归,一条直线;
15-NN,一条平滑曲线;4 层深的决策树,轴对齐的阶梯;梯度提升,更细的阶梯。每个子图的标题是其五折交叉验证准确率:
0.827、0.957、0.887 和 0.947。
| 方法 | 容量旋钮 | 需要缩放? | 拟合代价 | 预测代价 | 交互? | 典型的首选场景 |
|---|---|---|---|---|---|---|
| 线性或逻辑回归,带岭惩罚 | 特征,\lambda | 是,对惩罚和 GD | O(Nd^2) | O(d) | 仅在手动添加时 | 基线;可解释 |
| k-NN | k | 是 | 无 | O(Nd) | 是 | 低维基线 |
| 决策树 | 深度 | 否 | O(dN\log N) | O(\text{depth}) | 是 | 可读的规则 |
| 随机森林 | 每次划分的特征数,深度 | 否 | M 棵树 | O(M\cdot\text{depth}) | 是 | 稳健的表格数据默认选择 |
| 梯度提升 | M,\nu,深度 | 否 | M 棵树 | O(M\cdot\text{depth}) | 是 | 表格数据,最先尝试 |
| 核岭回归,SVM | \gamma,\lambda | 是 | O(N^3) | O(N) 次核计算 | 是 | 中等 N,平滑边界 |
| 高斯过程 | 核,噪声 | 是 | O(N^3) | 均值为 O(N) | 是 | 带不确定性的代理模型 |
| 神经网络 | 宽度,深度,训练时间 | 是 | 轮次 × N × 参数量 | O(\text{parameters}) | 是 | 图像、文本、信号 |
可以把这张表当作面对新的表格问题时的工作顺序。先给平凡基线评分(均值,或多数类),再是带正则化的线性模型,再是梯度提升集成, 全部在相同的折上;当 N 在几千且需要平滑函数或不确定性时,再考虑核方法或高斯过程;当输入是图像、文本或信号时,再用神经网络。 每一步都必须比上一步好出第 10 节的标准误以上,才配得上它额外的代价。“缩放”一列同时也是泄漏检查清单: 每个标着“是”的方法,其缩放器都必须在折内部拟合。
为什么树不需要特征缩放,而 k-NN 需要?
查看答案
树每次按阈值只对一个特征做划分,单调的重新缩放会移动阈值,但不改变每侧落入哪些点;k-NN 度量的距离则把各特征按各自的单位加在一起。
在平方误差的梯度提升中,每棵新树拟合的是什么?
查看答案
残差 y_i - F_{m-1}(\mathbf{x}_i),即 \tfrac12(y - F)^2 对 F 的负梯度。
工程案例:拟合超弹性材料模型
一位工程师在表征一种软水凝胶,要把新胡克系数 c_1 拟合到一次单轴压缩试验上。一旦把拉伸比的某个已知函数算出来, 它就是线性回归,并且包含本模块的所有内容:每个点噪声水平不同的似然、闭式解、不确定性、残差检查、在其范围之外错误的模型,以及一个非线性的替代方案。 我们使用合成试验,使下面每个数字都能在实验 5 中复现。仅在本节中,\lambda 表示拉伸比,不是正则化强度或特征值,P 表示应力。
模型
不可压缩的新胡克固体的应变能为 W = c_1(I_1 - 3),其中 I_1 是各主拉伸比平方之和。沿单轴拉伸 \lambda(压缩时 \lambda < 1), 不可压缩性使横向拉伸比为 \lambda^{-1/2},三者之积为 1,于是
其中 P 是名义应力,即力除以未变形面积。对小应变 \varepsilon, \lambda = 1 + \varepsilon 给出 g \approx 3\varepsilon 和 P \approx 6c_1\varepsilon: 杨氏模量为 E = 6c_1,剪切模量为 \mu = 2c_1。
加权最小二乘,以及 c_1 的不确定性
每个测得的应力 P_i 都附带一个记录下来的不确定度 \sigma_i,所以似然是每个点方差不同的高斯分布,最大化它就是第 5 节的加权最小二乘: 最小化 \sum_i w_i(P_i - 2c_1 g_i)^2,其中 w_i = 1/\sigma_i^2,g_i = g(\lambda_i)。对 c_1 的导数为 -4\sum_i w_i g_i(P_i - 2c_1 g_i);令其为零,
该估计关于带噪声的 P_i 是线性的:c_1^\ast = \sum_i a_iP_i, 其中 a_i = w_i g_i/(2\sum_j w_j g_j^2)。独立误差的传播为 \operatorname{Var}(\sum_i a_iP_i) = \sum_i a_i^2\sigma_i^2,又因为 w_i\sigma_i^2 = 1,
系数附带的标准差是测量值的函数,而不是一种主观意见。
\lambda = (0.9, 0.8, 0.7),P = (-6.8, -15.1, -27.2) kPa,\sigma = (0.2, 0.4, 0.6) kPa。
- g = 0.9 - 1/0.81 = -0.3346;0.8 - 1/0.64 = -0.7625;0.7 - 1/0.49 = -1.3408。
- w = 1/\sigma^2 = (25, 6.25, 2.778)。
- \sum w P g = 25(2.2753) + 6.25(11.5138) + 2.778(36.4702) = 230.14; \sum w g^2 = 25(0.11194) + 6.25(0.58141) + 2.778(1.79779) = 11.426。
- c_1^\ast = 230.14/(2\times11.426) = 230.14/22.852 = 10.07 kPa; \operatorname{SD} = 1/(2\sqrt{11.426}) = 0.148 kPa。
- 拟合应力 2c_1^\ast g = (-6.74, -15.36, -27.01);归一化残差 (P - \hat P)/\sigma = (-0.31, 0.65, -0.32);\chi^2_\nu = (0.093 + 0.417 + 0.104)/2 = 0.31。
检查拟合:残差与 \chi^2_\nu
如果模型和 \sigma_i 都正确,归一化残差 r_i = (P_i - \hat P_i)/\sigma_i 应当看起来像独立的标准正态变量。其汇总量是约化卡方(reduced chi-square)
其中 p 是拟合参数的个数;根据第 5 节的 \E[\text{RSS}] = (N - p)\sigma^2,模型正确时它约为 1。 远大于 1 意味着模型错误或 \sigma_i 被低估;远小于 1 则是 \sigma_i 被高估。同时也要看符号: 一长串同号的残差是系统性的失配,\chi^2_\nu 可能会把它稀释掉。报告以最大测得应力归一化的 RMS 残差, 这使对不同试样的拟合可以比较,同时还要报告拟合所用的应变范围。
实验 5 的合成试验:真实材料是一个 Gent 固体(见下),c_1 = 10 kPa, \beta = 0.2,在从 0.975 到 0.600 的 16 个拉伸比下测试(应变 2.5% 到 40%), \sigma_i = 0.05 kPa 加上应力的 2%。对应变不超过 20% 的部分(8 个点)做新胡克拟合, 得到 c_1 = 10.09 \pm 0.10 kPa,\chi^2_\nu = 0.71,归一化残差在 \pm1.3 以内, RMS 残差为最大应力的 1.1%。蒙特卡洛检验,对拟合曲线的 1,000 份带噪声副本重新拟合, 得到的标准差为 0.0999,公式给出 0.0997。这是一次干净、精确的拟合。
外推
在 0–20% 上的拟合对 40% 什么也说明不了。c_1 的区间量化的是给定模型下的噪声; 它不含任何描述模型出错的项。
预测的 95% 区间带为 \pm1.96\times2\,\operatorname{SD}(c_1)\,\lvert g(\lambda)\rvert。
- 30% 应变(\lambda = 0.7):-27.06 \pm 0.52 kPa,而真值为 -28.82,偏低 6.1%。
- 40%(\lambda = 0.6):-43.96 \pm 0.85 kPa,而真值为 -50.57,偏低 13.1%。误差 6.6 kPa 约为区间带半宽的八倍(图 1.16)。
名义应力(kPa,压缩时为负)随拉伸比从 1.0 降到 0.6 的变化。16 个带 \pm\sigma 误差棒的数据点;对应变不超过 20% 的新胡克拟合, 在该范围内为实线,之外为虚线,并带有窄窄的 95% 区间带;对全部 16 个点的 Gent 拟合,穿过数据;拟合范围用阴影标出; 一个标注指出 40% 应变处虚线曲线与数据之间 13% 的差距。
拟合范围必须随模型一起携带,并且模型只在其被评估过的范围内使用:这就是第 8 节的一句话版本。
残差揭示了错误的模型
对全部 16 个点拟合新胡克模型:c_1 = 10.55 \pm 0.06 kPa,\chi^2_\nu = 4.5,
从小应变到大应变,残差的符号为 ++++++++++------,先是十个正号,再是六个负号。
这唯一的系数是一种折中,在小应变时太硬,在大应变时太软(图 1.17)。更窄的区间 \pm0.06 并不能带来安慰:
它是在一个被残差否定的模型之下的噪声。
对全部 16 个点的两种拟合,归一化残差 (P_i - \hat P_i)/\sigma_i 随拉伸比的变化,水平线位于 0 和 \pm2。 新胡克:有系统性的模式,十个正残差之后是六个负残差,有几个超出 \pm2。Gent:无模式地散布在 \pm2 以内。
非线性最小二乘:Gent 模型
Gent 模型加入了有限的链可延伸性:
它在 \beta = 0 时就是新胡克模型,且对 \beta 是非线性的。设残差为 \mathbf{r}(\theta) = \hat{\mathbf{P}}(\theta) - \mathbf{P},权重为 \mathbf{W} = \operatorname{diag}(1/\sigma_i^2),雅可比矩阵为 \mathbf{J} = \partial\mathbf{r}/\partial\theta, 高斯-牛顿法(Gauss–Newton)把残差线性化为 \mathbf{r}(\theta + \boldsymbol{\delta}) \approx \mathbf{r} + \mathbf{J}\boldsymbol{\delta}, 并对 \boldsymbol{\delta} 求解加权最小二乘问题,得到
Levenberg–Marquardt 与信赖域方法加入阻尼,使糟糕的线性化不会把步子甩得太远;对加权残差使用 scipy.optimize.least_squares 就是这样做的,
并在解处返回 \mathbf{J}。于是 \operatorname{Cov}(\hat\theta) \approx (\mathbf{J}^\top\mathbf{W}\mathbf{J})^{-1},
如果 \sigma_i 只知道到一个比例因子,则再乘以 \chi^2_\nu。对线性的新胡克模型,J_i = 2g_i,这恰好就是 1/(4\sum_i w_ig_i^2),即上面的公式。
全部 16 个点:c_1 = 9.95 \pm 0.10 kPa,\beta = 0.208 \pm 0.024,相关系数 -0.78, \chi^2_\nu = 0.40;蒙特卡洛标准差 0.099 和 0.025 与线性化的结果一致。 两个参数此消彼长:更大的 \beta 使曲线变硬,所以更小的 c_1 来补偿。
仅用不超过 20% 的应变:\beta = 0.21 \pm 0.21,相关系数 -0.83。无法排除新胡克的 \beta = 0(图 1.18)。原因在 I_1:取 \lambda = 1 - \varepsilon, I_1 - 3 = 3\varepsilon^2 + O(\varepsilon^3),所以在 10% 应变时 I_1 - 3 = 0.032,\beta = 0.2 使应力升高 1/(1 - 0.0064) - 1 = 0.65\%,低于 2% 的噪声。从未用到某个参数的数据,无法确定这个参数。
Gent 拟合所得 (c_1, \beta) 的近似 95% 置信椭圆,并画出直线 \beta = 0(新胡克)。对 0–20% 的数据,是一个细长的椭圆, 向下倾斜(负相关),穿过 \beta = 0;对 0–40% 的数据,是一个小椭圆,明显位于该直线之上。
加载方向,以及拒绝输入
g 关于 \lambda = 1 不对称:g(0.8) = -0.7625,而 g(1.25) = 1.25 - 0.64 = 0.61。 因此加载方向是模型的一部分,必须声明。如果把它当作拉伸来读 (\lambda = 1 + \varepsilon,应力为正),实验 5 的 0–20% 数据给出 c_1 = 12.97 kPa, 比正确读法的 10.09 kPa 高 28.5%,且 \chi^2_\nu = 20.7,暴露了这个错误。 在最初 5% 的应变范围内,读错的拟合给出 10.60 kPa,而正确读法是 9.75,高出 8.7%, \chi^2_\nu = 0.38 却很干净:当数据分辨不出差别时,错误的模型也可以拟合得很好。
任何残差检查都抓不住这种情形,所以防线要设在拟合之前。拟合程序应当拒绝它无法满足的输入:没有不确定度的点、
符号与声明的加载方向矛盾的应力、拟合出的非正刚度,并说明原因,而不是返回一个数字。实验 5 的 check_inputs 实现了这些拒绝。
每当假设被违反时,学习方法都应该这样做。
c_1 的标准误是 1%(95% 区间约 \pm2\%),但在 40% 应变时,新胡克模型的预测偏差达 13%。这矛盾吗?
查看答案
不矛盾。区间量化的是给定模型下的噪声;对于模型在拟合范围之外出错,它没有任何说明。
为什么无法从 10% 应变以下的数据确定 \beta?
查看答案
I_1 - 3 \approx 3\varepsilon^2,所以那里 \beta 对应力的改变不到 1%,低于噪声;这些数据几乎不携带关于 \beta 的信息。
常见问题与排查
每个故障都按你会遇到的症状列出,然后是原因和对策。
损失已经最小化,但决策很差
原因。 损失不是目标。最小化的是交叉熵,而决策需要的是在固定假阳性率下的召回率, 或者漏掉一个缺陷的代价相当于二十次误报。损失对此一无所知。对策。 根据决策的代价或约束选择指标和操作阈值(第 7 节), 在验证数据上设定阈值,并报告在该操作点上的性能,而不是在 0.5 处。
梯度下降停滞;“模型不学习”
原因。 特征未缩放或未中心化,使 \kappa(\mathbf{X}^\top\mathbf{X}) 极大: 实验 1 被破坏的版本中为 10^{10},100,000 步之后训练 MSE 仍为 4.28,而应为 0.0100。对策。 用训练集统计量做中心化和标准化, 并在责怪模型之前先计算 \kappa(第 3 节)。权重可以精确地映射回原始单位。
损失在几步之内上升或变成 NaN
原因。 学习率超过了稳定性极限 2/\lambda_{\max},所以最陡的方向在每一步都被乘以绝对值大于 1 的因子。 对策。 把 \eta 除以 3 到 10,或者在一次短的运行上扫描对数网格,取使损失平滑下降的最大 \eta。
SGD 的损失在一个有噪声的平台上不再改善
原因。 恒定步长的噪声下限,与 \eta/B 成正比(第 4 节):在最小值处,mini-batch 梯度仍不为零。 对策。 在 Robbins–Monro 条件下衰减步长,或增大 batch。不要把平台当作收敛;更小的步长或更大的 batch 会降得更低。
逻辑回归的权重无限增长,概率全是 0 或 1
原因。 训练数据线性可分且没有惩罚:对分离的 \mathbf{w} 做的每一次放大都会降低损失,所以极大似然估计不存在(第 6 节)。 对策。 保留 L2 惩罚(scikit-learn 的默认值 C = 1)或提前停止,然后在留出数据上检查校准。
交叉验证分数极好,服务中的结果却很差
原因。 同一零件、试样或机器的行出现在划分的两侧,模型学会了识别个体:实验 4 中按行为 0.95,按试样为 0.63。
对策。 按部署时将是新的单位划分(GroupKFold),做自助法时对组重采样。
时间序列模型看起来像先知
原因。 打乱的划分让它在未来数据上训练,并在相邻时间之间插值;实验 4 的泵模型就是这样达到噪声下限的。
对策。 带间隔的前向滚动划分(TimeSeriesSplit);绝不跨时间打乱。
在本应不可预测的数据上准确率很高
原因。 特征选择或其他拟合型预处理步骤在交叉验证之前看到了全部数据:实验 4 中在纯噪声上达到 0.87。
对策。 把每个拟合步骤都放进在折内部评估的 Pipeline。得分远高于问题所允许的水平,就应先找泄漏,再庆祝。
所选配置的验证得分站不住脚
原因。 验证集在两百个配置中做了选择,而带噪声得分的最大值是乐观的,其程度你看不见。 对策。 嵌套交叉验证,或只打开一次的测试集,并记录打开的日期(第 10 节)。报告尝试过多少个配置;乐观程度随其数量增长。
准确率很高,模型却没用
原因。 类别不平衡:模型预测多数类,在 1% 的患病率下得分 99%。对策。 报告混淆矩阵、精确率和召回率以及精确率-召回率曲线, 并各自与多数类基线比较。平凡规则得分很高的指标,不适合作主要数字;稀有类的召回率通常更能说明问题。
“模型 A 比模型 B 高半个点”
原因。 差异落在测试集的抽样噪声之内;在 2,000 个样本、90% 准确率下,单个模型的标准误就有 0.7 个点。 对策。 在相同样本上比较:不一致计数、McNemar 精确检验和差值的配对自助区间。区间包含零时要如实说明,只有寥寥几个样本不一致时,要相信精确检验。
预测概率与观测频率不符
原因。 用交叉熵长时间训练会奖励越来越大的 logits,或者自训练以来总体已经发生了偏移。对策。 画可靠性图并计算 ECE; 在留出数据上重新校准(Platt 缩放或保序回归),绝不要在模型拟合所用的数据上做, 并检查误差的方向,而不是假定模型过度自信。
ECE 极好的模型毫无用处
原因。 校准不是区分能力:对每个样本都预测基础比率是校准的(在实验 2 的测试集上 ECE 为 0.003,而拟合模型为 0.023),但它不对任何东西排序。 对策。 把 ECE 与 Brier 分数和 AUC 一起报告,并说明分箱方式。
模型被要求外推,而拟合看起来很干净
原因。 在数据支撑范围之外没有任何东西约束 f,而参数区间不包含模型误差:实验 5 中 40% 应变处为 13%,约为区间带的八倍。 对策。 把拟合范围与模型一起存储;对范围之外的预测予以拒绝或标记;在候选模型意见分歧之处收集数据,那里是下一次试验信息量最大的地方。
部署几个月后性能衰减
原因。 非平稳性:过程、传感器或总体在数据收集之后发生了变化。对策。 监控输入和输出的分布,而不只是常常来得很晚的准确率; 在近期数据上重新训练或重新校准,并在新条件下的数据上评估。
实验 1 — 线性回归的三种解法:闭式解、梯度下降与 SGD
目标。 你用正规方程、梯度下降和随机梯度下降(stochastic gradient descent)三种方法,在同一个合成数据集上拟合同一个线性模型,并把每个结果与第 2 至 4 节的理论对照。你要扫描学习率,让它越过 2/\lambda_{\max},找出梯度下降发散的步长;再用尺度很差的特征把优化器搞坏,并用标准化修复;最后测量恒定步长 SGD 的噪声下限,并与预测值比较。全部使用 NumPy,无需下载任何东西,整个实验几秒钟即可跑完。
步骤 1:数据与闭式解
数据与第 2 节相同:200 个样本,三个服从标准正态分布的输入,真实权重 \mathbf{w} = (1.5, -2.0, 0.5),截距 0.7,噪声为标准差 0.1 的高斯噪声。截距的处理方式是在输入后面追加一列 1,得到形状为 (200, 4) 的设计矩阵 Xb 和参数向量 (w_1, w_2, w_3, b)。正规方程 \mathbf{X}^\top\mathbf{X}\,\mathbf{w} = \mathbf{X}^\top\mathbf{y} 求解两次:一次直接求解,一次用 np.linalg.lstsq,后者基于 SVD,从不构造 \mathbf{X}^\top\mathbf{X}。在条件良好的问题上,两者可以一致到很多位有效数字。
接下来是两个噪声估计。残差的均方根作为噪声水平的估计是偏低的,因为拟合已经用掉了四个自由度来压低残差。如第 5 节所推导,用 N - 4 而不是 N 去除残差平方和,就能修正这一偏差。
import numpy as np
import matplotlib.pyplot as plt

np.set_printoptions(precision=3, suppress=True)
np.random.seed(0)                       # the lab itself uses seeded generators

rng = np.random.default_rng(0)
N = 200
w_true = np.array([1.5, -2.0, 0.5])
b_true = 0.7
sigma = 0.1

X = rng.normal(size=(N, 3))
y = X @ w_true + b_true + sigma * rng.normal(size=N)
Xb = np.hstack([X, np.ones((N, 1))])          # shape (200, 4): last column is the intercept

w_normal = np.linalg.solve(Xb.T @ Xb, Xb.T @ y)
w_lstsq, *_ = np.linalg.lstsq(Xb, y, rcond=None)
print("normal equations:", np.round(w_normal, 3))
print("lstsq:           ", np.round(w_lstsq, 3))

resid = y - Xb @ w_lstsq
print(f"residual RMS          = {np.sqrt(np.mean(resid**2)):.4f}")
print(f"sqrt(RSS / (N - 4))   = {np.sqrt(np.sum(resid**2) / (N - 4)):.4f}")
normal equations: [ 1.491 -2.01   0.505  0.696]
lstsq:            [ 1.491 -2.01   0.505  0.696]
residual RMS          = 0.1000
sqrt(RSS / (N - 4))   = 0.1010
权重接近真值 (1.5, -2.0, 0.5, 0.7),误差在第 2 节预测的采样误差之内,每个系数约为 \sigma/\sqrt{N} = 0.007。残差的均方根就是数据的噪声水平,也就是当初加进去的 0.1。残差中没有留下任何可恢复的信号。
步骤 2:Hessian 矩阵、它的特征值和两个临界步长
对均方误差 \mathcal{L}(\mathbf{w}) = \frac{1}{N}\lVert\mathbf{X}_b\mathbf{w} - \mathbf{y}\rVert^2,梯度为 \frac{2}{N}\mathbf{X}_b^\top(\mathbf{X}_b\mathbf{w} - \mathbf{y}),Hessian 矩阵为 \mathbf{H} = \frac{2}{N}\mathbf{X}_b^\top\mathbf{X}_b,是常数。第 3 节说明,梯度下降收敛当且仅当 \eta < 2/\lambda_{\max},最快的固定步长是 \eta^\ast = 2/(\lambda_{\max} + \lambda_{\min})。两者都来自特征值,所以把特征值算出来。条件数(condition number)\kappa = \lambda_{\max}/\lambda_{\min} 表示最差方向比最好方向慢多少。
H = (2 / N) * Xb.T @ Xb
lam = np.linalg.eigvalsh(H)                   # ascending order
lam_min, lam_max = lam[0], lam[-1]
eta_max = 2 / lam_max
eta_star = 2 / (lam_max + lam_min)

print("eigenvalues of H:", np.round(lam, 3))
print(f"kappa             = {lam_max / lam_min:.2f}")
print(f"eta_max = 2/lmax  = {eta_max:.3f}")
print(f"eta*              = {eta_star:.3f}")
eigenvalues of H: [1.711 1.922 2.126 2.207]
kappa             = 1.29
eta_max = 2/lmax  = 0.906
eta*              = 0.511
相互独立、方差为 1 的输入使 \frac{1}{N}\mathbf{X}^\top\mathbf{X} 接近单位矩阵,所以 \mathbf{H} 接近 2\mathbf{I},条件数接近 1,最大的稳定步长略小于 1。这是梯度下降的最佳情形。接下来的步骤会离开这种情形。
步骤 3:梯度下降与步数统计
循环就是第 3 节中的那个:从零出发,沿梯度反方向走。它被包装成一个返回完整权重轨迹的函数,这样后面的步骤就可以在每一步测量损失以及到最优点的距离。第一次运行取 \eta = 0.1,共 500 步,应当落在闭式解的权重上。然后统计在 \eta = 0.1 和 \eta^\ast 下,使 \lVert\mathbf{w} - \mathbf{w}^\ast\rVert 低于 10^{-6} 所需的步数。
理论可以预测这个步数。沿特征值为 \lambda_i 的特征向量,误差每步乘以 1 - \eta\lambda_i,所以最小特征值决定收敛速率:约为 (1 - 0.1\lambda_{\min})^t。起始距离约为 2.6(真实权重的范数),达到 10^{-6} 大约需要 \ln(2.6\times10^{6})/\ln(1/(1 - 0.1\lambda_{\min})) 步;打印出的步数应当与此接近。
def gradient_descent(Xm, ym, eta, steps):
    """Full-batch GD on the mean squared error; returns the whole trajectory of weights."""
    n = len(ym)
    w = np.zeros(Xm.shape[1])
    path = [w.copy()]
    for _ in range(steps):
        grad = (2 / n) * Xm.T @ (Xm @ w - ym)
        w = w - eta * grad
        path.append(w.copy())
    return np.array(path)

path = gradient_descent(Xb, y, eta=0.1, steps=500)
print("GD, eta = 0.1, 500 steps:", np.round(path[-1], 3))

def steps_to_tolerance(Xm, ym, eta, w_star, tol=1e-6, max_steps=10_000):
    n = len(ym)
    w = np.zeros(Xm.shape[1])
    for t in range(1, max_steps + 1):
        w = w - eta * (2 / n) * Xm.T @ (Xm @ w - ym)
        if np.linalg.norm(w - w_star) < tol:
            return t
    return None

print("steps to 1e-6 at eta = 0.1 :", steps_to_tolerance(Xb, y, 0.1, w_lstsq))
print("steps to 1e-6 at eta*      :", steps_to_tolerance(Xb, y, eta_star, w_lstsq))
print("predicted at eta = 0.1     :",
      round(np.log(2.6e6) / np.log(1 / (1 - 0.1 * lam_min))))
GD, eta = 0.1, 500 steps: [ 1.491 -2.01   0.505  0.696]
steps to 1e-6 at eta = 0.1 : 76
steps to 1e-6 at eta*      : 7
predicted at eta = 0.1     : 79
三种方法在小数点后三位给出同样的答案,理应如此:它们最小化的是同一个凸二次函数。步数显示了 \eta^\ast 的好处:它使最慢和最快的方向以同样的速率收缩,即每步 (\kappa - 1)/(\kappa + 1),当 \kappa 接近 1 时这个值非常小。
步骤 4:发散边界
第 3 节断言,2/\lambda_{\max} 处的边界是尖锐的。来检验它:取 \eta = f\,\eta_{\max},f 从 0.5 到 1.5,各运行 200 步,打印最终训练损失。当 f < 1 时,所有方向都收缩。当 f > 1 时,\lambda_{\max} 方向每步乘以 1 - 2f,其绝对值 2f - 1 大于 1,于是几何级数地增长。在 f = 0.99 时,该方向每步的因子为 -0.98:它会收敛,但很慢,而且符号交替。
mse = lambda w: np.mean((Xb @ w - y) ** 2)
runs = {}
print(f"{'f':>5} {'final MSE':>12} {'|w - w*|':>12}")
for f in [0.5, 0.9, 0.99, 1.01, 1.1, 1.5]:
    p = gradient_descent(Xb, y, eta=f * eta_max, steps=200)
    runs[f] = np.array([mse(w) for w in p])
    print(f"{f:5.2f} {runs[f][-1]:12.4g} {np.linalg.norm(p[-1] - w_lstsq):12.3g}")

fig, ax = plt.subplots(figsize=(6.5, 4))
for f in [0.5, 0.99, 1.01]:
    ax.semilogy(runs[f], label=f"$\\eta = {f}\\,\\eta_{{max}}$")
ax.set_xlabel("step")
ax.set_ylabel("training MSE (log scale)")
ax.set_title("Gradient descent either side of $2/\\lambda_{max}$")
ax.legend()
plt.show()
    f    final MSE     |w - w*|
 0.50         0.01      2.4e-15
 0.90         0.01     2.73e-15
 0.99      0.01043       0.0196
 1.01         3782         58.5
 1.10    6.458e+31     7.65e+15
 1.50   3.545e+120     1.79e+60
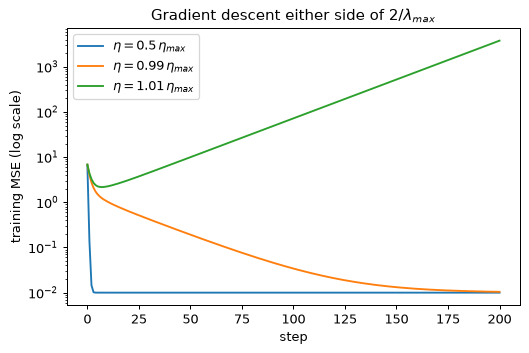
当 f 不超过 0.9 时,最终 MSE 就是噪声下限 0.0100(噪声方差 \sigma^2 减去拟合吸收的那一小部分),到最优点的距离处于舍入误差的量级。f = 0.99 的那次运行在 200 步之后仍在振荡,MSE 为 0.0104,距离为 0.020。刚刚越过边界时,损失不降反升,到 f = 1.5 时已经大得离谱。在由特征值算出的阈值的 1.01 倍处发散,是本模块中最有力的证据,说明理论确实描述了这台机器。
损失变成 inf 或 nan,几乎总是因为步长超过了 2/\lambda_{\max}。在动其他任何东西之前,先把 \eta 减半,再看前十个损失值。如果它们现在下降了,原因就是步长。
步骤 5:糟糕的单位
现在在不改变模型的前提下把问题搞坏。复制 \mathbf{X},把第一列乘以 1,000,仿佛长度是以毫米而不是米记录的;再给第二列加 100,仿佛接近 100 °C 的温度是按 °C 记录的,而不是记成相对 100 °C 的偏差。模型能表示的函数集合完全不变:新的第一个权重是旧权重的 1/1000,截距吸收了偏移。变化的只有条件数。分别打印这两种改动单独作用以及合在一起时的条件数,然后让梯度下降在 0.9\,\eta_{\max}(它能安全采用的最佳步长)下运行 100,000 步。
Xbad = X.copy()
Xbad[:, 0] *= 1000.0
Xbad[:, 1] += 100.0
Xbad_b = np.hstack([Xbad, np.ones((N, 1))])

def kappa_and_limit(Xm):
    lam_m = np.linalg.eigvalsh((2 / len(Xm)) * Xm.T @ Xm)
    return lam_m[-1] / lam_m[0], 2 / lam_m[-1]

Xscale_only = np.hstack([X * np.array([1000.0, 1.0, 1.0]), np.ones((N, 1))])
Xshift_only = np.hstack([X + np.array([0.0, 100.0, 0.0]), np.ones((N, 1))])
print(f"kappa, scaling only : {kappa_and_limit(Xscale_only)[0]:.1e}")
print(f"kappa, offset only  : {kappa_and_limit(Xshift_only)[0]:.1e}")
kappa_bad, eta_max_bad = kappa_and_limit(Xbad_b)
print(f"kappa, both         : {kappa_bad:.1e}")
print(f"eta_max, both       : {eta_max_bad:.1e}")

w_bad_lstsq, *_ = np.linalg.lstsq(Xbad_b, y, rcond=None)
mse_bad = lambda w: np.mean((Xbad_b @ w - y) ** 2)
path_bad = gradient_descent(Xbad_b, y, eta=0.9 * eta_max_bad, steps=100_000)
print(f"lstsq MSE on the bad data : {mse_bad(w_bad_lstsq):.4f}")
print(f"GD MSE after 100,000 steps: {mse_bad(path_bad[-1]):.4f}")
kappa, scaling only : 1.1e+06
kappa, offset only  : 1.0e+08
kappa, both         : 1.0e+10
eta_max, both       : 9.7e-07
lstsq MSE on the bad data : 0.0100
GD MSE after 100,000 steps: 4.2760
10^{10} 的条件数并不罕见:未经缩放的工程数据就会产生这样的数字。步长受最大曲率限制,而最大曲率属于以毫米计的那一列;其余方向的曲率小了许多个数量级,在 100,000 步里几乎没有移动。100,000 步之后,训练 MSE 为 4.28,而同一数据上 lstsq 的结果是 0.0100:模型没有问题,是优化器没有学会它。lstsq 不受影响,因为 SVD 在舍入误差范围内不在乎单位。闭式解从未察觉这个问题;而梯度下降,这个能推广到本系列其余所有场景的方法,却察觉到了。这就是第 3 节把标准化放在优化之前的原因。
步骤 6:标准化,并把权重映射回去
标准化是减去每一列的训练均值,再除以它的训练标准差,得到均值为 0、方差为 1 的各列。偏移从条件数中消失了(中心化的列与全 1 列正交),尺度也消失了。在标准化坐标下拟合出的权重,通过 w_j = \tilde w_j/s_j 和 b = \tilde b - \sum_j \mu_j\tilde w_j/s_j 映射回原始单位,这两个式子来自把 \tilde x_j = (x_j - \mu_j)/s_j 代入模型。映射回去的权重必须等于在尺度很差的问题上直接用 lstsq 得到的结果:标准化改变的是路径,不是答案。
mu = Xbad.mean(axis=0)
s = Xbad.std(axis=0)
Z = (Xbad - mu) / s
Zb = np.hstack([Z, np.ones((N, 1))])

kappa_z, _ = kappa_and_limit(Zb)
lam_z = np.linalg.eigvalsh((2 / N) * Zb.T @ Zb)
eta_star_z = 2 / (lam_z[-1] + lam_z[0])
print(f"kappa after standardising = {kappa_z:.2f}")

w_z_star, *_ = np.linalg.lstsq(Zb, y, rcond=None)
print("steps to 1e-6 at eta*     :", steps_to_tolerance(Zb, y, eta_star_z, w_z_star))

w_z = gradient_descent(Zb, y, eta=eta_star_z, steps=50)[-1]
w_orig = np.append(w_z[:3] / s, w_z[3] - np.sum(mu * w_z[:3] / s))
show = lambda v: np.array2string(v, precision=5, suppress_small=True)
print("GD weights, original units:", show(w_orig))
print("lstsq on the bad data     :", show(w_bad_lstsq))
print(f"largest difference        : {np.max(np.abs(w_orig - w_bad_lstsq)):.1e}")
kappa after standardising = 1.22
steps to 1e-6 at eta*     : 6
GD weights, original units: [  0.00149  -2.00962   0.5053  201.65791]
lstsq on the bad data     : [  0.00149  -2.00962   0.5053  201.65791]
largest difference        : 7.1e-13
条件数回到约 1,几步就收敛,映射回去的权重与 SVD 的解一致。第一个权重在原始单位下约为 1.5\times10^{-3}:真值 1.5 除以 1,000。截距约为 201.7,即 0.696 + 2.0096\times100:它吸收了加在第二列上的偏移。这次修复是一次变量替换,而不是什么更聪明的算法。请保留训练时的均值和标准差:任何新输入都必须用这些数来变换,而实验 4会展示不这样做会发生什么。
步骤 7:随机梯度下降及其噪声下限
第 4 节预测,恒定步长的 SGD 不会收敛,而是在一个下限附近徘徊。这个下限是超额训练损失 \mathcal{L}(\mathbf{w}_t) - \mathcal{L}(\mathbf{w}^\ast),对最小二乘而言为
其中 \sigma^2 是残差方差(代码里的 s2),推导见该节的例题。代码在原始的、尺度良好的数据上运行七种配置,每种 50 个轮次(epoch)。每个轮次抽取一个新的排列(来自种子为 1 的生成器,与生成数据的那个生成器相互独立),把它切成大小为 B 的 mini-batch,每个 batch 走一步。每次更新之后,代码记录超额损失,所用的恒等式为 \mathcal{L}(\mathbf{w}) - \mathcal{L}(\mathbf{w}^\ast) = \frac{1}{2}
(\mathbf{w} - \mathbf{w}^\ast)^\top\mathbf{H}(\mathbf{w} - \mathbf{w}^\ast),它对二次函数是精确的。最后一种配置让步长按 \eta_t = 0.1/(1 + t/200) 衰减,其中 t 是更新次数。测得的下限是后一半更新中超额损失的均值,此时瞬态已经消失。
def sgd(B, eta, epochs=50, decay_tau=None, seed=1):
    """Mini-batch SGD with per-epoch shuffling; returns the excess loss after every update."""
    gen = np.random.default_rng(seed)
    w = np.zeros(4)
    excess, t = [], 0
    for _ in range(epochs):
        perm = gen.permutation(N)
        for start in range(0, N, B):
            idx = perm[start:start + B]
            grad = (2 / len(idx)) * Xb[idx].T @ (Xb[idx] @ w - y[idx])
            step = eta if decay_tau is None else eta / (1 + t / decay_tau)
            w = w - step * grad
            d = w - w_lstsq
            excess.append(0.5 * d @ H @ d)
            t += 1
    return np.array(excess)

def predicted_floor(B, eta, s2=0.0100):
    return np.sum(eta * s2 * lam / (B * (2 - eta * lam)))

configs = [(200, 0.1, None), (32, 0.1, None), (10, 0.1, None),
           (1, 0.1, None), (1, 0.03, None), (1, 0.01, None), (1, 0.1, 200)]
curves = {}
print(f"{'B':>4} {'eta':>6} {'measured':>10} {'predicted':>10}")
for B, eta, tau in configs:
    ex = sgd(B, eta, decay_tau=tau)
    curves[(B, eta, tau)] = ex
    measured = ex[len(ex) // 2:].mean()
    label = f"{eta}" if tau is None else "decay"
    pred = predicted_floor(B, eta) if tau is None else float("nan")
    print(f"{B:4d} {label:>6} {measured:10.1e} {pred:10.1e}")
print(f"decaying step, last update: {curves[(1, 0.1, 200)][-1]:.1e}")
   B    eta   measured  predicted
 200    0.1    1.7e-05    2.2e-05
  32    0.1    1.0e-04    1.4e-04
  10    0.1    3.1e-04    4.4e-04
   1    0.1    9.6e-03    4.4e-03
   1   0.03    1.3e-03    1.2e-03
   1   0.01    2.7e-04    4.0e-04
   1  decay    3.0e-05        nan
decaying step, last update: 3.1e-06
按列往下读这张表。测得的下限按 \eta/B 缩放:把 batch 大小从 32 减到 10,下限大约升高到 3.2 倍;在 B = 1 时减小 \eta,下限随之同步下降。对每个 B < N 的恒定步长行,预测值都在两倍以内,对一个加性噪声模型来说这已经足够好了。对小步长,预测偏高(B = 10 时为 4.4 对 3.1,单位 10^{-4});在 B = 1、\eta = 0.1 时预测偏低(4.4 对 9.6,单位 10^{-3}),因为被忽略的、随到最优点距离增大的噪声在这里最大。全 batch 那一行并不是下限:B = N 时没有采样噪声,这次运行就是普通的梯度下降,那个数字是一段仍在几何级数地缩小的瞬态的均值。公式不适用于它,它与打印出的预测值接近纯属巧合。衰减步长在最后一次更新后降到 3\times10^{-6},远低于每一个恒定步长的下限。
步骤 8:绘图
图中把四次运行画在双对数坐标上:全 batch、B = 32、B = 1 以及带衰减的 B = 1,每条曲线对各自的更新次数作图。两个恒定步长运行的预测下限用虚线表示。全 batch 梯度下降每个轮次只更新一次,所以只有 50 个点;它那条笔直下降的线就是第 3 节中的几何收敛。这就是图 1.3。
fig, ax = plt.subplots(figsize=(7, 4.5))
spec = [((200, 0.1, None), "full batch, $\\eta = 0.1$", "C0"),
        ((32, 0.1, None), "$B = 32$, $\\eta = 0.1$", "C1"),
        ((1, 0.1, None), "$B = 1$, $\\eta = 0.1$", "C3"),
        ((1, 0.1, 200), "$B = 1$, $\\eta_t = 0.1/(1 + t/200)$", "C2")]
for key, label, colour in spec:
    ex = curves[key]
    ax.loglog(np.arange(1, len(ex) + 1), np.maximum(ex, 1e-12), color=colour,
              lw=1.0, alpha=0.9, label=label)
for (B, eta), colour in [((32, 0.1), "C1"), ((1, 0.1), "C3")]:
    ax.axhline(predicted_floor(B, eta), color=colour, ls="--", lw=1)
ax.set_xlabel("update number")
ax.set_ylabel("excess training loss  $L(w_t) - L(w^*)$")
ax.set_title("SGD hovers at a floor set by $\\eta/B$; decay goes below it")
ax.legend(loc="lower left", fontsize=8)
plt.show()
B = 32 的曲线下降得很快,然后在 10^{-4} 附近变平。B = 1 的曲线在 10^{-2} 附近是平的,并且锯齿状起伏。衰减的那次运行起初跟着噪声大的那条走,随后在其他曲线都已趋平之后继续下降。
你应当看到什么
- 正规方程、
lstsq和梯度下降在小数点后三位一致。残差的均方根等于噪声标准差:没有可恢复的信号被遗漏。 - 发散边界很尖锐,且位于特征值分析给出的位置:0.99\,\eta_{\max} 收敛(缓慢,且振荡),1.01\,\eta_{\max} 爆炸。
- 单位很差时,梯度下降看上去学不会,尽管模型本身没有问题。标准化几步之内就恢复了收敛,映射回原始单位的权重等于
lstsq的解。修复靠的是变量替换,而不是新算法。闭式解从未察觉这个问题。 - 恒定步长的 SGD 在一个大致与 \eta/B 成正比的下限附近徘徊。预测值在大约两倍之内吻合。衰减步长能降到每一个下限以下。
动手试试
- 增加第五列,等于第 0 列的 0.99 倍加上 0.01 倍的噪声,把所有列标准化,观察 \kappa 和梯度下降的步数如何增长。这是由相关性造成的病态,任何重新缩放都无法消除。
- 用回溯法代替固定步长:把 \eta 不断减半,直到损失下降,并把步数与 \eta^\ast 下的步数比较。
- 对 N = 10^6、d = 100,比较
np.linalg.lstsq与 100 步梯度下降的耗时,并决定你会用哪一个。再对 d = 10^5 决定你会用哪一个。 - 让 SGD 的下标改为独立有放回抽取,而不是按打乱的轮次遍历,并把下限与表中的数字比较:第 4 节的例题说明了应当预期什么。
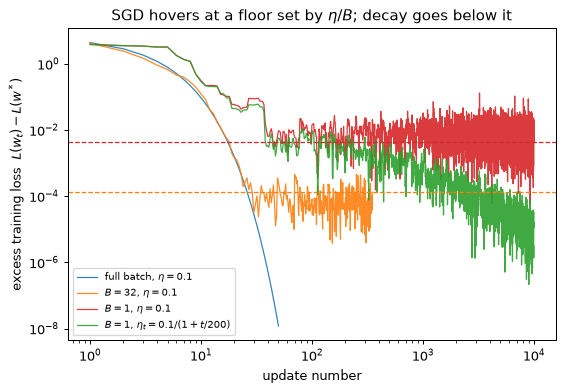
实验 2 — 从零实现逻辑回归,以及决策所需的指标
目标。 你实现带正则化的逻辑回归,使用数值稳定的损失和一个经过检验的梯度,用梯度下降训练它,并确认两者都收敛后与 scikit-learn 的结果一致。然后按决策所需的方式度量这个分类器:混淆矩阵、满足召回率目标的阈值、ROC 曲线和精确率-召回率曲线,以及校准,其中包括一个比模型校准得更好却毫无用处的常数预测器。最后,在可分数据上去掉惩罚项,观察权重无限增长。数据随 scikit-learn 一起提供,所以无需下载,实验几秒钟即可跑完。
步骤 1:数据
scikit-learn 的乳腺癌数据有 569 个病例和 30 个数值特征,这些特征由细胞核图像计算得出。该库把恶性编码为 0,这使准确率和召回率很容易被读错。工程师要问的问题是“这是缺陷吗?”,所以缺陷(这里是恶性)必须是正类:用 y = 1 - target 翻转目标。划分是分层的,使训练集和测试集保持类别比例,标准化只使用训练集的统计量。测试数据绝不能参与任何被拟合的东西,均值和标准差也包括在内。
import numpy as np
import matplotlib.pyplot as plt
from scipy.special import expit
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (confusion_matrix, roc_auc_score, average_precision_score,
                             roc_curve, precision_recall_curve, brier_score_loss)

np.set_printoptions(precision=4, suppress=True)
np.random.seed(0)

data = load_breast_cancer()
y_all = 1 - data.target                      # malignant = 1 (scikit-learn codes it as 0)
print("malignant:", int(y_all.sum()), " benign:", int((1 - y_all).sum()))

X_tr, X_te, y_tr, y_te = train_test_split(
    data.data, y_all, test_size=0.25, stratify=y_all, random_state=0)
print("train:", X_tr.shape, int(y_tr.sum()), "malignant")
print("test: ", X_te.shape, int(y_te.sum()), "malignant")

mu, sd = X_tr.mean(axis=0), X_tr.std(axis=0)
A_tr = np.hstack([(X_tr - mu) / sd, np.ones((len(X_tr), 1))])   # last column: intercept
A_te = np.hstack([(X_te - mu) / sd, np.ones((len(X_te), 1))])
N = len(y_tr)
malignant: 212  benign: 357
train: (426, 30) 159 malignant
test:  (143, 30) 53 malignant
步骤 2:损失、梯度和步长上界
设 logit 为 z = \mathbf{a}^\top\mathbf{w},概率为 \hat p = \sigma(z),则单个样本的负对数似然为 \ln(1 + e^{z}) - yz,推导见第 6 节。直接计算时,e^{z} 在 z 很大时会溢出;np.logaddexp(0, z) 计算 \ln(e^0 + e^z),而不构造指数本身。平均损失加上对 30 个特征权重(不含截距)的惩罚项 \lambda\lVert\mathbf{w}\rVert^2,其中 \lambda = 1/(2NC),使之与 scikit-learn 的 C = 1 相匹配。梯度为 \frac{1}{N}\mathbf{A}^\top(\hat{\mathbf{p}} - \mathbf{y}) + 2\lambda
\mathbf{w},截距对应的惩罚项为零。
数据项的 Hessian 矩阵为 \frac{1}{N}\mathbf{A}^\top\mathrm{diag}(\hat p(1 - \hat p)) \mathbf{A},而 \hat p(1 - \hat p) \le \frac{1}{4},所以它的最大特征值至多为 L = \lambda_{\max}(\mathbf{A}^\top\mathbf{A}/N)/4。于是取 \eta < 2/L 的梯度下降是安全的。把这个上界打印出来。
C = 1.0
lam_reg = 1.0 / (2 * N * C)                  # ridge strength matching scikit-learn's C
mask = np.r_[np.ones(30), 0.0]               # the intercept is not penalised

def loss_fn(w, A=A_tr, y=y_tr, lam=lam_reg):
    z = A @ w
    return np.mean(np.logaddexp(0, z) - y * z) + lam * np.sum((mask * w) ** 2)

def grad_fn(w, A=A_tr, y=y_tr, lam=lam_reg):
    p = expit(A @ w)
    return A.T @ (p - y) / len(y) + 2 * lam * mask * w

L = np.linalg.eigvalsh(A_tr.T @ A_tr / N)[-1] / 4
print(f"curvature bound L = {L:.2f}; GD is safe for eta < 2/L = {2 / L:.2f}")
curvature bound L = 3.39; GD is safe for eta < 2/L = 0.59
下面使用步长 \eta = 0.5。这个上界针对的是曲率达到最大可能值的损失;在最小值附近,曲率要小得多,这就是为什么对这个非二次的损失,该上界是充分条件而非必要条件,第 6 节对此有说明。
步骤 3:检验梯度
手写的梯度是最容易出现隐蔽错误的地方,而错误的梯度不会让程序崩溃:它只会让训练变慢或出错。检验方法是把它与中心差分 (\mathcal{L}(\mathbf{w} + \epsilon\mathbf{e}_j) - \mathcal{L}(\mathbf{w} - \epsilon\mathbf{e}_j))/2\epsilon 比较,在一个随机点上,使用相对误差 \lVert g_{\text{num}} - g\rVert / \lVert g_{\text{num}} + g\rVert。正确的梯度给出的误差远低于 10^{-6}。模块 02把这项检验作为编写反向传播时的常规步骤。
gen = np.random.default_rng(0)
w_probe = 0.1 * gen.normal(size=31)
g = grad_fn(w_probe)
eps = 1e-6
g_num = np.array([(loss_fn(w_probe + eps * e) - loss_fn(w_probe - eps * e)) / (2 * eps)
                  for e in np.eye(31)])
rel = np.linalg.norm(g_num - g) / np.linalg.norm(g_num + g)
print(f"relative error of the gradient: {rel:.1e}")
relative error of the gradient: 1.2e-10
步骤 4:用梯度下降训练
从零出发,以 \eta = 0.5 运行 20,000 步全 batch 梯度下降,并打印第 10、100、1,000 和 20,000 步的损失。开头下降很快、之后拖着很长的尾巴,这是曲率随方向不同而差异很大的问题的典型表现:这份数据标准化后的特征高度相关(这 30 个测量值在很大程度上是描述大小的不同方式)。
w = np.zeros(31)
eta = 0.5
history = {}
for step in range(1, 20_001):
    w = w - eta * grad_fn(w)
    if step in (10, 100, 1_000, 20_000):
        history[step] = loss_fn(w)
for step, value in history.items():
    print(f"step {step:6d}: loss {value:.4f}")
w_gd = w.copy()
print(f"gradient norm at the end: {np.linalg.norm(grad_fn(w_gd)):.1e}")
step     10: loss 0.1233
step    100: loss 0.0760
step   1000: loss 0.0685
step  20000: loss 0.0684
gradient norm at the end: 2.3e-14
步骤 5:与 scikit-learn 比较
LogisticRegression(C=1.0) 最小化的是同一个目标:\sum_i(负对数似然)+
\frac{1}{2C}\lVert\mathbf{w}\rVert^2,它是我们的目标(取 \lambda = 1/(2NC))的 N 倍。默认的收敛容差 tol=1e-4 会让求解器提前停止,此时系数与真正的最小值之间的差异,很容易被误认为是某一个实现中的 bug。代码分别用严格的容差和默认容差拟合,并打印各自与梯度下降解的最大系数差。
def fit_sklearn(tol):
    m = LogisticRegression(C=1.0, tol=tol, max_iter=10_000)
    m.fit(A_tr[:, :30], y_tr)
    return np.append(m.coef_.ravel(), m.intercept_[0])

w_tight = fit_sklearn(1e-8)
w_default = fit_sklearn(1e-4)
print(f"tol = 1e-8: largest coefficient difference = {np.max(np.abs(w_tight - w_gd)):.1e}")
print(f"tol = 1e-4: largest coefficient difference = {np.max(np.abs(w_default - w_gd)):.1e}")
tol = 1e-8: largest coefficient difference = 9.4e-07
tol = 1e-4: largest coefficient difference = 1.6e-02
容差严格时,两个解在约 10^{-6} 内一致。用默认容差时,它们在小数点后第二位出现差异。模型是同一个,不同的是停止规则。在为一个很小的不一致去责怪某个实现之前,值得先知道这一点。
步骤 6:测试集上的混淆矩阵
概率通过阈值变成决策,这里阈值为 0.5。混淆矩阵统计四种结果;行是真实类别,列是预测,负类(良性)排在前面。准确率只有与总是预测多数类的基线相比才有意义,该基线的准确率就是测试集中多数类所占的比例。
p_te = expit(A_te @ w_gd)
pred = (p_te >= 0.5).astype(int)
tn, fp, fn, tp = confusion_matrix(y_te, pred).ravel()
print("confusion matrix [[TN, FP], [FN, TP]]:")
print(np.array([[tn, fp], [fn, tp]]))

accuracy = (tp + tn) / len(y_te)
precision = tp / (tp + fp)
recall = tp / (tp + fn)
f1 = 2 * precision * recall / (precision + recall)
baseline = 1 - y_te.mean()
print(f"accuracy {accuracy:.3f}  precision {precision:.3f}  recall {recall:.3f}  "
      f"F1 {f1:.3f}")
print(f"majority-class baseline accuracy {baseline:.3f}")
confusion matrix [[TN, FP], [FN, TP]]:
[[90  0]
 [ 2 51]]
accuracy 0.986  precision 1.000  recall 0.962  F1 0.981
majority-class baseline accuracy 0.629
接近 0.99 的准确率听上去极好,但只有放在一个无需任何模型的 0.629 基线旁边才有意义。这些错误的代价是不对称的:这里的一个假阴性,就是把恶性病例判为良性。精确率回答“被标记的当中有多少是真的?”,召回率回答“真正的病例当中有多少被标记了?”。这两者在准确率里都看不出来。
步骤 7:ROC 曲线与精确率-召回率曲线
这些曲线扫描阈值,而不是固定阈值。ROC 曲线画的是召回率(真阳性率)对假阳性率;它下面的面积即 AUC,是随机取一个正例得分高于随机取一个负例的概率。精确率-召回率曲线画的是精确率对召回率;随机排序的模型,其精确率等于患病率 53/143 = 0.371,所以这才是它的基线,而不是 0.5。图中标出的点是上一步阈值为 0.5 时的决策。
auc = roc_auc_score(y_te, p_te)
ap = average_precision_score(y_te, p_te)
print(f"ROC AUC           = {auc:.3f}")
print(f"average precision = {ap:.3f}")

fpr, tpr, _ = roc_curve(y_te, p_te)
prec_c, rec_c, thr_c = precision_recall_curve(y_te, p_te)

fig, axes = plt.subplots(1, 2, figsize=(10, 4.2))
axes[0].plot(fpr, tpr, label=f"logistic regression (AUC {auc:.3f})")
axes[0].plot([0, 1], [0, 1], "k--", lw=1, label="chance")
axes[0].plot(fp / (fp + tn), recall, "o", color="C3", label="threshold 0.5")
axes[0].set_xlabel("false-positive rate")
axes[0].set_ylabel("recall (true-positive rate)")
axes[0].set_title("ROC curve, 143 test cases")
axes[0].legend(loc="lower right")
axes[1].plot(rec_c, prec_c, label=f"logistic regression (AP {ap:.3f})")
axes[1].axhline(y_te.mean(), color="k", ls="--", lw=1, label="chance (prevalence 0.371)")
axes[1].plot(recall, precision, "o", color="C3", label="threshold 0.5")
axes[1].set_xlabel("recall")
axes[1].set_ylabel("precision")
axes[1].set_ylim(0.3, 1.05)
axes[1].set_title("Precision-recall curve, 143 test cases")
axes[1].legend(loc="lower left")
plt.tight_layout()
plt.show()
ROC AUC           = 0.996
average precision = 0.994
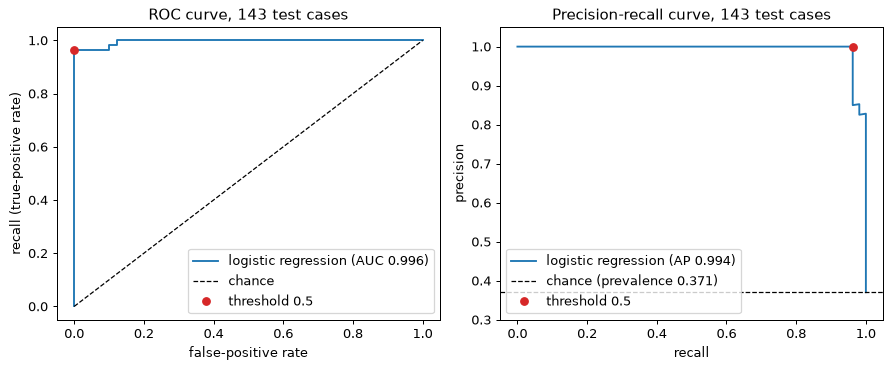
ROC 曲线紧贴左上角:排序极好。然而 AUC 没有说明阈值该放在哪里,而那才是决策。
步骤 8:满足召回率目标的阈值
假设漏掉一个恶性病例是不可接受的,要求是召回率至少为 0.98。precision_recall_curve 在预测发生变化的每一个阈值处返回精确率和召回率。从最高阈值向下扫描,得到满足目标的最大阈值,也就是满足目标者中精确率最好的那个。
def threshold_for_recall(target):
    ok = np.where(rec_c[:-1] >= target)[0]           # rec_c is non-increasing in the index
    i = ok[-1]
    return thr_c[i], prec_c[i], rec_c[i]

print(f"{'target recall':>14} {'threshold':>10} {'precision':>10} {'recall':>8}")
for target in [0.95, 0.98, 1.0]:
    thr, pr, rc = threshold_for_recall(target)
    print(f"{target:14.2f} {thr:10.3f} {pr:10.3f} {rc:8.3f}")
 target recall  threshold  precision   recall
          0.95      0.509      1.000    0.962
          0.98      0.218      0.852    0.981
          1.00      0.116      0.828    1.000
排序极好,阈值依然是一个决策。要满足 0.98 的召回率,需要阈值 0.218,代价是精确率 0.852;要把 53 个恶性病例全部找出,需要 0.116,精确率为 0.828,大致每六个被标记的病例中有一个是良性。这是否可以接受,取决于误报与漏报各自的代价,这是关于应用的问题,而不是关于模型的问题。还要注意,这些是基于 53 个正例的测试集数字:换一个样本,阈值本身也会移动。阈值应当在验证数据上选择,只在测试数据上报告;这里为了说明才使用测试集,正确的流程见实验 4。
步骤 9:校准
如果在被给出 0.8 概率的病例中大约 80% 是正例,则称模型是校准的(calibrated)。可靠性图把测试病例按预测概率分入 5 个等宽的箱,并画出每个箱中正例的比例对该箱平均预测值。期望校准误差(expected calibration error,ECE)是加权的平均差距, \sum_b \frac{n_b}{n}\lvert\text{freq}_b - \text{conf}_b\rvert,对 n 个测试病例求和,定义见第 7 节;Brier 分数是概率的均方误差,\frac{1}{n}\sum_i(\hat p_i - y_i)^2。两者都要计算,而这张图是本实验版本的图 1.6(见第 7 节)。然后给常数预测器打分,它对每个病例都输出训练集患病率 159/426 = 0.373。
def binned_calibration(p, y, n_bins=5):
    edges = np.linspace(0, 1, n_bins + 1)
    idx = np.clip(np.digitize(p, edges[1:-1]), 0, n_bins - 1)
    rows, ece = [], 0.0
    for b in range(n_bins):
        sel = idx == b
        if sel.any():
            rows.append((p[sel].mean(), y[sel].mean(), sel.sum()))
            ece += sel.mean() * abs(y[sel].mean() - p[sel].mean())
    return np.array(rows), ece

rows, ece = binned_calibration(p_te, y_te)
brier = brier_score_loss(y_te, p_te)
print(f"model:    Brier {brier:.3f}  ECE {ece:.3f}  AUC {auc:.3f}")
for mean_p, frac, n in rows:
    print(f"   bin: mean prediction {mean_p:.3f}, fraction positive {frac:.3f}, n = {int(n)}")

p_const = np.full(len(y_te), y_tr.mean())
_, ece_c = binned_calibration(p_const, y_te)
print(f"constant: Brier {brier_score_loss(y_te, p_const):.3f}  ECE {ece_c:.3f}  "
      f"AUC {roc_auc_score(y_te, p_const):.3f}")

fig, ax = plt.subplots(figsize=(5, 4.5))
ax.plot([0, 1], [0, 1], "k--", lw=1, label="perfect calibration")
ax.plot(rows[:, 0], rows[:, 1], "o-", label="logistic regression")
for mean_p, frac, n in rows:
    ax.annotate(f"n={int(n)}", (mean_p, frac), textcoords="offset points", xytext=(5, -12),
                fontsize=8)
ax.set_xlabel("mean predicted probability in the bin")
ax.set_ylabel("fraction of positives in the bin")
ax.set_title("Reliability diagram, 5 bins, 143 test cases")
ax.legend(loc="upper left")
plt.show()
model:    Brier 0.023  ECE 0.023  AUC 0.996
   bin: mean prediction 0.015, fraction positive 0.012, n = 82
   bin: mean prediction 0.278, fraction positive 0.143, n = 7
   bin: mean prediction 0.473, fraction positive 0.250, n = 4
   bin: mean prediction 0.665, fraction positive 1.000, n = 3
   bin: mean prediction 0.996, fraction positive 1.000, n = 47
constant: Brier 0.233  ECE 0.003  AUC 0.500
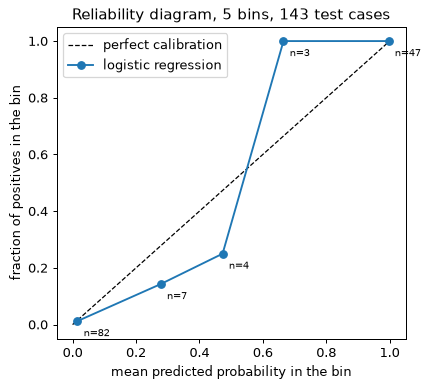
模型的 ECE 很小,但 143 个病例分到 5 个箱里,中间的箱只剩寥寥几个病例,所以每个箱的正例比例都是带噪声的估计,ECE 因这种噪声而偏高(第 7 节)。常数预测器说明了为什么不能单独使用 ECE。它的 ECE 比模型的还小,因为测试集中正例的总体频率接近训练集的患病率,所以它唯一的那个箱几乎是校准的。然而它的 Brier 分数差了十倍,AUC 恰好是 0.5:它对任何单个病例都说不出什么。校准不是区分能力,一种指标不能替代另一种。
步骤 10:在可分数据上去掉惩罚项会怎样
如果存在一个超平面把两类完全分开,那么随着权重沿分离方向增长,似然会不断上升,因为每个样本的 logit 都在正确的一侧离零越来越远。没有惩罚项就没有最小值:\lVert\mathbf{w}\rVert 永远增长,损失趋向于零。是惩罚项让最小值得以存在(第 6 节)。本实验的训练集有 30 个特征和 426 个训练病例,是可分的,运行时令 \lambda = 0,把训练错误数降到零,就证实了这一点。步长取 \eta = 1.0,高于带惩罚问题的上界,这里可以接受,因为概率饱和时 Hessian 矩阵会缩小。
w_sep = np.zeros(31)
checkpoints = {100, 1_000, 10_000, 100_000}
for step in range(1, 100_001):
    w_sep = w_sep - 1.0 * grad_fn(w_sep, lam=0.0)
    if step in checkpoints:
        print(f"step {step:7d}: ||w|| = {np.linalg.norm(w_sep):6.1f}   "
              f"loss = {loss_fn(w_sep, lam=0.0):.4f}")
train_errors = int(np.sum((A_tr @ w_sep >= 0).astype(int) != y_tr))
print("training errors:", train_errors)
step     100: ||w|| =    3.2   loss = 0.0584
step    1000: ||w|| =    6.2   loss = 0.0413
step   10000: ||w|| =   16.1   loss = 0.0256
step  100000: ||w|| =   51.2   loss = 0.0088
training errors: 0
范数不断上升,永不稳定:在 100、1,000、10,000 和 100,000 步时分别为 3.2、6.2、16.1 和 51.2,同时损失从 0.058 降到 0.0088,训练错误数降到零。对于严格可分的数据,增长最终只是步数的对数级,但这次运行还没有进入那个区间(步数每增加十倍,范数依次乘以 1.9、2.6、3.2),所以不要据此外推。重要的是它没有极限:不带惩罚的“解”并不存在,你得到的只是运行停下来时恰好到达的位置。这就是 scikit-learn 默认使用 L2 惩罚的原因,也是为什么在不带惩罚的逻辑回归中看到 10^{3} 的系数是一个警告,而不是一个发现。
你应当看到什么
- 从零实现的模型与 scikit-learn 在双方都收敛后一致。10^{-2} 的不一致来自求解器的容差,而不是模型。
- AUC 接近 0.996 说明排序极好,但阈值依然是一个决策:找出每一个恶性病例,要付出精确率约 0.83 而不是 1.00 的代价。
- 0.986 的准确率只有放在 0.629 的基线旁边才有意义。
- 在可分数据上不带惩罚时,\lVert\mathbf{w}\rVert 无限增长(在三个数量级的步数上从 3.2 增到 51),概率趋于饱和。L2 惩罚正是防止这一点的东西。
- 单看 ECE,常数预测器会排在模型之上;Brier 分数和 AUC 则不会。校准不是区分能力。
动手试试
- 在
load_iris上用你自己的梯度 (\hat{\mathbf{P}} - \mathbf{Y})^\top\mathbf{X}/N 实现 softmax 回归,并与LogisticRegression比较。 - 用 \eta = 2 和 \eta = 5 重复步骤 4。损失仍然下降:对这个非二次的损失,界 \eta < 2/L 是充分条件,而非必要条件。
- 在训练集上用
CalibratedClassifierCV(method='sigmoid', cv=5)重新校准,并比较 Brier 分数和可靠性图。 - 在训练集上用交叉验证得到的概率重新做步骤 8 的阈值搜索,固定阈值,然后在测试集上报告精确率和召回率。它们移动了多少?
实验 3 — 多项式:容量、偏差-方差与岭回归路径
目标。 你在 \sin(2\pi x) 的二十个带噪声的点上重现第 8 节的容量曲线,用蒙特卡洛方法估计每个多项式次数的偏差²和方差,并与固定设计下的精确公式对照,描绘 15 次多项式的岭回归路径,并用五折交叉验证选择惩罚强度。然后用十倍的数据重复这个实验。合成数据,只用 NumPy,无需下载;几秒钟即可跑完。
步骤 1:数据,以及基为什么重要
真实函数为 f(x) = \sin(2\pi x),噪声的标准差为 \sigma = 0.3。训练输入是一个固定设计,即 [0, 1] 上均匀分布的 20 个点,只有噪声是随机的。固定设计让实验保持干净:随机输入会在两端附近留下空隙,高次多项式在那里的方差会大到淹没所有图像。验证输入和测试输入是均匀抽取的,分别为 1,000 个和 10,000 个,抽样按固定顺序来自同一个生成器,所以数字可以复现。
特征是关于 t = 2x - 1 的 Legendre 多项式 P_0(t), \dots, P_d(t),它把 [0, 1] 映射到 [-1, 1]。它们张成的函数空间与单项式 x^k 完全相同,所以在精确算术下拟合出的曲线是一样的;改变的是设计矩阵的条件数。代码打印两种基下 15 次设计的条件数。
import numpy as np
import matplotlib.pyplot as plt
from numpy.polynomial import legendre as L

np.set_printoptions(precision=3, suppress=True)
np.random.seed(0)
SIGMA = 0.3
f = lambda x: np.sin(2 * np.pi * x)

def make_data(n_train, seed=0):
    gen = np.random.default_rng(seed)
    x_tr = np.linspace(0, 1, n_train)                       # fixed design
    y_tr = f(x_tr) + SIGMA * gen.normal(size=n_train)
    x_va = gen.uniform(0, 1, 1000)
    y_va = f(x_va) + SIGMA * gen.normal(size=1000)
    x_te = gen.uniform(0, 1, 10_000)
    y_te = f(x_te) + SIGMA * gen.normal(size=10_000)
    return x_tr, y_tr, x_va, y_va, x_te, y_te

x_tr, y_tr, x_va, y_va, x_te, y_te = make_data(20)
phi = lambda x, d: L.legvander(2 * x - 1, d)                # shape (len(x), d + 1)

t = 2 * x_tr - 1
print(f"condition number, Legendre design, d = 15: {np.linalg.cond(phi(x_tr, 15)):.1f}")
print(f"condition number, monomial design, d = 15: "
      f"{np.linalg.cond(np.vander(t, 16, increasing=True)):.1e}")
condition number, Legendre design, d = 15: 46.7
condition number, monomial design, d = 15: 6.7e+05
Legendre 基在区间上近似正交,这使条件数保持很小。单项式基在高次幂时各列彼此非常接近,它的条件数差了四个数量级。正规方程会把条件数平方,所以对 15 次的单项式,它们会丢掉双精度的大部分有效数字。我们全程使用 Legendre 基。
步骤 2:容量曲线
用最小二乘(np.linalg.lstsq)拟合 0 到 15 次,并记录训练集和验证集上的均方根误差。训练误差不会随次数增加而上升,因为每个模型都包含前一个。验证误差是对拟合在新数据上表现的估计:它应当先降到最小值,然后上升。
def rmse(a, b):
    return float(np.sqrt(np.mean((a - b) ** 2)))

def fit_ls(x, y, d):
    w, *_ = np.linalg.lstsq(phi(x, d), y, rcond=None)
    return w

degrees = list(range(16))
train_err, val_err = [], []
for d in degrees:
    w = fit_ls(x_tr, y_tr, d)
    train_err.append(rmse(phi(x_tr, d) @ w, y_tr))
    val_err.append(rmse(phi(x_va, d) @ w, y_va))

print(" degree  train RMSE  validation RMSE")
for d in degrees:
    print(f"{d:7d} {train_err[d]:11.3f} {val_err[d]:16.3f}")
print("best validation degree:", int(np.argmin(val_err)))
 degree  train RMSE  validation RMSE
      0       0.850            0.769
      1       0.655            0.536
      2       0.648            0.540
      3       0.217            0.354
      4       0.217            0.354
      5       0.183            0.360
      6       0.181            0.360
      7       0.178            0.361
      8       0.173            0.364
      9       0.173            0.365
     10       0.163            0.367
     11       0.141            0.393
     12       0.141            0.393
     13       0.128            0.385
     14       0.123            0.434
     15       0.112            0.720
best validation degree: 4
训练 RMSE 随每一次升阶而下降,在 15 次时达到 0.11,远低于 0.3 的噪声水平:拟合正在追随噪声。验证 RMSE 在 3 次和 4 次时降到约 0.35,到 15 次时升至约 0.72。3 次与 4 次几乎相同,因为 \sin(2\pi x) 关于 x = \tfrac12 是奇函数:4 次加入的偶次 Legendre 项,在这个对称的设计上真实系数恰好为零,所以它只能去拟合噪声。
步骤 3:拟合曲线本身
左图在细网格上画出真实函数、数据以及 1 次、3 次和 15 次的拟合;右图画出 RMSE 曲线。1 次是一条穿过正弦波的直线(欠拟合),3 次跟得上它,15 次穿过几乎每个训练点,并在这些点之间振荡,两端附近的摆幅最大,因为那里 20 个点对多项式的约束最弱。这就是图 1.7。
grid = np.linspace(0, 1, 201)
fig, axes = plt.subplots(1, 2, figsize=(11, 4.3))
axes[0].plot(grid, f(grid), "k", lw=1.5, label=r"true $\sin(2\pi x)$")
axes[0].plot(x_tr, y_tr, "o", color="grey", ms=4, label="20 training points")
for d, colour in [(1, "C0"), (3, "C2"), (15, "C3")]:
    axes[0].plot(grid, phi(grid, d) @ fit_ls(x_tr, y_tr, d), color=colour, label=f"degree {d}")
axes[0].set_ylim(-2.2, 2.2)
axes[0].set_xlabel("x")
axes[0].set_ylabel("y")
axes[0].set_title("Least-squares polynomial fits to 20 noisy points")
axes[0].legend(fontsize=8)

axes[1].plot(degrees, train_err, "o-", label="training")
axes[1].plot(degrees, val_err, "s-", label="validation (1,000 points)")
axes[1].axhline(SIGMA, color="k", ls="--", lw=1, label="noise level $\\sigma$ = 0.3")
axes[1].set_xlabel("polynomial degree")
axes[1].set_ylabel("RMSE")
axes[1].set_title("Training error falls; validation error turns up")
axes[1].legend(fontsize=8)
plt.tight_layout()
plt.show()
步骤 4:偏差²与方差,模拟与精确计算
对固定设计,在点 x 处的期望平方误差如第 8 节那样分解为偏差² + 方差 + \sigma^2,其中偏差是(对训练集取平均的)平均预测与真值之间的差距,方差是预测围绕其平均值的离散程度。两者都可以通过模拟来估计:在相同的输入上抽取 R = 200 组新的噪声,分别重新拟合,并在 201 个点的网格上取平均。
对固定设计上的最小二乘,还有一个精确答案。网格上的拟合值是目标值的线性函数,\hat f_{\text{grid}} = \mathbf{S}\mathbf{y},其中平滑矩阵(smoother matrix)为 \mathbf{S} = \boldsymbol{\Phi}_g(\boldsymbol{\Phi}^\top\boldsymbol{\Phi})^{-1} \boldsymbol{\Phi}^\top。用 QR 分解 \boldsymbol{\Phi} = \mathbf{QR},它等于 \boldsymbol{\Phi}_g\mathbf{R}^{-1}\mathbf{Q}^\top,这样就避免了构造 \boldsymbol{\Phi}^\top\boldsymbol{\Phi}。平均预测为 \mathbf{S}f(x_{\text{train}}),所以偏差²是 (\mathbf{S}f_{\text{train}} - f_{\text{grid}})^2 在网格上的均值,方差是 \sigma^2 乘以 \mathbf{S}^2 各行之和在网格上的均值。
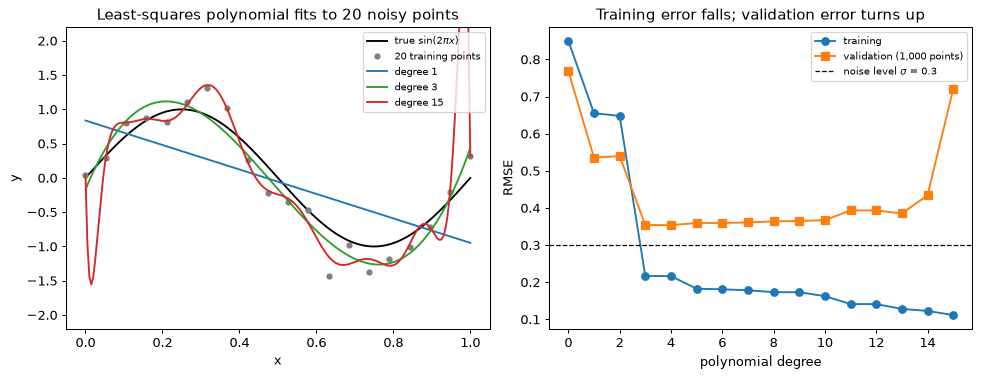
gen_mc = np.random.default_rng(1)
R_DRAWS = 200
noise = SIGMA * gen_mc.normal(size=(R_DRAWS, 20))
Y_sims = f(x_tr)[None, :] + noise                            # (200, 20): fresh targets, same x

def bias_var_mc(d):
    P, Pg = phi(x_tr, d), phi(grid, d)
    W, *_ = np.linalg.lstsq(P, Y_sims.T, rcond=None)         # (d+1, 200): one fit per draw
    preds = Pg @ W                                           # (201, 200)
    return np.mean((preds.mean(axis=1) - f(grid)) ** 2), np.mean(preds.var(axis=1))

def bias_var_exact(d):
    Q, Rm = np.linalg.qr(phi(x_tr, d))
    S = phi(grid, d) @ np.linalg.solve(Rm, Q.T)             # (201, 20) smoother matrix
    return np.mean((S @ f(x_tr) - f(grid)) ** 2), SIGMA**2 * np.mean(np.sum(S**2, axis=1))

print("        Monte Carlo (R = 200)          exact")
print("degree  bias^2  variance  total      bias^2  variance  total")
for d in [0, 1, 2, 3, 4, 5, 9, 12, 15]:
    b_m, v_m = bias_var_mc(d)
    b_e, v_e = bias_var_exact(d)
    print(f"{d:6d} {b_m:7.4f} {v_m:9.4f} {b_m + v_m + SIGMA**2:7.4f}  "
          f"{b_e:9.4f} {v_e:8.4f} {b_e + v_e + SIGMA**2:7.4f}")
        Monte Carlo (R = 200)          exact
degree  bias^2  variance  total      bias^2  variance  total
     0  0.4975    0.0044  0.5919     0.4975   0.0045  0.5920
     1  0.2051    0.0084  0.3034     0.2051   0.0086  0.3037
     2  0.2051    0.0119  0.3070     0.2051   0.0124  0.3075
     3  0.0051    0.0154  0.1104     0.0052   0.0161  0.1113
     4  0.0051    0.0189  0.1140     0.0052   0.0198  0.1150
     5  0.0002    0.0226  0.1128     0.0000   0.0236  0.1136
     9  0.0002    0.0414  0.1316     0.0000   0.0422  0.1322
    12  0.0006    0.0742  0.1648     0.0000   0.0754  0.1654
    15  0.0022    0.9209  1.0130     0.0000   0.8737  0.9637
两块结果在方差上吻合到几个百分点以内。蒙特卡洛的偏差²比精确值大,原因在估计量本身:R = 200 个带噪预测的平均值有它自己的采样方差,即 \text{variance}/R,对平均值取平方就把这一项加进了偏差²。在 15 次,方差为 0.87,预期的膨胀量是 0.87/200 \approx 0.004;这次运行显示的是 0.002,这在一个其方差集中在区间两端附近的量的波动范围之内,那里 201 个网格点中只有很少几个承载了它。那里精确的偏差²精确到四位小数为零,因为 15 次多项式几乎可以完美地在 20 个点上跟随 \sin(2\pi x)。相应地,15 次时蒙特卡洛的总和为 1.01,而精确值为 0.96。总和,即偏差² + 方差 + \sigma^2,就是新点上的期望平方误差:3 次时约为 0.111(RMSE 0.334,接近那一个验证集给出的 0.354),15 次时约为 0.96(RMSE 0.98)。偏差²成对下降(1 次与 2 次,然后 3 次与 4 次),原因就是步骤 2 中的奇函数性质。
方差随次数增长,起初缓慢,到 15 次时变得剧烈,那时 20 个点要拟合 16 个参数,模型几乎在做插值。对 20 个训练输入取平均,方差恰好是 \sigma^2(d + 1)/N,在 15 次时为 0.072;0.87 则是对包含两端的网格取平均,多项式在两端远离数据。
步骤 5:15 次的岭回归路径
保留 15 次的 16 个特征,不删除它们,而是收缩它们。岭回归最小化 \frac{1}{N}\lVert\mathbf{y} - \boldsymbol\Phi\mathbf{w}\rVert^2 + \lambda\lVert\mathbf{w}\rVert^2,其解满足 (\boldsymbol\Phi^\top\boldsymbol\Phi + \lambda N\mathbf{I}')\mathbf{w} = \boldsymbol\Phi^\top\mathbf{y},其中 \mathbf{I}' 是常数项位置为零的单位矩阵,这样截距不会被收缩。代码在 10^{-10} 到 10 之间取 23 个 \lambda 值扫描,并打印训练和验证 RMSE 以及 \lVert\mathbf{w}\rVert。这里 Legendre 基同样重要:若用标准化的单项式,惩罚项作用在尺度很差的列上,即使 \lambda = 10^{-10} 也已经在做正则化,于是路径上过拟合的那一端永远不会出现。
def fit_ridge(x, y, d, lam):
    P = phi(x, d)
    pen = np.eye(P.shape[1])
    pen[0, 0] = 0.0                                          # leave the constant term alone
    return np.linalg.solve(P.T @ P + lam * len(y) * pen, P.T @ y)

lams = np.logspace(-10, 1, 23)
path = []
print("      lambda  train RMSE  val RMSE   ||w||")
for lam in lams:
    w = fit_ridge(x_tr, y_tr, 15, lam)
    row = (lam, rmse(phi(x_tr, 15) @ w, y_tr), rmse(phi(x_va, 15) @ w, y_va),
           np.linalg.norm(w))
    path.append(row)
for i in range(0, 23, 2):
    print(f"{path[i][0]:12.2e} {path[i][1]:11.3f} {path[i][2]:9.3f} {path[i][3]:9.2f}")
best_val = min(path, key=lambda r: r[2])
print(f"best validation RMSE {best_val[2]:.3f} at lambda = {best_val[0]:.3f}")

fig, ax = plt.subplots(figsize=(6.5, 4.2))
ax.semilogx(lams, [r[1] for r in path], "o-", ms=3, label="training")
ax.semilogx(lams, [r[2] for r in path], "s-", ms=3, label="validation")
ax.axhline(SIGMA, color="k", ls="--", lw=1, label="noise level $\\sigma$")
ax.set_xlabel("regularisation strength $\\lambda$")
ax.set_ylabel("RMSE")
ax.set_title("Ridge path at degree 15: from interpolation to underfitting")
ax.legend()
plt.show()
      lambda  train RMSE  val RMSE   ||w||
    1.00e-10       0.112     0.720      2.98
    1.00e-09       0.112     0.720      2.98
    1.00e-08       0.112     0.720      2.98
    1.00e-07       0.112     0.720      2.98
    1.00e-06       0.112     0.719      2.98
    1.00e-05       0.112     0.710      2.95
    1.00e-04       0.112     0.641      2.73
    1.00e-03       0.117     0.441      2.14
    1.00e-02       0.133     0.362      1.85
    1.00e-01       0.319     0.348      1.22
    1.00e+00       0.702     0.629      0.33
    1.00e+01       0.832     0.751      0.07
best validation RMSE 0.335 at lambda = 0.032
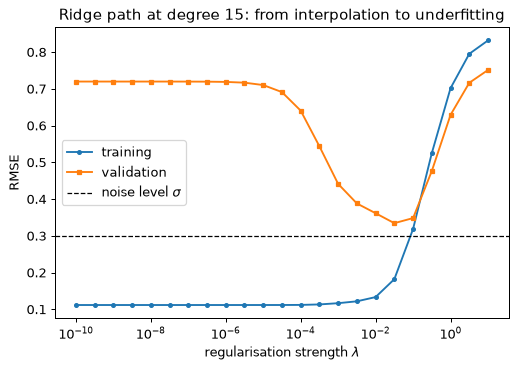
在最左端,惩罚几乎为零,拟合就是未正则化的 15 次拟合:训练 RMSE 接近 0.11,验证 RMSE 接近 0.72。随着 \lambda 增大,权重收缩,训练误差上升而验证误差下降;\lambda 很大时两者一起上升,因为模型被压平成常数。这与次数曲线上的 U 形相同,只是现在沿着一条连续的轴,更容易搜索。验证最小值约为 0.335,出现在 \lambda = 0.03 附近,低于步骤 2 中未正则化的最佳次数(0.354)。
步骤 6:用交叉验证选择 λ
1,000 个点的验证集是一种奢侈。只有 20 个训练点时,诚实的做法只使用这些点:五折交叉验证,即把点打乱,切成五折,每折四个点,每一折轮流由在其余 16 个点上拟合的模型来预测。五个折误差的均值估计该 \lambda 下的误差;它们的标准差除以 \sqrt5 是一个粗略的标准误(第 8 节)。一倍标准误规则(one-standard-error rule)选择平均误差在最小值的一个标准误之内的最强惩罚。选定 \lambda 之后,在全部 20 个点上重新拟合,并在 10,000 个点的测试集上只评估一次,同时评估未正则化的 3 次和 15 次作为对照。
perm = np.random.default_rng(0).permutation(20)
folds = np.array_split(perm, 5)

def cv_scores(lam):
    errs = []
    for k in range(5):
        va = folds[k]
        tr = np.concatenate([folds[j] for j in range(5) if j != k])
        w = fit_ridge(x_tr[tr], y_tr[tr], 15, lam)
        errs.append(np.mean((phi(x_tr[va], 15) @ w - y_tr[va]) ** 2))
    return np.mean(errs), np.std(errs, ddof=1) / np.sqrt(5)

cv = np.array([cv_scores(lam) for lam in lams])
i_min = int(np.argmin(cv[:, 0]))
within = np.where(cv[:, 0] <= cv[i_min, 0] + cv[i_min, 1])[0]
i_1se = int(within.max())
print(f"CV minimum:  lambda = {lams[i_min]:.3f}, CV MSE {cv[i_min, 0]:.3f} "
      f"(standard error {cv[i_min, 1]:.3f})")
print(f"one-SE rule: lambda = {lams[i_1se]:.3f}")

w_cv = fit_ridge(x_tr, y_tr, 15, lams[i_min])
print(f"test RMSE, ridge degree 15 with CV lambda : {rmse(phi(x_te, 15) @ w_cv, y_te):.3f}")
for d in (3, 15):
    print(f"test RMSE, unregularised degree {d:2d}       : "
          f"{rmse(phi(x_te, d) @ fit_ls(x_tr, y_tr, d), y_te):.3f}")
CV minimum:  lambda = 0.032, CV MSE 0.164 (standard error 0.041)
one-SE rule: lambda = 0.032
test RMSE, ridge degree 15 with CV lambda : 0.324
test RMSE, unregularised degree  3       : 0.348
test RMSE, unregularised degree 15       : 0.684
交叉验证选出的 \lambda 接近上一步的验证最小值,尽管它只见过那 20 个训练点。重新拟合的岭回归模型在测试集上胜过最好的未正则化多项式,而未正则化的 15 次多项式则差了两倍多。收缩一个灵活的模型,可以比选择一个小模型做得更好,因为惩罚去掉了灵活模型的大部分方差,却没有带来小模型那样的偏差。测试集只在所有选择都完成之后碰了一次。
步骤 7:与库对照
scikit-learn 中的岭回归 Ridge(alpha=...) 最小化 \lVert\mathbf{y} -
\mathbf{Xw}\rVert^2 + \alpha\lVert\mathbf{w}\rVert^2,不带 1/N 因子,所以 \alpha =
\lambda N。它自己拟合截距,且不对截距施加惩罚,所以给它的特征要去掉常数列。
from sklearn.linear_model import Ridge

lam_c = lams[i_min]
w_mine = fit_ridge(x_tr, y_tr, 15, lam_c)
sk = Ridge(alpha=lam_c * 20, fit_intercept=True).fit(phi(x_tr, 15)[:, 1:], y_tr)
w_sk = np.append(sk.intercept_, sk.coef_)
print(f"largest coefficient difference from Ridge: {np.max(np.abs(w_mine - w_sk)):.1e}")
largest coefficient difference from Ridge: 1.0e-15
两者在舍入误差内一致:本实验的闭式解就是库里的岭回归。
步骤 8:十倍的数据
用 N = 200 个训练点重新跑一遍容量曲线,数据由同一个种子按同样的顺序生成。最小二乘拟合的方差按 \sigma^2(d+1)/N 缩放,所以十倍的数据应当把它降到十分之一,灵活性的代价也随之降低。
x_tr2, y_tr2, x_va2, y_va2, _, _ = make_data(200)
val2 = []
for d in degrees:
    w = fit_ls(x_tr2, y_tr2, d)
    val2.append(rmse(phi(x_va2, d) @ w, y_va2))
print(" degree  validation RMSE (N = 200)   (N = 20)")
for d in [0, 1, 3, 4, 5, 7, 9, 12, 15]:
    print(f"{d:7d} {val2[d]:20.3f} {val_err[d]:12.3f}")
print("best validation degree, N = 200:", int(np.argmin(val2)))
 degree  validation RMSE (N = 200)   (N = 20)
      0                0.797        0.769
      1                0.541        0.536
      3                0.315        0.354
      4                0.315        0.354
      5                0.308        0.360
      7                0.310        0.361
      9                0.310        0.365
     12                0.311        0.393
     15                0.314        0.720
best validation degree, N = 200: 5
有 200 个点时,验证误差从 3 次或 4 次起达到约 0.31 的平台,略高于 0.3 的噪声水平,并且直到 15 次都保持在它的 0.01 以内(最小值 0.308 出现在 5 次):灵活的模型不再受到惩罚,因为它们的方差分摊到了十倍多的点上。数据越多,就越负担得起灵活性,最佳次数也随之上移。这就是第 8 节学习曲线图景的缩影。
你应当看到什么
- 训练 RMSE 从不随次数增加而上升。验证 RMSE 降到约 0.35,到 15 次时升至 0.72。
- 偏差² + 方差 + \sigma^2 在数据采样误差之内重现了验证 MSE。偏差²成对下降,因为 \sin(2\pi x) 关于 x = \tfrac12 是奇函数。
- 蒙特卡洛的偏差²比精确值大约 variance/R,而精确公式完全不需要模拟。
- 经过正则化的 15 次模型在测试集上胜过最好的小型未正则化模型:收缩一个灵活的模型,可以胜过选择一个小模型。
- 数据多十倍时,方差项约小十倍,灵活的模型不再受到惩罚。
动手试试
- 对 15 次,使用原始单项式 x^k 和正规方程 \boldsymbol\Phi^\top\boldsymbol\Phi,观察数据的微小扰动如何让解发生变化:\kappa(\boldsymbol\Phi^\top\boldsymbol\Phi) = \kappa(\boldsymbol\Phi)^2。
- 画学习曲线:对 3 次和 9 次,N 从 10 到 1,000 的期望训练和验证 MSE(图 1.8),对许多次噪声抽样取平均。
- 把五折交叉验证换成留一法(k = 20),并比较所选的 \lambda 和各折误差的离散程度。
- 把固定设计换成 20 个均匀随机输入,对十次不同的抽样重复精确方差的计算:两端的空隙使 15 次多项式爆炸的频率有多高?
实验 4 — 数据泄漏诊所
目标。 搭建三条评估流水线,它们都因为错误的原因报出了漂亮的分数;通过追问“哪些信息越过了数据划分”找出每一处泄漏,并加以修复。随后,你要为可信的结果加上自助法(bootstrap)置信区间,并用配对自助法和 McNemar 精确检验比较两个分类器。有泄漏的流水线分数故意很高。它们的代码里没有任何一行看起来有问题,所以要养成的习惯不是一个工具,而是一个问题:你报告的每个数字,用来得到它的那些行和已拟合的统计量,是否被允许看到它所评分的那些行?理论见第 10 节,指标见第 7 节。全部代码在笔记本电脑的 CPU 上一分钟内即可跑完,无需下载任何东西。
步骤 1:准备环境
本实验只用 scikit-learn。StratifiedKFold、KFold、GroupKFold 和 TimeSeriesSplit 是本实验用到的划分方案;每一种回答的都是“新”样本究竟指什么这一不同的问题。
import numpy as np
import matplotlib.pyplot as plt
from scipy.stats import binomtest, chi2
from sklearn.datasets import load_breast_cancer
from sklearn.ensemble import RandomForestClassifier, RandomForestRegressor
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import (
    GroupKFold, KFold, StratifiedKFold, TimeSeriesSplit,
    cross_val_score, train_test_split,
)
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

np.random.seed(0)
print("ready")
ready
步骤 2:泄漏 1,在交叉验证之前选择特征
数据是纯噪声:100 个样本,5000 个特征,标签由抛硬币决定。没有任何模型能在新数据上做到超过 50%,因为根本没有可学的东西。
有泄漏的流水线先用全部 100 行挑出与标签相关性最高的 20 个特征,然后才在这 20 列上对分类器做交叉验证。在 5000 个候选中,仅靠挑选,这 20 个看起来最好的列就会显得很好:5000 个噪声相关系数中的最大值远不为零。交叉验证随后划分了行,但特征选择已经看过每一行,包括每一折的测试行,于是测试标签已经泄漏进了特征的选择。
可信的流水线把特征选择放进 Pipeline,这样它在每一折的训练部分上重新拟合,永远看不到该折的测试行。两者使用相同的折。
def noise_problem(seed):
    rng = np.random.default_rng(seed)
    return rng.normal(size=(100, 5000)), rng.integers(0, 2, 100)

def leak1_scores(seed):
    X, y = noise_problem(seed)
    cv = StratifiedKFold(5, shuffle=True, random_state=0)
    clf = LogisticRegression(max_iter=1000)
    X_leaky = SelectKBest(f_classif, k=20).fit_transform(X, y)      # sees every row
    leaky = cross_val_score(clf, X_leaky, y, cv=cv)
    honest_model = make_pipeline(SelectKBest(f_classif, k=20),
                                 LogisticRegression(max_iter=1000))
    honest = cross_val_score(honest_model, X, y, cv=cv)             # selection per fold
    return leaky, honest

leaky, honest = leak1_scores(0)
print(f"leaky : {leaky.mean():.2f} +/- {leaky.std():.2f}")
print(f"honest: {honest.mean():.2f} +/- {honest.std():.2f}")

for seed in (1, 2, 3):
    leaky, honest = leak1_scores(seed)
    print(f"seed {seed}: leaky {leaky.mean():.2f}   honest {honest.mean():.2f}")
leaky : 0.87 +/- 0.05
honest: 0.50 +/- 0.09
seed 1: leaky 0.92   honest 0.58
seed 2: leaky 0.84   honest 0.55
seed 3: leaky 0.83   honest 0.45
可信的分数在 0.5 附近波动,理应如此。有泄漏的分数在每个种子下都远高于它:这是一个用噪声“制造”出来的结果。有泄漏的分数在各折之间的离散程度很小,这让这个数字不仅看起来好,还看起来可靠。
步骤 3:温和的情形,在交叉验证之前标准化
同样的错误,换成一个无害的统计量。这里先用全部 569 行的均值和标准差对整个乳腺癌数据集做标准化,再做交叉验证;可信的版本则把标准化器放进流水线里拟合。这一泄漏是真实存在的,因为每个测试行都影响了用来缩放它的均值和方差;但均值和方差每个特征只有两个数,由几百行估计得到,每一行对它们的影响量级为 1/N。
data = load_breast_cancer()
X_bc, y_bc = data.data, 1 - data.target     # flip: malignant becomes the positive class
cv5 = StratifiedKFold(5, shuffle=True, random_state=0)
clf = LogisticRegression(max_iter=1000)

X_scaled_all = StandardScaler().fit_transform(X_bc)                 # sees every row
leaky = cross_val_score(clf, X_scaled_all, y_bc, cv=cv5)
honest = cross_val_score(make_pipeline(StandardScaler(), clf), X_bc, y_bc, cv=cv5)
print(f"scaler fitted on all rows : {leaky.mean():.4f}")
print(f"scaler inside the pipeline: {honest.mean():.4f}")
scaler fitted on all rows : 0.9789
scaler inside the pipeline: 0.9789
两者一致。只用许多行估计少数几个数的无监督预处理,泄漏很小。但不要由此断定它是安全的:由很少几行估计的统计量,或用到标签的统计量(如上面的特征选择),就不是无害的。规则是把每一个需要拟合的步骤都放进流水线,因为这样做没有代价,还省去了逐个情形判断的麻烦。
步骤 4:泄漏 2,同一个试件同时出现在划分的两侧
四十个试件,每个测量十次。每个试件有一个指纹(一个能标识它的十维向量,比如它的几何形状或加工方式)和一个二元标签,比如有缺陷或完好。一个试件的十行就是它的指纹加上微小的测量噪声。标签有一个微弱的真实效应:它把第 0 列平移 \pm 0.3。所以信号是存在的,但与试件之间指纹的离散程度相比很小。
按行划分会把一个试件的一些行放进训练集,另一些行放进测试折。灵活的模型随后就能凭指纹认出这个试件,并凭记忆读出标签。这不是你想预测的性质,也不会迁移到新试件上。GroupKFold 让同一个试件的所有行都在同一侧。
rng = np.random.default_rng(0)
n_spec, n_rep = 40, 10
spec_label = rng.integers(0, 2, n_spec)
fingerprint = rng.normal(0, 1, (n_spec, 10))
rows, labels, groups = [], [], []
for s in range(n_spec):
    block = fingerprint[s] + 0.3 * rng.normal(size=(n_rep, 10))
    block[:, 0] += 0.3 * (2 * spec_label[s] - 1)                    # the weak real signal
    rows.append(block)
    labels += [spec_label[s]] * n_rep
    groups += [s] * n_rep
X_sp, y_sp, g_sp = np.vstack(rows), np.array(labels), np.array(groups)
print("rows:", X_sp.shape, " specimens:", len(set(g_sp)),
      " positive fraction:", f"{y_sp.mean():.2f}")

forest = RandomForestClassifier(n_estimators=300, random_state=0, n_jobs=1)
knn = make_pipeline(StandardScaler(), KNeighborsClassifier(5))
row_cv = KFold(5, shuffle=True, random_state=0)
group_cv = GroupKFold(5)
for name, model in (("random forest", forest), ("5-NN", knn)):
    by_row = cross_val_score(model, X_sp, y_sp, cv=row_cv)
    by_group = cross_val_score(model, X_sp, y_sp, cv=group_cv, groups=g_sp)
    print(f"{name:14s} by row {by_row.mean():.2f}   "
          f"by specimen {by_group.mean():.2f} +/- {by_group.std():.2f}")
rows: (400, 10)  specimens: 40  positive fraction: 0.57
random forest  by row 0.95   by specimen 0.63 +/- 0.14
5-NN           by row 1.00   by specimen 0.64 +/- 0.14
两个模型按行划分的分数都接近完美。按试件划分后,分数接近随机水平,各折之间的离散程度很大:只有 40 个试件、每折八个,又只有微弱的信号,数据能支撑的就是这样的结果。按行划分的数字并不是同一个估计稍微乐观了一点。它回答的是另一个问题:“模型能不能认出它见过的试件?”
步骤 5:泄漏 3,打乱时间序列
一台泵的轴承温度每小时记录一次,共 120 天。目标是一个导出量(比如泵壳温度),由日周期、一部分随轴承温度变化的成分、一个缓慢的随机漂移,再加上标准差为 2 的噪声构成。特征是时间索引 t、一天中的小时和轴承温度。由于噪声的标准差为 2.0,没有任何模型能在新数据上把 RMSE 做到低于 2.0:这就是噪声下限。
打乱后的划分会把第 100 小时放进训练集,而把第 99 和 101 小时放进测试折。漂移在三个小时内几乎不变,所以只要森林学到了“时间索引接近 100 意味着大致是这个水平”,就能把它插值出来。这之所以可能,只是因为未来泄漏进了过去。TimeSeriesSplit 在起始的一段上训练,在紧随其后的一段上测试,而 gap=24 在两者之间留出一天,使最后一个训练小时不与第一个测试小时相邻。
rng = np.random.default_rng(0)
t = np.arange(2880)
hour = t % 24
drift = np.cumsum(rng.normal(0, 0.2, 2880))
temp = 10 + 8 * np.sin(2 * np.pi * (hour - 9) / 24) + rng.normal(0, 1, 2880)
y_ts = (50 + 0.8 * temp + 5 * np.sin(2 * np.pi * hour / 24) + drift
        + rng.normal(0, 2, 2880))
X_ts = np.column_stack([t, hour, temp])

def make_forest():
    return RandomForestRegressor(100, min_samples_leaf=2, random_state=0, n_jobs=1)

def forecast_scores(cv):
    rmse, r2 = [], []
    for train, test in cv.split(X_ts):
        model = make_forest().fit(X_ts[train], y_ts[train])
        resid = y_ts[test] - model.predict(X_ts[test])
        rmse.append(np.sqrt(np.mean(resid ** 2)))
        r2.append(1 - np.sum(resid ** 2) / np.sum((y_ts[test] - y_ts[test].mean()) ** 2))
    return np.mean(rmse), np.mean(r2)

shuffled = forecast_scores(KFold(5, shuffle=True, random_state=0))
forward = forecast_scores(TimeSeriesSplit(5, gap=24))
print(f"shuffled KFold          RMSE {shuffled[0]:.2f}   R^2 {shuffled[1]:.2f}")
print(f"TimeSeriesSplit(gap=24) RMSE {forward[0]:.2f}   R^2 {forward[1]:.2f}")
print("noise floor             RMSE 2.00")
shuffled KFold          RMSE 2.33   R^2 0.88
TimeSeriesSplit(gap=24) RMSE 4.09   R^2 -0.01
noise floor             RMSE 2.00
打乱后的分数刚好略高于 2.0 的噪声下限:模型似乎解释了几乎所有可以解释的东西。前向链式划分给出的 RMSE 大约是前者的两倍,R^2 接近零,因为模型无法外推一个已经游走到训练期间所在位置之外的随机游走。两者都是对不同问题的诚实回答;只有第二个回答的是“这个模型在下个月的数据上表现如何?”。前向链式划分某一折的 R^2 以该折自身的方差为基线,可能为负,所以比较不同划分方案时,应优先看 RMSE。
train, test = list(TimeSeriesSplit(5, gap=24).split(X_ts))[-1]
model = make_forest().fit(X_ts[train], y_ts[train])
fig, ax = plt.subplots(figsize=(8, 3.5))
ax.plot(t[test][:240], y_ts[test][:240], label="measured", lw=1.2)
ax.plot(t[test][:240], model.predict(X_ts[test])[:240], label="forecast", lw=1.2)
ax.set_xlabel("hour index")
ax.set_ylabel("casing temperature")
ax.set_title("Last forward-chaining fold: the forecast misses the drift")
ax.legend()
plt.show()
步骤 6:为可信的结果加上区间
现在是一个可信的结果,以及它有多精确的问题。按实验 2 的方式划分乳腺癌数据(25% 作测试集,分层,random_state=0,得到 143 个测试样本),并拟合两个分类器:逻辑回归和 15 近邻,二者都在标准化之后进行。
百分位自助法对这 143 个测试样本做 R = 2{,}000 次有放回重抽样,在每次重抽样上重新计算准确率,并报告第 2.5 和第 97.5 百分位数。两个模型使用相同的重抽样索引,这正是下一段代码块中的比较成为配对比较的原因。
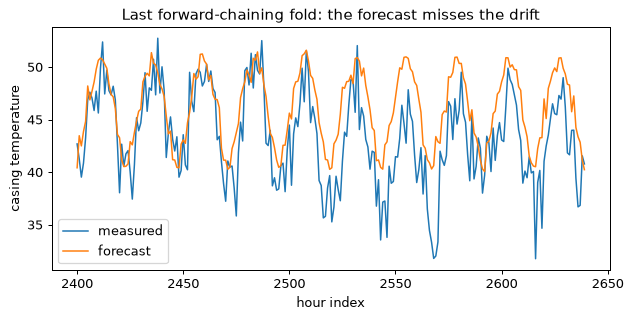
Xtr, Xte, ytr, yte = train_test_split(
    X_bc, y_bc, test_size=0.25, random_state=0, stratify=y_bc)
logreg = make_pipeline(StandardScaler(), LogisticRegression(C=1)).fit(Xtr, ytr)
knn15 = make_pipeline(StandardScaler(), KNeighborsClassifier(15)).fit(Xtr, ytr)
ok_a = (logreg.predict(Xte) == yte).astype(float)       # 1 where model A is right
ok_b = (knn15.predict(Xte) == yte).astype(float)
n = len(yte)
print(f"test cases {n}; errors: logistic {int(n - ok_a.sum())}, "
      f"15-NN {int(n - ok_b.sum())}")
print(f"accuracy: logistic {ok_a.mean():.3f}, 15-NN {ok_b.mean():.3f}")

R = 2000
rng = np.random.default_rng(0)
idx = rng.integers(0, n, size=(R, n))                   # shared by both models
acc_a, acc_b = ok_a[idx].mean(axis=1), ok_b[idx].mean(axis=1)
for name, acc in (("logistic", acc_a), ("15-NN", acc_b)):
    lo, hi = np.percentile(acc, [2.5, 97.5])
    print(f"{name:9s} 95% interval [{lo:.3f}, {hi:.3f}]")
test cases 143; errors: logistic 2, 15-NN 7
accuracy: logistic 0.986, 15-NN 0.951
logistic  95% interval [0.965, 1.000]
15-NN     95% interval [0.909, 0.986]
两个区间有重叠,这常被解读为“没有显著差异”。这种解读一般来说是错的:两个准确率是在同样的样本上算出来的,对一个模型容易的样本,大多对另一个也容易,所以两者的错误是正相关的,差值的确定程度比任何一个准确率都高。配对自助法逐个样本地对差值重抽样;它的直方图就是本实验中对图 1.14 右图的复现。
diff = acc_a - acc_b
lo, hi = np.percentile(diff, [2.5, 97.5])
print(f"observed difference {ok_a.mean() - ok_b.mean():.3f}")
print(f"paired 95% interval [{lo:.3f}, {hi:.3f}]")
print(f"fraction of replicates with difference <= 0: {np.mean(diff <= 0):.4f}")

n_a_only = int(np.sum((ok_a == 1) & (ok_b == 0)))       # A right, B wrong
n_b_only = int(np.sum((ok_a == 0) & (ok_b == 1)))       # A wrong, B right
print(f"discordant cases: A right/B wrong {n_a_only}, A wrong/B right {n_b_only}")
print(f"chance a resample contains none of the {n_a_only} cases: "
      f"{((n - n_a_only) / n) ** n:.4f}")

fig, ax = plt.subplots(figsize=(6, 3.5))
ax.hist(diff, bins=30, color="tab:blue", edgecolor="white")
ax.axvline(0, color="k", ls="--", label="no difference")
ax.set_xlabel("accuracy(logistic) - accuracy(15-NN) on a bootstrap resample")
ax.set_ylabel("number of replicates")
ax.set_title("Paired bootstrap of the accuracy difference (R = 2000)")
ax.legend()
plt.show()
observed difference 0.035
paired 95% interval [0.007, 0.070]
fraction of replicates with difference <= 0: 0.0065
discordant cases: A right/B wrong 5, A wrong/B right 0
chance a resample contains none of the 5 cases: 0.0062
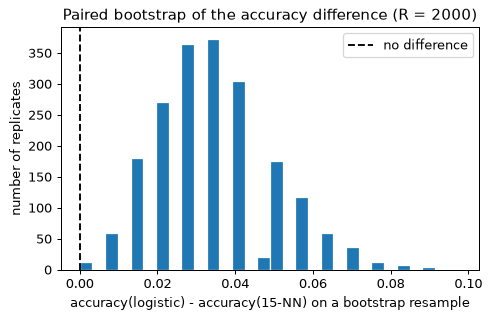
配对区间不包含零。重复实验说明了原因:只有当某次重抽样没有抽到两个模型意见不一致的那五个样本时,差值才可能为零或为负,而这种情况的概率是 (138/143)^{143}。
步骤 7:McNemar 精确检验,以及自助法与检验为何不一致
只有不一致的样本才携带关于差异的信息:两个模型都对或都错的地方,无法说明哪个更好。在两个模型准确率相同的零假设下,每个不一致样本倒向哪一边的可能性相等,所以只有 A 正确的样本数服从二项分布,试验次数为 n_{10} + n_{01},成功概率为 0.5。McNemar 精确检验就是对这个计数做二项检验。这里 n_{10} 是 A 对 B 错的样本数,n_{01} 是反过来的样本数。
常见的 \chi^2 形式 (n_{10} - n_{01})^2/(n_{10} + n_{01}) 在计数较大时近似精确检验。不一致样本很少时,它会夸大证据。下面把三者都算出来。
n10, n01 = n_a_only, n_b_only
exact = binomtest(n10, n10 + n01, 0.5).pvalue
chi_plain = (n10 - n01) ** 2 / (n10 + n01)
chi_corrected = (abs(n10 - n01) - 1) ** 2 / (n10 + n01)
print(f"discordant counts n10 = {n10}, n01 = {n01}")
print(f"exact binomial test        p = {exact:.4f}")
print(f"chi-square {chi_plain:.1f}              p = {chi2.sf(chi_plain, 1):.3f}")
print(f"corrected chi-square {chi_corrected:.1f}    p = {chi2.sf(chi_corrected, 1):.3f}")
discordant counts n10 = 5, n01 = 0
exact binomial test        p = 0.0625
chi-square 5.0              p = 0.025
corrected chi-square 3.2    p = 0.074
对于“0.035 的差异是真实的吗?”,这几种方法给出了不同的回答。配对自助法说是,未校正的 \chi^2 也说是(p = 0.025)。对这样的计数而言正确的精确检验,在 5% 水平上并不拒绝(p = 0.0625);经连续性校正的 \chi^2 在结论上与它一致。它们不一致,是因为可供判断的信息太少。自助法对观测到的样本重抽样,而这里有五个不一致样本,反方向的一个也没有,所以每个至少含其中一个的重抽样,差值都为正,区间因此不可能跨过零。它把样本中五比零的分布当作了真相,在计数这么小的时候,这会低估不确定性。而在公平硬币下,五比零也并非不可能:它出现的概率是 2 \times (1/2)^5 = 0.0625。
诚实的报告应包含差值(0.035,143 个样本中的五个)、不一致样本的计数(5 和 0)以及精确 p 值(0.0625),并说明数据提示逻辑回归更好,但 143 个样本太少,无法确定。只报告“配对自助法区间不包含零”,会是对一个具有误导性的结果的正确陈述。要在看到计数之前就决定用精确检验,而不是看到之后。
步骤 8:汇总表
# values copied from Steps 2 to 5 above
table = [
    ("feature selection before CV", "0.87", "0.50", "selection inside the pipeline"),
    ("scaler before CV", "0.9789", "0.9789", "scaler inside the pipeline (free)"),
    ("rows of one specimen split", "0.95 / 1.00", "0.63 / 0.64", "GroupKFold by specimen"),
    ("shuffled time series (RMSE)", "2.33", "4.09", "TimeSeriesSplit with a gap"),
]
print(f"{'case':30s} {'leaky':>12s} {'honest':>12s}   the fix")
for case, leaky_score, honest_score, fix in table:
    print(f"{case:30s} {leaky_score:>12s} {honest_score:>12s}   {fix}")
case                                  leaky       honest   the fix
feature selection before CV            0.87         0.50   selection inside the pipeline
scaler before CV                     0.9789       0.9789   scaler inside the pipeline (free)
rows of one specimen split      0.95 / 1.00  0.63 / 0.64   GroupKFold by specimen
shuffled time series (RMSE)            2.33         4.09   TimeSeriesSplit with a gap
你应该看到什么
- 在全部数据上选择特征,会从纯噪声中制造出约 0.87 的准确率;放进流水线后,分数在每个种子下都回到随机水平,约 0.50。
- 在全部数据上标准化,对乳腺癌数据没有可测量的影响:泄漏存在,但可以忽略。修复没有代价,所以仍要做。
- 按行划分时,两个模型都是在认试件,而不是在学那个性质。按试件划分时,两者都接近随机水平,且离散程度很大,这才是 40 个试件加微弱信号的真实面貌。
- 打乱后的时间序列分数处于噪声下限,因为森林从相邻小时插值出了漂移。前向链式划分表明它并不能预测漂移。
- 分开看的区间有重叠,而配对区间不包含零,所以比较需要用配对方法。McNemar 精确检验(p = 0.0625)在 5% 水平上不拒绝:只有五个不一致样本时,自助法区间过窄。诚实的总结是差值、计数和精确 p 值。
动手试试
- 模型选择中的选择偏差。 在
X形状为(100, 50)的纯噪声上,对 200 个随机的 5 特征子集做 5 折交叉验证打分,保留最好的一个:它能达到约 0.67。然后把这一搜索包进外层的 5 折循环(嵌套交叉验证:在每个外层训练部分内选子集,在外层测试部分上打分),看分数降到约 0.56。(这是用default_rng(0)生成数据时的值;种子 1 和 2 分别给出 0.70 与 0.60、0.64 与 0.54,所以约 0.1 的差距才是稳定的部分。)许多带噪声的分数中的最好者,是对自身质量的乐观估计。这大约需要 20 秒。 - 聚类自助法。 对泄漏 2,对试件而不是对行做重抽样,并把区间宽度与按行自助法的相比较。同一试件的各行并不独立,所以按行自助法的区间过窄。
- 目标泄漏。 加一列等于标签加小噪声的特征(一个在结果出来之后才记录的“结果代码”),观察每个模型在每一种划分方案下都变得表现出色。划分无法修复一个在预测时拿不到的特征;只有弄清该特征的含义才行。
- 种子彩票。 在步骤 6 中让划分的
random_state取 1 到 5 重复一遍。逻辑回归有多少次更好?不一致样本的计数和精确 p 值会怎样变化?
实验 5 — 拟合超弹性材料模型
目标。 用加权最小二乘法,把一种软水凝胶的 neo-Hookean 系数 c_1 拟合到一组合成的压缩试验数据上,用蒙特卡洛实验检验其不确定性公式,然后观察一个在其适用范围内表现干净的拟合如何在范围之外失效。你要从残差中发现失配,拟合 Gent 模型(它有一个参数位于分母中,因此需要非线性最小二乘法),观察它的两个参数如何相互权衡,并编写输入检查,让拟合例程拒绝它无法遵守的输入。背景见第 12 节;最小二乘和不确定性的公式来自第 2 节和第 5 节。数据是合成的,这样每个数字都能复现。全部代码在笔记本电脑的 CPU 上几秒内即可跑完,无需下载任何东西。
步骤 1:模型与合成试验
在单轴拉伸比 \lambda(变形后长度与原长之比,所以压缩时 \lambda < 1)下,不可压缩的 neo-Hookean 固体的名义应力为
Gent 模型描述聚合物链接近其可延伸极限时的变硬:
其中 \beta = 1/J_m,而 \beta = 0 退化为 neo-Hookean。本实验中的“真实”材料是 c_1 = 10 kPa、\beta = 0.2 的 Gent 材料。试验有 16 个拉伸比 \lambda = 1 - 0.025k,k = 1, \dots, 16(应变从 2.5% 到 40%)。每个点都记录了标准不确定度 \sigma_i = 0.05\ \text{kPa} + 0.02\,|P_{\text{true},i}|,即一个小的下限加上读数的 2%;测量值是真实应力加上这一大小的高斯噪声。按这一约定,压缩应力为负。
import numpy as np
import matplotlib.pyplot as plt
from scipy.optimize import least_squares
from scipy.stats import chi2

np.random.seed(0)

def g(lam):
    return lam - lam ** -2.0

def i1_minus_3(lam):
    return lam ** 2 + 2.0 / lam - 3.0

def p_neo_hookean(lam, c1):
    return 2.0 * c1 * g(lam)

def p_gent(lam, c1, beta):
    return 2.0 * c1 * g(lam) / (1.0 - beta * i1_minus_3(lam))

k = np.arange(1, 17)
lam = 1.0 - 0.025 * k                                   # compression: 0.975 ... 0.600
p_true = p_gent(lam, 10.0, 0.2)
sigma = 0.05 + 0.02 * np.abs(p_true)                    # kPa, recorded with each point
p_meas = p_true + sigma * np.random.default_rng(1).normal(size=16)

print(" k  stretch  stress (kPa)  sigma (kPa)")
for ki, li, pi, si in zip(k, lam, p_meas, sigma):
    print(f"{ki:2d}   {li:.3f}   {pi:9.2f}    {si:8.3f}")
 k  stretch  stress (kPa)  sigma (kPa)
 1   0.975       -1.51       0.081
 2   0.950       -3.07       0.113
 3   0.925       -4.84       0.148
 4   0.900       -6.98       0.185
 5   0.875       -8.51       0.224
 6   0.850      -10.73       0.267
 7   0.825      -13.33       0.313
 8   0.800      -15.48       0.364
 9   0.775      -18.32       0.419
10   0.750      -21.40       0.481
11   0.725      -24.95       0.549
12   0.700      -28.47       0.626
13   0.675      -33.70       0.713
14   0.650      -38.28       0.813
15   0.625      -44.33       0.928
16   0.600      -49.93       1.061
应力从 2.5% 应变时的 -1.51 kPa 变化到 40% 应变时的 -49.93 kPa,记录的不确定度随之增大。这就是拟合必须加权的原因:不加权的拟合会让应力大、绝对噪声也最大的点占据主导。
步骤 2:拒绝无法遵守的输入
总是返回一个数的拟合例程是危险的,因为一个数看起来就像一个结果。拟合之前,check_inputs 会拒绝缺失或非正的不确定度(没有不确定度,加权最小二乘就没有意义)、位于声明的加载方向错误一侧的拉伸比,以及符号与该方向矛盾的应力。拟合之后,例程还会拒绝非正的刚度,因为那不是一种材料。每次拒绝都会说明理由。
def check_inputs(lam, p, sigma, direction):
    lam, p = np.asarray(lam, float), np.asarray(p, float)
    if direction not in ("compression", "tension"):
        raise ValueError(f"direction must be compression or tension, got {direction!r}")
    if sigma is None:
        raise ValueError("no uncertainty supplied: weighted least squares needs one per point")
    sigma = np.asarray(sigma, float)
    if sigma.shape != p.shape or not np.all(np.isfinite(sigma)) or np.any(sigma <= 0):
        raise ValueError("every point needs a finite, positive uncertainty")
    sign = 1.0 if direction == "compression" else -1.0
    if np.any(sign * (1.0 - lam) <= 0):
        raise ValueError(f"declared {direction}, but some stretches are on the wrong side of 1")
    if np.any(-sign * p <= 0):
        raise ValueError(f"declared {direction}, but some stresses have the wrong sign")

cases = {
    "no uncertainty": (lam, p_meas, None, "compression"),
    "tension stretches, compression declared": (1 + 0.025 * k, p_meas, sigma, "compression"),
    "stress sign flipped": (lam, -p_meas, sigma, "compression"),
}
for name, args in cases.items():
    try:
        check_inputs(*args)
        print(f"{name}: accepted")
    except ValueError as err:
        print(f"{name}: refused -> {err}")
check_inputs(lam, p_meas, sigma, "compression")
print("the real data: accepted")
no uncertainty: refused -> no uncertainty supplied: weighted least squares needs one per point
tension stretches, compression declared: refused -> declared compression, but some stretches are on the wrong side of 1
stress sign flipped: refused -> declared compression, but some stresses have the wrong sign
the real data: accepted
步骤 3:加权最小二乘的闭式解
似然是高斯的,每个点的方差各不相同,所以极大似然就是加权最小二乘:在 w_i = 1/\sigma_i^2 下最小化 \sum_i w_i\,(P_i - 2c_1 g_i)^2。令导数为零,得到
方差之所以如此,是因为 \hat c_1 是带噪声的 P_i 的线性函数。由此得到两个诊断量:归一化残差 (P_i - \hat P_i)/\sigma_i,它们应当看起来像标准正态抽样;以及 \chi^2_\nu,即归一化残差的平方和除以 n - 1 个自由度,它应当接近 1。
我们只拟合前 8 个点,即应变至 20% 的部分,在这一范围内 neo-Hookean 模型是合理的描述。例程还会报告 RMS 残差除以拟合范围内最大测量应力的结果,这一约定让不同试件的拟合可以相互比较(引用它时要同时说明所拟合的应变范围)。对加权残差调用 scipy.optimize.least_squares 应当得到同样的 c_1。
def fit_neo_hookean(lam, p, sigma, direction="compression"):
    check_inputs(lam, p, sigma, direction)
    w, gg = 1.0 / sigma ** 2, g(lam)
    s_gg = np.sum(w * gg ** 2)
    c1 = np.sum(w * p * gg) / (2.0 * s_gg)
    if c1 <= 0:
        raise ValueError(f"fitted stiffness c1 = {c1:.3f} is not positive: not a material")
    resid = p - p_neo_hookean(lam, c1)
    return {
        "c1": c1,
        "se": 1.0 / (2.0 * np.sqrt(s_gg)),
        "norm_resid": resid / sigma,
        "chi2_nu": np.sum((resid / sigma) ** 2) / (len(p) - 1),
        "rms_pct": 100 * np.sqrt(np.mean(resid ** 2)) / np.max(np.abs(p)),
    }

n_fit = 8
fit20 = fit_neo_hookean(lam[:n_fit], p_meas[:n_fit], sigma[:n_fit])
print(f"c1 = {fit20['c1']:.2f} +/- {fit20['se']:.2f} kPa   "
      f"chi2_nu = {fit20['chi2_nu']:.2f}")
print("normalised residuals:", np.round(fit20["norm_resid"], 2))
print(f"RMS residual = {fit20['rms_pct']:.1f}% of the largest stress in range")

def weighted_resid(theta):
    return (p_meas[:n_fit] - p_neo_hookean(lam[:n_fit], theta[0])) / sigma[:n_fit]

check = least_squares(weighted_resid, x0=[5.0])
print(f"least_squares check: c1 = {check.x[0]:.2f}")
c1 = 10.09 +/- 0.10 kPa   chi2_nu = 0.71
normalised residuals: [ 0.51  1.03  0.52 -1.21  0.86  0.2  -1.04 -0.24]
RMS residual = 1.1% of the largest stress in range
least_squares check: c1 = 10.09
拟合恢复出 c_1 \approx 10.09 kPa,而真值为 10,标准误差为 0.10:估计值与真值相差不到一个标准误差。归一化残差在约 \pm 1.2 之内散布,没有规律,\chi^2_\nu = 0.71 与 1 相符(在 7 个自由度下,\chi^2_\nu 的 95% 范围大约是 0.24 到 2.3)。对这些数据而言,这个模型是够用的,尽管它并不是真实的模型。
步骤 4:用模拟检验所引用的不确定度
公式 \operatorname{Var}(\hat c_1) = 1/(4\sum_i w_i g_i^2) 假定噪声恰如记录所示。用模拟来检验:由拟合曲线加上具有相同 \sigma_i 的新噪声,生成 1000 个新数据集,对每个重新拟合,并把这 1000 个系数的离散程度与公式比较。
rng = np.random.default_rng(2)
lam8, sig8 = lam[:n_fit], sigma[:n_fit]
curve = p_neo_hookean(lam8, fit20["c1"])
w8, g8 = 1.0 / sig8 ** 2, g(lam8)
refits = []
for _ in range(1000):
    p_new = curve + sig8 * rng.normal(size=n_fit)
    refits.append(np.sum(w8 * p_new * g8) / (2.0 * np.sum(w8 * g8 ** 2)))
refits = np.array(refits)
print(f"Monte Carlo mean {refits.mean():.3f}, SD {refits.std(ddof=1):.4f}")
print(f"formula SD       {fit20['se']:.4f}")
Monte Carlo mean 10.087, SD 0.0999
formula SD       0.0997
两个标准差的吻合程度在百分之一左右。对于参数线性的模型,公式是精确的,所以唯一的差异来自模拟自身的抽样误差(约为标准差的 1/\sqrt{2 \times 1000} = 2\%)。这一检验的价值体现在下面的非线性拟合上,那里公式只是一个线性化近似。
步骤 5:带置信带的外推
c_1 的方差给出了任意拉伸比处预测的置信带:P(\lambda) = 2c_1 g(\lambda) 是 c_1 的线性函数,所以它的标准误差是 2|g(\lambda)|\,\mathrm{SE}(c_1),95% 置信带是它的 \pm 1.96 倍。预测 \lambda = 0.7(30% 应变)和 \lambda = 0.6(40%)处的应力,这两点都在拟合范围之外,并与真实材料相比较。
for target in (0.7, 0.6):
    pred = p_neo_hookean(target, fit20["c1"])
    half = 1.96 * 2.0 * abs(g(target)) * fit20["se"]
    truth = p_gent(target, 10.0, 0.2)
    print(f"lambda = {target}: predicted {pred:.2f} +/- {half:.2f} kPa, "
          f"true {truth:.2f}, error {100 * (pred / truth - 1):+.1f}%")
lambda = 0.7: predicted -27.06 +/- 0.52 kPa, true -28.82, error -6.1%
lambda = 0.6: predicted -43.96 +/- 0.85 kPa, true -50.57, error -13.1%
40% 应变处的预测偏低 13%,即 6.6 kPa,而置信带的半宽为 0.85 kPa:约为置信带的八倍。置信带对它所声称的内容是正确的:它说明了测量噪声会让 c_1 移动多少。但它完全没有说明模型在你外推的位置是否正确,而这里模型是不正确的,因为真实材料会变硬(\beta 项),neo-Hookean 曲线做不到。统计不确定度不是模型误差,而外推正是模型误差所在之处。
步骤 6:失配在残差中显现
现在用同一个模型拟合全部 16 个点,并观察残差的符号。正确的模型留下符号随机的残差。错误的模型留下长长的同号游程。
fit_all = fit_neo_hookean(lam, p_meas, sigma)
signs = "".join("+" if r > 0 else "-" for r in fit_all["norm_resid"])
print(f"c1 = {fit_all['c1']:.2f} +/- {fit_all['se']:.2f} kPa   "
      f"chi2_nu = {fit_all['chi2_nu']:.1f}")
print("residual signs (k = 1..16):", signs)
print("largest |normalised residual|:", f"{np.max(np.abs(fit_all['norm_resid'])):.1f}")
c1 = 10.55 +/- 0.06 kPa   chi2_nu = 4.5
residual signs (k = 1..16): ++++++++++------
largest |normalised residual|: 3.8
系数移到了约 10.55,标准误差降到 0.06,所以估计看起来更精确了;而 \chi^2_\nu = 4.5 离 1 很远,符号分成两个游程,十个为一种符号,六个为另一种。在 15 个自由度下,\chi^2_\nu 的 95% 上限约为 1.7,所以这个拟合被拒绝。变小的标准误差并不令人放心:同类数据越多,错误模型的统计误差就越小,却并不会更接近真值。
步骤 7:用非线性最小二乘拟合 Gent 模型
P_\text{Gent} 对 c_1 是线性的,对 \beta 则不是,所以没有闭式解。对加权残差使用 least_squares,从 (5, 0) 出发,边界为 c_1 \ge 0 和 0 \le \beta < 1/\max(I_1 - 3)(超过这个边界,分母会在数据范围内变为零),并设置 x_scale="jac",使量级不同的参数得到均衡的对待。
不确定度是问题在解处的线性化:设 \mathbf{J} 为加权残差对参数的雅可比矩阵,则 \operatorname{Cov}(\hat\theta) \approx (\mathbf{J}^\top\mathbf{J})^{-1}。这与闭式解中的公式相同,只是用 \mathbf{J} 代替了设计矩阵。我们拟合全范围和 20% 范围,并用蒙特卡洛检验标准误差。
def fit_gent(lam, p, sigma):
    check_inputs(lam, p, sigma, "compression")
    beta_max = (1.0 - 1e-6) / np.max(i1_minus_3(lam))

    def weighted_resid(theta):
        return (p - p_gent(lam, theta[0], theta[1])) / sigma

    sol = least_squares(weighted_resid, x0=[5.0, 0.0],
                        bounds=([0.0, 0.0], [np.inf, beta_max]), x_scale="jac")
    cov = np.linalg.inv(sol.jac.T @ sol.jac)
    se = np.sqrt(np.diag(cov))
    return {"theta": sol.x, "se": se, "cov": cov,
            "corr": cov[0, 1] / (se[0] * se[1]),
            "chi2_nu": 2.0 * sol.cost / (len(p) - 2)}

gent_all = fit_gent(lam, p_meas, sigma)
gent_20 = fit_gent(lam[:n_fit], p_meas[:n_fit], sigma[:n_fit])
for name, f in (("all 16 points ", gent_all), ("first 8 points", gent_20)):
    print(f"{name}: c1 = {f['theta'][0]:.2f} +/- {f['se'][0]:.2f}   "
          f"beta = {f['theta'][1]:.3f} +/- {f['se'][1]:.3f}   "
          f"corr = {f['corr']:.2f}   chi2_nu = {f['chi2_nu']:.2f}")

# Monte Carlo check of the linearised standard errors, full range
rng = np.random.default_rng(3)
curve = p_gent(lam, *gent_all["theta"])
draws = np.array([fit_gent(lam, curve + sigma * rng.normal(size=16), sigma)["theta"]
                  for _ in range(300)])
print(f"Monte Carlo SDs (300 refits): c1 {draws[:, 0].std(ddof=1):.3f}, "
      f"beta {draws[:, 1].std(ddof=1):.3f}")
all 16 points : c1 = 9.95 +/- 0.10   beta = 0.208 +/- 0.024   corr = -0.78   chi2_nu = 0.40
first 8 points: c1 = 9.95 +/- 0.18   beta = 0.208 +/- 0.210   corr = -0.83   chi2_nu = 0.67
Monte Carlo SDs (300 refits): c1 0.099, beta 0.025
在全部 16 个点上,Gent 拟合恢复出了两个参数(c_1 \approx 9.95,\beta \approx 0.21;真值为 10 和 0.2),\chi^2_\nu = 0.40,这是一个好的拟合,甚至比噪声所允许的还略好一些:在 14 个自由度下,正确模型出现这样低的 \chi^2_\nu 的概率约为 2.5%。应把它看作一个种子带来的偶然抽样,而不是方法的性质。线性化的标准误差与蒙特卡洛的结果一致。
两个参数强烈负相关,约为 -0.78:较大的 \beta 会使曲线在大应变处变硬,而较小的 c_1 在小应变处进行补偿。只拟合前 8 个点时,\beta 为 0.21 \pm 0.21:与真值相符,也与零相符。始终没有达到 \beta 起作用的应变的数据,无法确定它,而且相关性更高(约 -0.83)。
步骤 8:加载方向是模型的一部分
比模型形式错误更隐蔽的错误,是对实验的误读。假设压缩试验被当作拉伸试验录入:\lambda = 1 + \text{strain},应力取 |P|。对于声明为拉伸的情形,检查可以通过,模型也会拟合出一个系数。
strain = 1.0 - lam
tension_20 = fit_neo_hookean(1.0 + strain[:8], np.abs(p_meas[:8]), sigma[:8],
                             direction="tension")
tension_5 = fit_neo_hookean(1.0 + strain[:2], np.abs(p_meas[:2]), sigma[:2],
                            direction="tension")
correct_5 = fit_neo_hookean(lam[:2], p_meas[:2], sigma[:2])
print(f"20% strain: tension reading c1 = {tension_20['c1']:.2f} kPa "
      f"({100 * (tension_20['c1'] / fit20['c1'] - 1):+.1f}%), "
      f"chi2_nu = {tension_20['chi2_nu']:.1f}")
print(f" 5% strain: tension reading c1 = {tension_5['c1']:.2f} kPa "
      f"({100 * (tension_5['c1'] / correct_5['c1'] - 1):+.1f}%), "
      f"chi2_nu = {tension_5['chi2_nu']:.2f}")
20% strain: tension reading c1 = 12.97 kPa (+28.5%), chi2_nu = 20.7
 5% strain: tension reading c1 = 10.60 kPa (+8.7%), chi2_nu = 0.38
在 20% 应变范围内,误读后的拟合给出 c_1 = 12.97 kPa,偏高 28.5%,而 \chi^2_\nu = 20.7 发出了问题的警报。只看前 5%(两个点)时,误读后的拟合很干净(\chi^2_\nu = 0.38),却仍然偏高 8.7%。在小应变下,g(1-\epsilon) \approx -3\epsilon - 3\epsilon^2 与 g(1+\epsilon) \approx 3\epsilon - 3\epsilon^2 在一阶上大小相同,只在二阶上有差别,而噪声把这一差别掩盖了。当数据无法区分差别时,错误的模型也可以拟合得很好,好的 \chi^2_\nu 并不能证明模型是正确的。
步骤 9:绘图
三幅图,是本实验对第 12 节中图 1.16 至 1.18 的复现。第一幅:带误差棒的数据、20% 范围的 neo-Hookean 拟合及其带 95% 置信带的外推,以及 Gent 拟合。
fine = np.linspace(0.6, 0.99, 200)
c1_hat, se_c1 = fit20["c1"], fit20["se"]
band = 1.96 * 2.0 * np.abs(g(fine)) * se_c1
fig, ax = plt.subplots(figsize=(7, 4.5))
ax.errorbar(1 - lam, p_meas, yerr=sigma, fmt="o", ms=4, capsize=2, color="k",
            label="measured, $\\pm\\sigma_i$")
ax.plot(1 - fine, p_neo_hookean(fine, c1_hat), color="tab:red",
        label="neo-Hookean fitted to strains up to 20%")
ax.fill_between(1 - fine, p_neo_hookean(fine, c1_hat) - band,
                p_neo_hookean(fine, c1_hat) + band, color="tab:red", alpha=0.25,
                label="95% band (noise only)")
ax.plot(1 - fine, p_gent(fine, *gent_all["theta"]), color="tab:blue",
        label="Gent fitted to all 16 points")
ax.axvline(0.2, color="grey", ls=":")
ax.set_xlabel("compressive strain $1 - \\lambda$")
ax.set_ylabel("nominal stress (kPa)")
ax.set_title("Neo-Hookean fit: clean to 20% strain, wrong beyond it")
ax.legend(fontsize=8)
plt.show()
第二幅:各个模型在全部点上的归一化残差。虚线标出 \pm 2。
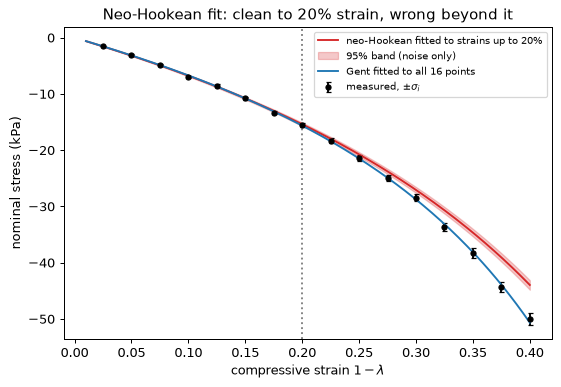
resid_nh20 = (p_meas - p_neo_hookean(lam, fit20["c1"])) / sigma
resid_nh_all = fit_all["norm_resid"]
resid_gent = (p_meas - p_gent(lam, *gent_all["theta"])) / sigma
fig, ax = plt.subplots(figsize=(7, 3.8))
ax.plot(1 - lam, resid_nh20, "o-", color="tab:red", label="neo-Hookean, fitted to 20%")
ax.plot(1 - lam, resid_nh_all, "s-", color="tab:orange",
        label="neo-Hookean, all 16 points")
ax.plot(1 - lam, resid_gent, "^-", color="tab:blue", label="Gent, all 16 points")
for level in (-2, 0, 2):
    ax.axhline(level, color="grey", ls="--" if level else "-", lw=0.8)
ax.set_xlabel("compressive strain $1 - \\lambda$")
ax.set_ylabel("normalised residual $(P_i - \\hat P_i)/\\sigma_i$")
ax.set_title("Residuals: runs of one sign reveal the wrong model")
ax.legend(fontsize=8)
plt.show()
第三幅:两个应变范围下 (c_1, \beta) 的联合 95% 置信椭圆。椭圆为 \{\theta : (\theta - \hat\theta)^\top \mathrm{Cov}^{-1} (\theta - \hat\theta) \le \chi^2_{2,\,0.95}\},通过协方差的特征分解映射单位圆来绘制。
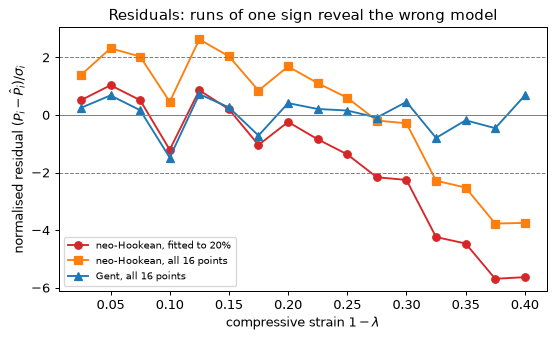
def ellipse(theta_hat, cov, level=0.95, points=200):
    vals, vecs = np.linalg.eigh(cov)
    angle = np.linspace(0, 2 * np.pi, points)
    circle = np.stack([np.cos(angle), np.sin(angle)])
    radius = np.sqrt(chi2.ppf(level, 2))
    return theta_hat[:, None] + radius * vecs @ (np.sqrt(vals)[:, None] * circle)

fig, ax = plt.subplots(figsize=(6, 4.5))
for f, label, colour in ((gent_all, "all 16 points (to 40% strain)", "tab:blue"),
                         (gent_20, "first 8 points (to 20% strain)", "tab:red")):
    xy = ellipse(f["theta"], f["cov"])
    ax.plot(xy[0], xy[1], color=colour, label=label)
    ax.plot(*f["theta"], "o", color=colour)
ax.plot(10.0, 0.2, "k*", ms=10, label="true value")
ax.set_xlabel("$c_1$ (kPa)")
ax.set_ylabel("$\\beta$")
ax.set_title("95% confidence ellipses of the Gent parameters")
ax.legend(fontsize=8)
plt.show()
你应该看到什么
- 在适用范围之内,neo-Hookean 拟合干净,精确到 1%。在范围之外,40% 应变处的预测偏低 13%,约为其自身置信带的八倍:区间度量的是噪声,而不是模型误差。
- 一旦数据到达两个模型出现差别的应变,长长的同号残差游程以及远大于 1 的 \chi^2_\nu 就会暴露错误的模型。错误模型的标准误差会随着数据增多而缩小。
- 对这个条件良好的拟合,线性化的不确定度与蒙特卡洛一致。联合拟合的参数是相关的,而没有任何数据触及的 \beta 是无法确定的:20% 范围的椭圆比全范围的大得多,并一直延伸到 \beta = 0。
- 加载方向是模型的一部分。误读它,在 20% 应变范围内会产生 28.5% 的误差,而在小范围内残差并不会暴露它。
动手试试
- 另一个模型。 拟合 Mooney–Rivlin 模型 P = 2(\lambda - \lambda^{-2})(c_1 + c_2/\lambda),它对 (c_1, c_2) 是线性的(两列的加权最小二乘),并把它向 40% 应变的外推与 Gent 的比较。\chi^2_\nu 说明了什么,外推的置信带又说明了什么?
- 实验设计。 只有 8 个点时,选择使 \beta 的标准误差最小的拉伸比(试试把八个点全部取在 [0.6, 0.8] 内,与均匀间隔的设计比较),然后重新计算。再根据结果论证下一次试验应把点放在哪里。
- 未知噪声。 把记录的 \sigma_i 换成由残差估计的单个未知 \sigma,即 \hat\sigma^2 = \sum_i r_i^2/(n - p),并比较参数区间。什么时候这会是唯一的选择,它又让你付出什么代价?
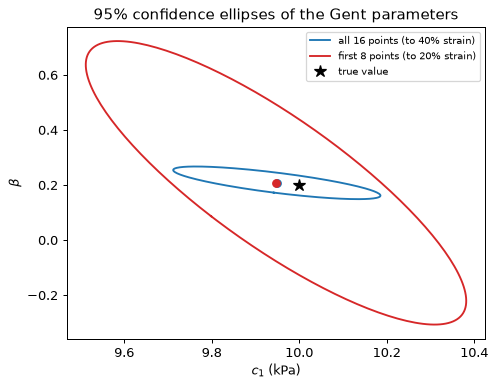
练习
共十五道练习,按所需的工作量分级。一星练习(★)是概念题,约需五分钟:用几句话口头作答即可。二星练习(★★)是推导或计算题,需十到二十分钟,在纸上配合计算器完成。唯一的三星练习(★★★)是一个约 25 分钟的编程小项目。总计 130 分钟。学习计划把每道练习安排在它所检验的阅读内容之后,这样任何一段阅读都不会长时间没有练习可做。
请在打开解答之前先做完每一道练习。解答默认折叠,打开后应当完整阅读:它们给出每一步,说明为什么这样做,并给出数值,每个数值都经过计算和核对。如果你的答案与解答不同,请先找出两者最早分歧的那一行,再往下读。方法正确而数值错误,通常只是笔误;数值正确但方法不同,则值得与解答的方法对照,因为差异往往揭示了某个假设。
五个要素。 针对下面两种情形,写出第 1 节中的五个要素(数据、模型、损失、优化器、评估):
(a) 在电子表格中对应变片标定数据拟合的线性趋势线,横轴为施加的应变,纵轴为应变片电压;
(b) 一个 k 近邻分类器(k = 5),根据 20 个测得的特征把焊缝射线底片判为合格或缺陷。
对于 (b),哪个要素是退化的?这意味着它的误差来自哪里?
查看解答
(a) 趋势线。
- 数据。 来自一次标定实验的(施加应变,应变片电压)数据对,抽自分布 P,也就是标定装置中的应变片。应变片在服役中遇到的温度、应变范围和引线长度属于另一个分布,标定对此毫无说明。
- 模型。 一条直线,\text{电压} = a + b\cdot\text{应变},两个参数。标定结果要反过来用,即把测得的电压换算成应变,所以使用时要对拟合直线求逆。施加的应变由试验台设定,比电压准确得多,因此电压作为纵轴变量:损失把纵轴变量视为含噪声的那一个。
- 损失。 平方误差。如果电压噪声近似为高斯分布,且在各应变水平下幅度相同,这就是正确的选择(第 5 节)。
- 优化器。 闭式解,即正规方程(第 2 节)。电子表格替你求解。
- 评估。 在未参与拟合的检验点上看残差,或做第二次标定实验。电子表格给出的 R^2 是在拟合所用的点上算出的:它是训练分数。两个参数的直线不会严重过拟合,但六个参数的趋势线可以让它凭空变高。
(b) k-NN 分类器。
- 数据。 过往检测的带标签射线底片。P 是这一工艺生产的这类焊缝,所以分类器的好坏取决于存储的样本对明天的焊缝有多典型。
- 模型。 在 20 维特征空间中,取距新焊缝最近的五个已存样本的多数标签。它的“参数”就是存储的数据本身,外加超参数 k 和距离度量(包括各特征如何缩放)。
- 损失。 0–1 损失,仅用于在验证数据上比较不同的 k 和缩放方式。训练过程中没有任何东西被最小化。
- 优化器。 没有。“训练”就是存储数据,所以这就是退化的要素。
- 评估。 留出的焊缝,按焊缝或按生产批次划分;如果一条焊缝有多张底片,绝不能按底片划分。
优化器退化意味着什么。 没有优化,就不会出现收敛失败导致的误差,也没有训练曲线可查。一切都押在数据和距离度量上。误差来自:存储样本缺乏代表性;与缺陷无关的特征在距离中却同等计数;特征尺度不一;以及 20 维空间中“近”几乎没有意义(第 11 节)。第二个后果是训练误差毫无用处:当 k = 1 时,每个存储点都是它自己的最近邻,训练误差按构造为零;k = 5 时也几乎为零。只有留出数据才能告诉你真相。
类别输入的编码。 一个线性模型根据材料牌号预测抗拉强度,牌号取自 {钢, 铝, 钛}。
(a) 把牌号编码为 1、2、3,隐含了什么假设?
(b) 你把牌号独热编码为三列,并保留全 1 的截距列。证明 \mathbf{X}^\top\mathbf{X} 是奇异的,并说明拟合权重和预测会怎样。
(c) 给出两种修正办法。
查看解答
(a) 单独一列取值 1、2、3,给牌号分配一个权重 w,所以编码每加一,模型的预测就加 w,无论从哪个牌号起算。这假设了一种顺序(钢 < 铝 < 钛)和等间距:铝的效应必须恰好落在钢与钛的效应正中间。关于这三种材料的任何事实都不支持这两点。无论数据怎么说,穿过各编码的直线对中间牌号的预测,总是另外两个牌号预测的平均值。如果真实强度分别是 400、300 和 900 MPa,对中间牌号的这个预测就会错得很厉害。
(b) 独热设计矩阵的每一行,在截距列取 1,并在三个牌号列中恰有一个 1,所以每一行中三个牌号列之和等于截距列。取 \mathbf{v} = (-1, 1, 1, 1),对应(截距,钢,铝,钛)。则 \mathbf{X}\mathbf{v} 的每一行都是 -1 + 1 = 0,于是 \mathbf{X}\mathbf{v} = \mathbf{0},因此 \mathbf{X}^\top\mathbf{X}\mathbf{v} = \mathbf{X}^\top\mathbf{0} = \mathbf{0}。被矩阵映为零的非零向量是特征值为 0 的特征向量:\mathbf{X}^\top\mathbf{X} 是奇异的,正规方程没有唯一解,(\mathbf{X}^\top\mathbf{X})^{-1} 不存在。这就是第 2 节中列相关的情形,它有个名字,叫虚拟变量陷阱(dummy-variable trap)。
这对拟合的影响是:如果 \mathbf{w} 满足正规方程,那么对任意 t,\mathbf{w} + t\mathbf{v} 也满足,因为 \mathbf{X}(\mathbf{w} + t\mathbf{v}) = \mathbf{X}\mathbf{w}。把截距加 t、同时把三个牌号权重都减 t,什么都不会改变。所以权重是不可识别的:只要其余权重相应补偿,其中任何一个都可以取任意值,像“钛增加 493 MPa”这样的说法单独看没有意义。预测则是可识别的,因为预测是 \mathbf{y} 在列空间上的正交投影,与你选择该空间的哪一组基无关;这里每个牌号的预测就是该牌号试样的平均强度。库函数各有处理奇异性的办法:np.linalg.lstsq 返回范数最小的解。
用 12 个合成试样(每个牌号四个)做一次数值验证:
import numpy as np

rng = np.random.default_rng(0)
grade = np.repeat([0, 1, 2], 4)                      # 4 specimens per grade
strength = np.array([400.0, 300.0, 900.0])[grade] + rng.normal(0, 10, 12)  # MPa

X = np.column_stack([np.ones(12), np.eye(3)[grade]])   # intercept + one-hot grade
print("columns:", X.shape[1], " rank:", np.linalg.matrix_rank(X))
print("eigenvalues of X^T X:", np.round(np.linalg.eigvalsh(X.T @ X), 2))

v = np.array([-1.0, 1.0, 1.0, 1.0])
print("largest entry of X v:", np.abs(X @ v).max())

w_min = np.linalg.lstsq(X, strength, rcond=None)[0]    # minimum-norm solution
w_shift = w_min + 50 * v                               # another exact solution
print("same predictions:", np.allclose(X @ w_min, X @ w_shift))
print("weights, minimum norm:", np.round(w_min, 1))
print("weights, shifted     :", np.round(w_shift, 1))

X_ref = X[:, [0, 2, 3]]                                # drop the steel column
w_ref = np.linalg.lstsq(X_ref, strength, rcond=None)[0]
print("reference coding:", np.round(w_ref, 1), " same predictions:",
      np.allclose(X_ref @ w_ref, X @ w_min))
columns: 4  rank: 3
eigenvalues of X^T X: [ 0.  4.  4. 16.]
largest entry of X v: 0.0
same predictions: True
weights, minimum norm: [400.2   1.7 -95.  493.5]
weights, shifted     : [350.2  51.7 -45.  543.5]
reference coding: [401.8 -96.7 491.8]  same predictions: True
四列但秩为 3,且 \mathbf{X}^\top\mathbf{X} 有一个特征值恰为零。两个权重向量相差 50\,\mathbf{v},却给出完全相同的预测。以钢为参照类别后,权重变得可解释:401.8 是钢的平均强度,另外两个是相对钢的差值(铝为 -96.7,钛为 +491.8)。
(c) 两种修正办法,含义不同:
- 消除冗余。 去掉一个牌号列并保留截距(参照类别:截距是该牌号的均值,其余每个权重是相对它的差值),或者去掉截距并保留全部三列(每个权重就是该牌号的均值)。两种情况下预测完全相同,矩阵也是列满秩的。
- 正则化。 岭惩罚把 \mathbf{X}^\top\mathbf{X} 换成 \mathbf{X}^\top\mathbf{X} + \lambda N\mathbf{I},其特征值至少为 \lambda N > 0,所以方程组有唯一解(练习 8)。在拟合效果同样好的权重向量中,惩罚选出范数最小的那个,也就决定了共同的常数如何在截距与牌号权重之间分配。这是一种建模选择,并非中性,而且它还会使拟合略有收缩。
由特征值求步长与步数。 一个双特征问题的最小二乘 Hessian 矩阵,特征值为 1 和 25。
(a) 最大的稳定学习率是多少?
(b) 最佳的固定学习率是多少?它给出的每步误差收缩因子是多少?
(c) 在最佳学习率下,以及在 \eta = 1/\lambda_{\max} 下,把误差降低 10^6 倍各需多少步?
(d) 标准化之后特征值为 0.8 和 1.2。重做 (b) 和 (c)。
查看解答
设定。 对 Hessian 矩阵为 \mathbf{H} 的二次函数,误差 \mathbf{e}_t = \mathbf{w}_t - \mathbf{w}^\ast 满足 \mathbf{e}_{t+1} = (\mathbf{I} - \eta\mathbf{H})\mathbf{e}_t(第 3 节)。在 \mathbf{H} 的特征基下各分量互不影响,沿特征值为 \lambda_i 的特征向量的分量,每一步都乘以 1 - \eta\lambda_i。整体误差的收缩速度取决于其最慢的分量,所以每步的收缩因子为 \rho(\eta) = \max_i |1 - \eta\lambda_i|。
(a) 稳定性。 每个分量都必须收缩,所以对每个 i 都有 |1 - \eta\lambda_i| < 1。对正的 \lambda_i,这意味着 0 < \eta < 2/\lambda_i,而当 \eta < 2/\lambda_{\max} 时它们全部成立:
恰好为 0.08 时,快分量每步乘以 1 - 0.08 \cdot 25 = -1:它翻转符号,既不增大也不缩小,所以迭代永远不会收敛。
(b) 最佳固定学习率。 两项相互竞争:|1 - \eta\lambda_{\min}| 随 \eta 增大而下降(慢方向希望步子大),而一旦 \eta 超过 1/\lambda_{\max},快方向就要承受 |1 - \eta\lambda_{\max}|(它会冲过头,因子为负)。最佳的 \eta 在两者大小相等、符号相反之处:
于是 \rho = 1 - \eta^\ast\lambda_{\min} = 1 - 0.0769 = 0.9231,一般地有
现在两个分量的收缩因子大小相同:慢分量为 +0.9231,快分量为 1 - 0.0769\cdot 25 = -0.9231。
(c) 步数。 要把误差降低 10^6 倍,需要 \rho^t \le 10^{-6},即 t \ge \ln 10^6/(-\ln\rho)。其中 \ln 10^6 = 13.816:
- 在最佳学习率下,-\ln 0.9231 = 0.0800,所以 t \ge 13.816/0.0800 = 172.6:173 步。
- 在 \eta = 1/\lambda_{\max} = 0.04 下,慢分量的因子是 1 - 0.04\cdot 1 = 0.96,快分量的因子是 1 - 0.04 \cdot 25 = 0。由慢分量决定:-\ln 0.96 = 0.0408,所以 t \ge 13.816/0.0408 = 338.4:339 步。
最佳学习率使步数大约减半,办法是放弃快方向的瞬间收敛,换取更快的慢方向。两者都逃不出步数与 \kappa 同阶这一事实:当 \kappa 很大时,-\ln\rho = \ln\frac{\kappa+1}{\kappa-1} \approx 2/\kappa,所以 t \approx (\kappa/2)\ln 10^6(这里为 12.5 \times 13.8 = 173)。对两个分量做一次直接模拟,可以确认 173 和 339。
(d) 标准化之后。 现在 \kappa = 1.2/0.8 = 1.5。
- \eta^\ast = 2/(0.8 + 1.2) = 1.0。
- 两个因子分别为 1 - 1.0\cdot 0.8 = +0.2 和 1 - 1.0\cdot 1.2 = -0.2,所以 \rho = 0.2,与 (\kappa - 1)/(\kappa + 1) = 0.5/2.5 = 0.2 一致。
- t \ge 13.816/(-\ln 0.2) = 13.816/1.609 = 8.58:9 步。
标准化使步数从 173 降到 9,约少了二十倍,既没有更换方法,也没有改变模型能表示的内容。这就是为什么对特征做中心化和缩放,是最廉价的优化改进。
交叉熵与经过 sigmoid 的平方误差。
(a) 证明二元交叉熵对 logit z 的梯度为 \hat p - y,其中 \hat p = \sigma(z)。
(b) 计算 \tfrac12(\sigma(z) - y)^2 对 z 的梯度。
(c) 对一个自信但错误的预测(\hat p = 0.999,y = 0)和一个自信且正确的预测(\hat p = 0.001,y = 0),分别求两者的值。
(d) 这些数字对学习意味着什么?
查看解答
(a) 单个样本的损失为 \ell = -y\ln\sigma(z) - (1-y)\ln(1-\sigma(z))。sigmoid 的导数为 \sigma'(z) = \sigma(z)(1 - \sigma(z))(对 1/(1 + e^{-z}) 求导并化简)。由链式法则,
sigmoid 带来的因子 \sigma(1 - \sigma) 抵消了对数带来的分母。这种抵消就是交叉熵与 sigmoid 总是搭配使用的原因。
(b) 记 \ell_2 = \tfrac12(\sigma(z) - y)^2。则
没有任何东西被抵消:sigmoid 的导数作为额外因子留了下来。
(c) 数值。 当 y = 0 时,两个梯度分别为 \hat p 和 \hat p\cdot\hat p(1 - \hat p) = \hat p^2(1-\hat p)。
| 交叉熵梯度 | 平方误差梯度 | |
|---|---|---|
| 自信但错误,\hat p = 0.999 | 0.999 | 0.999^2 \times 0.001 = 0.000998 |
| 自信且正确,\hat p = 0.001 | 0.001 | 0.001^2 \times 0.999 = 9.99\times10^{-7} |
两行中的比值都是 1/(\hat p(1 - \hat p))(在 \hat p = 0.999 或 0.001 处),即 1/(0.999 \times 0.001) = 1001:交叉熵梯度约为平方误差梯度的 1,001 倍。
(d) 含义。 梯度步使 logit 的移动量与梯度成正比。交叉熵的梯度 \hat p - y 就是预测误差本身:模型自信地出错时它接近 1,随模型改进而平滑地减小,模型正确时接近 0。平方误差的梯度多带一个因子 \hat p(1 - \hat p),它在两个极端都接近零,因为 sigmoid 在那里是平的(它饱和了)。所以错得最厉害的模型,对负样本来说其 logit 约为 z = \ln(0.999/0.001) = +6.9,几乎收不到任何信号:它的梯度是 0.001,学习速度比用交叉熵时慢约一千倍。平方误差梯度 \hat p^2(1-\hat p) 的最大值只有 4/27 = 0.148(在 \hat p = 2/3 处),而交叉熵梯度可达 1。
交叉熵给出的损失值也是合理的:对自信但错误的预测,-\ln 0.001 = 6.9,而平方误差给出 \tfrac12(0.999)^2 = 0.5,且永远不会超过 \tfrac12。一个分不清轻度错误与灾难性错误的损失,加上一个恰在模型最需要纠正时消失的梯度,就是分类问题用交叉熵训练的原因(第 6 节)。同样的抵消,即 \hat{\mathbf{p}} - \mathbf{y},对 softmax 也成立,因此对语言模型的输出层同样成立。
报警意味着什么。 一个裂纹检测器的召回率为 0.90,假阳性率为 0.03,被检零件中有 2% 存在裂纹。
(a) 被标记的零件中,真有裂纹的占多大比例?每出现一次真报警,伴随多少次误报警?
(b) 证明在给定报警的条件下,有裂纹的几率等于先验几率乘以 TPR/FPR,并据此求出使一半报警为真的裂纹发生率。
(c) 每个被标记的零件都送去做第二次检测,其召回率和假阳性率相同,且在给定真实状态时,其错误与第一次的错误相互独立。两次都被标记的零件中,有裂纹的占多大比例?两阶段合起来的召回率是多少?第二阶段要检测全部零件的多大比例?
(d) 供应商的宣传册上的哪些数字会掩盖 (a) 的答案?
查看解答
(a) 以占全部零件的比例来计算。设 \pi = 0.02 为发生率,TPR = 0.90 为召回率,FPR = 0.03。
- 被标记的有裂纹零件:\text{TPR}\cdot\pi = 0.90 \times 0.02 = 0.0180,占全部零件。
- 被标记的合格零件:\text{FPR}\cdot(1-\pi) = 0.03 \times 0.98 = 0.0294,占全部零件。
- 全部被标记的:0.0180 + 0.0294 = 0.0474。
精确率是被标记零件中有裂纹的比例:
十次报警中真报警不到四次。每次真报警对应的误报警次数:0.0294/0.0180 = 1.63。
(b) 由贝叶斯公式,
两个概率有共同的分母 P(\text{报警}),它在比值中约去。所以后验几率等于先验几率乘以似然比(likelihood ratio)TPR/FPR,这里为 0.90/0.03 = 30。用 (a) 检验:先验几率 0.02/0.98 = 0.0204,乘以 30 得 0.612,几率 0.612 对应的概率为 0.612/1.612 = 0.380。吻合。
当后验几率为 1 时,一半的报警为真,所以 \pi/(1-\pi) = \text{FPR}/\text{TPR},由此得
在发生率为 2% 时报警大多为假的检测器,在 3.2% 及以上时则大多为真:同一个分类器,召回率和假阳性率都不变,在不同的总体中就是不同的工具(第 7 节,基础率)。
(c) 第二阶段只看到第一阶段标记过的零件,所以它面对的先验几率就是第一阶段的后验几率 0.612。由于在给定真实状态时两次错误相互独立,它的报警再次把几率乘以似然比:
也可以直接计算:有裂纹且两次被标记 0.90^2\times 0.02 = 0.0162;合格但两次被标记 0.03^2\times 0.98 = 0.000882;比值 0.0162/(0.0162 + 0.000882) = 0.948。
- 两阶段合起来的召回率: 裂纹必须被两次都检出,所以为 0.90 \times 0.90 = 0.81。第二阶段使召回率损失 9 个百分点(0.90 降到 0.81),换来精确率从 0.38 提升到 0.95;每次真报警对应的误报警次数从 1.63 降到 0.000882/0.0162 = 0.054。
- 第二阶段检测的零件: 第一阶段标记的那些,即全部零件的 4.74%。
独立性假设是乐观的,且两个方向都是如此。如果两次检测漏掉的是同样的隐蔽裂纹,那么第一阶段标记出来的是容易发现的裂纹,第二阶段检出它们的概率高于 0.90,所以真实的合并召回率高于 0.81。如果两次检测在同样难判但完好的零件上误报,第二阶段剔除的误报就比 30 倍这个因子所暗示的少,真实的精确率低于 0.948。依靠这些乘积之前,先在真实数据上测量相关性。
(d) 有两个数字会掩盖它。准确率:0.0180 + 0.97\times0.98 = 0.9686,听上去极好,却低于一个从不报警的“检测器”所达到的 0.98。准确率被 98% 被正确放行的合格零件所主导。ROC AUC,以及任何以 TPR 和 FPR 为坐标画出的曲线,因为二者都与发生率无关:宣传册若只报告这些,就完全没说明在你的总体中会有多少报警是假的。在平衡测试集(一半有裂纹)上做基准测试的宣传册,还会给这同一个检测器标出精确率 0.90/0.93 = 0.97。能说明 (a) 的是在部署时发生率下的精确率,或者在真实裂纹与合格零件混合比例的数据上算出的精确率-召回率曲线。
数对子求 AUC。 六个测试零件得到分数。缺陷件:0.9、0.7、0.4。合格件:0.8、0.3、0.2。
(a) 通过数对子计算 AUC。
(b) 把阈值向下扫描,列出 ROC 曲线上的(FPR,TPR)点;验证阶梯下方的面积等于 (a)。
(c) 在阈值 0.5 处,给出精确率和召回率。
(d) 哪一个分数的单独改动可以使 AUC 升到 1?
查看解答
(a) 数对子。 AUC 是随机选取的一个缺陷件得分高于随机选取的一个合格件的概率(平局算一半;此处没有平局)。缺陷-合格的对子共有 3 \times 3 = 9 个。对每个缺陷件,数出它得分高于的合格件:
- 0.9 胜过 0.8、0.3 和 0.2:3 对。
- 0.7 胜过 0.3 和 0.2,但不胜过 0.8:2 对。
- 0.4 胜过 0.3 和 0.2,但不胜过 0.8:2 对。
(b) ROC 曲线。 让阈值按得分从高到低依次下降。阈值标记所有得分不低于它的零件。每经过一个缺陷件,TPR 增加 1/3;每经过一个合格件,FPR 增加 1/3。
| 阈值到达 | 零件 | FPR | TPR |
|---|---|---|---|
| (高于 0.9) | 无标记 | 0 | 0 |
| 0.9 | 缺陷 | 0 | 1/3 |
| 0.8 | 合格 | 1/3 | 1/3 |
| 0.7 | 缺陷 | 1/3 | 2/3 |
| 0.4 | 缺陷 | 1/3 | 1 |
| 0.3 | 合格 | 2/3 | 1 |
| 0.2 | 合格 | 1 | 1 |
阶梯下方的面积,按竖直条带计算:FPR 从 0 到 1/3 时高度为 1/3,面积 \tfrac13\cdot\tfrac13 = 1/9;FPR 从 1/3 到 1 时高度为 1,面积 \tfrac23\cdot 1 = 6/9。总计 7/9,与 (a) 一致。(两种算法是同一个和的不同排列:按缺陷件数对子,或按合格件数对子。)用 sklearn.metrics.roc_auc_score 做机器核对,返回 0.7778。
(c) 阈值 0.5。 得分不低于 0.5 的零件是 0.9(缺陷)、0.8(合格)和 0.7(缺陷)。所以 TP = 2,FP = 1;得分 0.4 的缺陷件被漏掉,FN = 1;TN = 2。
(d) 一处改动。 AUC 为 1 意味着每个缺陷件的得分都高于每个合格件,所以三个得分 0.9, 0.7, 0.4 必须全都高于三个合格件的得分。唯一的障碍是得分 0.8 的合格件,它胜过缺陷件 0.7 和 0.4。把它降到 0.4 以下,例如 0.35,就得到 AUC 为 1。单独提高缺陷件 0.4 行不通:把它升到 0.95 只修复一个对子,缺陷件 0.7 仍低于合格件 0.8,AUC 只变为 8/9。(把 0.7 和 0.4 都提到 0.8 以上同样可行,但那是两处改动。)这道题表明 AUC 度量的是什么:它描述的是得分的排序,一个得分错误的合格件就会损失九个对子中的两个。
一维收缩。 你用 n 个方差为 \sigma^2 的独立读数估计均值 \mu,使用收缩估计量 \hat\mu_c = c\,\bar y,其中 0 \le c \le 1。
(a) 推导它的偏差^2、方差和均方误差。
(b) 求使 MSE 最小的 c。
(c) 取 \sigma = 3、n = 9。分别对 \mu = 2 和 \mu = 0.5 求 c^\ast 及其 MSE,并与 \bar y 的 MSE 比较。
(d) 为什么实践中不能直接使用 c^\ast?计算当使用 \mu = 0.5 对应的 c^\ast、而 \mu 实际为 2 时的 MSE,并说明这与用交叉验证选取 \lambda 有何关系。
查看解答
(a) 样本均值 \bar y 满足 \mathbb{E}[\bar y] = \mu 和 \operatorname{Var}(\bar y) = \sigma^2/n(n 个独立读数的平均值的方差)。乘以常数 c:
- \mathbb{E}[\hat\mu_c] = c\mu,所以偏差为 c\mu - \mu = -(1-c)\mu,且 \text{偏差}^2 = (1-c)^2\mu^2。
- \operatorname{Var}(\hat\mu_c) = c^2\sigma^2/n。
均方误差是两者之和(交叉项消失,与第 8 节相同):
(b) 记 v = \sigma^2/n。对 c 求导并令导数为零:
二阶导数 2\mu^2 + 2v 为正,所以这是极小值;且 c^\ast 位于 0 与 1 之间,约束不起作用。代入 1 - c^\ast = v/(\mu^2 + v),
由于 c^\ast < 1,这低于 v = \text{MSE}(1),即无偏估计 \bar y 的 MSE:一定程度的偏差总是值得的,最佳的 c 如同偏差-方差分解那样,在偏差与方差之间折中。(这个收缩因子与练习 8 中岭回归的因子 s^2/(s^2 + \lambda N) 形式相同。若如第 9 节那样给 \mu 一个方差为 \tau^2 的高斯先验,则后验均值为 \tau^2/(\tau^2 + v)\,\bar y,形式相同,只是用 \tau^2 取代了未知的 \mu^2。)
(c) 数值。 这里 v = \sigma^2/n = 9/9 = 1,所以无论 \mu 为何,\bar y 的 MSE 都是 1.0。
- \mu = 2:c^\ast = 4/(4 + 1) = 0.8。偏差^2 = (0.2)^2\cdot 4 = 0.16,方差 0.8^2\cdot 1 = 0.64,MSE = 0.80 = c^\ast v。降低 20%。
- \mu = 0.5:c^\ast = 0.25/(0.25 + 1) = 0.2。偏差^2 = 0.8^2 \cdot 0.25 = 0.16,方差 0.2^2\cdot 1 = 0.04,MSE = 0.20。降低 80%。
信号相对噪声较小时,收缩的帮助最大,因为此时无偏估计主要是噪声,丢弃其中一部分代价很小。(用 10^6 个样本做模拟,得到 0.800 和 0.200。)
(d) 问题所在。 c^\ast 依赖于 \mu,也就是正要估计的那个量。假设你相信 \mu = 0.5,于是用 c = 0.2 收缩,但 \mu 实际为 2:
是普通均值 \bar y 的 MSE(1.0)的两倍半。没有证据支持、或基于错误信念选取的收缩,可能造成实实在在的伤害:偏差项随与真值距离的平方增长,公式里没有任何东西向你示警。
补救办法是从数据中选取收缩的程度,即在留出数据上直接估计误差,这正是验证和交叉验证所做的事。在岭回归中,更大的强度 \lambda 对应更小的 c:由交叉验证选出的 \lambda 是对不可知的 c^\ast 的一个估计,实验 3 展示了在含噪数据上的岭路径及其最小值。这个估计本身也有噪声,但与上面那种猜测不同,它是以数据为依据的。
正规方程与岭回归。
(a) 由 \mathcal{L}(\mathbf{w}) = \tfrac1N\|\mathbf{X}\mathbf{w} - \mathbf{y}\|^2 的梯度推导正规方程。
(b) 加上岭惩罚 \lambda\|\mathbf{w}\|^2,证明方程组变为 (\mathbf{X}^\top\mathbf{X} + \lambda N\mathbf{I})\mathbf{w} = \mathbf{X}^\top\mathbf{y}。
(c) 利用 \mathbf{X}^\top\mathbf{X} 的特征值,解释为什么对每个 \lambda > 0 这个方程组都可解,即使 \mathbf{X} 的行数少于列数。
(d) 若 \mathbf{X}^\top\mathbf{X} 的特征值为 50 和 0.5,且 \lambda N = 5,给出各方向的收缩因子 s^2/(s^2 + \lambda N),以及收缩前后的条件数。
查看解答
(a) 展开平方范数:\|\mathbf{X}\mathbf{w} - \mathbf{y}\|^2 = \mathbf{w}^\top\mathbf{X}^\top\mathbf{X}\mathbf{w} - 2\mathbf{w}^\top\mathbf{X}^\top\mathbf{y} + \mathbf{y}^\top\mathbf{y}。对称矩阵 \mathbf{A} 的二次型 \mathbf{w}^\top\mathbf{A}\mathbf{w} 的梯度为 2\mathbf{A}\mathbf{w},\mathbf{w}^\top\mathbf{b} 的梯度为 \mathbf{b},最后一项与 \mathbf{w} 无关,所以
在极小值处梯度为零:\mathbf{X}^\top\mathbf{X}\mathbf{w} = \mathbf{X}^\top\mathbf{y}。这就是正规方程。(Hessian 矩阵为 \tfrac2N\mathbf{X}^\top\mathbf{X},半正定,所以损失是凸的,梯度为零的点就是全局最小值。)
(b) 带惩罚的损失为 \mathcal{L}(\mathbf{w}) + \lambda\|\mathbf{w}\|^2,且 \nabla_{\mathbf{w}}\lambda\|\mathbf{w}\|^2 = 2\lambda\mathbf{w}。令总梯度为零:
两边乘以 N/2:\mathbf{X}^\top\mathbf{X}\mathbf{w} - \mathbf{X}^\top\mathbf{y} + \lambda N\mathbf{w} = \mathbf{0},整理得
因子 N 的出现,是因为 \mathcal{L} 是平均损失,而惩罚项未经缩放就加了上去;如果损失写成求和形式,则得到的是 \lambda\mathbf{I}。
(c) \mathbf{X}^\top\mathbf{X} 是对称的,所以它有实特征值 s_i^2 和正交的特征向量 \mathbf{v}_i,并且每个特征值都非负:s_i^2 = \mathbf{v}_i^\top \mathbf{X}^\top\mathbf{X}\mathbf{v}_i = \|\mathbf{X}\mathbf{v}_i\|^2 \ge 0(对单位特征向量)。加上 \lambda N\mathbf{I} 使每个特征值都加 \lambda N,而特征向量保持不变,所以岭矩阵的特征值为 s_i^2 + \lambda N \ge \lambda N > 0。特征值全为正的对称矩阵是可逆的,所以对每个 \lambda > 0,方程组恰有一个解。
即使 \mathbf{X} 的行数少于列数(N < d + 1)或存在相关列(练习 2),这一结论也成立。此时 \mathbf{X}^\top\mathbf{X} 的秩至多为 N,所以至少有 d + 1 - N 个特征值恰为零,未加惩罚的方程组有无穷多解。惩罚把这些零提升为 \lambda N,并在所有拟合效果同样好的权重向量中,选出范数最小的那个。
(d) 一个具体例子。 在特征基下,岭回归把最小二乘解沿各方向的分量乘以 s^2/(s^2 + \lambda N)。(推导:在 \mathbf{v}_i 构成的基下,方程组解耦为 (s_i^2 + \lambda N)\,\tilde w_i = s_i^2\,\tilde w_i^{\text{LS}},因为只要最小二乘解存在,就有 \mathbf{X}^\top\mathbf{y} = \mathbf{X}^\top\mathbf{X}\mathbf{w}^{\text{LS}}。)取 \lambda N = 5:
- s^2 = 50 的方向:50/55 = 0.909;
- s^2 = 0.5 的方向:0.5/5.5 = 0.091。
数据把权重定得很紧的、确定得好的方向,保留其最小二乘值的 91%。确定得差的方向,即数据几乎没有约束的方向,只保留 9%:岭回归去掉了数据无法支持的大部分,而很少去掉数据能够支持的部分。条件数从 50/0.5 = 100 降到 (50 + 5)/(0.5 + 5) = 55/5.5 = 10,所以在岭损失上做梯度下降,按练习 3 的意义也大约快十倍收敛。
找出泄漏。 对下面每种设置,说明是否存在泄漏,属于哪一类,以及如何修正。
(a) 用整个数据集的列均值填补缺失值,然后做 5 折交叉验证。
(b) 12 台泵的振动频谱,每台 500 条,按 80/20 随机划分。
(c) 预测次日故障,使用的特征包括“距上次维护的小时数”,该特征是在故障当天结束时记录的。
(d) 因为验证集“太小”,就在测试集上调参。
查看解答
(a) 预处理泄漏,通常较轻微。 列均值包含了每一折用作验证的那些行的取值,所以关于留出行的一点信息通过输入进入了模型。对于由许多行平均得到的均值,影响很小,这正是这种泄漏常常不被察觉的原因;而对于更依赖个别行的统计量(目标编码、按与标签的相关性做特征选择、在全部数据上拟合的 PCA),影响可能很大。修正: 把填补器放进 Pipeline,让交叉验证只在每个训练折上拟合它:make_pipeline(SimpleImputer(strategy="mean"), model)。规则是:任何带有 fit 步骤的东西都是模型的一部分。
(b) 分组泄漏。 随机划分把同一台泵的频谱分在两边,而同一台泵的频谱彼此之间的相似度,远高于与另一台泵的频谱的相似度,所以模型可以靠识别泵而不是故障来取得高分。这个分数对模型从未见过的泵毫无说明,而实际使用时遇到的恰是这种情形。修正: 按使用时会是新对象的那个单位来划分:以泵为分组的 GroupKFold,或者完整留出两三台泵。
一个模拟可以显示这种影响有多大。十二台泵各有一个由五个特征构成的特征标记,以及一个与该标记无关的“磨损”值;用 5 近邻回归器预测磨损:
import numpy as np
from sklearn.impute import SimpleImputer
from sklearn.model_selection import GroupKFold, KFold, cross_val_score
from sklearn.neighbors import KNeighborsRegressor
from sklearn.pipeline import make_pipeline

rng = np.random.default_rng(0)
n_pumps, per_pump = 12, 500
pump = np.repeat(np.arange(n_pumps), per_pump)
signature = rng.normal(0, 3, size=(n_pumps, 5))        # each pump's own spectrum
wear = rng.normal(0, 1, n_pumps)                       # unrelated to its spectrum
X = signature[pump] + rng.normal(0, 1, size=(n_pumps * per_pump, 5))
y = wear[pump] + rng.normal(0, 0.2, n_pumps * per_pump)
X[rng.random(X.shape) < 0.05] = np.nan                 # 5% missing values

# (a) the imputer sits inside the pipeline, so each fold fits it on its training rows
model = make_pipeline(SimpleImputer(strategy="mean"), KNeighborsRegressor(5))
score = "neg_root_mean_squared_error"
rmse_random = -cross_val_score(model, X, y, cv=KFold(4, shuffle=True, random_state=0),
                               scoring=score).mean()
rmse_by_pump = -cross_val_score(model, X, y, cv=GroupKFold(4), groups=pump,
                                scoring=score).mean()
print(f"spread of y             : {y.std():.2f}")
print(f"random split, RMSE      : {rmse_random:.2f}")
print(f"split by pump, RMSE     : {rmse_by_pump:.2f}")
spread of y             : 1.12
random split, RMSE      : 0.44
split by pump, RMSE     : 1.72
随机划分报告的 RMSE 为 0.44,而 y 的离散程度为 1.12:看上去是个不错的模型。按泵划分后,RMSE 为 1.72,比直接预测均值还差,因为对于没见过的泵,模型无物可供。按构造,这里本来就没有什么可学的。(这里用 RMSE 而不用 R^2,因为 R^2 的分母会随折而变。)
(c) 目标泄漏,带有时间特征。 故障之后进行的维护会重置“距上次维护的小时数”,所以故障当天结束时记录的值编码了结果。这个特征在作出预测的时刻并不可得,使用它的模型是在预测过去。修正: 为每个特征定义它被获知的时间,并以预测时刻为准构建特征表,设置明确的截止时间。典型症状是准确率很高,但模型一上线运行就崩溃。检查模型最依赖哪个特征(并追问为什么),能发现许多这类泄漏。
(d) 测试集复用。 测试集一旦指导了某个选择(模型、超参数、阈值),它就成了验证集,其得分会乐观,乐观的程度取决于选择的幅度(第 10 节)。验证集小,是使用交叉验证的理由,而不是借用测试集的理由。修正: 在训练数据上用交叉验证调参(若要报告交叉验证分数本身,则用嵌套交叉验证),并保留或另行收集一个从未被碰过的测试集,在所有决定做完之后只打开一次。
相信 98% 之前。 一位同事报告,某个把危险源分为可控或不可控的模型,准确率为 98%。列出你在相信这个数字之前要问的五个问题,并对每个问题说明怎样的回答会让你信任这个数字。
查看解答
五个问题,每个针对高准确率可能空洞无物的一种方式:
- 类别比例是多少?多数类规则能得多少分? 如果 97% 的危险源是可控的,一个总回答“可控”的模型就能得 97%,98% 几乎没有增加什么。信任的条件: 98% 明显高于多数类基线,且基线与它一并报告。
- 混淆矩阵以及各类的精确率和召回率是什么? 准确率按各类的频率加权平均,所以它掩盖了对稀少而代价高昂的那一类是如何处理的。把危险源误判为可控,是危险的错误。信任的条件: “不可控”类的召回率和报警的精确率,对该模型所支持的决策而言是可接受的。
- 数据是怎样划分的?重复项是否已去除? 同一个危险源,或对同一系统的不同分析中它的近似副本,出现在划分的两侧,会抬高分数(练习 9)。信任的条件: 划分是按使用时会是新对象的单位(系统、项目或危险场景,而不是行)进行的,且在划分之前已经去除了完全重复和近似重复的项。
- 试过多少个模型和设置?测试集是否只打开过一次? 许多分数中的最佳者是乐观的(练习 11),而被反复查阅的测试集就是验证集。信任的条件: 所有选择都是在训练数据上或通过交叉验证做出的,测试集只评分一次,且数字是在看结果之前写下的。
- 测试用例是否来自实际使用条件?有多少个? 来自另一个行业、较旧的标注做法或去年的系统的测试集,度量的是另一个问题;而只有 100 个用例的测试集,会留下几个百分点宽的区间(第 10 节)。信任的条件: 这些用例在类型和时间上都与未来的输入相像,并且报告了区间(例如来自自助法),区间窄到足以有意义。
当标签由人来制作时,还值得问第六个问题:标注者之间的一致程度如何? 如果两位工程师对危险源的判断有 95% 一致,那么模型就无法有意义地按 98% 来评判,因为在这部分用例上,“真值”本身是错的或有争议的。
120 个中的最佳者。 你对一个梯度提升模型的 120 种配置做随机搜索,用 5 折交叉验证给每个配置评分,并报告最佳分数。
(a) 即使每个配置同样好,为什么这个分数也是乐观的?
(b) 乐观程度会随下列情况增大还是缩小:(i) 配置更多,(ii) 数据更多,(iii) 配置彼此太相像以至于分数几乎相同?各用一句话回答。
(c) 补救办法是什么?它为什么有效?
查看解答
(a) 交叉验证分数等于该配置的真实性能加上由具体的折和具体的数据带来的噪声。从 120 个中选出最佳者,就是选出噪声恰好最有利的那个配置,所以即使没有哪个配置比别的更好,最大值也会向上偏。这种偏差是选择与噪声的性质,并不需要任何配置发生过拟合(第 10 节)。
(b)
- (i) 配置更多: 乐观程度增大,但增长缓慢。n 个独立标准正态抽样的期望最大值大致按 \sqrt{2\ln n} 上升;模拟给出 10 个抽样为 1.5,120 个为 2.6,1,200 个为 3.3,单位为噪声的标准差。搜索量增加十倍所得有限,这也是随机搜索不再划算的原因。
- (ii) 数据更多: 乐观程度缩小,因为每个分数的噪声按 1/\sqrt{N} 下降,而选择偏差是该噪声的某个倍数。
- (iii) 配置几乎相同: 乐观程度缩小,因为强相关的分数表现得像更少的独立抽样,可供挑选最幸运者的空间就更小。(全部 120 个配置共用同样的折,这已经使它们的噪声相关,所以 (i) 中的数字是上界。)
(c) 在未参与选择的数据上给选定的配置评分:嵌套交叉验证(内层循环做选择,外层循环给包含选择在内的整个流程评分),或者在所有选择都已完成之后只打开一次的测试集。这样,被选中的模型是在它没有被选择过的噪声上被度量的,它的运气与该噪声无关,会被平均掉,分数就成为对该流程性能的诚实估计。嵌套交叉验证的代价是额外的拟合次数;单个测试集的代价是只能用一次。实验 4 的扩展部分展示了在纯噪声上这种影响的大小,那里每个配置都恰好只相当于随机猜测。
四十七个无用特征。 一个 k 近邻分类器(k = 5,特征已标准化)利用在约 3,000 个带标签窗口上算出的 3 个振动特征,能很好地检测轴承故障。新的数据记录仪又增加了 47 个特征,其中大多数与故障无关,交叉验证准确率因此下降,尽管并没有信息被移除。
(a) 给出两个原因,都与距离有关。
(b) 说出两种补救办法。
(c) 为什么梯度提升树集成面对同样的 47 个特征,损失要小得多?
查看解答
(a) 两个原因。
- 无关特征稀释了距离。 标准化之后,每个特征对平方距离贡献的离散程度大致相同。47 个无关特征中的每一个,在两个随机窗口之间所增加的平方距离,与一个有信息的特征一样多,所以 47 个噪声项淹没了 3 个信号项,“最近”的邻居是在毫无意义的方向上近。有信息的差异仍然存在,只是在总量中占了一小部分。
- 维数灾难。 在 50 维中,容纳固定比例数据的邻域必须跨越每个特征的大部分取值范围。容纳均匀分布数据的 1% 的立方体,边长是取值范围的 0.01^{1/d}:d = 3 时为 0.22,d = 50 时则为 0.91(第 11 节)。在 3,000 个窗口下,最近的五个邻居根本谈不上局部,并且一个点到它最近邻与最远邻的距离变得几乎相等。
(b) 两种补救办法。
- 选择或缩减特征。 通过验证来选取特征,且要在交叉验证的折内部进行,使选择不泄漏标签(实验 4);或者利用领域知识,保留物理上确实重要的特征;或者用 PCA 降维,但要记住 PCA 保留的是方差大的方向,不一定是携带故障信息的方向。
- 学习距离。 给特征加权(例如按经验证的相关性),或者使用能够学到哪些输入重要的模型,而把 k-NN 留给特征少而精的问题。
(c) 树为何应付得来。 树的每次分裂只用一个特征和一个阈值,从可用特征中选出使不纯度下降最多的那个。无关特征很少在这一选择中胜出,所以很少被用到,也没有哪一步把全部 50 个特征合并成一个距离。因此集成模型会忽略大部分噪声特征,而不是对它们求平均。它们也不是毫无代价:每次分裂有 47 个候选,噪声特征时不时会碰巧胜出,树就会拟合到一点噪声。
对这一设置(3,000 个窗口,三个均值随故障而偏移的特征,47 个与故障无关的标准正态特征)做的模拟显示了差异:
import numpy as np
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

rng = np.random.default_rng(0)
n = 3000
fault = rng.integers(0, 2, n)
# three informative features: the mean shifts when a fault is present
signal = rng.normal(size=(n, 3)) + fault[:, None] * np.array([1.2, 0.8, 1.0])
noise = rng.normal(size=(n, 47))                       # 47 unrelated features
cv = StratifiedKFold(5, shuffle=True, random_state=0)

for name, X in [("3 features ", signal), ("50 features", np.hstack([signal, noise]))]:
    knn = make_pipeline(StandardScaler(), KNeighborsClassifier(5))
    boost = HistGradientBoostingClassifier(random_state=0)
    acc_knn = cross_val_score(knn, X, fault, cv=cv).mean()
    acc_boost = cross_val_score(boost, X, fault, cv=cv).mean()
    print(f"{name}: k-NN {acc_knn:.3f}   boosting {acc_boost:.3f}")
3 features : k-NN 0.772   boosting 0.769
50 features: k-NN 0.659   boosting 0.789
k-NN 的准确率下降了 11 个百分点,从 0.77 降到 0.66;提升树则完全没有下降。(实际上,在这个模拟中以及试过的其他每个随机种子下,提升树加入噪声特征后还好了约两个百分点。本练习不解释这一点,它也不是噪声特征的好处;这里只想说明树没有下降。)
梯度提升是需要击败的基线吗? 检验“在表格数据上梯度提升是需要击败的基线”这一说法。用 5 折交叉验证,所有模型使用同样的折(KFold(5, shuffle=True, random_state=0)),比较以下模型的 RMSE:
- 预测均值(
DummyRegressor); - 岭回归(
StandardScaler+RidgeCV(alphas=np.logspace(-3, 3, 13))); - k-NN(
StandardScaler+KNeighborsRegressor(10)); - RBF 支持向量回归器(
StandardScaler+SVR(C=10)); - 随机森林(300 棵树,
random_state=0); HistGradientBoostingRegressor(random_state=0),
数据集为 (a) make_friedman1(n_samples=2000, n_features=10, noise=1.0, random_state=0) 和 (b) load_diabetes。报告各折的均值 \pm 标准差以及拟合时间。然后在每个数据集上,计算最好的两个模型的逐折 RMSE 之差,并说明这一排名是否有证据支持。
查看解答
方案。 把六个模型构建为流水线,使缩放在每一折内部拟合(基于距离的模型和岭回归需要缩放,树不在乎)。每次调用都使用同一个 KFold 对象,使每个模型都在完全相同的测试折上评分;正是这一点使逐折之差有意义。cross_validate 配合 neg_root_mean_squared_error 返回每折一个 RMSE。“最好的两个”按平均 RMSE 选出,然后要问的是:二者的差距相对于该差距的折间波动是否足够大。
import time
import numpy as np
from sklearn.datasets import make_friedman1, load_diabetes
from sklearn.dummy import DummyRegressor
from sklearn.ensemble import HistGradientBoostingRegressor, RandomForestRegressor
from sklearn.linear_model import RidgeCV
from sklearn.model_selection import KFold, cross_validate
from sklearn.neighbors import KNeighborsRegressor
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVR

models = {
    "mean": DummyRegressor(),
    "ridge": make_pipeline(StandardScaler(), RidgeCV(alphas=np.logspace(-3, 3, 13))),
    "k-NN": make_pipeline(StandardScaler(), KNeighborsRegressor(10)),
    "SVR": make_pipeline(StandardScaler(), SVR(C=10)),
    "forest": RandomForestRegressor(300, random_state=0),
    "boosting": HistGradientBoostingRegressor(random_state=0),
}
X1, y1 = make_friedman1(n_samples=2000, n_features=10, noise=1.0, random_state=0)
X2, y2 = load_diabetes(return_X_y=True)
datasets = {"Friedman #1": (X1, y1), "diabetes": (X2, y2)}
cv = KFold(5, shuffle=True, random_state=0)  # one splitter object: same folds for all

for dname, (X, y) in datasets.items():
    print(f"{dname}: {X.shape[0]} rows, {X.shape[1]} features")
    rmse = {}
    for mname, model in models.items():
        t0 = time.perf_counter()
        res = cross_validate(model, X, y, cv=cv, scoring="neg_root_mean_squared_error")
        rmse[mname] = -res["test_score"]
        secs = time.perf_counter() - t0
        print(f"  {mname:9s} RMSE {rmse[mname].mean():6.2f} +- "
              f"{rmse[mname].std(ddof=1):5.2f}   time {secs:5.1f} s")
    # The two best by mean RMSE, compared fold by fold on identical test folds.
    best = sorted(rmse, key=lambda m: rmse[m].mean())[:2]
    diff = rmse[best[1]] - rmse[best[0]]
    print(f"  {best[1]} minus {best[0]}, per fold:", np.round(diff, 2))
    print(f"  mean {diff.mean():.2f}, SD {diff.std(ddof=1):.2f}, "
          f"{best[0]} better in {(diff > 0).sum()} of 5 folds")
Friedman #1: 2000 rows, 10 features
  mean      RMSE   5.02 +-  0.09   time   0.0 s
  ridge     RMSE   2.59 +-  0.09   time   0.0 s
  k-NN      RMSE   2.52 +-  0.07   time   0.0 s
  SVR       RMSE   1.40 +-  0.05   time   0.6 s
  forest    RMSE   1.79 +-  0.07   time   5.6 s
  boosting  RMSE   1.34 +-  0.04   time   0.5 s
  SVR minus boosting, per fold: [0.09 0.09 0.03 0.01 0.07]
  mean 0.06, SD 0.04, boosting better in 5 of 5 folds
diabetes: 442 rows, 10 features
  mean      RMSE  76.93 +-  4.53   time   0.0 s
  ridge     RMSE  54.65 +-  2.19   time   0.0 s
  k-NN      RMSE  56.83 +-  2.99   time   0.0 s
  SVR       RMSE  55.63 +-  2.84   time   0.0 s
  forest    RMSE  57.78 +-  4.11   time   1.4 s
  boosting  RMSE  59.02 +-  5.50   time   0.2 s
  SVR minus ridge, per fold: [ 0.11  0.76 -1.92  4.79  1.18]
  mean 0.99, SD 2.44, ridge better in 4 of 5 folds
时间取决于机器,列出只是为了给出数量级;整个脚本的运行时间远不到一分钟。(如果 HistGradientBoostingRegressor 意外地慢,原因是在繁忙的机器上它的 OpenMP 后端发生了线程争用:把环境变量 OMP_NUM_THREADS 设为 1 或 2。)
解读 Friedman #1 的表格。 这份数据具有线性模型无法表达的结构:目标为 10\sin(\pi x_1 x_2) + 20(x_3 - 0.5)^2 + 10x_4 + 5x_5 加噪声,即一个交互项、一个二次项和两个线性项,另有五个什么作用也没有的特征。均值预测器的 5.02 设定了尺度。岭回归(2.59)和 k-NN(2.52)约达到其一半:岭回归是因为除两个线性项之外它几乎抓不到什么,k-NN 则是因为五个无关特征损害了它的距离(练习 12)。接下来依次是随机森林(1.79)、SVR(1.40)和提升(1.34)。噪声的标准差为 1.0,所以下限,即不可约误差,是约 1.0 的 RMSE;提升与它相差不到 0.34。
前两名的排名是否有证据支持? 提升在全部五折中都胜过 SVR,分别领先 0.09、0.09、0.03、0.01 和 0.07,平均 0.059,折间标准差 0.038。把这五个差值视为一个样本,均值距零 3.5 个标准误(0.059/(0.038/\sqrt5)),并且每折的符号都相同。提升优于 SVR 的排名是有证据支持的,不过差距很小:占 RMSE 的 4%。各折并不独立(每一对训练集有四分之三重叠),所以形式上的显著性被夸大了;符号的一致性才是更有说服力的证据。提升与线性模型和最近邻模型之间的差距超过 1.1 的 RMSE,不需要这样小心。随机森林远居第三,比提升高约 0.45,而折间标准差分别为 0.07(随机森林)和 0.04(提升)。
解读 diabetes 的表格。 情形变了。这份数据有 442 行、十个特征,信号近乎可加且大多是线性的。岭回归最好(54.65 \pm 2.19),SVR 第二(55.63),而提升是真实模型中的最后一名(59.02 \pm 5.50,波动最大)。SVR 减岭回归的差值为 0.11, 0.76, -1.92, 4.79, 1.18:均值 0.99,标准差 2.44,所以均值距零 0.9 个标准误,并且有一折符号反转。岭回归优于 SVR 的排名没有证据支持:在这份数据上两者无法区分。提升减岭回归为 7.47, 0.34, -1.60, 9.01, 6.61,均值 4.37,岭回归在五折中的四折更好。平均差距是这五个差值(标准差 4.69)的 2.1 个标准误:有提示意义,但五折不足以使之可靠。
结论。 这一说法是有条件的。当目标具有交互和非线性,并且有足够多的行可供学习时,梯度提升获胜(Friedman #1,2,000 行),在那里它也胜过调得很好的核方法,尽管只是险胜。在只有几百行且信号可加的数据上,正则化线性模型同样好甚至更好,而且拟合、解释和检查的成本都更低。明智的做法不是预设赢家,而是按成本顺序在同样的折上走完这个阶梯:基线、线性模型,然后是提升或随机森林,并逐折地、对照其波动来判断差异。仅看各折的均值,你无从知道差距何时小到无关紧要。
扩展。 提升在其灵活性有回报之前比岭回归需要更多的行,这一说法是可以用学习曲线检验的预测(第 8 节):在 100、200 和 400 行上重复 diabetes 的比较,看提升与岭回归之间的差距是否变化。结果在此不作断言。
加权拟合中的一个坏点。 在实验 5 中应变至 20% 的 neo-Hookean 拟合里,把 \lambda = 0.90 处的点从 -6.98 kPa 改为 -8.00 kPa。
(a) 使用其记录的 \sigma = 0.185 kPa 重新拟合:c_1 移动了多少?该点的归一化残差是多少?\chi^2_\nu 怎样变化?
(b) 把该点的 \sigma 乘以十后重新拟合。
(c) 你希望出现哪种行为?这对记录不确定度说明了什么?
查看解答
设定。 实验 5 的数据是一次合成的软水凝胶压缩试验:拉伸比 \lambda_k = 1 - 0.025k,k = 1, \dots, 16,真实材料为 Gent 模型,c_1 = 10 kPa,\beta = 0.2,记录的不确定度 \sigma_k = 0.05 + 0.02|P_{\text{true},k}| kPa,测得的应力 P_k = P_{\text{true},k} + \sigma_k\varepsilon_k,其中 \varepsilon_k 取自 default_rng(1)。c_1 的加权拟合使用第 12 节的闭式解:c_1^\ast = \sum w_i P_i g_i / (2\sum w_i g_i^2),其中 w_i = 1/\sigma_i^2,g(\lambda) =
\lambda - \lambda^{-2},标准误为 1/(2\sqrt{\sum w_i g_i^2})。下面的代码是自包含的:
import numpy as np

def g(lam):
    return lam - lam**-2                     # neo-Hookean shape function

def p_gent(lam, c1=10.0, beta=0.2):          # the true material of the test
    i1m3 = lam**2 + 2/lam - 3
    return 2*c1*g(lam)/(1 - beta*i1m3)

lam = 1 - 0.025*np.arange(1, 17)
sigma = 0.05 + 0.02*np.abs(p_gent(lam))      # recorded uncertainty, kPa
P = p_gent(lam) + sigma*np.random.default_rng(1).normal(size=16)

def fit_neo_hookean(lam, P, sigma):
    """Weighted least squares for c1: closed form, standard error, residuals."""
    w = 1/sigma**2
    sum_wgg = np.sum(w*g(lam)**2)
    c1 = np.sum(w*P*g(lam))/(2*sum_wgg)
    se = 1/(2*np.sqrt(sum_wgg))
    r = (P - 2*c1*g(lam))/sigma              # normalised residuals
    chi2_nu = np.sum(r**2)/(len(P) - 1)      # one parameter fitted
    return c1, se, r, chi2_nu

n = 8                                        # strains up to 20%
lam8, P8, s8 = lam[:n], P[:n].copy(), sigma[:n].copy()
k = 3                                        # the point at lambda = 0.90
print(f"point {k}: lambda = {lam8[k]:.2f}, P = {P8[k]:.2f}, sigma = {s8[k]:.3f}")

def report(label, P, s):
    c1, se, r, chi = fit_neo_hookean(lam8, P, s)
    print(f"{label:22s} c1 = {c1:6.2f} +- {se:.2f} kPa   r[{k}] = {r[k]:5.2f}"
          f"   chi2_nu = {chi:.2f}")

report("original", P8, s8)
P8[k] = -8.00
report("point moved to -8.00", P8, s8)
s8[k] *= 10
report("... and its sigma x 10", P8, s8)
point 3: lambda = 0.90, P = -6.98, sigma = 0.185
original               c1 =  10.09 +- 0.10 kPa   r[3] = -1.21   chi2_nu = 0.71
point moved to -8.00   c1 =  10.29 +- 0.10 kPa   r[3] = -6.03   chi2_nu = 6.44
... and its sigma x 10 c1 =  10.04 +- 0.11 kPa   r[3] = -0.69   chi2_nu = 0.54
(a) 保留记录的不确定度。 拟合的 c_1 从 10.09 移到 10.29 kPa,变化为 +0.20 kPa:占该值的 2.0%,或两个标准误(0.20/0.0997)。该点的归一化残差为 -6.03:拟合曲线在 \lambda = 0.90 处,比该测量值高出约六个该点自身的标准差。而 \chi^2_\nu 从 0.71 升到 6.44,是之前的九倍,额外的贡献几乎全部来自这一个点(其余七个残差仍在约 \pm 1.6 之内)。
拉动的大小可以手算验证。c_1^\ast 对数据是线性的,所以把某个 P_i 改变 \Delta P,它就改变 \Delta c_1 = w_i g_i\,\Delta P/(2\sum w_j g_j^2)。这里 w_i = 1/0.1847^2 = 29.3,g(0.90) = 0.90 - 1/0.81 = -0.3346,\Delta P = -8.00 - (-6.975) = -1.025,且 2\sum w_j g_j^2 = 1/(2\,\text{SE}^2) = 50.3。所以 \Delta c_1 = 29.3\times(-0.3346)\times(-1.025)/50.3 = +0.20,与重新拟合的结果相符。拟合被拖动的幅度与该点的权重成正比,但诊断量清楚地标出了它。
(b) 放大不确定度。 把该点的 \sigma 乘以十,就是把它的权重除以一百。现在 c_1 = 10.04 kPa,基本就是完全没有这个点时的值(把它剔除时为 10.04),该点的残差为 -0.69 个标准差,\chi^2_\nu = 0.54。这个点实际上被忽略了。c_1 的标准误略微升到 0.107,因为拟合现在拥有的信息更少。
(c) 你想要什么,以及这道练习说明了什么。 这取决于这个读数当时是什么情况。如果仪器工作正常,读数确实与其记录的 \sigma 一样精确,那么 (a) 就是诚实的答案:偏离六个标准差的点,是试样、模型或试验装置需要解释的真实证据,而大的 \chi^2_\nu 就是警报。把这个点降权会掩盖证据。如果取这个点时已知有问题(压板打滑,载荷传感器下有气泡),则对这一测量价值的诚实记录就是一个大的 \sigma,如 (b) 所示,这时拟合理所当然地忽略它。
绝不能发生的是第三种情形:一个坏读数配上错误的、很小的 \sigma,这会产生 (a) 的结果而没有诊断,得到一个没人检查的结果。\sigma_i 是数据的一部分,而不是一个设置:它们说明每个点可以在多大程度上改变答案,而拟合的诚实程度只取决于它们。接受不带不确定度的点的程序根本无法做这项检查,这也是实验 5 的 check_inputs 拒绝它们的原因。而且诊断的顺序很重要:在调整任何 \sigma 之前先看归一化残差,因为把不确定度放大到 \chi^2_\nu 看起来不错,是让拟合“过关”而不是去理解它的做法。
标错的加载方向。 一位同事导出一次压缩试验的数据,把拉伸比写成 1 + \text{应变},把应力写成正数,并在把加载方向声明为拉伸的情况下拟合 neo-Hookean 模型。
(a) 实验 5 的哪些输入检查会触发?为什么没有任何输入检查能发现这个错误?
(b) 在前 5% 的应变范围内,读错的拟合看上去很干净;在 20% 范围内则不然。不用计算,从 g(\lambda) = \lambda - \lambda^{-2} 在 \lambda = 1 两侧的弯曲方式作出解释。
(c) 拟合出的 c_1 旁边必须存储什么,才能使下一位使用者不再犯同样的错误?
查看解答
(a) 没有检查会触发。 这些检查拒绝的是相互矛盾的输入:缺失或非正的不确定度,对于所声明的方向落在 1 错误一侧的拉伸比,符号对该方向不正确的应力。拉伸比大于 1、应力为正、声明为拉伸试验,这些彼此相容:它们描述的是一次完全有效的拉伸试验。错误不在于这些数字彼此之间的关系,而在于它们与实验室里实际发生之事的关系,在那里压板是相向移动的。检查只能发现各项声明之间的矛盾,而这里并没有矛盾;只有试验记录才能说明加载的是哪个方向。这是基于规则的验证的一般局限:自洽的错误标注会通过每一项一致性检查。
(b) 为什么错误只在较大应变时才显现。 g(\lambda) = \lambda - \lambda^{-2} 在 \lambda = 1 两侧斜率相同:g'(\lambda) = 1 + 2\lambda^{-3} 在 \lambda = 1 处等于 3。但 g''(\lambda) = -6\lambda^{-4} 为负,所以 g 向下弯曲。以应变 \varepsilon 离开 \lambda = 1,在 \lambda = 1 附近的展开为
在压缩中,|g| 随应变的增长快于线性(曲线偏离切线,朝更负的值弯去);在拉伸中则增长得比线性慢。对 \varepsilon 的一阶近似,两个分支一致,读错的数据看起来就像一种稍硬材料的拉伸试验,单参数拟合把它吸收进一个更大的 c_1,不留下任何模式。两个分支相差约 6\varepsilon^2,而一阶项为 3\varepsilon:相对差异约为 2\varepsilon。在前 5% 的应变内,两个分支的比值从约 1.05 变到 1.10;单个 c_1 吸收了其平均值,剩下的在整个范围内只有百分之几,低于噪声允许残差显示出来的水平。在 20% 范围内,比值从 1.05 变到 1.5,远非一个系数所能吸收,残差呈现成串的同号,\chi^2_\nu 远高于 1。在实验 5 的测量数据中,前 5% 范围内读错的拟合使 c_1 偏高 8.7%,\chi^2_\nu = 0.38(对错误模型的一次干净拟合);在 20% 范围内则偏高 28.5%,\chi^2_\nu = 20.7。干净的拟合并不说明模型是对的:它说明的是数据无法区分两者。
(c) 要存储什么。 与系数一起,记录加载方向,以及拉伸比和应力的符号约定(压缩为负吗?),拟合所用的应变范围,不确定度和诊断量(\chi^2_\nu 与归一化残差),以及所用的模型(neo-Hookean,Gent)。拟合出的 c_1 只对它所来自的那次试验、在拟合它所用的模型中才有意义。一个光秃秃的数字,“c_1 = 12.97 kPa”,等于邀请别人在它不适用的场合重用它,而随数字一同流转的报告,是下一位使用者唯一的保护。
自测题
共十二道题,每题约 90 秒;先作答再看解析,答错的题请重读解析中指出的章节。
论文导读
读论文不是从第一行读到最后一行。分两遍读,并在第一遍之后决定第二遍是否值得花时间。
第一遍,5 到 10 分钟。 读标题、摘要、引言和结论,并只看每张图和每张表及其说明,不看周围的正文。然后用自己的话写下三件事:论文提出的问题、它的主张,以及它给出的证据。如果你无法把主张表述成一个含有数字或比较的句子(“在数据集 C 上,方法 A 比方法 B 高出这么多”),第一遍就没有完成。第一遍结束时,你应当知道这篇论文是否与你相关。
第二遍,用剩余的时间。 只读下面的导读指出的章节,其余跳过。读方法部分,直到你能根据描述复现核心图。对每个结果,提出本模块的那些问题:基线是什么,数字是怎么测的,在哪个划分上,区间多大,什么会改变它?先读实验设置再读结果,因为它会告诉你哪些比较是公平的。第一次阅读时跳过证明,除非某个问题问到它;改为检查自己能否说出每个定理的假设。
准备一页笔记,以下面的阅读问题为标题,每个答案写一两句话。读过的论文,是你能复述并批评其主张的论文,而不是你只是看过的论文。所给时间是初读的预算;这些问题值得再读一遍。
Belkin, M., Hsu, D., Ma, S., Mandal, S. “Reconciling modern machine-learning practice and the classical bias–variance trade-off.” Proceedings of the National Academy of Sciences (PNAS), 2019.
为什么读。 提出“双下降”这一名称的论文。它说明了第 8 节中经典的 U 形验证曲线在哪里不再是全部图景,以及为什么分解本身依然成立。
读什么、跳过什么。 读摘要、引言(到图 1 为止,含图 1),以及“神经网络”一节中关于随机傅里叶特征的部分,连同那张随特征数变化的测试风险、系数范数和训练风险图。跳过理论分析和补充材料。
阅读时要回答的问题
- 什么是插值阈值?对随机傅里叶特征,它位于何处?
- 越过阈值后,许多参数向量都能精确拟合训练数据。作者选了哪一个?这一选择为什么对测试误差很重要?
- 双下降是否与你在第 8 节推导的偏差-方差分解相矛盾?用两句话解释。
- 这篇论文对实践中用验证集选择模型规模意味着什么?
读完之后。 把论文中的曲线与第 8 节双下降段落中的数字对比,那些数字把超过 19 次之后的最小范数拟合应用于实验 3 的设计。在那里,第二次下降并没有低于经典的最小值;检查论文对其实验是否有不同的主张,以及这个答案说明了何时该相信哪一种曲线形状。
Kapoor, S., Narayanan, A. “Leakage and the reproducibility crisis in machine-learning-based science.” Patterns, 2023.
为什么读。 一份关于已发表的基于机器学习的科学研究中泄漏问题的综述,其分类法把实验 4 的三种情形变成了一张检查清单,并附有一个案例研究:一旦修复泄漏,复杂模型备受称道的优势就消失了。
读什么、跳过什么。 读引言、八类泄漏的分类法(每一类的定义,以及以这些类别为列的综述表)以及内战预测案例研究。略读逐领域的综述和模型信息表。
阅读时要回答的问题
- 把实验 4 的三条有泄漏的流水线分别放进论文的分类法中。
- 在内战案例中,错误被纠正之后,所报告的复杂模型相对于逻辑回归的优势怎么样了?
- 作者提出的文档规范(模型信息表)中,哪些条目本可以发现实验 4 中的分组泄漏?
- 说出分类法中的一种泄漏类型,是只打开一次测试集也防不住的,并说明原因。
读完之后。 取一次你做过或审阅过的模型评估,把分类法当作检查清单逐项填写,每种泄漏类型一行:“已排除,因为……”或“可能存在,因为……”。你答不上来的部分,就是该评估最薄弱之处。
Domingos, P. “A few useful things to know about machine learning.” Communications of the ACM, 2012.
为什么读。 一位实践者对本模块正式推导过的那些经验的总结。最后读它,可以检验形式化的版本是否真的记住了;当同事问起本模块讲了什么时,这也是可以递给他的那篇文章。
读什么、跳过什么。 读关于“学习 = 表示 + 评估 + 优化”的一节,以及关于泛化、过拟合(含飞镖靶图)、高维下直觉失效、以及更多数据胜过更聪明的算法的各节。其余略读。
阅读时要回答的问题
- Domingos 把学习器拆成表示、评估和优化。把它们对应到第 1 节的五个要素。他让哪些要素保持隐含?
- 他的四个飞镖靶中,哪一个对应实验 3 中 20 个点上未正则化的 15 次多项式,哪一个对应 1 次拟合?
- 他说更多数据胜过更聪明的算法。利用第 8 节的学习曲线,说明何时这是对的、何时是错的。
- 他的高维直觉中,哪一条被第 11 节的子立方体计算量化了,哪一条由练习 12 的 k-NN 场景所说明?
读完之后。 列出文章中本模块没有涉及的经验(例如特征工程和集成方法),并标注哪个后续模块会讲到每一条。
小结
- 一种学习方法由五个选择构成:数据、模型族、损失、优化器和评估。每一个选择都带有一个假设,大多数失败都能追溯到其中之一。
- 最小二乘是一个正交投影:正规方程 \mathbf{X}^\top(\mathbf{y} - \mathbf{X}\mathbf{w}) = \mathbf{0} 表明残差与 \mathbf{X} 的每一列正交。
- 在二次函数上,梯度下降收敛当且仅当 \eta < 2/\lambda_{\max}(Hessian 的最大特征值),所需步数与条件数 \kappa = \lambda_{\max}/\lambda_{\min} 成正比;中心化并标准化特征是降低 \kappa 最便宜的办法。
- 步长恒定时,SGD 停在与 \eta/B 成正比的噪声底,而不是极小值。收敛需要衰减的步长或更大的 batch,这两个旋钮是在速度与精度之间权衡。
- 损失是负对数似然:高斯噪声给出平方误差(最优常数:均值),拉普拉斯噪声给出绝对误差(中位数),伯努利或类别型结果给出交叉熵。
- 对逻辑回归和 softmax 回归,损失对 logits 的梯度是 \hat p - y(或 \hat{\mathbf{p}} - \mathbf{y}):sigmoid 或 softmax 的导数与对数相消,所以自信的错误会产生很大的梯度。
- 指标要根据它所服务的决策来选。精确率取决于基础比率(召回率 0.8、假阳性率 0.01、患病率 0.2% 时,精确率为 0.14),而用期望校准误差和 Brier 分数衡量的校准,是与区分能力不同的另一种性质。
- 测试误差等于偏差平方加方差加噪声。验证曲线、学习曲线和 k 折交叉验证能把模型定位在欠拟合与过拟合之间,在近乎相等的候选之间做选择时,应对照比较的标准误差来判断。
- 岭回归和 Lasso 回归分别是高斯先验和拉普拉斯先验下的 MAP 估计,岭回归的 \lambda = \sigma^2/(N\tau^2):正则化就是先验知识,用少量偏差换取更大的方差下降。双下降在特定条件下是真实存在的现象,但并不取代 U 形曲线。
- 诚实的评估意味着每个拟合的步骤(包括缩放和选择)都在折内进行;划分尊重分组和时间;模型选择是嵌套的;测试集只打开一次(在全部数据上选特征,在实验 4 的纯噪声上得到 0.87 的准确率),并且每个报告的数字都附带区间。在同一测试集上比较两个模型,用配对自助法和 McNemar 精确检验;当两者结论不一致时,如实说明,而不是选你偏爱的那一个。
- 表格数据先做基线:先正则化线性模型,再梯度提升树。重新缩放某个特征会改变 k-NN、核方法和岭回归的预测,但不会改变树的预测。
- 参数区间衡量的是给定模型下的噪声,而不是模型误差。在 0–20% 应变上区间为 \pm2\%(95%)的 neo-Hookean 拟合,在 40% 处偏低 13%,因此拟合出的模型应当附上它被拟合时所用的范围。
下一模块 Module 02 把本模块的线性模型变成网络:堆叠多层,用反向传播取代手工推导的梯度,用动量法和 Adam 取代朴素 SGD。这里的一切都会延续:损失仍是负对数似然,Hessian 的特征值仍决定训练速度,正则化仍编码先验,而网络的验证分数一旦泄漏,仍然一文不值。
关键术语
| English | 中文 |
|---|---|
| supervised / unsupervised learning | 监督学习 / 无监督学习 |
| loss function / empirical risk | 损失函数 / 经验风险 |
| generalisation | 泛化 |
| least squares / normal equations | 最小二乘法 / 正规方程 |
| condition number | 条件数 |
| gradient descent / learning rate | 梯度下降 / 学习率 |
| stochastic gradient descent / mini-batch / batch size / epoch | 随机梯度下降 / mini-batch / batch 大小 / 轮次(epoch) |
| likelihood / maximum likelihood estimation | 似然 / 极大似然估计 |
| prior / maximum a posteriori (MAP) estimation | 先验 / 最大后验估计 |
| cross-entropy / softmax / logits | 交叉熵 / softmax / logits |
| logistic regression / decision boundary | 逻辑回归 / 决策边界 |
| overfitting / underfitting | 过拟合 / 欠拟合 |
| bias–variance trade-off | 偏差-方差权衡 |
| learning curve / double descent | 学习曲线 / 双下降 |
| regularisation / weight decay | 正则化 / 权重衰减 |
| ridge regression / lasso | 岭回归 / Lasso 回归(套索回归) |
| training / validation / test set | 训练集 / 验证集 / 测试集 |
| cross-validation / nested cross-validation | 交叉验证 / 嵌套交叉验证 |
| data leakage / distribution shift | 数据泄漏 / 分布偏移 |
| confusion matrix | 混淆矩阵 |
| precision / recall / F1 score | 精确率 / 召回率 / F1 分数 |
| ROC curve / AUC / precision–recall curve | ROC 曲线 / 曲线下面积(AUC) / 精确率-召回率曲线 |
| calibration / reliability diagram | 校准 / 可靠性图 |
| bootstrap / confidence interval | 自助法 / 置信区间 |
| standardisation / one-hot encoding | 标准化 / 独热编码 |
| k-nearest neighbours / curse of dimensionality | k 近邻 / 维数灾难 |
| decision tree / random forest / gradient boosting | 决策树 / 随机森林 / 梯度提升 |
| support vector machine / kernel | 支持向量机 / 核函数 |
| k-means clustering / principal component analysis | k 均值聚类 / 主成分分析 |
| nonlinear least squares / extrapolation / hyperelastic (neo-Hookean) model | 非线性最小二乘 / 外推 / 超弹性(新胡克)模型 |
参考文献
- Bishop, C. M. “Pattern Recognition and Machine Learning.” Springer, 2006. 第 1、3、4 章:本模块的概率视角。
- Hastie, T., Tibshirani, R., Friedman, J. “The Elements of Statistical Learning,” 2nd ed. Springer, 2009. 第 2、3、7 章:最小二乘、岭回归与 Lasso、模型评估和单标准误差规则。
- James, G., Witten, D., Hastie, T., Tibshirani, R. “An Introduction to Statistical Learning,” 2nd ed. Springer, 2021. 上一本书的入门版配套读物。
- Goodfellow, I., Bengio, Y., Courville, A. “Deep Learning.” MIT Press, 2016. 第 5 章:机器学习基础。
- Murphy, K. P. “Probabilistic Machine Learning: An Introduction.” MIT Press, 2022. 在同一套记号下讲极大似然、MAP 和逻辑回归。
- Trefethen, L. N., Bau, D. “Numerical Linear Algebra.” SIAM, 1997. QR、SVD 与最小二乘的条件性。
- Nocedal, J., Wright, S. J. “Numerical Optimization,” 2nd ed. Springer, 2006. 梯度下降的收敛速率;Gauss–Newton 与 Levenberg–Marquardt。
- Robbins, H., Monro, S. “A stochastic approximation method.” Annals of Mathematical Statistics, 1951. SGD 的步长条件。
- Bottou, L., Curtis, F. E., Nocedal, J. “Optimization methods for large-scale machine learning.” SIAM Review, 2018. SGD 的理论与实践。
- Keskar, N. S. et al. “On large-batch training for deep learning: generalization gap and sharp minima.” ICLR, 2017. 第 4 节中小 batch、平坦极小值的观察。
- Hoerl, A. E., Kennard, R. W. “Ridge regression: biased estimation for nonorthogonal problems.” Technometrics, 1970. 岭回归的原始论文。
- Tibshirani, R. “Regression shrinkage and selection via the lasso.” Journal of the Royal Statistical Society, Series B, 1996. Lasso 回归的原始论文。
- Belkin, M., Hsu, D., Ma, S., Mandal, S. “Reconciling modern machine-learning practice and the classical bias–variance trade-off.” PNAS, 2019. 双下降;论文导读。
- Nakkiran, P. et al. “Deep double descent: where bigger models and more data hurt.” ICLR, 2020. 深度网络中的双下降。
- Wolpert, D. H. “The lack of a priori distinctions between learning algorithms.” Neural Computation, 1996. 没有免费午餐定理。
- Kaufman, S., Rosset, S., Perlich, C., Stitelman, O. “Leakage in data mining: formulation, detection, and avoidance.” ACM Transactions on Knowledge Discovery from Data, 2012. 对泄漏较早的形式化处理。
- Kapoor, S., Narayanan, A. “Leakage and the reproducibility crisis in machine-learning-based science.” Patterns, 2023. 论文导读。
- Ambroise, C., McLachlan, G. J. “Selection bias in gene extraction on the basis of microarray gene-expression data.” PNAS, 2002. 实验 4 的特征选择泄漏。
- Varma, S., Simon, R. “Bias in error estimation when using cross-validation for model selection.” BMC Bioinformatics, 2006. 为什么要用嵌套交叉验证。
- Cawley, G. C., Talbot, N. L. C. “On over-fitting in model selection and subsequent selection bias in performance evaluation.” Journal of Machine Learning Research, 2010. 超参数搜索中的同一问题。
- Fawcett, T. “An introduction to ROC analysis.” Pattern Recognition Letters, 2006. ROC 曲线与 AUC。
- Saito, T., Rehmsmeier, M. “The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets.” PLoS ONE, 2015. 为什么基础比率影响曲线的选择。
- Niculescu-Mizil, A., Caruana, R. “Predicting good probabilities with supervised learning.” ICML, 2005. 经典分类器的校准;Platt 与保序重校准。
- Guo, C., Pleiss, G., Sun, Y., Weinberger, K. Q. “On calibration of modern neural networks.” ICML, 2017. 期望校准误差与温度缩放。
- Efron, B., Tibshirani, R. J. “An Introduction to the Bootstrap.” Chapman & Hall, 1993. 第 10 节的自助法。
- McNemar, Q. “Note on the sampling error of the difference between correlated proportions or percentages.” Psychometrika, 1947. 第 10 节的配对检验。
- Dietterich, T. G. “Approximate statistical tests for comparing supervised classification learning algorithms.” Neural Computation, 1998. 为什么 McNemar 检验适合在同一测试集上比较两个分类器。
- Breiman, L. “Random forests.” Machine Learning, 2001. 带随机特征子集的装袋树。
- Friedman, J. H. “Greedy function approximation: a gradient boosting machine.” Annals of Statistics, 2001. 作为函数空间梯度下降的梯度提升。
- Chen, T., Guestrin, C. “XGBoost: a scalable tree boosting system.” KDD, 2016. 一个广泛使用的提升库。
- Ke, G. et al. “LightGBM: a highly efficient gradient boosting decision tree.” NeurIPS, 2017. 基于直方图的提升。
- Grinsztajn, L., Oyallon, E., Varoquaux, G. “Why do tree-based models still outperform deep learning on typical tabular data?” NeurIPS Datasets and Benchmarks Track, 2022. 表格基线建议背后的基准测试。
- Cortes, C., Vapnik, V. “Support-vector networks.” Machine Learning, 1995. 软间隔支持向量机。
- Rasmussen, C. E., Williams, C. K. I. “Gaussian Processes for Machine Learning.” MIT Press, 2006. 高斯过程的标准参考书。
- Arthur, D., Vassilvitskii, S. “k-means++: the advantages of careful seeding.” SODA, 2007. scikit-learn 的 k 均值默认使用的初始化规则。
- Domingos, P. “A few useful things to know about machine learning.” Communications of the ACM, 2012. 论文导读。
- Holzapfel, G. A. “Nonlinear Solid Mechanics: A Continuum Approach for Engineering.” Wiley, 2000. Neo-Hookean 及相关应变能函数。
- Gent, A. N. “A new constitutive relation for rubber.” Rubber Chemistry and Technology, 1996. 第 12 节和实验 5 的 Gent 模型。
- Bates, D. M., Watts, D. G. “Nonlinear Regression Analysis and Its Applications.” Wiley, 1988. 非线性最小二乘中的参数不确定性。
- Pedregosa, F. et al. “Scikit-learn: machine learning in Python.” Journal of Machine Learning Research, 2011. 实验中使用的库。