摆脱循环计算
第 04 模块 最后介绍了注意力(attention):它如何缓解编码器-解码器的瓶颈。在每个输出步骤,解码器读取编码器状态的加权和;权重由解码器当前状态与各编码器状态之间的匹配分数决定。Bahdanau 的方法用一个小网络计算分数:
其中,\mathbf{s}_{t-1} 是解码器状态,\mathbf{h}_j 是位置 j 的编码器状态,\mathbf{a}_t 是解码器在步骤 t 读取的上下文向量。Luong 等人用乘法形式取代小网络:或者直接计算点积 \mathbf{s}^\top\mathbf{h}_j,或者使用双线性形式 \mathbf{s}^\top\mathbf{W}\mathbf{h}_j,从而将所有位置的打分合并为一次矩阵乘法。两种方法都是在两个循环网络之上添加注意力。Transformer(Vaswani 等,2017)则彻底去掉循环计算,使注意力成为位置之间传递信息的唯一途径。
循环计算的代价
循环计算有两项代价,无论怎样优化工程实现都无法消除。
时间维度上的计算必须串行进行。 步骤 t 需要 \mathbf{h}_{t-1},而后者又需要 \mathbf{h}_{t-2},依此类推,直到第一个 token。因此,无论使用什么硬件,一条包含 10,000 个 token 的训练序列在每一层都需要 10,000 个相互依赖的步骤。GPU 可以并行处理多条序列,但同一条序列中的每一步都必须等待前一步。教师强制虽然让所有输入提前已知,也无法解决这个问题,因为非线性运算位于循环内部。
信息传播路径很长。 位置 j 的信息要经过 t - j 次循环更新才能到达位置 t。每次更新都将信息压入相同宽度的状态向量,可能丢失一部分信息。第 04 模块 中的梯度消失,正是沿这条长路径反向传播时出现的问题。
自注意力(self-attention)消除了这两项代价。每个位置都对所有允许看到的位置计算加权和,而且所有位置可以通过一次矩阵乘法同时完成计算。一条包含 10,000 个 token 的序列,因而对应一次大型矩阵运算,而非 10,000 次相互依赖的小型运算。无论相距多远,任意两个位置之间的传播路径都只经过一层。
代价与权衡
这种改进也有代价。Vaswani 等(2017,表 1)比较了两种层处理长度为 T、向量宽度为 d 的序列时的成本:
| 层 | 每层成本 | 顺序操作 | 最大路径长度 |
|---|---|---|---|
| 循环层 | O(Td^2) | O(T) | O(T) |
| 自注意力 | O(T^2 d) | O(1) | O(1) |
循环层在 T 个步骤中的每一步,都将一个 d 维向量乘以一个 d \times d 矩阵;自注意力则通过长度为 d 的点积,为 T^2 对位置打分。两者的成本比为 T^2 d / (T d^2) = T/d,因此在 T < d 时,自注意力的成本较低。原始翻译模型的句子通常只有几十个 token,宽度为 d = 512,正属于这种情况;T = 50 时,成本比约为 0.1。超过 T = d 后,自注意力就要承担关于序列长度的二次方成本:在 T = 32{,}768、d = 4{,}096 时,成本比为 8,并随上下文长度线性增长。表中只计算位置之间的信息混合;自注意力还需要 O(Td^2) 的投影运算(第 4 节),循环层的权重运算也有同样的成本。第 04 模块,第 12 节 还介绍了卷积这个替代方案,以及循环网络仍保有的一项优势:每生成一个 token,只需恒定大小的状态内存。
T^2 也体现在内存需求上,因为注意力权重构成一个 T \times T 矩阵。第 10 节 说明 FlashAttention 如何在不保存完整矩阵的情况下计算注意力:它消除了 T^2 的内存需求,但没有消除 T^2 的算术运算量。第 04 模块,第 13 节 的状态空间模型采用另一条路线:保留循环,但使递推关系成为线性的,从而能够并行计算。
注意力作为软字典查找
Python 字典是一种硬查找。给定 {"pump": v1, "valve": v2, "tank": v3} 和查询 "tank",它将查询与键比较,找到相等的键,并精确返回该键对应的值 v3。其他查询都找不到结果。
注意力放宽了这三个步骤的要求。它用点积计算查询与每个键的匹配分数,允许部分匹配;再用 softmax 将分数转为权重,使每个键都获得正权重,且权重总和为 1;最后返回值的加权平均,因此输出混合了多个值,匹配越好的值占比越大(图 6.1)。
查询为 \mathbf{q} = (1, 1);键为 \mathbf{k}_1 = (1, 0)(“泵”)、\mathbf{k}_2 = (0, 1)(“阀门”)和 \mathbf{k}_3 = (1, 1)(“水箱”);值为 \mathbf{v}_1 = (1, 0)、\mathbf{v}_2 = (0, 2) 和 \mathbf{v}_3 = (3, 3)。
- 得分 \mathbf{q}\cdot\mathbf{k}_j:1 + 0 = 1、0 + 1 = 1 和 1 + 1 = 2,因此 (1, 1, 2)。
- 除以 \sqrt{d_k} = \sqrt 2 = 1.414(第 2 节 给出原因):(0.707, 0.707, 1.414)。
- 求幂:e^{0.707} = 2.028(两次)和 e^{1.414} = 4.113;总和是 8.169。
- 归一化:(2.028, 2.028, 4.113)/8.169 = (0.248, 0.248, 0.503)。
- 将权重保留到小数点后四位(0.2483 和 0.5035),计算值的加权平均:0.2483\,(1, 0) + 0.2483\,(0, 2) + 0.5035\,(3, 3) = (0.2483 + 1.5105,\ 0.4966 + 1.5105) = (1.759, 2.007)。
如果将权重四舍五入到小数点后三位,最终结果会偏移至 (1.757, 2.005),所以步骤 5 保留四位。相同查询的硬查找精确返回 \mathbf{v}_3 = (3, 3);若各分数相等,则返回值的平均值 (1.333, 1.667)。软查找介于两者之间:偏向匹配最好的“水箱”,同时仍保留另外两个值各约四分之一的贡献。这对应 第 3 节 算例的第 3 行,其中 token 3 关注全部三个 token,使用的正是这组数字。
这一行为有两个极限。将所有分数乘以因子 c。随着 c 增大,最大分数支配 softmax:c = 10 时,权重为 (0.001, 0.001, 0.998),输出为 (2.996, 2.997),几乎完全是 \mathbf{v}_3。在极限下,softmax 变成 argmax,软查找变为硬查找。当 c \to 0,或各分数相等时,权重均为 1/3,输出为简单平均值 (1.333, 1.667)。注意力介于两者之间,由分数的尺度决定具体位置;这也是 第 2 节 讨论分数尺度的原因。
import numpy as np

table = {"pump": (1, 0), "valve": (0, 2), "tank": (3, 3)}
print(table["tank"])                                 # hard: one exact match

q = np.array([1.0, 1.0])
K = np.array([[1.0, 0.0], [0.0, 1.0], [1.0, 1.0]])   # keys: pump, valve, tank
V = np.array([[1.0, 0.0], [0.0, 2.0], [3.0, 3.0]])   # values
s = K @ q / np.sqrt(2)                               # scaled scores
w = np.exp(s - s.max())                              # subtracting the max avoids overflow
w = w / w.sum()                                      # softmax weights
print(np.round(w, 3), np.round(w @ V, 3))            # soft: a weighted average
(3, 3)
[0.248 0.248 0.503] [1.759 2.007]
软查找的平滑性使它能够学习。字典查找不能提供有用的梯度:查询的微小变化要么不改变结果,要么突然跳到另一个键。软查找的输出则是查询、每个键和每个值的平滑函数,损失梯度能够指出它们各自应向什么方向移动。因此,可以通过可学习的投影从 token 生成查询、键和值(第 2 节),让训练决定每个位置寻找什么、提供什么。
硬查找与软查找。查询 tank 选择一个字典条目。软查找中,\mathbf{q}=(1,1) 对键 (1,0)、(0,1)、(1,1) 分别赋予权重 0.248、0.248、0.503,将对应的值混合为输出 (1.759,2.007)。分数相等时得到平均值;一个分数占主导时则接近硬查找。
必须添加回来的内容
去掉循环计算,也去掉了它自然提供的两项特性。第一项是顺序。加权和本身没有位置概念:打乱输入 token 后,每个输出仍是原来的向量,只是移动到对应 token 的新位置。因此,“压力超过限值”和“限值超过压力”得到相同的输出集合。第 6 节 加入位置信息,练习 4 证明这种对称性。第二项对生成而言是时间方向。循环网络无法看到未来,因为步骤 t 的状态只由步骤 1 到 t 构成;注意力层同时看到所有位置,所以预测下一个 token 的模型需要掩码,阻止每个位置看到未来(第 2 节)。
注意力是一种可微分的软字典查找:计算查询与每个键的分数,用 softmax 将分数转为权重,再返回值的加权平均。
为什么循环网络不能并行处理训练序列的 10,000 个位置?
查看答案
步骤 t 依赖 \mathbf{h}_{t-1},后者又依赖 \mathbf{h}_{t-2},一直追溯到起点。这 10,000 个步骤形成必须按顺序计算的依赖链,即使所有输入事先已知也是如此。
在上面的软查找中,如果三个分数相等,输出会变成什么?
查看答案
各权重为 1/3,输出为值的简单平均:\tfrac13\big[(1, 0) + (0, 2) + (3, 3)\big] = (1.333, 1.667)。
缩放点积注意力
将包含 T 个 token 向量的序列堆叠成矩阵 \mathbf{X} \in \R^{T\times d} 的行。通过可学习矩阵,将每个向量投影到三个不同角色:
其中 \mathbf{W}_Q, \mathbf{W}_K \in \R^{d\times d_k},\mathbf{W}_V \in \R^{d\times d_v}。第 i 行是 token i 的投影,即 \mathbf{q}_i = \mathbf{x}_i\mathbf{W}_Q,\mathbf{k}_i 和 \mathbf{v}_i 同理。查询(query)表示该位置寻找什么;键(key)表示该位置提供什么供匹配;值(value)表示匹配后传递什么。三个角色不同,所以需要三个矩阵:一个单词寻找的内容(如动词寻找主语)不必与它提供的内容相同,传递的内容也不必与匹配的内容相同。查询和键共享宽度 d_k,以便比较;值可以采用任意宽度 d_v。于是
\mathbf{S} = \mathbf{Q}\mathbf{K}^\top/\sqrt{d_k} 是 T \times T 矩阵,每一对(查询位置,键位置)对应一个分数 S_{ij} = \mathbf{q}_i\cdot\mathbf{k}_j/\sqrt{d_k}。逐行应用 softmax,得到 P_{ij} = \exp(S_{ij})/\sum_k \exp(S_{ik})。因此 \mathbf{P} = \softmax(\mathbf{S}) 的各元素非负,各行之和为 1,每个查询都得到键位置上的概率分布。输出的第 i 行为 \mathbf{o}_i = \sum_j P_{ij}\mathbf{v}_j,是值向量的凸组合,因而位于它们的凸包内(第 3 节 给出图示)。图 6.2 标出了各张量的形状。
T=5 时的缩放点积注意力,框内标出张量形状。查询与键的投影形成分数 \mathbf{Q}\mathbf{K}^{\top}/\sqrt{d_k}。因果掩码在逐行 softmax 之前屏蔽上三角部分。将所得权重乘以值矩阵,得到形状为 T\times d_v 的输出。
逐行应用 softmax 雅可比矩阵
注意力通过 softmax 学习,因此其导数决定学习速度。第 02 模块,第 3 节 已推导 \mathbf{p} = \softmax(\mathbf{s}) 的雅可比矩阵:
本模块会用到它的三个性质。各行之和为零,\sum_j p_i(\delta_{ij} - p_j) = p_i - p_i = 0,因为对所有分数加上相同常数不会改变 \mathbf{p}。当 \mathbf{p} 接近独热分布时,\mathbf{J} 趋于零:每个元素都包含趋于零的因子(p_i、p_j 或 1 - p_i)。当 \mathbf{p} 分布较均匀时,\mathbf{J} 较大:它的迹 1 - \sum_i p_i^2 在均匀分布处达到最大值。
运行示例的第 3 行的权重为 \mathbf{p} = (0.2483, 0.2483, 0.5035) (第 1 节)。对角线条目为 p_i(1 - p_i): 0.2483 \times 0.7517 = 0.187(两次)和 0.5035 \times 0.4965 = 0.250。非对角线条目为 -p_ip_j: -0.2483^2 = -0.062 和 -0.2483 \times 0.5035 = -0.125。所以
第 1 行总计为 0.187 - 0.062 - 0.125 = 0,第 3 行总计为 -0.125 - 0.125 + 0.250 = 0。该矩阵是对称的,因此其列的总和也为零。四舍五入到小数点后三位,权重在对角线上的值为 0.248 \times 0.752 = 0.186;小数点后第四位在这里也很重要。
一行的梯度。 设一行的输出为 \mathbf{o} = \sum_j p_j\mathbf{v}_j,\mathcal{L} 是由该输出计算的任意标量。由 \partial\mathbf{o}/\partial p_j = \mathbf{v}_j 可得,各权重的梯度为 g_j = \partial\mathcal{L}/\partial p_j = (\partial\mathcal{L}/\partial\mathbf{o})\cdot\mathbf{v}_j。通过 \mathbf{J} 应用链式法则,得到
g_j 表示将权重移向值 j 时损失的变化率,\bar g 是当前混合下的平均变化率。若某键的值比当前加权平均更有利于降低损失(g_j < \bar g),梯度下降就提高该键的分数;反之则降低分数。变化量与 p_j 成比例,所以权重已经很小的键几乎不会移动。分数通过 S_{ij} = \mathbf{q}_i\cdot\mathbf{k}_j/\sqrt{d_k} 将梯度传给查询和键;第 3 节 用具体数字演示这一过程。
为什么分数会被缩放
假设 \mathbf{q} 和 \mathbf{k} 的条目是独立的,均值为 0,方差为 1。得分 \mathbf{q}\cdot\mathbf{k} = \sum_{i=1}^{d_k} q_i k_i 是 d_k 项的总和。因为 q_i 和 k_i 是独立的,所以它的均值是
项 q_ik_i 彼此独立,因此它们的方差相加,并且每一项的均值为 0,因此其方差是其二阶矩,通过独立性进行因式分解:
标准差为 \sqrt{d_k};在常见的头宽度 d_k = 128 下,约为 11.3。除以 \sqrt{d_k} 后,无论头宽度如何,都恢复单位方差:\operatorname{Var}(\mathbf{q}\cdot\mathbf{k}/\sqrt{d_k}) = d_k/d_k = 1。
这一假设描述的是初始化状态:归一化的输入经过保留方差的投影初始化(第 02 模块,第 6 节)后,各元素的方差大致为 1。训练可以改变尺度:增大 \mathbf{W}_Q 和 \mathbf{W}_K 会使注意力分布更集中,模型可以据此获益。因此,缩放因子设定的是 softmax 的初始温度,并不限制后续学习。
实验 1 抽取 100,000 对向量,各元素独立服从标准正态分布,并测量 \mathbf{q}\cdot\mathbf{k} 的标准差:
| d_k | 2 | 16 | 64 | 128 |
|---|---|---|---|---|
| 实测值 | 1.43 | 3.99 | 7.99 | 11.33 |
| \sqrt{d_k} | 1.41 | 4.00 | 8.00 | 11.31 |
各实测值与 \sqrt{d_k} 的相对误差均在 1% 以内。未缩放分数的分布范围随头宽度增大,因此若没有缩放因子,更宽的头在初始化时就会具有更集中的 softmax 分布。
没有它会出现什么问题。 d_k = 128 处的未缩放分数的标准偏差为 11.3,因此最佳键与其余键之间的差距通常为 10 或更多。然后 softmax 饱和,接近 one-hot,其中 \mathbf{J} 几乎为零。每个到达 \mathbf{W}_Q 和 \mathbf{W}_K 的梯度都会经过 \partial\mathcal{L}/\partial\mathbf{s} = \mathbf{J}\mathbf{g} (\mathbf{J} 是对称的,因此它是它自己的转置),所以在初始化时,无论 \mathbf{g} 是什么,这些梯度都很小:模型以任意的、几乎独热的注意力模式开始,并且只能慢慢地学习改变它。
取分数 (11.3, 0, 0):其差距对应 d_k = 128 时未缩放分数的一个标准差。分子分母同除以 e^{11.3},得到 p_2 = p_3 = e^{-11.3}/(1 + 2e^{-11.3}) = 0.000012 和 p_1 = 0.999975。于是 J_{11} = p_1(1 - p_1) = 0.999975 \times 0.000025 = 2.5\times10^{-5},其他元素也同样很小(J_{22} = 0.000012、J_{12} = -0.000012)。
按 1/\sqrt{128} 缩放后,同一组分数变成 (1, 0, 0):指数为 (2.718, 1, 1),总和为 4.718,得到 \mathbf{p} = (0.576, 0.212, 0.212) 和 J_{11} = 0.576 \times 0.424 = 0.244,后者约增大一万倍。根据 p_j(g_j - \bar g),饱和行中各分数梯度的数量级约为 10^{-5} 乘以 g_j 之间的差值。
实验 1 测量了随机行的效果。在 d_k = 128 下,使用 16 个键、5,000 次随机抽样,未缩放 softmax 的最大权重中位数为 0.978,平均熵为 0.28 奈特;缩放后分别为 0.224 和 2.36 奈特,而均匀行的熵为 \ln 16 = 2.77(图 6.3;末位数字随随机抽样变化)。缩放并非唯一措施:一些大型训练还在点积之前归一化 \mathbf{q} 和 \mathbf{k},即 QK 归一化,直接控制分数尺度;第 08 模块,第 7 节 将它作为稳定性措施讨论。
缩放的作用。左:\mathbf{q}\cdot\mathbf{k} 在 d_k = 2、16、128 下的叠加直方图,各元素具有单位方差,共用从 -40 到 40 的横轴;标准差分别为 1.4、4.0、11.3。右:在 d_k = 128 下,对查询和 16 个键进行 5,000 次抽样,绘制每行最大 softmax 权重的直方图。未缩放时集中在 1 附近,中位数 0.978;缩放后集中在 0.2 附近,中位数 0.225;横轴均为 0 到 1。数据来自实验 1。
因果掩码
从左到右生成时,模型不能看到将要预测的内容,因此位置 i 只能关注 j \le i 的位置。在 softmax 之前,将满足 j > i 的条目设为 S_{ij} = -\infty。由于 \exp(-\infty) = 0,未来位置的权重精确为零,并非仅仅很小,也没有梯度流过这些条目。掩码屏蔽对角线上方的 T(T-1)/2 个条目;第 i 行保留 i 个分数。
掩码使训练能够并行进行。位置 i 的输出只依赖 token 1, \dots, i,因此可以用它预测 token i + 1;所有位置同时这样做。对包含 T 个 token 的序列进行一次前向传播,就得到 T 个下一个 token 的预测,各自对应一个损失。第 04 模块,第 10 节 的解码器即使使用教师强制,也必须逐步计算,因为循环依赖仍然存在。
代码中的掩码可以是加性或布尔形式。加性掩码是 T \times T 矩阵:允许关注的位置为 0,禁止关注的位置为 -\infty(或该 dtype 最小的有限值),再将其加到 \mathbf{S} 上。布尔掩码则在允许关注的位置取 True。PyTorch 的 F.scaled_dot_product_attention 接受 attn_mask,也可以用 is_causal=True 自动构造因果掩码,使融合 kernel 跳过被屏蔽的一半计算(第 10 节)。
填充掩码。 不等长序列组成 batch 时,会填充到共同长度 T。填充的键位置必须对所有查询不可见,因此填充掩码是形状为 (B, 1, 1, T) 的布尔张量,在头和查询维度上广播;与因果掩码结合后成为 (B, 1, T, T)。填充的查询位置仍会计算输出,因为张量是矩形的,但这些输出没有意义,必须从损失中排除;通常将对应目标设为损失函数的 ignore_index。
import math, torch, torch.nn.functional as F

B, h, T, dk = 2, 8, 5, 32
q, k, v = (torch.randn(B, h, T, dk) for _ in range(3))
lengths = torch.tensor([5, 3])                         # sequence 2 ends in two pads
key_real = torch.arange(T) < lengths[:, None]          # (B, T)
pad = key_real[:, None, None, :]                       # (B, 1, 1, T)
causal = torch.ones(T, T, dtype=torch.bool).tril()     # (T, T), True = may attend
mask = causal & pad                                    # broadcasts to (B, 1, T, T)

y = F.scaled_dot_product_attention(q, k, v, attn_mask=mask)        # fused
s = q @ k.transpose(-2, -1) / math.sqrt(dk)                        # the same, by hand
y_hand = s.masked_fill(~mask, float("-inf")).softmax(dim=-1) @ v
数值安全。 用 \exp(s_j - m)/\sum_k \exp(s_k - m) 计算 softmax,其中 m = \max_k s_k。减去相同常数不改变结果,同时使所有指数的自变量不大于零,避免溢出;第 10 节 展示了不这样做的后果。另一种陷阱是所有键都被屏蔽的行:所有指数均为 0,softmax 出现 0 除以 0。手写实现返回 NaN,并向后续各层传播;某些融合 kernel 返回零(本模块所用 PyTorch 版本如此);若使用最小有限值构成加性掩码,则所有键得到相同分数,该行悄然变成所有值(包括填充值)的平均。三种行为都不能依赖。因果掩码下的左填充 batch 很容易出现这种情况:开头的填充查询只能看到填充键。应确保每个查询至少有一个有效键,或显式将这些行置零。
将分数除以 \sqrt{d_k},保持单位方差;否则 softmax 会饱和,其雅可比矩阵趋于零,传给查询和键的学习梯度也随之消失。
为什么当一个键控制一行时,到达 \mathbf{W}_Q 和 \mathbf{W}_K 的梯度几乎消失?
查看答案
该梯度通过 \partial\mathcal{L}/\partial\mathbf{s} = \mathbf{J}\mathbf{g} 和 \mathbf{J} = \operatorname{diag}(\mathbf{p}) - \mathbf{p}\mathbf{p}^\top,并且当 \mathbf{p} 接近独热时,\mathbf{J} 趋于零,无论 \mathbf{g} 是什么。
对于 d_k = 64 和单位方差条目,未缩放分数的标准差是多少?
查看答案
\sqrt{64} = 8。除以 \sqrt{d_k} 后为 1。
因果掩码删除了 T \times T 分数矩阵的多少个条目?
查看答案
满足 j > i 的上三角条目,共 T(T - 1)/2 个,占总计 T^2 个条目的一部分。例如 T = 5 时,25 个条目中屏蔽 10 个。
手算示例
取三个 token,d_k = d_v = 2。为清楚展示算术过程,直接给出投影向量,不再从嵌入计算:
分数,以及分数除以 \sqrt 2 = 1.414:
仅出现三个不同的缩放分数,因此三个指数适用于以下所有内容:e^{0} = 1、e^{0.707} = 2.028 和 e^{1.414} = 4.113。
使用因果掩码
使用因果掩码,第 1 行仅看到第 1 列,第 2 行看到第 1-2 列,第 3 行看到全部三列。
- 第 1 行 一个可见的分数,单个数字的 softmax 为 1。权重(1, 0, 0);输出 \mathbf{o}_1 = \mathbf{v}_1 = (1, 0)。
- 第 2 行 分数 (0, 0.707),指数 (1, 2.028),总和 3.028。权重 (0.330, 0.670, 0)。输出 0.330\,(1, 0) + 0.670\,(0, 2) = (0.330, 1.340)。
- 第 3 行 分数 (0.707, 0.707, 1.414),指数 (2.028, 2.028, 4.113),总和 8.169。权重 (0.248, 0.248, 0.503)。对于输出,保持指数非标准化并在最后除一次: [2.028\,(1, 0) + 2.028\,(0, 2) + 4.113\,(3, 3)]/8.169 = (2.028 + 12.339,\ 4.056 + 12.339)/8.169 = (14.367, 16.395)/8.169 = (1.759, 2.007)。
所以
第 3 行打印的权重加起来为 0.999,只是因为每个权重均四舍五入到小数点后三位;精确的权重加到 1。最后除一次可以完全避免权重四舍五入,这是 第 10 节 构建 FlashAttention 的形式。
token 3 的查询 (1, 1) 与自己的键匹配最好,所以输出偏向自己的值。token 1 则只能复制 \mathbf{v}_1,无论其查询和键是什么。
去掉掩码与缩放
- 第 1 行 分数 (0.707, 0, 0.707),指数 (2.028, 1, 2.028),总和 5.056。权重 (0.401, 0.198, 0.401)。输出[2.028\,(1, 0) + 1\,(0, 2) + 2.028\,(3, 3)]/5.056 = (8.112, 8.084)/5.056 = (1.604, 1.599)。
- 第 2 行 分数 (0, 0.707, 0.707),权重 (0.198, 0.401, 0.401)。输出[1\,(1, 0) + 2.028\,(0, 2) + 2.028\,(3, 3)]/5.056 = (7.084, 10.140)/5.056 = (1.401, 2.006)。
- 第 3 行 不变:权重 (0.248, 0.248, 0.503),输出 (1.759, 2.007)。
第 1 行和第 2 行的权重相互镜像,前两个条目交换,因为 \mathbf{Q} = \mathbf{K} 和交换 token 1 和 2 交换了它们的查询和键: \mathbf{q}_1\cdot\mathbf{k}_1 = \mathbf{q}_2\cdot\mathbf{k}_2、\mathbf{q}_1\cdot\mathbf{k}_2 = \mathbf{q}_2\cdot\mathbf{k}_1 和 \mathbf{q}_1\cdot\mathbf{k}_3 = \mathbf{q}_2\cdot\mathbf{k}_3。输出不同,因为 \mathbf{v}_1 和 \mathbf{v}_2 不同。第 3 行根本没有改变:掩码不会从最后一行中删除任何内容,而最后一行已经看到了每个键。
- 第 2 行 分数 (0, 1),指数 (1, 2.718),总和 3.718。权重 (0.269, 0.731, 0);输出 (0.269, 1.462)。
- 第 3 行 分数 (1, 1, 2),指数 (2.718, 2.718, 7.389),总和 12.826。权重 (0.212, 0.212, 0.576);输出 [2.718\,(1, 0) + 2.718\,(0, 2) + 7.389\,(3, 3)]/12.826 = (24.885, 27.603)/12.826 = (1.940, 2.152)。
去掉缩放后,每个分数差距增大 \sqrt 2 倍(第 3 行中,键 3 比其他键高 1,而非 0.707),权重更集中,输出更靠近最佳匹配的值:第 3 行中 \mathbf{v}_3 的权重从 0.503 升至 0.576,输出从 (1.759, 2.007) 移至 (1.940, 2.152)。即使 d_k = 2 时,效果也可见。d_k = 128 时,未缩放分数的分布范围是 d_k = 2 时的八倍(11.3 对 1.4),导致 第 2 节 所讨论的饱和。
几何形状
每个输出都是该查询可见的值向量的凸组合:权重非负且总和为 1。因此 \mathbf{o}_1 就是 \mathbf{v}_1 本身;\mathbf{o}_2 = 0.330\,\mathbf{v}_1 + 0.670\,\mathbf{v}_2 位于 \mathbf{v}_1 到 \mathbf{v}_2 的线段上,约为全程的三分之二;\mathbf{o}_3 位于三角形 \mathbf{v}_1\mathbf{v}_2\mathbf{v}_3 内,最靠近 \mathbf{v}_3(图 6.4)。分数只决定输出落在该区域的哪个位置。注意力能够混合值,却不能离开它们的凸包:它无法外推、放大值,或产生可见值所不包含的方向。因此,每个 Transformer 块都配有独立变换各位置的前馈网络,以及保留每个 token 自身向量的残差路径(第 5 节)。
手算示例的三个面板。(a) 3 \times 3 缩放分数矩阵,对角线上方三个单元置灰并标为 -\infty。(b) 因果权重矩阵 \mathbf{P},色阶 0–1,各单元标出三位小数。(c) x、y 轴范围为 -0.5–3.5,值向量 \mathbf{v}_1 = (1, 0)、\mathbf{v}_2 = (0, 2)、\mathbf{v}_3 = (3, 3) 组成浅色三角形,输出为空心点:\mathbf{o}_1 = (1, 0) 与 \mathbf{v}_1 重合,\mathbf{o}_2 = (0.330, 1.340) 位于线段 \mathbf{v}_1\mathbf{v}_2,\mathbf{o}_3 = (1.759, 2.007) 位于三角形内部。各值与 \mathbf{o}_3 的连线宽度正比于权重 0.248、0.248、0.503。
手算反向传播
取标量 \mathcal{L} = o_{3,2},即 token 3 输出的第二个分量(2.007),沿因果、缩放后的计算反向求梯度。一般规则来自 \mathbf{O} = \mathbf{P}\mathbf{V} 的逐行推导,以及 第 2 节 和 S_{ij} = \mathbf{q}_i\cdot\mathbf{k}_j/\sqrt{d_k}:
其中 g_{ij} = (\partial\mathcal{L}/\partial\mathbf{o}_i)\cdot\mathbf{v}_j、\bar g_i = \sum_k P_{ik}g_{ik}。被屏蔽条目的 P_{ij} = 0,因此不接收梯度。这里 \partial\mathcal{L}/\partial\mathbf{O} 只有第 3 行第 2 列为 1,其余为零,所以只有第 3 行贡献梯度。
- 值。 \mathbf{P}^\top\partial\mathcal{L}/\partial\mathbf{O} 选取 \mathbf{P} 的第 3 行:\partial\mathcal{L}/\partial\mathbf{V} 的第 2 列是 (0.248, 0.248, 0.503) 并且第 1 列为零。将 \mathbf{v}_j 的第二个分量移动 \epsilon 将 o_{3,2} 移动 p_j\epsilon。
- 权重。 \partial\mathcal{L}/\partial\mathbf{o}_3 = (0, 1),因此 g_j = v_{j,2} 和 \mathbf{g} = (0, 2, 3)。它们在当前权重下的平均值是\bar g = \sum_k p_kg_k = o_{3,2} = 2.007。
- 分数。 \partial\mathcal{L}/\partial s_{3j} = p_j(g_j - 2.007): 0.2483 \times (0 - 2.007) = -0.498, 0.2483 \times (2 - 2.007) = -0.002 和 0.5035 \times (3 - 2.007) = 0.500。正如 第 2 节 所承诺的那样,它们的总和为零。
- 查询。 \partial\mathcal{L}/\partial\mathbf{q}_3 = [-0.498\,(1, 0) - 0.002\,(0, 1) + 0.500\,(1, 1)]/1.414 = (0.002, 0.498)/1.414 = (0.001, 0.352)。查询 1 和 2 什么也接收不到,因为 \mathcal{L} 不依赖于第 1 行和第 2 行。
- 键。 \partial\mathcal{L}/\partial\mathbf{k}_j = (\partial\mathcal{L}/\partial s_{3j})\, \mathbf{q}_3/1.414 与 \mathbf{q}_3 = (1, 1): (-0.352, -0.352)、(-0.001, -0.001)和(0.354, 0.354)。
数字说明了公式所承诺的内容。提高 s_{33} 将权重移向 \mathbf{v}_3,其第二个分量 (3) 高于当前 2.007;提高 s_{31} 将其移向 \mathbf{v}_1,其第二个分量为 0;键 2 的值 2 几乎恰好位于当前平均值,因此它的分数几乎不重要。在查询中,提高第二个分量会增加与键 2 和 3 的匹配,其值具有较大的第二分量,但代价是键 1:梯度 0.352。提高第一个分量会增加与键 1 和 3 的匹配,其拉力(-0.498 和 +0.500)几乎完全抵消:梯度 0.001。 实验 1 通过有限差异和 PyTorch 的 autograd 确认每个数字。
这就是注意力的核心:可学习的软查找。其余设计是在组织多个这样的计算:并行的头(第 4 节)、与前馈网络交替组成的块(第 5 节)、位置信息(第 6 节),以及分块计算(第 10 节)。
每个输出行都是可见值向量的凸组合;分数、掩码和缩放只决定它在凸包中的位置。
为什么使用和不使用因果掩码时 token 3 的输出相同?
查看答案
掩码只屏蔽查询位置之后的键。最后一行后面没有键,所以它已经能看到全部键,权重和输出都不改变。
在未缩放的情况下,为什么 token 3 的输出会向 (3, 3) 移动?
查看答案
如果不除以 \sqrt 2,键 3 和其他两个键之间的分数差距会从 0.707 增长到 1,因此 softmax 将更多权重放在 \mathbf{v}_3 上(0.576 而不是 0.503),并且输出朝它移动。
为什么 \partial\mathcal{L}/\partial\mathbf{s}_3 总和必须为零?
查看答案
它是 softmax 雅可比矩阵作用于 \mathbf{g} 的结果,而该矩阵对称,行和与列和均为零。等价地,对三个分数加上相同常数,不改变权重,也就不改变 \mathcal{L}。
多头注意力和残差流
单个注意力头为每个查询提供一种键位置上的概率分布,捕获一种关系。多头注意力(multi-head attention)并行计算 h 个头,每个头有独立的投影,将输入映射到较窄的空间 d_k = d_v = d/h;然后拼接各头的输出,再用另一个矩阵混合:
其中 \mathbf{W}_Q^{(i)}, \mathbf{W}_K^{(i)}, \mathbf{W}_V^{(i)} \in \R^{d\times d_k},每个 \text{head}_i \in \R^{T\times d_k},分号表示沿特征维度拼接,\mathbf{W}_O \in \R^{d\times d}。若 d = 4{,}096、h = 32,每个头就在 128 维空间中工作。
为什么使用多个头。 一个 softmax 只有总量为 1 的权重可分配。如果某位置需要两处信息(用于语法判断的前一个单词、此前提到的名字),单个头只能返回二者的加权平均;第 3 节 表明,平均值位于两者之间,并不等于任何一个值。使用 h 个头后,该位置可因 h 种不同原因关注 h 个位置。成本不增加:由于 hd_k = d,无论 h 取何值,投影参数共 d \times d,分数计算共 h \cdot T^2 \cdot d_k = T^2 d 次乘加,与一个全宽头相同。区别是每个头在 d_k 维而非 d 维空间中比较查询和键。
形状,一步一步
代码不会为每个头创建独立对象。一个 d \times d 矩阵同时计算所有头的查询(各 \mathbf{W}_Q^{(i)} 是它的列块),随后 reshape 将结果拆分到各头,头索引成为一个 batch 维度。下面的显式实现逐行对应 第 12 节 的注意力类,只是直接构造分数,而非调用融合的 F.scaled_dot_product_attention:
import math, torch, torch.nn as nn

B, T, d, h = 2, 16, 256, 8
dk = d // h                                                    # 32
x = torch.randn(B, T, d)
wq, wk, wv, wo = (nn.Linear(d, d, bias=False) for _ in range(4))

q = wq(x).view(B, T, h, dk).transpose(1, 2)                    # (B, h, T, dk)
k = wk(x).view(B, T, h, dk).transpose(1, 2)
v = wv(x).view(B, T, h, dk).transpose(1, 2)
s = q @ k.transpose(-2, -1) / math.sqrt(dk)                    # (B, h, T, T)
future = torch.triu(torch.ones(T, T, dtype=torch.bool), diagonal=1)
p = s.masked_fill(future, float("-inf")).softmax(dim=-1)       # (B, h, T, T)
y = (p @ v).transpose(1, 2)                                    # (B, T, h, dk), not contiguous
out = wo(y.reshape(B, T, d))                                   # (B, T, d)
逐步,对于 B 序列的 batch:
wq(x)将 (B, T, d) 映射到 (B, T, d):所有头的查询并排。.view(B, T, h, dk)将最后一个维度分割为 h 个 d_k 块;没有数据移动。.transpose(1, 2)给出 (B, h, T, d_k):每个头现在是一个单独的 batch 条目。q @ k.transpose(-2, -1)给出分数,(B, h, T, T)。矩阵乘法将每个前导维度视为 batch,因此所有 B \times h 分数矩阵都来自一次批量乘法。p @ v给出每个头的输出,(B, h, T, d_k)。.transpose(1, 2)返回到 (B, T, h, d_k),并且.reshape(B, T, d)连接头。它必须是reshape,而不是view:转置后,内存仍然是逐个头布局的,并且合并头尺寸违反了view的步幅兼容性条件(此处引发RuntimeError)。非连续张量仍然可以支持其他兼容的视图。reshape在可能的情况下返回视图,并在必要时进行复制。wo将 (B, T, d) 映射到 (B, T, d)。
B = 2、T = 16、d = 256 和 h = 8,因此 d_k = 256/8 = 32: (2, 16, 256) \to (2, 16, 8, 32) \to (2, 8, 16, 32) \to 分数 (2, 8, 16, 16) \to (2, 8, 16, 32) \to (2, 16, 8, 32) \to (2, 16, 256),并且 \mathbf{W}_O 保持 (2, 16, 256)。分数张量包含 2 \times 8 \times 16 \times 16 = 4{,}096 个数字:每个序列和头都有一个 16 \times 16 矩阵。 实验 1 准确地打印这些形状。
具有 B=2、T=16、d=256 和八个头的多头注意力。投影张量分裂成形状 (2,8,16,32)。每个头计算自己的 16\times16 得分矩阵和加权值。合并头输出会恢复输出投影之前的形状 (2,16,256)。
连接,然后投影:每个头写入的总和
将 \mathbf{W}_O 拆分为 h 个 d_k 连续行的块,\mathbf{W}_O^{(1)}, \dots, \mathbf{W}_O^{(h)},每个 d_k \times d。块矩阵乘法给出
因为 \text{head}_i 的元素只乘以 \mathbf{W}_O 中与之对应的行。拼接只是组织数据的方式:每个头通过自己的切片 \mathbf{W}_O^{(i)},将 d_k 维结果写入 d 维输出,然后将各头的写入相加。
d = 4、h = 2、d_k = 2,头在一个位置输出 \mathbf{h}_1 = (1, 2) 和 \mathbf{h}_2 = (0, 1)。
对于 \mathbf{W}_O = \mathbf{I}_4,串联得到 (1, 2, 0, 1)\,\mathbf{I}_4 = (1, 2, 0, 1)。每头,\mathbf{h}_1 乘以 \mathbf{I}_4 的第 1–2 行为 (1, 2, 0, 0),\mathbf{h}_2 乘以第 3–4 行为 (0, 0, 0, 1),总和为(1, 2, 0, 1)。
单位矩阵使每个头只写入“自己的”两个坐标,这是特殊情形。若矩阵各行为 (1, 0, 0, 1)、(0, 1, 1, 0)、(1, 1, 0, 0)、(0, 0, 1, 1),拼接后得到 1\,(1, 0, 0, 1) + 2\,(0, 1, 1, 0) + 0\,(1, 1, 0, 0) + 1\,(0, 0, 1, 1) = (1, 2, 3, 2);头 1 写入 (1, 2, 2, 1),头 2 写入 (0, 0, 1, 1),相加仍为 (1, 2, 3, 2)。两个头都写入每个坐标;各自的 \mathbf{W}_O 切片决定写入方向。
每个头的两个低秩电路
根据层的输入,写入位置 t 处的查询和位置 s 处的键之间头 i 的分数:
这是关于两个输入的双线性形式,矩阵 \mathbf{W}_Q^{(i)}\mathbf{W}_K^{(i)\top} 的形状为 d \times d。由于中间经过 d_k 维空间,其秩至多为 d_k。Elhage 等(2021)称其为头的 QK 电路,它决定该头关注哪里。同理,头对位置 t 的写入为
即将加权输入通过形状为 d \times d 的矩阵 \mathbf{W}_V^{(i)}\mathbf{W}_O^{(i)},其秩至多为 d_k。这就是 OV 电路,它决定关注之后写入什么。因此,每个头从输入的 d_k 维子空间读取,并写入输出的 d_k 维子空间:d = 4{,}096、h = 32 时,只有 4,096 维中的 128 维。两个电路独立,所以头可根据 token 的一种属性(如位置)选择关注位置,再复制另一种属性(如身份);下文的归纳头正是如此。
计数
四个投影中的每一个(所有头的 \mathbf{W}_Q、\mathbf{W}_K 和 \mathbf{W}_V 以及 \mathbf{W}_O)均为 d \times d,因此注意力层具有 4d^2 参数,无论 h 是什么。对于每个 token,将 d 向量乘以 d \times d 矩阵需要 d^2 次乘加,或 2d^2 次浮点运算(各一次乘法和一次加法),因此四个投影的成本为 8d^2 次浮点运算。上下文 t 处的 token,关注 t 位置,为其 \mathbf{Q}\mathbf{K}^\top 行支付 2td 更多费用(每个 h 头中长度 d_k 的 t 点积, thd_k = td 乘加)和 2td 用于混合值:4td。对 T token 序列求和,即 O(T^2 d),其长度是二次方,是 Transformer 最著名的成本。 第 11 节 将这些计数转换为该系列使用的 FLOP 约定。
对于长度为 4,096 个 token 的上下文的最后一个 token,投影成本为 8d^2 = 8 \times 4{,}096^2 = 134{,}217{,}728 FLOP,约 134 MFLOP;分数与值混合成本为 4td = 4 \times 4{,}096 \times 4{,}096 = 67{,}108{,}864,约 67 MFLOP。即使此时,投影仍比注意力本身贵两倍。对整个因果掩码序列取平均时,位置 t 只看到 t 个键,第二项约减半至 34 MFLOP(第 11 节 推导该平均值)。
残差流
从一个位置的角度看整个模型。它的向量以 token 嵌入开始,\mathbf{x}_0。每个注意力层和每个前馈网络通过归一化从该向量读取,并将其输出添加回来:
其中 F_l 表示第 l 个子层,可为注意力或前馈网络(注意力还读取其所关注位置的向量)。最后一层之后,将最终向量归一化并线性读出 logits。Elhage 等(2021)称这一持续累加的向量为残差流(residual stream)。展开得 \mathbf{x}_L = \mathbf{x}_0 + \sum_l F_l(\cdot):最终状态是嵌入加上各层写入的全部更新。
有两个结果决定了如何理解 Transformer。各层仅通过流进行通信:注意力头从它所关注的位置的流中读取数据并将其写入到其自己位置的流中,前馈网络在一个位置上进行读取和写入,并且没有其他内容在层之间传递。流的 d 维度是共享资源:每个层的写入必须适合每个位置相同的 d 数字,以及前面层写入和后面层需要的所有内容。 第 5 节将残差连接写为块的方程,并解释了为什么归一化位于分支而不是流上。
两个前置归一化块从同一个残差流读取,并向其中添加更新。归一化位于更新分支上。各注意力头通过自己的输出投影块 \mathbf{W}_O^{(i)} 写入;FFN 写入另一个更新。最终归一化与词表投影将累积的残差流转换为 logits。
头学习什么
训练后的模型包含行为可辨认的头。前一 token 头在每个位置从 t 关注到 t - 1。对训练模型的分析还发现,有的头关注匹配括号,有的头从单词关注到句子主语。理解这些头的行为,本身就是一个研究领域。
最容易理解的例子是归纳头(induction head)(Olsson 等,2022):它将“… A B … A”补全为 B。例如读到“P-104 pump … P-104”后预测“pump”。这一电路需要分属两层的两个头。较早层的前一 token 头,将前一个 token 写入各位置的残差流;于是 B 位置包含“我的前一个 token 是 A”。在后面再次出现的 A 处,归纳头的查询寻找“前一个 token 为 A”的位置,并通过 QK 电路匹配第一个头写入 B 位置的键。它关注该位置,再通过 OV 电路将 B 的身份复制到残差流,提高 B 的 logit。第二个头的键依赖第一个头搬运的信息。这一特定电路需要连续两个注意力阶段,但不能据此断言一层无法完成任何复制任务。
归纳头是从上下文复制名称、标识符和重复短语的通用机制。Olsson 等报告,它们在训练早期的一个狭窄窗口中突然形成,损失曲线出现一个凸起,上下文学习也在同一时刻改善。实验 6 在重复序列上训练两层模型,找到这两类头(图 6.7);第 12 节 的字符级模型学习复制标识符时,也出现类似的突然变化。
谨慎解读注意力图。 注意力图显示头从哪里读取,无法单独说明为什么读取,也无法说明上层如何使用这些信息。Jain 和 Wallace(2019)发现,注意力权重往往与其他输入重要性指标不一致,而且差异很大的注意力模式可以产生相同预测。判断某个头的作用需要干预:将其输出置零,重新测量损失,检查归因于该头的行为是否消失。实验 6 就进行了这种测试。
实验 6 的两层模型在长度为 n=31 的重复片段上测得的注意力图。第 0 层最强的前一 token 头关注紧邻对角线下方的位置。第 1 层最强的归纳头在后半段沿 \text{key}=\text{query}-n+1 关注前半段。标注概括查找模式;实验中的消融检验各头对预测的贡献。
各层通过读取同一个残差流并向其中添加更新来通信。每个头通过 QK 电路选择关注位置,通过 OV 电路选择写入内容;两者的秩均至多为 d_k。
B = 4、h = 12、T = 128 的注意力权重的形状是什么?
查看答案
(4, 12, 128, 128):每个序列和每个头的一个 128 \times 128 权重矩阵。
为什么代码在 transpose(1, 2) 之后调用 .reshape 而不是 .view?
查看答案
转置只改变步幅,不移动数据。合并这些头维度不满足 view 的步幅兼容条件,因此需要复制。reshape 完成该复制;若步幅兼容,则即使张量不连续,它也可以返回视图。
d = 4{,}096 与 h = 32 构成的 \mathbf{W}_Q^{(i)}\mathbf{W}_K^{(i)\top},最大可能的秩是多少?
查看答案
d_k = 4{,}096/32 = 128:4{,}096 \times 4{,}096 的乘积经过一个 128 维中间空间。
Transformer 块:残差、归一化与前馈网络
Transformer 层,也称为块(block),依次包含两个子层:在位置之间搬运信息的多头注意力,以及在各位置内部变换信息的前馈网络(feed-forward network,FFN)。每个子层都经过归一化读取 第 4 节 的残差流,再将输出加回:
这是前置归一化(pre-norm)块:归一化位于子层之前的分支上。原始论文则将归一化放在残差相加之后的主路径上,即后置归一化(post-norm)块:
这一差别看似细微,却会影响深层网络的训练稳定性和所需的训练措施。约自 2020 年起,前置归一化成为常见配置(图 6.8)。
后置与前置归一化块并列展示,计算方向由下至上。左侧后置归一化:\mathbf{x} → 注意力 → 圆圈加号(接收从 \mathbf{x} 的跳连)→ Norm → FFN → 圆圈加号 → Norm → 输出;两个 Norm 都位于粗线表示的主路径上。右侧前置归一化:主路径从 \mathbf{x} 直达输出,标为“恒等路径:不经过 Norm”;两条分支分别经过 Norm 和注意力、Norm 和 FFN,再在各自的加号处返回。
前置归一化为何有助于稳定训练
沿一个位置的向量追踪前置归一化堆栈:用 \mathbf{x}_l 表示进入子层 l 的残差流,用 F_l 表示该子层。每一步为 \mathbf{x}_{l+1} = \mathbf{x}_l + F_l(\operatorname{Norm}(\mathbf{x}_l))。从层 l 到最上层 L 反复展开,得到
对 \mathbf{x}_l 求导(\mathbf{x}_m 中每个满足 m > l 的项也依赖 \mathbf{x}_l,导数中包含这条依赖):
层 l 处的损失梯度等于 \partial\mathcal{L}/\partial\mathbf{x}_L 乘以上述矩阵,因此恒等项直接贡献 \partial\mathcal{L}/\partial\mathbf{x}_L,不受子层具体计算的影响。这条不含权重或归一化的恒等路径,即使在子层随机初始化时,也能将输出梯度传到每一层。
后置归一化中,\mathbf{x}_{l+1} = \operatorname{Norm}(\mathbf{x}_l + F_l(\mathbf{x}_l)),链式法则给出
其中 \mathbf{J}_{\text{Norm}} 是该层输入处归一化运算的雅可比矩阵。从顶部到层 l 的梯度要经过 L - l 个这样的因子。每个因子都按该层激活的尺度进行缩放,深层乘积可能显著增大或减小。Xiong 等(2020)表明,初始化时,后置归一化 Transformer 靠近输出的参数梯度较大,不随深度增大而缩小;前置归一化则会缩小。因此,从第一步就采用较大学习率时,后置归一化模型可能不稳定。原始论文在前 4,000 步逐渐提高学习率,即预热(warmup)(第 02 模块,第 9 节)。前置归一化往往降低预热需求,Xiong 等也展示了无需预热的训练配置。两种布局都不能保证在任意学习率下稳定;深度、初始化和其他训练配置仍有影响(练习 5)。
回顾归一化
第 02 模块,第 10 节 已介绍归一化层、算例及 PyTorch 实现。LayerNorm 减去均值、除以标准差,再应用可学习的缩放和平移,即 \operatorname{LayerNorm}(\mathbf{x}) = \boldsymbol{\gamma}\odot(\mathbf{x} - \mu)/\sigma + \boldsymbol{\beta}。均方根归一化(RMSNorm)(Zhang 和 Sennrich,2019)省去减均值和平移,在 Transformer 中计算更便宜,效果相当:
本模块还需用到 RMSNorm 的尺度不变性。对 c > 0,有 \tfrac1d\sum_j (cx_j)^2 = c^2\cdot\tfrac1d\sum_j x_j^2,因此
当 \epsilon 可忽略时,上式成立。前置归一化块的各子层只读取残差流的“方向”,不读取其大小。
前置归一化的代价
残差流本身从不归一化。每个子层都向其中添加更新,因此深层前置归一化模型的残差流范数往往随深度增长。同样大小的写入,对较长向量方向的改变小于对较短向量的改变。
取两个方向相同的残差流,均方根(RMS)大小分别为 1 和 8。由于尺度不变性,它们给子层的归一化输入相同,因此子层计算相同的更新。设更新的 RMS 为 1,且与原残差流正交。
- 短流:垂直边的比例为 1 : 1,因此流转动 \arctan(1/1) = 45°。
- 长流:比率1 : 8,所以转了\arctan(1/8) = 7.1°。
下一次 RMSNorm 只保留方向,因此同样的写入对较长残差流的方向影响约小六倍(45/7.1 = 6.3)。除非后续层学会更大的输出,否则它们的影响会减弱。
由此引出两项措施。最后一个块之后、输出词表投影之前,需要最终归一化(第 12 节 代码中的 self.norm);否则 logits 会随残差流大小一起缩放。GPT-2(Radford 等,2019)还将写入残差流的层的初始权重按 1/\sqrt{N} 缩放,N 是残差子层数。N 次独立写入、每次方差 \sigma^2,累加后方差为 N\sigma^2;将各次写入的方差除以 N,即可令总方差保持为 \sigma^2,不随深度增长。
前馈网络
FFN 独立应用于每个位置。将一个位置的向量写为一列,如 nn.Linear 存储它,
其中 \phi 为非线性函数(原始模型使用 ReLU,BERT 和 GPT-2 使用 GELU)。原始模型的内部宽度为 d_{\text{ff}} = 4d,每层有 2 \times d \times 4d = 8d^2 个参数,是注意力 4d^2 的两倍。注意力在位置之间搬运信息;FFN 在各位置内部变换信息。
FFN 作为键值记忆。 \mathbf{W}_1\mathbf{x} 的第 i 个元素为 \mathbf{k}_i\cdot\mathbf{x},其中 \mathbf{k}_i 是 \mathbf{W}_1 的第 i 行;又有 \mathbf{W}_2\mathbf{a} = \sum_i a_i\mathbf{v}_i,其中 \mathbf{v}_i 是 \mathbf{W}_2 的第 i 列。合并得到:
每个隐藏单元都是一个记忆槽:输入匹配它的键时激活,并按激活强度将对应值方向添加到残差流。与注意力不同,这里的键和值是参数,\phi 也不在各槽之间归一化,所以可以同时激活任意数量的槽。Geva 等(2021)在训练后的语言模型中发现,键会响应可辨认的输入模式:低层偏表面模式,高层偏语义模式;对应的值则提高合理后续 token 的概率。Meng 等(2022)将实体事实的检索定位到中间层 FFN,并通过修改一个 FFN 的权重编辑单个事实。因此,知识似乎存储在 FFN 中:这是对训练模型的经验解释,并非架构本身保证的性质。
SwiGLU
当前模型使用门控 FFN (Shazeer 2020):
其中 \sigma 是逻辑 sigmoid(第 02 模块,第 5 节 比较 SiLU、ReLU 和 GELU)。单元 i 计算 \operatorname{SiLU}(\mathbf{k}_i\cdot\mathbf{x})\,(\mathbf{u}_i\cdot\mathbf{x}),\mathbf{u}_i 是 \mathbf{W}_3 的第 i 行。门与一个可正可负的线性分支相乘,因此各单元可随输入开启、关闭,或产生负输出。Shazeer 在参数量和计算量匹配的条件下比较门控变体,报告其留出集对数困惑度低于 ReLU 或 GELU FFN,并承认尚未解释为何这些架构有效。这个经验结果后来在许多模型中得到验证。
三个矩阵共有 3\,d\,d_{\text{ff}} 个参数;要保持 8d^2 的预算,需要 d_{\text{ff}} = \tfrac83 d。
在 d = 4{,}096 处:
- \tfrac83 \times 4{,}096 = 10{,}922.7。
- 四舍五入为 256 的倍数,适合硬件:43 \times 256 = 11{,}008,即 Llama-2-7B 的 d_{\text{ff}}。
- 每层参数:3 \times 4{,}096 \times 11{,}008 = 135{,}266{,}304,或 135.3M。
- 4d = 16{,}384 处的 GELU FFN:2 \times 4{,}096 \times 16{,}384 = 134{,}217{,}728 或 134.2M。
宽度取整仅增加 0.8% 的参数;除此之外,两种 FFN 的预算基本相同。
前置归一化保留从损失到各层的恒等路径,有助于训练深层堆栈;代价是未经归一化的残差流会增大,因此输出前需要最终归一化。
前置归一化模型还必须在哪里添加一次归一化,为什么?
查看答案
最后一个块之后、输出词表投影之前。前置归一化不归一化残差流本身;若无最终归一化,logits 会随残差流的大小缩放。
为什么 SwiGLU 使用大约 8d/3 的 d_{\text{ff}} 而不是 4d?
查看答案
它有三个 d \times d_{\text{ff}} 矩阵而不是两个。对于 d_{\text{ff}} = 8d/3,计数为 3 \times d \times \tfrac83 d = 8d^2,与 4d 处的二矩阵 FFN 相同。
位置
至此定义的注意力没有顺序概念。用置换矩阵 \mathbf{P} 打乱输入行。投影逐行计算,所以查询、键、值变为 \mathbf{P}\mathbf{Q}、\mathbf{P}\mathbf{K}、\mathbf{P}\mathbf{V},分数变为 \mathbf{P}\mathbf{Q}\mathbf{K}^\top\mathbf{P}^\top,只是重新排列旧分数。逐行 softmax 与这种排列可交换;结合 \mathbf{P}^\top\mathbf{P} = \mathbf{I},输出就是 \mathbf{P} 乘以原输出。因此,无掩码注意力具有置换等变性(permutation equivariance)(练习 4 给出完整证明)。逐位置计算的 FFN 和归一化也如此,所以整个堆栈会将“阀门隔离泵”当作“泵隔离阀门”的位置重排。
因果掩码部分打破这种对称性:位置 t 恰好看到 t 个 token,因此均匀权重的头在位置 1 返回 \mathbf{v}_1,在位置 100 返回前 100 个值的平均。Haviv 等(2022)发现,即使没有位置编码,仅解码器模型仍能借此学习位置。以下方案显式加入顺序:输入处加一次向量(绝对位置),或在每个注意力层中改变计算,使分数依赖位置偏移(相对位置)。
正弦编码
原始的 Transformer 在输入处向位置 t 的 token 嵌入添加一次固定向量:
每对维度对应同一频率的正弦与余弦,频率从 \omega_0 = 1(波长约 2\pi \approx 6.3 个位置)按几何比例下降至 1/10000(波长接近 2\pi\times 10{,}000)。高频维度对区分邻近位置,低频维度对在较粗尺度上定位 token,类似时钟的不同指针(图 6.9)。
d = 64 正弦位置编码 PE(t, j) 的热图,纵轴为位置 t = 0, \dots, 127,横轴为维度 j = 0, \dots, 63,色阶为 -1–1。左侧高频维度形成密集条纹,向右频率降低,条纹变宽。
该设计具有论文中未证明的属性:t + k 的编码是 t 编码的线性函数。角加法公式给出:
于是,一对一对地,
为每对维度堆叠一个 2\times2 旋转矩阵,得到 PE(t+k) = \mathbf{M}_k\,PE(t);矩阵 \mathbf{M}_k 只依赖偏移量 k,不依赖 t。因此,层可以通过适用于各位置的线性映射,学习关注“前面 k 个位置”。
当 d = 4 时,频率为 \omega_0 = 10000^{0} = 1 和 \omega_1 = 10000^{-2/4} = 0.01。
- PE(0) = (\sin 0, \cos 0, \sin 0, \cos 0) = (0, 1, 0, 1)。
- PE(1) = (\sin 1, \cos 1, \sin 0.01, \cos 0.01) = (0.841, 0.540, 0.010, 1.000)。
- PE(2) = (\sin 2, \cos 2, \sin 0.02, \cos 0.02) = (0.909, -0.416, 0.020, 1.000)。
检查第一对上的 k = 1 的移位,\omega = 1:
第一对 PE(2)。对于每个 t,相同的矩阵采用第一对 PE(t) 到 PE(t+1) 的第一对。
学习绝对位置
GPT-2 和 BERT 则为每个位置学习一个向量,构成一直覆盖到训练长度的表。GPT-2 最小模型的位置表有 1{,}024 \times 768 = 786{,}432 个参数;BERT 有 512 行。训练长度之外没有对应条目:GPT-2 的第 1,025 个位置没有行;即使表更长,超出训练序列的行也未受训练。可学习绝对位置无法外推(练习 7)。
旋转位置编码
当前模型常用旋转位置编码(rotary position embedding,RoPE)(Su 等,2021)。它不向输入添加向量,而是在每个注意力层投影之后,将查询和键的 (q_{2i}, q_{2i+1}) 个维度两两配对,并按与位置成比例的角度旋转各对:
查询位于 t;位置 s 的键同样按 s\theta_i 旋转。值不旋转。
证明只依赖相对偏移。 将一对维度表示为复数 z = x_{2i} + \mathrm{i}\,x_{2i+1}。需要两个事实。
- 二维点积是共轭乘积的实部。 对于 a 和 b 对, a\,\overline{b} = (a_x + \mathrm{i}a_y)(b_x - \mathrm{i}b_y) = (a_xb_x + a_yb_y) + \mathrm{i}(a_yb_x - a_xb_y),所以 \operatorname{Re}(a\,\overline{b}) = a_xb_x + a_yb_y。
- 旋转 \varphi 是乘以 e^{\mathrm{i}\varphi}。 (x + \mathrm{i}y)(\cos\varphi + \mathrm{i}\sin\varphi) = (x\cos\varphi - y\sin\varphi) + \mathrm{i}(x\sin\varphi + y\cos\varphi),即上面的矩阵。
因此 i 对对分数有贡献
这里使用 \overline{e^{\mathrm{i}\varphi}} = e^{-\mathrm{i}\varphi}。右边只通过 t - s 依赖位置。对 d_k/2 对求和后,\mathbf{q}'_t\cdot\mathbf{k}'_s 只依赖 \mathbf{q}、\mathbf{k}、t - s;相对位置无需额外参数即可进入分数。练习 6 给出同一证明的矩阵形式。
取d_k = 2,因此存在一对\theta_0 = 10000^{0} = 1和\mathbf{q} = (1, 0)、\mathbf{k} = (0, 1)。
- t 处的旋转查询:(\cos t - 0, \sin t + 0) = (\cos t, \sin t)。
- s 处的旋转键:(0 - \sin s, 0 + \cos s) = (-\sin s, \cos s)。
- 得分:-\cos t\sin s + \sin t\cos s = \sin(t - s)。
因此 (t, s) = (3, 1) 给出 \sin 2 = 0.909; (7, 5) 给出相同的 0.909; (1, 3) 给出 \sin(-2) = -0.909; (5, 5) 给出 0。相等的偏移量,相等的分数。 t - s 的符号很重要,因为 \mathbf{q} \neq \mathbf{k}: RoPE 编码方向和距离。
频率有什么作用
RoPE 没有参数,也不旋转值,因为位置应改变查询查找哪里,而非返回什么。旋转为正交变换,所以 \mathbf{q}、\mathbf{k} 的范数和分数尺度不变。高频对(较小 i)编码精细位置,低频对编码较粗位置。
d_k = 4 和基数 10,000 给出 \theta_0 = 1 和 \theta_1 = 10000^{-2/4} = 0.01。取\mathbf{q} = \mathbf{k} = (1, 0, 1, 0),因此每对是z = 1和z_q\overline{z_k} = 1;对 i 在偏移量 \Delta = t - s 处贡献 \cos(\Delta\theta_i),并且
\Delta = 0: 1 + 1 = 2.000。 \Delta = 1: 0.540 + 1.000 = 1.540。 \Delta = 2: -0.416 + 1.000 = 0.584。 \Delta = 10: -0.839 + 0.995 = 0.156。 \Delta = 100: 0.862 + 0.540 = 1.403。 \Delta = 300: -0.022 - 0.990 = -1.012。
高频对每约 6.3 个 token 重复一次;低频对在数百个 token 的范围内缓慢变化。两者共同区分近距离与远距离偏移。
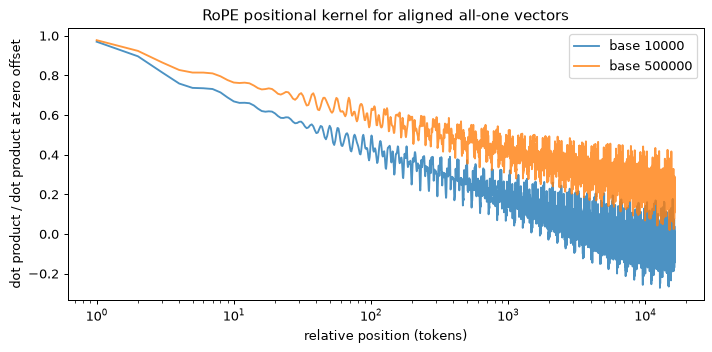
维度对较多时,高频振荡往往相互抵消;对于对齐的 \mathbf{q} 和 \mathbf{k},分数随偏移增大而衰减,并伴有波动。Su 等称之为远距离衰减。
取 \mathbf{q} = \mathbf{k} = 全一,d_k = 128,基数为 10,000。每对都是 z = 1 + \mathrm{i},因此 z_q\overline{z_k} = (1+\mathrm{i})(1-\mathrm{i}) = 2 和对 i 贡献 2\cos(\Delta\theta_i)。在 \Delta = 0 处,64 对给出 128。除以 128,标准化分数为 \Delta = 1 处的 0.970、16 处的 0.620、128 处的 0.333、1,024 处的 0.204 和 4,096 处的 -0.053。 实验 2 计算整条曲线。以 500,000 为基数时,衰减速度较慢:相同的计算得出 0.383 为 4,096。
RoPE 相对于偏移量的得分:\mathbf{q} = \mathbf{k} = 全 1 和 d_k = 128 的归一化得分 \mathbf{q}'\cdot\mathbf{k}'/128(其在偏移量 0 处的值为 1),针对 \Delta 绘制对数轴从 1 到 16,384。实线:基数 10,000;虚线:基数 500,000; 0 处的水平参考线。数据来自 实验 2。
低频端对长上下文尤其重要。维度对 i 每 2\pi/\theta_i 个 token 转一整圈,这就是它的波长。当 d_k = 128、基数为 10,000 时,波长从第 0 对的 2\pi/1 = 6.28 个 token,增长到第 63 对的 2\pi \times 10000^{126/128} = 54{,}410 个 token。64 对中有 18 对(46 到 63)的波长超过 4,096 个 token,因此训练长度为 4,096 的模型从未见它们完成整圈旋转。扩展上下文时,这些对将遇到未见过的角度。
ALiBi
ALiBi(Attention with Linear Biases,带线性偏置的注意力;Press 等,2022)不使用位置向量。头 h 给每个分数添加与距离成比例的固定惩罚:
斜率 m_h 构成几何序列;8 个头时为 \tfrac12, \tfrac14, \dots, \tfrac1{256}。大斜率头主要关注局部,小斜率头可以看得更远(图 6.11)。
八个头的斜率从 2^{-1} 到 2^{-8}。从分数中减去惩罚,等价于将该键未归一化的权重乘以 e^{-\text{penalty}}。
- 距离 100,头 1(m = 1/2):惩罚为 50,乘数 e^{-50} \approx 2\times10^{-22},该键几乎不可见。
- 距离 100,头 8(m = 1/256):惩罚为 100/256 = 0.39,乘数 e^{-0.39} = 0.68,该键只受到很小的折减。
- 距离 1,000,头 8:罚分 3.9,系数 e^{-3.9} = 0.020。
即使是看得最远的头,1,000 个 token 之前的键,其原始分数也须比近处键高约 3.9,才能与之竞争。
ALiBi 偏见。左:斜率 1/2 的 12\times12 偏置矩阵,由 -m(t - s) 阴影的下三角形,从对角线上的 0 到左下角的 -5.5,以及掩码的上三角形。右:从 0 到 100 的距离的偏差为斜率 1/2, 1/4, \dots, 1/256 的八条直线,垂直轴上从 -50 到 0。
ALiBi 可外推到训练长度之外,因为任意距离都有明确定义的偏置,而且远距离受到很大惩罚,影响很小。这也是它的代价:近因偏置由设计固定,原始分数相同时,远处 token 永远不及近处 token 重要。
扩展已训练的上下文
RoPE 模型超过训练长度时性能下降,因为低频对会遇到未见过的角度。下面用扩展因子 \kappa = L_{\text{target}} / L_{\text{train}}(写成 \kappa,因为 s 已用于键位置)介绍三种方法。
位置插值(position interpolation)(Chen 等,2023)将各位置除以 \kappa,使所有角度 t\theta_i/\kappa 保持在训练时见过的范围内,再通过短期微调让模型适应。代价是分辨率:相邻 token 的角度差在所有维度对上都缩小 \theta_i/\kappa,包括高频对,因而精细位置变得模糊。
NTK 感知缩放(于 2023 年非正式提出;YaRN 论文记录了这一点)反而提高了基数,因此最慢的对恰好减慢了 \kappa,而最快的对根本没有减慢。最慢的频率是\theta_{\text{last}} = b^{-(d_k-2)/d_k}。要求 b'^{-(d_k-2)/d_k} = b^{-(d_k-2)/d_k}/\kappa 并将两边同时求幂 -d_k/(d_k-2) 给出
而 \theta_0 = b'^{0} = 1 不变。其间的对被 1 和 \kappa: \theta'_i = \theta_i\,\kappa^{-2i/(d_k-2)} 之间的因子减慢。
\kappa = 4、d_k = 128、b = 10{,}000: b' = 10{,}000 \times 4^{128/126} = 10{,}000 \times 4.089 = 40{,}890。对 63 的频率恰好下降了 4,对 0 根本没有下降,对 32 的频率下降了 4^{64/126} = 2.02。
YaRN(Peng 等,2024)按波长处理:对波长超过训练上下文的维度对按 \kappa 插值,高频对保持不变,中间用斜坡过渡,并对注意力 logits 应用小幅温度调整。当前也有模型从训练之初就使用更大的基数;Llama 3 使用 500,000(Grattafiori 等,2024)。第 07 模块,第 9 节 讨论用户面对的上下文窗口,第 08 模块,第 14 节 讨论长上下文中期训练。
通过波长看到的上下文扩展。每 RoPE 对 i = 0, \dots, 63 (d_k = 128) 一根柱,其波长 2\pi/\theta_i 的高度 \log_{10},水平线位于 4,096(“训练上下文”)和 16,384(“目标”)上下文”)。每条三个 token:原始(基础 10^4);使用 \kappa = 4 进行位置插值,每个柱由 \log_{10}4 升高; NTK 感知基数 40,890,慢速对提升至 \log_{10}4,最快对不变。文中讨论了 YaRN 的独立波长相关斜坡;这里没有绘制。
RoPE 按与位置成比例的角度旋转查询与键的维度对,使分数只依赖相对偏移。训练时未完成整圈旋转的低频对,是扩展上下文时容易失效的部分,也是扩展方法重点处理的部分。
为什么这些值没有旋转?
查看答案
位置应该改变查询查找的位置,而不是返回的内容。旋转值将使输出取决于每个键的绝对位置。
基数为 10,000、训练长度为 4,096 个 token 的模型,在长度 16,384 下运行。哪些维度对会遇到训练时未见过的角度?
查看答案
波长超过 4,096 个 token 的低频对:在 d_k = 128 下,64 对中有 18 对,即第 46 到 63 对。更高频的对在训练中已经完成整圈旋转,因此见过各种角度。
哪个 ALiBi 头的行为最像本地窗口?
查看答案
斜率最大的头 1/2:20 个 token 之前的键,权重已乘以 e^{-10}。
模型的三种形状
同一个块可以通过三种方式连接。这三种形状的不同之处在于哪些位置可以关注哪些位置,以及它们被训练来预测什么,并且它们的注意力掩码最清晰地区分了它们:编码器的完整正方形,解码器的下三角形,连接两者的交叉注意力的完整矩形(图 6.13)。
标题为“仅编码器(BERT)”、“仅解码器(GPT)”和“编码器-解码器(T5,原始)”的三个专栏。每个都显示一个块堆栈,其下方的注意力掩码或掩码为 6\times6 网格,其中填充了允许的单元格:编码器的完整正方形;解码器的下三角;对于编码器-解码器,编码器的完整正方形、解码器的下三角形和交叉注意力的完整 5\times6 矩形(六个编码器键的五个解码器查询)。在每一列下,其训练目标在一行中:“填写屏蔽的 token”、“预测下一个 token”、“将输入映射到输出文本”。插图显示了六个位置上的前缀 LM 掩码:前三个位置是完整的,之后是因果关系。
编码器-解码器
最初的 Transformer 和后来的 T5 有两个堆栈。 编码器以双向注意力读取输入:每个位置都能看到其他位置。 解码器生成具有因果自注意力的输出,并且在每层中都有一个交叉注意力子层,该子层读取编码器的最终状态 \mathbf{H}_{\text{enc}} \in \R^{T_{\text{enc}}\times d}:
查询来自解码器,键和值来自编码器,分数的形状为 (B, h, T_{\text{dec}}, T_{\text{enc}})。交叉注意力没有因果掩码,因为在解码开始之前整个输入都是已知的;它只需要编码器位置上的填充掩码。编码器的 \mathbf{K} 和 \mathbf{V} 每个输入计算一次,并在每个解码步骤中重用。解码器层具有三个子层:自注意力 (4d^2)、交叉注意力 (4d^2) 和 FFN (8d^2),因此 16d^2 参数与编码器层的 12d^2 相对应。该形状适合将一个文本映射到另一个文本的任务:翻译、摘要。
Vaswani 等人的基座模型具有 d = 512、d_{\text{ff}} = 2{,}048 = 4d 和 6 个编码器层和 6 个解码器层。
- 编码器层:12d^2 = 12\times512^2 = 3{,}145{,}728 \approx 3.15M。
- 解码器层:16d^2 = 4{,}194{,}304 \approx 4.19M。
- 层数:6\times3.15\text{M} + 6\times4.19\text{M} = 44.0M。
- 嵌入:编码器输入、解码器输入和输出投影共享一个矩阵,约 37{,}000\times512 = 18.9M,共享词汇表约为 37,000 个 token。
- 总计:大约 63M,与论文报告的 65M 相比(表 3)。
论文没有逐项说明剩下的 3%。偏置和归一化权重只约 0.1M,词表大小也仅写作“约 37,000”个 token;剩余差异无法根据论文给出的信息分配,所以此处计数止于“约 63M”。
仅编码器
BERT(Devlin 等,2019)只保留编码器,通过掩码语言建模(masked language modelling)训练:选取 15% 的位置,其中 80% 替换为 [MASK],10% 替换为随机 token,10% 保持不变;只在选中位置计算损失。这种混合避免模型学成“只有 [MASK] 位置才需要预测”,因为实际使用时不会出现 [MASK]。结果是各 token 的上下文表示,可读取输入前置的 [CLS] 向量,或对最终状态求平均,用于分类、检索、嵌入。BERT-Base 有 12 层,d = 768,110M 参数。仅编码器模型不能直接生成文本续写(练习 8)。
仅解码器
GPT 只保留解码器,并去掉交叉注意力:采用因果注意力,在各位置计算下一个 token 的预测损失。它原生支持生成;规模足够大时,也能通过提示词完成其他架构所处理的任务。两者之间还有前缀语言模型(prefix LM):对提示词部分使用双向注意力,对续写部分使用因果注意力;T5 研究比较过这一变体(Raffel 等,2020)。
为什么仅解码器获胜
它获胜是因为一个目标、一种架构和一次训练涵盖了每一项任务,而且因为生成是人们想要的任务。这句话的每一部分都有其背后的证据。
- 每个位置都是训练目标。 因果模型预测序列的所有 T - 1 位置处的下一个 token;掩码语言模型的学习对象约为 15%。
- 一个目标涵盖各项任务,只要将任务写成文本。GPT-2 在未专门训练的任务上表现出零样本能力;GPT-3(Brown 等,2020)则从提示词中的少量示例学习(第 07 模块,第 6 节 介绍上下文学习)。
- 生成是人们想要的任务,解码器原生地完成它。
- 服务很简单:根据提示和回答,一个堆栈和一个 KV cache (第 9 节)。
- 第 07 模块,第 4 节 的缩放证据是在此形状上收集的,因此它的缩放行为是最好理解的。
一条包含 512 个 token 的序列,仅解码器模型得到 511 个下一个 token 的目标,即除最后位置外,每个位置一个。BERT 得到 0.15\times512 = 76.8,约 77 个。读取相同数量的 token,因果模型得到的训练目标多于六倍。
也有反面的证据。在受控比较中,结果取决于评估方式。Raffel 等(2020)发现,在预训练后再微调的任务中,同等计算预算下,采用去噪目标的编码器-解码器效果最好。Wang 等(2022)发现,若预训练后直接进行零样本应用,以简单下一个 token 预测训练的因果解码器最好。市场选择了通用性与简单性,这不意味着它在所有任务上都更强。编码器仍是嵌入与检索的有效选择;人工智能特工系列 展示其在检索增强生成中的应用。
模块 07 至 10 将采用这一架构,并贯穿一个假设案例:使用约 9.5B 参数的开放权重模型,起草和检查反应堆容器泄压系统的安全论证。
三种架构的区别在掩码与目标:编码器使用双向注意力预测被遮盖的 token;解码器使用因果注意力预测下一个 token;二者之间的交叉注意力由解码器提供查询、编码器提供键和值,不使用因果掩码。
在交叉注意力中,哪一方提供查询,哪一方提供键和值?
查看答案
解码器提供查询;编码器的输出提供键和值。
为什么交叉注意力没有被因果掩盖?
查看答案
解码开始前,整个输入序列已经确定,所以各解码器位置都能读取全部输入。只有解码器自身的未来位置,由自注意力的因果掩码遮盖。
视觉 Transformer
Transformer 并不限定于文本;它处理向量序列,因此也可以把图像变成这种序列(Dosovitskiy 等,2021)。将 224\times224\times3 图像切成 16\times16 图像块,每边 224/16 = 14 块,共 14\times14 = 196 块。各块展平成 16\times16\times3 = 768 个数,再用共享线性层映射到宽度 d;这等价于 kernel 大小和步幅均为 16 的卷积。前置一个可学习的 [CLS] token,共 197 个 token,再加上可学习位置嵌入,送入仅编码器堆栈。类别由最终 [CLS] 向量读出(图 6.14)。这个 token 初始不含图像内容,而是一个可学习向量;它在每层读取所有图像块后,最终状态概括整幅图像。
使用图像块而非像素,是因为注意力成本随 token 数量二次增长。若每个像素对应一个 token,就有 224^2 = 50{,}176 个 token,每层每个头约 2.5\times10^9 个分数;197 个 token 则只有 38,809 个分数。
示意泵图像分成 196 个形状为 16\times16\times3 的图像块。展平后各块包含 768 个数,用共享线性映射变为模型宽度 d。添加类别 token 和位置嵌入后,197 个 token 送入十二层 Transformer 编码器;分类读取类别 token 的输出。
ViT-Base/16 有 12 层,d = 768,12 个头,MLP 宽度为 3,072。根据第 11 节的规则:
- Transformer 主体:12Ld^2 = 12\times12\times768^2 = 84{,}934{,}656,即 84.9M;带有偏差和层范数权重,85.1M。
- 补丁嵌入:768\times768 + 768 = 590{,}592 (0.59M)。
- 位置嵌入:197\times768 = 151{,}296 (0.15M)。
- 1000 类的线性分类头:768\times1{,}000 + 1{,}000 = 769{,}000(0.77M)。
总计约 86.6M,与论文的 86M 相近;Transformer 主体占 98%。
归纳偏置。 卷积自带局部性与平移等变性(第 03 模块);ViT 除了图像块网格外,没有显式加入这些性质,必须从数据学习。只用 ImageNet 规模的数据训练时,它落后于同类 CNN;大规模预训练,或强数据增强与蒸馏,可使它达到或超过 CNN(DeiT,Touvron 等,2021)。作为交换,各层都可联系任意两个图像块,而 CNN 的感受野必须逐层增大。
成本。 token 的数量随着分辨率的平方增长,注意力随着 token 的平方增长,因此分辨率加倍会使每层的注意力成本乘以约 16。
在 224\times224 下,共 14^2 + 1 = 197 个 token;在 448\times448 下,共 28^2 + 1 = 785 个 token。每层每个头的分数条目为 197^2 = 38{,}809 与 785^2 = 616{,}225,相差 15.9 倍。投影和 FFN 成本随 token 数线性增长,增大 785/197 = 4.0 倍。
ViT 如今既可独立使用,也可作为组件。CLIP 的图像编码器(第 05 模块,第 11 节)就是一种;多模态语言模型将视觉编码器的图像块输出投影到解码器的 token 流中(第 07 模块)。
384\times384 图像使用 16\times16 补丁和 [CLS] token 提供多少个 token?
查看答案
每边有 384/16 = 24 个补丁,因此 24^2 + 1 = 577 token。
现代解码器块的组成
注意力公式保持不变,周围的块结构却有多种变化。阅读模型配置时,应区分数学计算、存储方式、参数共享与具体实现。改变 KV 头数会改变模型本身;更换计算相同注意力的 kernel,通常只改变执行方式。
| 成分 | 该模块的解码器中的选择 | 原因和之前的讨论 |
|---|---|---|
| 归一化 | 各子层之前的 RMSNorm | 简单的前置归一化残差路径;第 5 节 |
| 位置 | 对查询与键应用 RoPE | 通过旋转表示相对位置;第 6 节 |
| 注意力 | 分组查询注意力 | 更小的键/值投影和缓存;以下 |
| 前馈激活 | SwiGLU | 在参数预算内使用门控;第 5 节 |
| 线性偏置 | 无 | 减少参数,简化投影 |
| 注意力实现 | 融合缩放点积注意力 | 避免构造完整中间矩阵;第 10 节 |
这些都是设计选择,不是所有解码器都必须遵循的清单。采用可学习位置、偏置或普通多头注意力的模型,仍是 Transformer。推理时改变这些选择,不能只改配置文件:权重是针对原有计算训练的。
生成时为何保存键和值
训练时,因果掩码允许所有位置在一次并行前向传播中预测下一个 token。生成时,每步只有一个新 token;它在每层的查询都需要整个可见前缀的键和值。反复重算前缀会浪费计算。KV cache 保存已投影的键和值,使下一步只计算新 token 的投影,再读取已有缓存。
缓存既不保存未来 token,也不使各层独立。新 token 仍须依次经过各层,各层根据自身输入状态追加自己的键和值。旧查询不必保留,因为生成新输出时不会再使用它们。
对于 L 层、n_{\text{kv}} KV 头、头宽度 d_{\text{head}} 和每个存储值的 b_v 字节,增加一个 token 的存储空间为
因子 2 分别计入键和值。再乘以保留的序列长度和 batch 中存储的序列数,即得张量存储量;分配开销另计。本节采用二进制单位:1 KiB = 1024 字节,1 MiB = 2^{20} 字节,1 GiB = 2^{30} 字节。硬件规格采用十进制 GB、TB/s。后续模块引用这些大小时会同时给出两种单位。
取 32 层,头宽 128,bf16 存储,每个值两个字节。具有 32 KV 头的完整多头注意力为每个 token 添加了 2\times32\times32\times128\times2=524{,}288 字节:512 KiB。八个 KV 头添加 131,072 字节,即 128 KiB。一个 KV 头增加 16,384 个字节,即 16 KiB。对于 4096 个保留的 token,它们变为 2 GiB (2.15 GB)、512 MiB (0.54 GB) 和 64 MiB (0.067 GB)。在所有三种情况下,查询头都保持为 32。
共享键和值而不共享查询
分组查询注意力(grouped-query attention,GQA)让多个查询头共享同一组键和值,查询本身仍各不相同。八个查询头、两个 KV 头时,每四个查询头共享一个 KV 头。多查询注意力是极端情形,所有查询头共享一个 KV 头;普通多头注意力则为每个查询头配一个 KV 头。安斯利等人。 研究质量与推理成本之间的权衡,也讨论将已有多头模型转换后继续训练。
键和值投影的宽度从 d 缩小到 n_{\text{kv}}d_{\text{head}},查询和输出投影保持宽度 d。注意力分数计算不会按相同比例减少:每个查询头仍须给每个可见键打分。缓存容量、投影参数量和注意力算术量,是三个不同的指标。
将两个 KV 头标记为 0 和 1。 repeat_interleave(4, dim=1) 将它们扩展为 [0, 0, 0, 0, 1, 1, 1, 1],连续查询头组所期望的映射。 repeat(1, 4, 1, 1) 则给出 [0, 1, 0, 1, 0, 1, 0, 1]。两者产生相同的张量形状。只有一个与此检查点的分组匹配。形状检查无法检测到错误;将输出与显式的每组计算进行比较。
多头、分组查询和多查询布局。查询头保留单独的投影,而组共享键/值头。在算例中,缓存比较使用 32 个查询头、32 层配置,而不是为了易读性而绘制的 8 个头。
小型解码器常采用嵌入权重共享(tied embeddings):输入查找表与输出投影共享同一个参数张量。输出投影仍然要计算,因此节省的是参数存储,而非计算词表 logits 的矩阵乘法。若不共享,模型可以学习独立的输入和输出表示,代价是再存一个词表大小的矩阵。
限制可见的过去
宽度为 w、包含当前位置的滑动窗口,允许读取 \max(0,t-w+1) 到 t 的键。长度为 T 时,注意力成本为 O(Tw),而非 O(T^2)。跨层传播可以超出一个窗口:每增加一层,依赖路径最多向前扩展 w-1 个位置;L 层的理论跨度为 L(w-1) 个位置,受实际前缀长度限制。这只是依赖范围的上界,不保证能可靠检索那么远的信息。
在从零编号的位置 7,第一层读取位置 4–7;第二层读取的状态已经包含位置 1–7 的信息;第三层可以到达八个 token 序列的起点 0。最大向后跨度为 3(4-1)=9 个位置,但受序列起点截断。没有任何单个头直接读取全部这些输入 token。
仅使用局部注意力的层可以丢弃窗口之前的缓存键;使用全注意力的层仍需保留整个过去。有些流式方案还保留初始 token,因为模型可能赋予它们很大的注意力权重;移除这些注意力汇聚点会改变模型行为。缓存策略必须匹配模型的注意力模式。第 10 模块 进一步讨论对服务的影响。
分组查询注意力会按查询头与 KV 头的数量比,减少查询-键分数矩阵的 FLOPs 吗?
查看答案
不会。每个查询头仍计算自己的分数。GQA 减少键和值的投影及缓存存储,但分数计算和值混合仍按查询头数进行。
FlashAttention 和在线 softmax
稠密注意力看似包含三个操作:构造分数、归一化、乘以值。直接实现会将分数写入 GPU 主存,softmax 时读回,再写入概率并读回用于值混合。这些中间矩阵随序列长度二次增长,而输出只线性增长。精确实现可以避免存储这些大矩阵。
32 个头、8192 个位置时,bf16 分数张量占 32\times8192^2\times2=4{,}294{,}967{,}296 字节,即一个序列的一层需要 4 GiB。每个头、每个查询保存一个 fp32 log-sum-exp 统计量,只占 32\times8192\times4=1{,}048{,}576 字节,即 1 MiB。输入、输出和临时块仍需存储;这里比较的是保留注意力中间结果的成本。
FlashAttention 根据 GPU 的存储层级组织计算:小块分数留在快速片上存储中,贡献到输出后即丢弃。难点是 softmax 要对整行归一化,而当前块不知道尚未处理的键会贡献多少分母。解决方法是维护累积归一化常数,并在后续块出现更大分数时重新缩放。
从稳定 softmax 到累积不变量
对于分数 s_j,减去其最大值 m 得出
将分子和分母乘以 e^m 可恢复原始公式,因此这不会改变概率。所有指数至多为一。对于分数 (1000,1001,1002),直接求幂会溢出普通浮点格式。减去 1002 后,指数为 (e^{-2},e^{-1},1),概率约为 (0.090,0.245,0.665)。
设已处理键的累积最大值为 m、累积和为 \ell=\sum_{j\in\text{seen}}e^{s_j-m}。新块的最大值为 m_b、局部和为 \ell_b=\sum_{j\in\text{block}}e^{s_j-m_b}。更新后的最大值和总和为
展开第一项即可验证:\ell e^{m-m'}=\sum_{j\in\text{seen}}e^{s_j-m}e^{m-m'} =\sum_{j\in\text{seen}}e^{s_j-m'}。第二项将新块表示在相同尺度上,所以两项相加正好得到全部已处理键的不变量。从空和开始,按块归纳即可证明整个过程。
输出需要加权值和分母。保留 \mathbf{a}=\sum_{j\in\text{seen}}e^{s_j-m}\mathbf{v}_j 并更新
同样展开可证明累加器的不变量。最后一个块处理完后,\mathbf{o}=\mathbf{a}/\ell 精确等于 softmax 的值加权和。概率矩阵本身从不需要写入主存。
前两个分数是 1/\sqrt2 和 1/\sqrt2。它们的值为 (1,0) 和 (0,2)。在该块之后,m=0.707107、\ell=2 和 \mathbf{a}=(1,2)。最终得分为 \sqrt2,值为 (3,3)。旧累加器和总和必须乘以 e^{-1/\sqrt2}=0.493069。因此 m'=1.414214、\ell'=2(0.493069)+1=1.986137 和 \mathbf{a}'=(1,2)(0.493069)+(3,3)=(3.493069,3.986137)。除法得到 (1.759,2.007),即 第 3 节 的稠密结果。
查询块、键块与因果对角线
将查询分成 B_r 行一块,键和值分成 B_c 行一块。每个查询块保留各行最大值、归一化常数,以及各行的向量累加器。构造 B_r\times B_c 分数块,更新统计量后丢弃;全部可见键处理完后,将累加器除以归一化常数,再写出输出。
完全位于因果对角线上方的块没有贡献,可直接跳过;跨越对角线的块仍需逐元素掩码。在 T=1024、方块边长为 64 时,每个轴有 16 块;256 块中只有 16(17)/2=136 块参与计算。每个 float64 分数块占 64^2\times8=32 KiB,替代完整的 8 MiB 矩阵。实验 3 实现该算法,并检查不等大小及不完整的块。
每个头持续保留的逐行统计量只需 O(T) 存储,输出本身需 O(Td_{\text{head}}),工作区还需一个块和累加器。注意力的额外存储为线性,并不意味着整个模型内存恒定,也不意味着注意力算术量线性。全注意力仍要计算每一对可见查询与键的分数。
通过重算完成反向传播
反向传播时,用重算的分数块和保存的逐行 log-sum-exp m+\ln\ell 恢复概率块,避免为每层保存完整概率矩阵。重算增加算术量,却减少内存流量;在受内存带宽限制的硬件上,可能缩短运行时间。它并不丢弃键,不近似 softmax,也不将注意力限制在窗口内。
PyTorch 的 scaled_dot_product_attention 根据设备、dtype、形状和掩码选择实现。在 CPU 上调用该函数,不代表运行了 CUDA FlashAttention kernel。笔记本上的数值检查验证功能是否等价;识别实际 kernel 并测量性能,需要 GPU 性能分析。
为何新块提高最大值时,必须同时重新缩放归一化常数和累加器?
查看答案
二者的指数都相对于旧最大值计算。乘以 e^{m-m'},才能在新尺度上表示旧贡献;若只缩放其中一个,它们的比值改变,输出就会错误。
FlashAttention 保持全注意力的数学计算,只改变运算顺序和中间结果的存储位置;浮点舍入可能不同。
计算参数和 FLOP 次数
模型宣传的参数规模描述存储量。计算量则取决于哪些权重参与乘法、多少 token 彼此可见,以及 kernel 是否计算被屏蔽的条目。从张量形状计数,可以得到假设明确的估计。
先数一层再数堆栈
设残差宽度为 d,查询头数为 h,KV 头数为 n_{\text{kv}},头宽度为 d_{\text{head}}=d/h。查询与输出投影各有 d^2 个权重,键和值投影各有 d n_{\text{kv}}d_{\text{head}} 个,所以注意力共有 2d^2+2d n_{\text{kv}}d_{\text{head}} 个权重。普通多头注意力时,化为 4d^2。
SwiGLU 前馈网络有两个 d\times d_{\text{ff}} 输入矩阵和一个 d_{\text{ff}}\times d 输出矩阵,共 3dd_{\text{ff}} 个权重。选择 d_{\text{ff}}\approx8d/3 时,约为 8d^2,与宽度 4d 的普通双矩阵 FFN 相当。两个 RMSNorm 增益再增加 2d 个参数;若有偏置,也须计入。普通多头注意力加上这一 FFN 预算,每层约有 12d^2 个权重。
共享嵌入时,词表增加 Vd 个权重;不共享时增加 2Vd 个。可学习位置增加 T_{\max}d;RoPE 不增加可学习表。最终 RMSNorm 增加 d。
取 L=32、d=4096,查询头与 KV 头均为 32,d_{\text{ff}}=11008,词表 V=32000,嵌入不共享,无偏置。注意力有 67,108,864 个权重,FFN 有 135,266,304 个,两个归一化有 8192 个;每层共 202,383,360 个,堆栈共 6,476,267,520 个。加上两个各有 131,072,000 个权重的词表矩阵,以及 4096 个最终归一化增益,得到 6,738,415,616。每个值占两个字节时,权重占 13.5 GB(12.6 GiB);优化器状态、激活与缓存另计。
近似规则 12Ld^2+2Vd 对这一配置给出 6.70B,效果较好是因为架构基本符合其假设。实验 4 得到 GPT-2 small 的 124,439,808、SmolLM2-135M 的 134,515,008、Qwen2.5-0.5B 的 494,032,768,以及 Llama-3-8B 的 8,030,261,248。分组查询、词表大小、FFN 宽度、偏置约定和位置表,解释了与近似规则的差别。小模型的很大一部分参数可能用于词表矩阵。
将存储与矩阵乘法工作分开
N_{\text{total}} 统计所有不同的参数。N_{\text{matmul}} 则从中扣除仅用于查找的表:不共享的输入嵌入和可学习位置。共享嵌入的词表矩阵仍计入 N_{\text{matmul}},因为它也用于计算输出 logits。这一计数约定仍包含归一化增益与偏置;虽然它们不执行矩阵乘法,但贡献很小,保留后仍是实用近似。
先考虑输出形状为 N_{\text{matmul}}=6{,}738{,}415{,}616-131{,}072{,}000 =6{,}607{,}343{,}616 的乘法。一次乘加计两次 FLOP。m\times n 矩阵乘以 n\times p 矩阵约需 2mnp 次浮点运算,所以可学习矩阵的乘法成本约为每个 token 2N_{\text{matmul}}。实际实现中的嵌入查找,并不是稠密矩阵乘以独热向量。
注意力增加了上下文相关的成本
在看到 t 键的位置,查询-键乘法每层花费 2td,值混合花费另一个 2td。跨层即 4Ldt。分组查询不会更改这些产品中的 hd_{\text{head}}=d。
在 T 位置的因果序列中,平均可见长度为 (T+1)/2。确切的对计数项是每个 token 的 2Ld(T+1),通常近似为 2LdT。相反,在掩蔽之前评估整个正方形的 kernel 将支付 4LdT。分块边界工作和 softmax 操作增加了此算术估计忽略的开销。
本例模型每个 token 的权重乘法为 13.21 GFLOP。注意力在 t=512 时增加 0.27 GFLOP,t=4096 时增加 2.15 GFLOP,t=32768 时增加 17.18 GFLOP,分别约为权重计算的 2%、16%、130%。对长度 4096 的整个因果序列取平均,注意力增加 1.07 GFLOP,约 8%。最后一个 token 的成本与序列平均成本应区分。
实验 4 对五种公开解码器配置统计参数占比:词表矩阵、注意力、前馈网络和归一化。每根条形总计 100%。
Llama-2-7B 配置的前向计算随上下文长度的变化。每个 token 的权重乘法成本固定,全注意力成本随上下文增长。单 token 与因果序列平均的注意力曲线,分别约在 25,205 和 50,410 个 token 处与权重项相交。
将 4Ldt 与近似权重成本 2(12Ld^2) 相等,得到 t=6d。使用因果平均值得出 T=12d。这些是假设架构的尺寸规则;包括输出投影和精确的 FFN 宽度会移动交叉点。
训练为何约为三次前向计算
对于 \mathbf{Y}=\mathbf{X}\mathbf{W},反向传播计算 \partial\mathcal{L}/\partial\mathbf{X}=(\partial\mathcal{L}/\partial\mathbf{Y}) \mathbf{W}^{\top} 与 \partial\mathcal{L}/\partial\mathbf{W}=\mathbf{X}^{\top} (\partial\mathcal{L}/\partial\mathbf{Y}),两者的主导乘加次数都与前向乘积相同。因此,前向加反向约为三次前向乘积的成本;注意力中的乘积也具有相同关系。重算、优化器更新、通信和数据加载不在这一模型内。
该系列的 FLOP 约定。 内存和缩放定律模型大小使用 N_{\text{total}}。每个 token 的前向计算大约为可见上下文 t 处的 2N_{\text{matmul}}+4Ldt,或在跳过屏蔽对的因果序列上平均的 2N_{\text{matmul}}+2LdT。训练成本大约是前向计算的三倍。不共享的输入嵌入和学习位置表仅用于查找,并且从 N_{\text{matmul}} 中排除。快捷方式 2N_{\text{total}} 和 6N_{\text{total}} 必须标记为估计值。
本例在 T=4096 下,每个 token 的训练成本为 6N_{\text{matmul}}+6LdT =39.64+3.22=42.87 GFLOP。简化公式 6N_{\text{total}}=40.43 低估 5.7%:它错误计入输入嵌入的 0.79 GFLOP,同时漏掉注意力的 3.22 GFLOP,两项误差并不抵消。将单 token 成本乘以训练 token 数,得到模型计算量;第 08 模块 再转为运行预算并加入执行开销。
为什么将输出头绑定到输入嵌入不会删除其 2Vd FLOP?
查看答案
绑定会删除第二个存储的参数矩阵。每个输出仍然将隐藏状态乘以该共享矩阵来计算所有词汇表 logits。
训练一个小型 GPT
实验 4 的解码器将各组件连接起来:相邻维度对的 RoPE、分组键和值、缩放点积注意力、前置归一化残差、SwiGLU、共享输出权重。默认配置为词表 4096、宽度 256、四层、八个查询头、两个 KV 头、FFN 宽度 682,共有 3,801,344 个不同参数。实验 5 使用更小的模型:宽度 128、四个查询头、四层。
在信任损失曲线之前检查初始化
正确的下一个 token 交叉熵为 -\ln p(y)。接近均匀的预测给出损失 \ln V;在 V=4096 下为 8.318 奈特。随机初始 logits 不必完全相同,所以初始损失可略高。若远高于基线,应先怀疑尺度或目标对齐问题,而非任务异常困难。
共享权重带来一个初始化陷阱。默认嵌入表的元素尺度为 1;初始残差状态与自身输入嵌入相似,经过最终归一化后,与同一嵌入的点积可达 d 数量级。于是共享输出头强烈预测当前 token,而非下一个 token。以标准差 0.02 初始化共享表,可以减小这些 logits。实验的解码器在共享权重之后显式调用 nn.init.normal_(self.emb.weight, std=0.02)。应同时测量首个 batch 的损失、logit 分布和目标对齐。
每个窗口都包含许多预测
抽取 T+1 个 token 的窗口。输入为 window[:-1],目标为 window[1:]。位置 0 根据第一个 token 预测第二个,位置 1 根据前两个预测第三个。因果掩码保证各位置看不到自身目标,损失对 batch 与序列维度取平均。若省略移位,模型学习的将是重建当前 token;错误任务也能得到看似令人放心的低损失。
合成维护日志任务在行尾重复记录标识符。词汇、状态规则和格式都是局部规律;复制结尾标识符则需要较早的信息。数据生成器已知,所以可以直接计算其熵,而非从模型分数推断。实验区分均匀、单元组、二元组、无法复制、真实生成器五种基线。只有真实条件熵才是该数据源预期损失的信息论下界;无法复制的参考值描述一种受限预测器。
AdamW、预热、余弦衰减与梯度裁剪来自 第 02 模块 的优化工具。固定种子有助于比较,但不保证不同硬件和线程数下的训练轨迹相同。有意义的指标是留出损失,以及生成记录中结尾标识符与开头匹配的比例。损失下降本身不能确定哪个头在复制;实验 6 通过注意力测量和干预测试一个更简单的复制机制。
实际执行的 1500 步训练中,留出损失达到每字符 0.399 奈特,低于无法复制参考值 0.501,高于生成器熵 0.330。172 条完整生成行全部可解析,其中 155 条正确复制标识符(90.1%),171 条状态正确(99.4%)。这些是特定模型、种子和样本的测量,不保证每次训练都相同。300 步 QUICK 运行的损失为 0.532,其 170 条可解析记录均未正确复制标识符。
1500 步因果训练与 200 步无掩码对照的维护日志验证损失。因果模型最终低于受限的无法复制参考值;无掩码模型读取未来 token,损失低于数据源熵。右图比较各模型训练后的普通窗口损失与仅前缀评分。
采样测量了教师强制以外的行为
生成时,输入前缀,读取最后位置的 logits,除以温度(实验中为 0.8),采样下一个 token 并追加。将前缀裁剪到支持的上下文长度,再重复。早期生成错误会成为后续输入的一部分。第 07 模块 解释不同采样选择及其效果。
没有 KV cache 时,从一个初始字符生成 128 个字符需要处理 1+2+\cdots+128=8256 个输入位置。使用缓存后,先处理初始位置,再每步只处理一个新位置,并读取已有键和值。这消除重复的前缀投影,却不消除新查询对前缀的注意力计算。这个短序列的位置数量比为 64.5,不代表实际运行时间必然加速 64.5 倍。
验证拆分无法修复架构泄漏
去掉因果掩码,但仍将目标移位一格。大多数位置现在可以读取下一个输入 token,而它恰好就是目标。训练与留出窗口损失都会骤降,因为两种数据划分都暴露了同样的未来信息。每个窗口最后位置例外,因为它的目标在输入之外。
仅前缀评分为各预测提供当时实际可用的前缀。它比一次处理完整无掩码窗口慢,却符合生成时的信息边界。比较它与普通窗口损失及生成记录:较大差距可揭示泄漏。留出数据划分防止部分记忆行为,却无法弥补架构违反的信息边界。
无掩码对照的留出窗口损失为 0.014,仅前缀损失却为 1.291;83 条完整生成行均无法解析。完整因果模型的仅前缀损失为 0.394。仅前缀评分与窗口评分对不同的位置集合取平均,因此即使是因果模型,也不要求精确相等。对照组差距的大小与方向,才是诊断证据。
词汇量为 256 的模型从损失 12.7 开始。首先应该检查什么?
查看答案
均匀基线为 \ln256=5.545。在长时间优化实验之前,先检查初始 logit 尺度、共享嵌入初始化及输入与目标对齐。
常见问题与排查
| 症状 | 可能的原因 | 诊断或纠正 |
|---|---|---|
| 窗口损失很好,生成质量很差 | 缺少因果掩码或目标未移位 | 比较仅前缀评分,检查输入与目标配对 |
| 第零步损失极大 | logits 过大,尤其是共享嵌入 | 与 \ln V 比较,打印 logit 分布范围 |
| 形状通过,分组头给出错误的输出 | 交替 KV 扩展而不是连续组 | 与显式组循环进行比较 |
| RoPE 改变两个位置后分数发生变化 | 仅旋转一侧或混合约定 | 运行公共移位和复数乘法检查 |
| 注意力出现 NaN | 溢出或全掩码行 | 使用稳定 softmax,明确填充和空行处理 |
| 分块结果强烈依赖块大小 | 最大值改变时未重新缩放,或块边界掩码错误 | 与 float64 稠密参考实现比较 |
| 使用融合 kernel 后内存仍二次增长 | 其他路径保存完整注意力权重或掩码 | 检查张量分配与实际选用的实现 |
| 局部窗口丢失信息 | 移除了直接可见的位置或保留的注意力汇聚点 | 测试模型的注意力模式与缓存策略 |
| 计算估计不一致 | 不同的嵌入或因果对约定 | 报告 N_{\text{total}}、N_{\text{matmul}}、长度和掩蔽假设 |
| 将注意力热图视为语义解释 | 权重本身不能提供完整证据 | 测量受控干预后的输出变化 |
比较性能前,先验证数值等价性;解释损失前,先验证模型究竟在学习什么任务。这些检查比在错误计算上训练模型便宜得多。
实验 1 — 手算注意力,并与 PyTorch 核对
目标。 在 NumPy 中复现 第 3 节 算例的全部数值,再用独立检查验证:PyTorch 的融合注意力 kernel 及自动求导,应在舍入误差范围内与手算一致;有限差分应与 第 2 节 的 softmax 雅可比矩阵一致。随后测量 1/\sqrt{d_k} 缩放因子对随机分数的影响,绘制图 6.3,并打印实际多头注意力的张量形状。全部数据均为合成,仅需 NumPy、PyTorch、matplotlib,无需下载,CPU 运行约一分钟。
第 1 步:设置
本系列各实验都先固定随机种子。NumPy 的打印选项统一设为三位小数,与正文显示精度一致。
import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
import torch.nn.functional as F

np.random.seed(0)
torch.manual_seed(0)
rng = np.random.default_rng(0)           # used by the random experiments below
np.set_printoptions(precision=3, suppress=True)
print("torch", torch.__version__.split("+")[0], "| numpy", np.__version__)
torch 2.14.1 | numpy 2.4.6
步骤 2 — NumPy 手算示例
第 3 节直接给出了三个 token 的投影向量,所以无需学习权重,也没有嵌入:输入为 \mathbf{Q} = \mathbf{K} 和 \mathbf{V}。全部计算使用 float64,舍入误差远小于正文显示的精度。
softmax 在求指数前减去各行最大值。这不改变结果(分子与分母都乘以 e^{-m}),却能避免溢出;实验 3 将再次使用这一性质。attention 返回推导中的分数 \mathbf{S}、权重 \mathbf{P}、输出 \mathbf{O} 三个矩阵。因果掩码在 softmax 之前将满足 j > i 的条目写为 -\infty,使对应权重精确为零。
Q = np.array([[1., 0.], [0., 1.], [1., 1.]])
K = Q.copy()
V = np.array([[1., 0.], [0., 2.], [3., 3.]])


def softmax(s, axis=-1):
    """Row-wise softmax; subtracting the maximum keeps exp() from overflowing."""
    e = np.exp(s - s.max(axis=axis, keepdims=True))
    return e / e.sum(axis=axis, keepdims=True)


def attention(Q, K, V, causal=True, scale=True):
    """Return scores S, weights P and output O = P V for one head, shapes (T, d)."""
    S = Q @ K.T
    if scale:
        S = S / np.sqrt(Q.shape[-1])
    if causal:
        S = np.where(np.tril(np.ones_like(S, dtype=bool)), S, -np.inf)
    P = softmax(S)
    return S, P, P @ V


S, P, O = attention(Q, K, V, causal=True, scale=True)
print("scores S (masked entries are -inf):")
print(S)
print("weights P:")
print(P)
print("output O:")
print(O)
scores S (masked entries are -inf):
[[0.707  -inf  -inf]
 [0.    0.707  -inf]
 [0.707 0.707 1.414]]
weights P:
[[1.    0.    0.   ]
 [0.33  0.67  0.   ]
 [0.248 0.248 0.503]]
output O:
[[1.    0.   ]
 [0.33  1.34 ]
 [1.759 2.007]]
第 1 行正好是 \mathbf{v}_1 = (1, 0),第 2 行是 (0.330, 1.340),第 3 行是 (1.759, 2.007):第 3 节 的数字,这里有精确的权重。
步骤 3 — 另外三个变体
正文也计算了无掩码和无缩放的情况。四次调用覆盖 {因果掩码,无掩码} × {缩放,无缩放} 的 2 × 2 组合。
for causal in (True, False):
    for scale in (True, False):
        _, P_, O_ = attention(Q, K, V, causal=causal, scale=scale)
        tag = f"{'causal  ' if causal else 'unmasked'} {'scaled  ' if scale else 'unscaled'}"
        print(tag, "O =", np.round(O_, 3).tolist())
        print(" " * 17, "row 3 weights", np.round(P_[2], 3).tolist())
causal   scaled   O = [[1.0, 0.0], [0.33, 1.34], [1.759, 2.007]]
                  row 3 weights [0.248, 0.248, 0.503]
causal   unscaled O = [[1.0, 0.0], [0.269, 1.462], [1.94, 2.152]]
                  row 3 weights [0.212, 0.212, 0.576]
unmasked scaled   O = [[1.604, 1.599], [1.401, 2.006], [1.759, 2.007]]
                  row 3 weights [0.248, 0.248, 0.503]
unmasked unscaled O = [[1.689, 1.578], [1.422, 2.112], [1.94, 2.152]]
                  row 3 weights [0.212, 0.212, 0.576]
与正文一致,无掩码、保留缩放时,只有第 1、2 行不同。去掉缩放后,第 3 行权重从 (0.248, 0.248, 0.503) 变为 (0.212, 0.212, 0.576),输出从 (1.759, 2.007) 变为 \mathbf{v}_3 = (3, 3)。
步骤 4 — 与 PyTorch 融合 kernel 核对
torch.nn.functional.scaled_dot_product_attention(SDPA)是本模块各模型调用的函数。它接收形状为 (B, h, T, d_k) 的张量,自行应用 1/\sqrt{d_k} 缩放,并在 is_causal=True 时使用因果掩码。在 CPU 上可能采用融合 kernel 或直接公式,但两者都应与步骤 2 一致。比较指标为所有元素的最大绝对差。
def to4(a):
    """(T, d) NumPy array -> (1, 1, T, d) float64 tensor: batch 1, one head."""
    return torch.tensor(a, dtype=torch.float64)[None, None]


q4, k4, v4 = to4(Q), to4(K), to4(V)
for causal in (True, False):
    ref = attention(Q, K, V, causal=causal, scale=True)[2]
    out = F.scaled_dot_product_attention(q4, k4, v4, is_causal=causal)[0, 0].numpy()
    print(f"is_causal={causal!s:5}  max |numpy - torch| = {np.abs(out - ref).max():.1e}")
is_causal=True   max |numpy - torch| = 5.6e-17
is_causal=False  max |numpy - torch| = 0.0e+00
误差小于 10^{-16},处于 float64 舍入精度,说明手算、公式与融合 kernel 对应相同计算。
步骤 5 — 填充掩码
batch 中的序列可不等长,短序列需要填充。填充掩码隐藏填充键,并与因果掩码做逻辑 AND:只有 j \le i 且键 j 是真实 token 时,查询 i 才能看到键 j。此处将同一示例堆叠两次,并将第二条序列的第三个 token 设为填充。SDPA 接收布尔 attn_mask,其中 True 表示“允许关注”;它在头维度广播,形状为 (B, 1, T, T)。
qb = to4(Q).expand(2, 1, 3, 2).clone()               # batch of two copies, (2, 1, 3, 2)
kb = qb.clone()
vb = to4(V).expand(2, 1, 3, 2).clone()
real = torch.tensor([[True, True, True], [True, True, False]])        # (B, T) keys
causal_mask = torch.tril(torch.ones(3, 3, dtype=torch.bool))          # (T, T)
mask = causal_mask[None, None] & real[:, None, None, :]               # (B, 1, T, T)
print("mask shape:", tuple(mask.shape))
print("second sequence's mask:")
print(mask[1, 0].int().numpy())

out = F.scaled_dot_product_attention(qb, kb, vb, attn_mask=mask)
print("sequence 1 output:")
print(out[0, 0].numpy())
print("sequence 2 output (row 3 is a padded query):")
print(out[1, 0].numpy())
mask shape: (2, 1, 3, 3)
second sequence's mask:
[[1 0 0]
 [1 1 0]
 [1 1 0]]
sequence 1 output:
[[1.    0.   ]
 [0.33  1.34 ]
 [1.759 2.007]]
sequence 2 output (row 3 is a padded query):
[[1.   0.  ]
 [0.33 1.34]
 [0.5  1.  ]]
第一条序列不变。第二条序列的第 1、2 行也不变,因为原本就看不到 token 3。第 3 行属于填充位置,但查询仍能看到键 1、2,所以得到看似合理的 (0.500, 1.000)。这正是填充的陷阱:填充位置也有输出,而且貌似正常;只有损失掩码才能排除这些位置的训练贡献。
步骤 6 — 第 3 行的 softmax 雅可比矩阵
第 2 节 已为 \mathbf{p} = \operatorname{softmax}(\mathbf{s}) 推导 \mathbf{J} = \operatorname{diag}(\mathbf{p}) - \mathbf{p}\mathbf{p}^\top。这里检查两个性质:行和为零(权重总和为 1,改变分数不能改变这个总和),以及它与中心有限差分一致,使用 \partial p_i / \partial s_j \approx [p_i(\mathbf{s} + \epsilon\mathbf{e}_j) - p_i(\mathbf{s} - \epsilon\mathbf{e}_j)]/(2\epsilon) 和 \epsilon = 10^{-6}。
s3 = S[2]                                      # scaled scores of row 3: 0.707, 0.707, 1.414
p3 = softmax(s3)
J = np.diag(p3) - np.outer(p3, p3)
print("J = diag(p) - p p^T:")
print(J)
print("largest |row sum|:", f"{np.abs(J.sum(axis=1)).max():.1e}")

eps = 1e-6
J_fd = np.zeros((3, 3))
for j in range(3):
    step = np.zeros(3)
    step[j] = eps
    J_fd[:, j] = (softmax(s3 + step) - softmax(s3 - step)) / (2 * eps)
print(f"max |J - finite differences| = {np.abs(J - J_fd).max():.1e}")
J = diag(p) - p p^T:
[[ 0.187 -0.062 -0.125]
 [-0.062  0.187 -0.125]
 [-0.125 -0.125  0.25 ]]
largest |row sum|: 2.8e-17
max |J - finite differences| = 4.9e-11
10^{-11} 阶的残差是有限差分的截断和舍入误差,而不是 \mathbf{J} 的缺陷。
步骤 7:第 3 节的梯度,通过 autograd
第 3 节手算了 \mathcal{L} = o_{3,2} 的反向传播:\partial\mathcal{L}/\partial\mathbf{q}_3 = (0.001, 0.352),键的梯度为 (-0.352, -0.352)、(-0.001, -0.001)、(0.354, 0.354),\partial\mathcal{L}/\partial\mathbf{V} 的第二列等于 \mathbf{P} 的第 3 行。自动求导无需这些答案即可对融合 kernel 求导。
Qt, Kt, Vt = (to4(a).requires_grad_() for a in (Q, K, V))
Ot = F.scaled_dot_product_attention(Qt, Kt, Vt, is_causal=True)
loss = Ot[0, 0, 2, 1]                      # second component of token 3's output
loss.backward()
print("loss =", f"{loss.item():.3f}")
print("dL/dQ:")
print(Qt.grad[0, 0].numpy())
print("dL/dK:")
print(Kt.grad[0, 0].numpy())
print("dL/dV:")
print(Vt.grad[0, 0].numpy())
loss = 2.007
dL/dQ:
[[0.    0.   ]
 [0.    0.   ]
 [0.001 0.352]]
dL/dK:
[[-0.352 -0.352]
 [-0.001 -0.001]
 [ 0.354  0.354]]
dL/dV:
[[0.    0.248]
 [0.    0.248]
 [0.    0.503]]
只有 \mathbf{Q} 的第 3 行接收梯度,因为其他查询不影响 o_{3,2}。\mathbf{V} 梯度的第一列为零(损失仅读取第二分量),第二列为 (0.248, 0.248, 0.503),即注意力权重本身。
步骤 8 — 为何缩放分数
第 2 节的方差推导表明,元素独立且方差为 1 时,有 \operatorname{Var}(\mathbf{q}\cdot\mathbf{k}) = d_k。这里实际测量:为四种头宽度分别抽取 100,000 对标准正态向量。保留这些点积,用于图 6.3 的左图。
dots = {}
print(f"{'d_k':>5} {'std(q.k)':>9} {'sqrt(d_k)':>10}")
for dk in (2, 16, 64, 128):
    q = rng.standard_normal((100_000, dk))
    k = rng.standard_normal((100_000, dk))
    dots[dk] = (q * k).sum(axis=1)
    print(f"{dk:>5} {dots[dk].std():>9.2f} {np.sqrt(dk):>10.2f}")
  d_k  std(q.k)  sqrt(d_k)
    2      1.43       1.41
   16      3.99       4.00
   64      7.99       8.00
  128     11.33      11.31
各实测标准差与 \sqrt{d_k} 相差约不超过 1%;原始分数的标准差随头宽度增长。
步骤 9 — 饱和
接下来测量这种增长对 softmax 的影响。在 d_k = 128 下,独立抽取一个查询和 16 个键,元素服从标准正态分布,共重复 5,000 次。每次分别对未缩放分数和除以 \sqrt{128} 后的分数计算 softmax,记录最大权重与熵 H = -\sum_j p_j \ln p_j。均匀行的熵为 \ln 16 = 2.77 奈特,独热分布 0。两张图对应图 6.3:原始分数分布、最大权重直方图。
dk, n_keys, n_draws = 128, 16, 5000
rng_sat = np.random.default_rng(0)                  # a fresh generator: the draw does not
qd = rng_sat.standard_normal((n_draws, dk))         # depend on how much Step 8 consumed
kd = rng_sat.standard_normal((n_draws, n_keys, dk))
raw = np.einsum("nd,nkd->nk", qd, kd)               # unscaled scores, (5000, 16)


def stats(scores):
    """Largest weight and entropy (nats) of the softmax of each row."""
    p = softmax(scores)
    entropy = -(p * np.log(p + 1e-300)).sum(axis=1)
    return p.max(axis=1), entropy


for name, sc in (("unscaled", raw), ("scaled", raw / np.sqrt(dk))):
    pmax, ent = stats(sc)
    print(f"{name:9s} median largest weight {np.median(pmax):.3f}   "
          f"mean entropy {ent.mean():.2f} nats   (uniform: {np.log(n_keys):.2f})")
    if name == "unscaled":
        print(f"{'':9s} share of rows with largest weight above 0.95: "
              f"{(pmax > 0.95).mean():.2f}")

fig, axes = plt.subplots(1, 2, figsize=(10, 3.6))
for dk_, colour in ((2, "tab:blue"), (16, "tab:orange"), (128, "tab:green")):
    axes[0].hist(dots[dk_], bins=np.linspace(-40, 40, 81), alpha=0.6, color=colour,
                 density=True, label=f"$d_k$ = {dk_}  (std {dots[dk_].std():.1f})")
axes[0].set_xlabel("score  q . k")
axes[0].set_ylabel("density")
axes[0].set_title("Spread of raw scores grows with $d_k$")
axes[0].legend()
for name, sc, colour in (("unscaled", raw, "tab:red"),
                         ("scaled by $1/\\sqrt{d_k}$", raw / np.sqrt(dk), "tab:blue")):
    pmax, _ = stats(sc)
    axes[1].hist(pmax, bins=np.linspace(0, 1, 41), alpha=0.6, color=colour,
                 label=f"{name} (median {np.median(pmax):.3f})")
axes[1].set_xlabel("largest softmax weight in the row")
axes[1].set_ylabel("number of draws")
axes[1].set_title("16 keys, $d_k$ = 128: saturation")
axes[1].legend(loc="upper center")
plt.tight_layout()
plt.show()
unscaled  median largest weight 0.978   mean entropy 0.28 nats   (uniform: 2.77)
          share of rows with largest weight above 0.95: 0.58
scaled    median largest weight 0.225   mean entropy 2.35 nats   (uniform: 2.77)
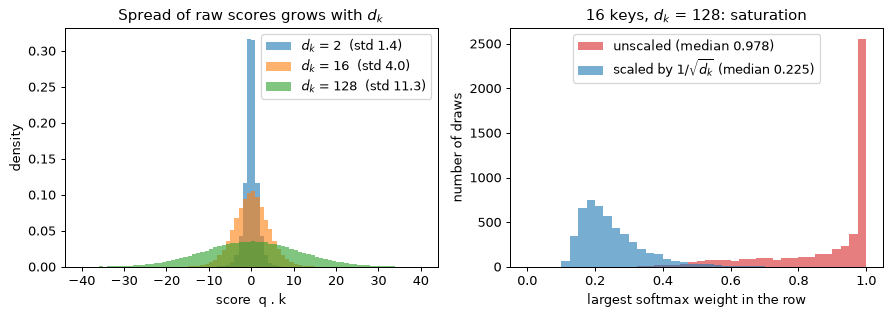
未缩放时,大多数抽样的最大权重接近 1,平均熵约为均匀分布的十分之一:softmax 接近硬查找,传递梯度给 \mathbf{W}_Q、\mathbf{W}_K 的雅可比矩阵接近零。缩放后,权重分布较分散。
第 10 步:多头形状
第 4 节 追踪形状 (B, T, d) 的张量在多头计算中的变化。这里采用同样的路径,设置 B = 2、T = 16、d = 256、h = 8,头宽度为 d_k = 32。投影得到 (B, T, d);view 将最后轴拆为各头;transpose(1, 2) 将头轴移到 batch 轴旁,使矩阵乘法作用于最后两个轴 (T, d_k)。最后转置并 reshape,合并各头。将结果与同样投影张量的 SDPA 输出比较。
B, T, d, h = 2, 16, 256, 8
dk = d // h
x = torch.randn(B, T, d)
wq, wk, wv = (nn.Linear(d, d, bias=False) for _ in range(3))

q = wq(x).view(B, T, h, dk)
print("after the projection and view:", tuple(q.shape))
q = q.transpose(1, 2)
k = wk(x).view(B, T, h, dk).transpose(1, 2)
v = wv(x).view(B, T, h, dk).transpose(1, 2)
print("after transpose(1, 2):        ", tuple(q.shape))

scores = q @ k.transpose(-2, -1) / dk ** 0.5
print("scores:                       ", tuple(scores.shape))
causal_mask = torch.tril(torch.ones(T, T, dtype=torch.bool))
weights = scores.masked_fill(~causal_mask, float("-inf")).softmax(dim=-1)
per_head = weights @ v
print("per-head output:              ", tuple(per_head.shape))
merged = per_head.transpose(1, 2).reshape(B, T, d)
print("merged:                       ", tuple(merged.shape))

fused = F.scaled_dot_product_attention(q, k, v, is_causal=True)
print(f"max |explicit - fused| = {(per_head - fused).abs().max().item():.1e}")
after the projection and view: (2, 16, 8, 32)
after transpose(1, 2):         (2, 8, 16, 32)
scores:                        (2, 8, 16, 16)
per-head output:               (2, 8, 16, 32)
merged:                        (2, 16, 256)
max |explicit - fused| = 2.4e-07
显式 softmax 与融合 kernel 在 float32 舍入精度内一致,约 10^{-7}。这不同于前面 10^{-16} 的精度,因此前面使用 float64。
预期观察
- NumPy 与 PyTorch 的输出在 10^{-16} 下误差小于
float64。手算、公式与融合 kernel 对应相同计算。 - 各输出行是可见值向量的凸组合。有因果掩码时,无论 \mathbf{Q}、\mathbf{K} 为何,第 1 行精确等于 \mathbf{v}_1。
- 去掉缩放使各行权重更集中,第 3 行最大权重从 0.503 升至 0.576。在 d_k = 128 下,大多数未缩放抽样接近独热分布,雅可比矩阵及到达 \mathbf{W}_Q、\mathbf{W}_K 的梯度几乎消失。
- 第 3 行各分数的梯度总和为零。来自 \mathcal{L} = o_{3,2} 的梯度只到达 \mathbf{q}_3、键,以及 \mathbf{V} 的第二列。
进一步尝试
- 将
Q乘以 10,重跑步骤 2。第 3 行接近 (0, 0, 1),输出接近 \mathbf{v}_3 = (3, 3),即 第 1 节 的硬查找极限。步骤 6 的雅可比矩阵会怎样变化? - 将一个查询的全部键屏蔽(全填充行),观察 NumPy -\infty 将
softmax减去 -\infty 后的结果,并与 SDPA 比较。再编写保护逻辑,令这种行返回零。 - 用显式 Python 循环逐头实现多头注意力,与步骤 10 的批量实现比较,确认误差不超过 10^{-6}。
实验 2 — 用数值检验 RoPE
目标。 实现旋转位置编码,验证相对位置性质,再故意破坏它。比较实数与复数实现,测量频率和位置插值如何改变分数。输入均为合成,无需下载;输出末位可能随机器变化。
步骤 1:旋转相邻对
x 的各行表示对应位置的向量。最后维度必须为偶数,因为旋转逐对进行。如 第 6 节 推导,查询与键同时平移相同位置,其点积中的平移会抵消。
import numpy as np
import matplotlib.pyplot as plt
import torch

np.random.seed(0)
torch.manual_seed(0)
rng = np.random.default_rng(0)
np.set_printoptions(precision=3, suppress=True)


def rope_np(x, positions, base=10000.0):
    width = x.shape[-1]
    assert width % 2 == 0
    frequencies = base ** (-np.arange(0, width, 2) / width)
    angles = np.asarray(positions)[..., None] * frequencies
    first, second = x[..., 0::2], x[..., 1::2]
    result = np.empty_like(x)
    result[..., 0::2] = first * np.cos(angles) - second * np.sin(angles)
    result[..., 1::2] = first * np.sin(angles) + second * np.cos(angles)
    return result


q, k = np.array([[1., 0.]]), np.array([[0., 1.]])
for t, s in ((3, 1), (7, 5), (1, 3), (5, 5)):
    score = (rope_np(q, [t]) * rope_np(k, [s])).sum()
    print(f"positions ({t}, {s}): score {score:.3f}")
positions (3, 1): score 0.909
positions (7, 5): score 0.909
positions (1, 3): score -0.909
positions (5, 5): score 0.000
第 2 步:测试每条对角线
在每个位置使用相同的内容向量,只让位置改变。沿各对角线数值恒定的矩阵称为 Toeplitz 矩阵,各对角线偏移对应相对位置。这不意味着真实句子的分数矩阵也是 Toeplitz,因为内容会变化。
positions = np.arange(64)
q = np.broadcast_to(rng.normal(size=64), (64, 64)).copy()
k = np.broadcast_to(rng.normal(size=64), (64, 64)).copy()
qr, kr = rope_np(q, positions), rope_np(k, positions)
scores = qr @ kr.T


def diagonal_deviation(matrix):
    return max(np.abs(np.diag(matrix, offset) -
                      np.diag(matrix, offset).mean()).max()
               for offset in range(1 - len(matrix), len(matrix)))


print(f"both rotated: diagonal deviation {diagonal_deviation(scores):.1e}")
norm_error = np.abs(np.linalg.norm(qr, axis=1) - np.linalg.norm(q, axis=1))
print(f"maximum norm change: {norm_error.max():.1e}")
broken = qr @ k.T
print(f"query only: diagonal deviation {diagonal_deviation(broken):.3f}")
assert diagonal_deviation(scores) < 1e-11
assert norm_error.max() < 1e-11
both rotated: diagonal deviation 2.1e-14
maximum norm change: 8.9e-16
query only: diagonal deviation 10.936
仅旋转查询会留下绝对位置依赖性。代码仍然运行并且形状仍然匹配,这使得这对于错误的 RoPE 调用来说是一个有用的诊断。
步骤 3 — 用复数乘法核对
两个实坐标分别作为复数的实部与虚部,乘以单位复数即可完成相同旋转。它能检查配对约定和符号。有些模型将头的前半维度与后半维度配对,投影权重也必须采用相应排列。
def rope(x, base=10000.0):
    B, h, T, dk = x.shape
    theta = base ** (-torch.arange(0, dk, 2, device=x.device) / dk)
    ang = torch.arange(T, device=x.device)[:, None] * theta[None, :]
    cos, sin = ang.cos()[None, None], ang.sin()[None, None]
    x1, x2 = x[..., 0::2], x[..., 1::2]
    return torch.stack([x1 * cos - x2 * sin, x1 * sin + x2 * cos],
                       dim=-1).flatten(-2)


x = torch.randn(2, 4, 32, 64)
theta = 10000.0 ** (-torch.arange(0, 64, 2) / 64)
angle = torch.arange(32)[:, None] * theta[None, :]
complex_x = torch.view_as_complex(x.reshape(2, 4, 32, 32, 2))
phase = torch.polar(torch.ones_like(angle), angle)
complex_result = torch.view_as_real(complex_x * phase).flatten(-2)
print(f"real versus complex: {(rope(x) - complex_result).abs().max():.1e}")
assert torch.allclose(rope(x), complex_result, atol=1e-6)
qt = torch.tensor(q[0], dtype=torch.float32).expand(1, 1, 256, 64)
kt = torch.tensor(k[0], dtype=torch.float32).expand(1, 1, 256, 64)
float_scores = (rope(qt) @ rope(kt).transpose(-1, -2))[0, 0].numpy()
print(f"float32, 256 positions: {diagonal_deviation(float_scores):.1e}")
real versus complex: 4.8e-07
float32, 256 positions: 4.4e-05
float32 误差随位置增大,因为更大的角度会损失更多绝对精度。这是数值误差,并非相对位置恒等式失效。
步骤 4 — 波长与振荡
对于宽度 128、相互对齐的全一向量,归一化点积就是 64 个旋转角的余弦平均。各频率会振荡,总和不保证单调衰减。这张图描述一个示意性位置 kernel,并非测量训练后注意力头的权重。
offsets = np.arange(1, 16385)
fig, ax = plt.subplots(figsize=(8, 4))
for base in (10000.0, 500000.0):
    frequencies = base ** (-np.arange(0, 128, 2) / 128)
    wavelengths = 2 * np.pi / frequencies
    correlation = np.cos(offsets[:, None] * frequencies).mean(axis=1)
    print(f"base {base:.0f}: wavelengths {wavelengths[0]:.2f} to "
          f"{wavelengths[-1]:.0f}; above 4096: {(wavelengths > 4096).sum()}/64")
    if base == 10000:
        for offset in (1, 16, 128, 1024, 4096):
            print(f"  offset {offset:5d}: {correlation[offset - 1]:.3f}")
    ax.plot(offsets, correlation, label=f"base {base:.0f}", alpha=0.8)
ax.set_xscale("log")
ax.set_xlabel("relative position (tokens)")
ax.set_ylabel("dot product / dot product at zero offset")
ax.set_title("RoPE positional kernel for aligned all-one vectors")
ax.legend()
plt.tight_layout()
plt.show()
base 10000: wavelengths 6.28 to 54410; above 4096: 18/64
  offset     1: 0.970
  offset    16: 0.620
  offset   128: 0.333
  offset  1024: 0.204
  offset  4096: -0.053
base 500000: wavelengths 6.28 to 2559196; above 4096: 32/64
第 5 步:插值和 ALiBi
位置除以四,将 256 个位置映射到原来 64 个位置所覆盖的大致角度范围。在位置编号可被四整除处,分数矩阵与原矩阵精确一致。仅凭这一等式,不能证明训练后的模型能处理更长序列,因为中间位置间距和竞争键的分布已改变。
long_positions = np.arange(256) / 4
long_q = np.broadcast_to(q[0], (256, 64))
long_k = np.broadcast_to(k[0], (256, 64))
interpolated = rope_np(long_q, long_positions) @ rope_np(long_k, long_positions).T
print(f"interpolated submatrix error: {np.abs(interpolated[::4, ::4] - scores).max():.1e}")
assert np.allclose(interpolated[::4, ::4], scores, atol=1e-11)
slopes = 2.0 ** (-np.arange(1, 9))
distance = np.maximum(0, np.arange(6)[:, None] - np.arange(6)[None, :])
bias = -slopes[:, None, None] * distance
print("ALiBi slopes:", slopes)
print("first head's bias:")
print(bias[0])
interpolated submatrix error: 0.0e+00
ALiBi slopes: [0.5   0.25  0.125 0.062 0.031 0.016 0.008 0.004]
first head's bias:
[[-0.  -0.  -0.  -0.  -0.  -0. ]
 [-0.5 -0.  -0.  -0.  -0.  -0. ]
 [-1.  -0.5 -0.  -0.  -0.  -0. ]
 [-1.5 -1.  -0.5 -0.  -0.  -0. ]
 [-2.  -1.5 -1.  -0.5 -0.  -0. ]
 [-2.5 -2.  -1.5 -1.  -0.5 -0. ]]
对角线上方的零偏置不意味着允许读取未来 token;还需单独的因果掩码。这里的几何斜率适用于八个头,其他头数应采用目标实现规定的斜率构造。
预期观察
同时旋转两个向量,在舍入误差内保留范数和各对角线分数;只旋转一个则破坏对角线性质。较大基数使衰减更慢;位置除以四,在对应子矩阵上保留原分数。
进一步尝试
- 计算 NTK 感知基数
10000 * 4 ** (128 / 126)并比较波长。 - 将坐标
i与i + 32配对,而不是相邻坐标。检查 Toeplitzness,然后显示相同未排列向量的分数不同。 - 为三 token 算例加入旋转,将所有位置同时平移七格。验证查询与键都平移时,每个输出都不变。
实验 3 — 在线 softmax 与分块注意力
目标。 不构造完整分数矩阵,仍精确计算注意力。实现累积 softmax 归一化常数,追踪三 token 算例,并将分块注意力与稠密参考实现比较。本 NumPy 实验测量存储与数值一致性;CPU 计时不能预测 GPU kernel 的速度。
步骤一:避免溢出
import time
import numpy as np

np.random.seed(0)
rng = np.random.default_rng(0)
np.set_printoptions(precision=3, suppress=True)


def safe_softmax(scores):
    weights = np.exp(scores - scores.max(axis=-1, keepdims=True))
    return weights / weights.sum(axis=-1, keepdims=True)


large = np.array([1000., 1001., 1002.])
with np.errstate(over="ignore", invalid="ignore"):
    naive = np.exp(large) / np.exp(large).sum()
print("naive:", naive)
print("safe: ", safe_softmax(large))
naive: [nan nan nan]
safe:  [0.09  0.245 0.665]
减去最大值的因子在分子和分母中抵消。最大指数值为 1,所有指数都不会溢出。
步骤 2 — 累积归一化常数
当前最大值定义累积和的尺度。若后续分数提高最大值,须先将旧和乘以 exp(old_max - new_max),再加入新项。输出各概率需要第二遍计算;注意力直接累积加权值,可免去这一遍。
def online_softmax_stats(scores):
    maximum, normaliser = -np.inf, 0.0
    for score in scores:
        new_maximum = max(maximum, score)
        normaliser = (normaliser * np.exp(maximum - new_maximum)
                      + np.exp(score - new_maximum))
        maximum = new_maximum
    return maximum, normaliser


scores = rng.normal(0, 5, 10000)
maximum, normaliser = online_softmax_stats(scores)
online = np.exp(scores - maximum) / normaliser
print(f"online versus safe: {np.abs(online - safe_softmax(scores)).max():.1e}")
assert np.allclose(online, safe_softmax(scores), atol=1e-14)
online versus safe: 8.9e-16
步骤 3:跟踪输出累加器
累加器保存值向量未归一化的加权和。它的尺度必须与归一化常数同步变化;只重新缩放其中一个会得到错误答案。
Q = np.array([[1., 0.], [0., 1.], [1., 1.]])
K = Q.copy()
V = np.array([[1., 0.], [0., 2.], [3., 3.]])
row = Q[2] @ K.T / np.sqrt(2)
maximum, normaliser, accumulator = -np.inf, 0., np.zeros(2)
for start in (0, 2):
    block = row[start:start + 2]
    new_maximum = max(maximum, block.max())
    rescale = np.exp(maximum - new_maximum)
    weights = np.exp(block - new_maximum)
    accumulator = accumulator * rescale + weights @ V[start:start + 2]
    normaliser = normaliser * rescale + weights.sum()
    maximum = new_maximum
    print(f"block {start // 2 + 1}: m={maximum:.3f}, rescale={rescale:.3f}, "
          f"l={normaliser:.3f}, a={accumulator}")
print("output:", accumulator / normaliser)
block 1: m=0.707, rescale=0.000, l=2.000, a=[1. 2.]
block 2: m=1.414, rescale=0.493, l=1.986, a=[3.493 3.986]
output: [1.759 2.007]
步骤 4 — 将查询与键分块
各查询行分别保存最大值、归一化常数和累加器。完全位于未来的键块跳过,对角块内的未来元素用掩码遮盖。代码支持不等块大小,此时某些行可能没有可见键;对这些行采用有限的备用最大值,避免零贡献变为 NaN。
def tiled_attention(Q, K, V, Br=64, Bc=64, causal=True):
    assert Br > 0 and Bc > 0
    assert Q.shape == K.shape and len(Q) == len(V)
    T, width = Q.shape
    output = np.empty((T, V.shape[1]), dtype=Q.dtype)
    tiles, largest = 0, 0
    for row_start in range(0, T, Br):
        query = Q[row_start:row_start + Br]
        rows = row_start + np.arange(len(query))
        maximum = np.full(len(query), -np.inf, dtype=Q.dtype)
        normaliser = np.zeros(len(query), dtype=Q.dtype)
        acc = np.zeros((len(query), V.shape[1]), dtype=Q.dtype)
        key_stop = min(T, row_start + Br) if causal else T
        for key_start in range(0, key_stop, Bc):
            key = K[key_start:key_start + Bc]
            scores = query @ key.T / np.sqrt(width)
            if causal:
                columns = key_start + np.arange(len(key))
                scores = np.where(columns[None, :] <= rows[:, None], scores, -np.inf)
            new_max = np.maximum(maximum, scores.max(axis=1))
            finite_max = np.where(np.isfinite(new_max), new_max, 0)
            rescale = np.exp(maximum - finite_max)
            weights = np.exp(scores - finite_max[:, None])
            acc = acc * rescale[:, None] + weights @ V[key_start:key_start + Bc]
            normaliser = normaliser * rescale + weights.sum(axis=1)
            maximum = new_max
            tiles += 1
            largest = max(largest, scores.nbytes)
        output[row_start:row_start + Br] = acc / normaliser[:, None]
    return output, tiles, largest


def dense_attention(Q, K, V, causal=True):
    scores = Q @ K.T / np.sqrt(Q.shape[1])
    if causal:
        scores = np.where(np.tri(len(Q), dtype=bool), scores, -np.inf)
    return safe_softmax(scores) @ V


print("three-token tiled output:")
print(tiled_attention(Q, K, V, Br=1, Bc=2)[0])
Q, K, V = (rng.normal(size=(1024, 64)) for _ in range(3))
for causal in (True, False):
    reference = dense_attention(Q, K, V, causal)
    result, tiles, largest = tiled_attention(Q, K, V, causal=causal)
    print(f"causal={causal}: float64 error {np.abs(result - reference).max():.1e}, "
          f"tiles {tiles}/256, largest scores {largest // 1024} KiB")
    assert np.allclose(result, reference, atol=1e-12)
    float_inputs = [a.astype(np.float32) for a in (Q, K, V)]
    float_result = tiled_attention(*float_inputs, causal=causal)[0]
    float_dense = dense_attention(*float_inputs, causal=causal)
    print(f"  float32 tiled error {np.abs(float_result - reference).max():.1e}, "
          f"dense error {np.abs(float_dense - reference).max():.1e}")
    assert np.allclose(float_result, reference, atol=2e-6)
print(f"dense scores: {1024 ** 2 * 8 // 1024 ** 2} MiB")
for Br, Bc in ((32, 128), (37, 53)):
    result = tiled_attention(Q, K, V, Br=Br, Bc=Bc)[0]
    assert np.allclose(result, dense_attention(Q, K, V), atol=1e-12)
print("unequal and non-dividing tiles: passed")
three-token tiled output:
[[1.    0.   ]
 [0.33  1.34 ]
 [1.759 2.007]]
causal=True: float64 error 5.6e-16, tiles 136/256, largest scores 32 KiB
  float32 tiled error 3.4e-07, dense error 3.3e-07
causal=False: float64 error 1.7e-16, tiles 256/256, largest scores 32 KiB
  float32 tiled error 1.7e-07, dense error 1.7e-07
dense scores: 8 MiB
unequal and non-dividing tiles: passed
最大分数块为 32 KiB,完整稠密分数矩阵为 8 MiB。这只是分数存储:分块实现还保留当前块的权重、累加器、输入与输出。这是教学用前向实现,不包含自定义反向传播,也没有利用 GPU 存储层级。
第 5 步:对 CPU 实现进行计时
for name, function in (("dense", dense_attention), ("tiled", tiled_attention)):
    started = time.perf_counter()
    function(Q, K, V)
    print(f"{name}: {time.perf_counter() - started:.3f} seconds (CPU NumPy)")
dense: 0.012 seconds (CPU NumPy)
tiled: 0.008 seconds (CPU NumPy)
这些单次计时受 BLAS、线程数和其他进程影响。GPU FlashAttention 的关键是避免在 HBM 中写入、读回巨大的分数和权重矩阵;CPU 的 Python 循环不能复现这种性能比较。
预期观察
在线、稠密、分块结果在舍入误差内一致。64 × 64 的因果分块只计算 256 块中的 136 块;改为不等或不完整的块,仍保持答案。
进一步尝试
- 删除累加器的重新缩放,用三 token 算例找到首个出错块。
- 保存逐行 log-sum-exp,反向传播时重算概率块。在长度 128 下,将梯度与 PyTorch 自动求导比较。
- 固定块大小,统计长度 512、1024、2048 时的分数存储;将输入输出存储与中间分数存储分开。
实验 4 — Llama 类模型的参数与 FLOP 计数器
目标。 编写计数器,读取解码器配置(词表、宽度、深度、查询头、KV 头、前馈宽度、权重共享、偏置),返回参数量、按 第 11 节 约定的单 token FLOPs,以及单 token KV cache 大小。用三种方式验证:构造本模块的 Decoder,与 PyTorch 参数量比较;与从 GPT-2 small 到 Llama-3-8B 的五个开放模型的公布规模比较;若安装 Hugging Face transformers,再在 PyTorch meta 设备上构造参考模型,无需分配 8B 权重或下载。你将理解为何 12Ld^2 规则对某模型误差不足 1%,对另一个却达 55%;小模型有多少参数用于嵌入;GQA 如何减少缓存;多长上下文下注意力不再可忽略。配置从各模型 config.json 手工录入,无需下载,运行只需几秒。
第 1 步 — 设置
计数本身不需要随机数,但本系列各实验都先固定种子,使构造的张量(这里是步骤 3 的解码器)每次相同。
from dataclasses import dataclass

import matplotlib.pyplot as plt
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F

np.random.seed(0)
torch.manual_seed(0)
第 2 步 — 描述模型,然后对其进行计数
仅解码器 Transformer 可以用少数数值与开关描述:
- 词表大小 V,残差流宽度 d;
- 层数 L,每层具有 h 宽度为 d_{\text{head}} = d/h 的查询头和 n_{kv} 键值头:n_{kv} = h 是多头注意力,1 < n_{kv} < h 是分组查询注意力, n_{kv} = 1 是多查询注意力(第 9 节);
- 前馈宽度 d_{\text{ff}},以及前馈网络是 SwiGLU (三个矩阵)还是普通的两矩阵 MLP (第 5 节);
- 输出投影是否与输入嵌入共享权重;
- 哪些线性层有偏置;位置使用可学习表(GPT-2)还是无参数的 RoPE;归一化使用 LayerNorm(增益与偏置,共 2d 个数)还是 RMSNorm(只有增益,共 d 个数)。
计数器将各个块逐块相加,与 第 11 节 完全相同。每层都容纳
模型还需一次性添加 Vd 个参数的 token 表;若输出不共享,再添加 Vd 个参数;可学习位置表增加 T_{\max} d,最终归一化另计。这里各模型满足 h d_{\text{head}} = d,所以注意力项为 2d^2 + 2d\,n_{kv} d_{\text{head}};多头注意力为 4d^2,分组查询则更少。
计数器也返回 N_{\text{matmul}},即每个 token 参与矩阵乘法的参数量。它等于 N_{\text{total}} 减去仅用于查找的表:不共享的输入嵌入与可学习位置表;读取第 i 行不需要矩阵运算。共享词表仍计入 N_{\text{matmul}},因为每个 token 都用它计算输出投影。字典分别列出单层和整个模型的数值,便于与论文对一个块的描述比较。
@dataclass
class Cfg:
    name: str
    V: int                   # vocabulary size
    d: int                   # width of the residual stream
    L: int                   # number of layers (blocks)
    h: int                   # query heads
    n_kv: int                # key-value heads: h is multi-head, 1 is multi-query
    d_ff: int                # inner width of the feed-forward network
    tied: bool               # does the output projection reuse the input embedding?
    glu: bool = True         # SwiGLU (three matrices) or a plain two-matrix MLP
    bias: str = "none"       # "none", "qkv" (on W_Q, W_K, W_V only) or "all"
    learned_pos: int = 0     # rows of a learned position table (0 with RoPE)
    norm_bias: bool = False  # LayerNorm has a gain and a bias; RMSNorm a gain only
    published: str = "-"     # the size its authors quote


def count(cfg):
    """Parameters of a decoder-only transformer, itemised as in Section 11."""
    d_head = cfg.d // cfg.h
    q_width = cfg.h * d_head        # all query heads side by side (equals d here)
    kv_width = cfg.n_kv * d_head    # narrower than d under GQA and MQA

    # Attention: W_Q is d x q_width, W_K and W_V are d x kv_width, W_O is q_width x d.
    attention = cfg.d * q_width + 2 * cfg.d * kv_width + q_width * cfg.d
    if cfg.bias in ("qkv", "all"):
        attention += q_width + 2 * kv_width     # one bias per output unit
    if cfg.bias == "all":
        attention += cfg.d                      # and one on W_O

    # Feed-forward: W_1 and W_3 (d x d_ff) and W_2 (d_ff x d), or W_1 and W_2 only.
    mlp = (3 if cfg.glu else 2) * cfg.d * cfg.d_ff
    if cfg.bias == "all":
        mlp += (2 if cfg.glu else 1) * cfg.d_ff + cfg.d

    # Two norms per layer (before attention, before the FFN) and one at the end.
    one_norm = 2 * cfg.d if cfg.norm_bias else cfg.d
    per_layer = attention + mlp + 2 * one_norm

    token_table = cfg.V * cfg.d
    embeddings = token_table * (1 if cfg.tied else 2) + cfg.learned_pos * cfg.d
    total = embeddings + cfg.L * per_layer + one_norm

    # A lookup is not a matrix multiply: an untied input embedding and a position
    # table cost no FLOPs. A tied table stays in, because it is used once per
    # token as the output projection.
    lookups = (0 if cfg.tied else token_table) + cfg.learned_pos * cfg.d
    return {
        "attention_per_layer": attention,
        "mlp_per_layer": mlp,
        "norms_per_layer": 2 * one_norm,
        "embeddings": embeddings,
        "attention": cfg.L * attention,
        "mlp": cfg.L * mlp,
        "norms": cfg.L * 2 * one_norm + one_norm,
        "total": total,
        "n_matmul": total - lookups,
    }


llama2 = Cfg("Llama-2-7B", V=32000, d=4096, L=32, h=32, n_kv=32, d_ff=11008,
             tied=False, published="6.7B")
c = count(llama2)
layer = c["attention_per_layer"] + c["mlp_per_layer"] + c["norms_per_layer"]
print(f"attention per layer   {c['attention_per_layer']:>15,}")
print(f"FFN per layer         {c['mlp_per_layer']:>15,}")
print(f"norms per layer       {c['norms_per_layer']:>15,}")
print(f"one layer             {layer:>15,}")
print(f"{llama2.L} layers             {llama2.L * layer:>15,}")
print(f"embeddings (untied)   {c['embeddings']:>15,}")
print(f"final norm            {llama2.d:>15,}")
print(f"N_total               {c['total']:>15,}")
print(f"N_matmul              {c['n_matmul']:>15,}")
attention per layer        67,108,864
FFN per layer             135,266,304
norms per layer                 8,192
one layer                 202,383,360
32 layers               6,476,267,520
embeddings (untied)       262,144,000
final norm                      4,096
N_total                 6,738,415,616
N_matmul                6,607,343,616
各项都可手算复核。注意力包含四个 4096 \times 4096 矩阵,共 4 \times 16{,}777{,}216 = 67{,}108{,}864;SwiGLU 包含三个 4096 \times 11{,}008 矩阵,共 135{,}266{,}304,略多于近似规则的 8d^2 = 134{,}217{,}728,因为 11{,}008 是将 \tfrac{8}{3}d = 10{,}922.7 向上取整为 256 的倍数。两个 RMSNorm 增益共 2 \times 4{,}096 = 8{,}192。三十二层、两个不共享的 32{,}000 \times 4{,}096 表、最终归一化共 6{,}738{,}415{,}616,即 Llama 2 论文的 6.7B。减去仅查找的输入表,剩下 N_{\text{matmul}} = 6{,}607{,}343{,}616,用于步骤 7 的 FLOP 乘法计数。
步骤 3 — 用 PyTorch 验证计数器
公式需要验证,最可靠的检查之一是实际构造模型:PyTorch 能统计它分配的参数张量。下面代码与 第 12 节 的 Decoder 相同,只重新排版为每行 88 字符;初始化和 实验 5 使用的 causal 开关也保留。两者都不影响参数计数。
构造两种大小:模块默认配置(词表 4,096、d = 256、四层、八个查询头、两个 KV 头),以及实验 5 的配置(词表 46、d = 128、四层、四个查询头、两个 KV 头)。将计数器与张量元素总数比较。输出投影与输入嵌入为同一个张量(self.head.weight = self.emb.weight),model.parameters() 只遍历每个张量一次,因此共享矩阵只计一次。若逐模块累加各自权重,会重复计数;最后一行展示这种错误脚本的结果。
def rope(x, base=10000.0):
    """x: (B, h, T, dk). Rotate pairs of dims by position-dependent angles."""
    B, h, T, dk = x.shape
    theta = base ** (-torch.arange(0, dk, 2, device=x.device) / dk)   # (dk/2,)
    ang = torch.arange(T, device=x.device)[:, None] * theta[None, :]   # (T, dk/2)
    cos, sin = ang.cos()[None, None], ang.sin()[None, None]
    x1, x2 = x[..., 0::2], x[..., 1::2]
    return torch.stack([x1 * cos - x2 * sin, x1 * sin + x2 * cos], dim=-1).flatten(-2)


class Attention(nn.Module):
    def __init__(self, d, n_heads, n_kv_heads, causal=True):
        super().__init__()
        self.h, self.kv, self.dk = n_heads, n_kv_heads, d // n_heads
        self.causal = causal
        self.wq = nn.Linear(d, d, bias=False)
        self.wk = nn.Linear(d, n_kv_heads * self.dk, bias=False)
        self.wv = nn.Linear(d, n_kv_heads * self.dk, bias=False)
        self.wo = nn.Linear(d, d, bias=False)

    def forward(self, x):
        B, T, d = x.shape
        q = self.wq(x).view(B, T, self.h, self.dk).transpose(1, 2)    # (B, h, T, dk)
        k = self.wk(x).view(B, T, self.kv, self.dk).transpose(1, 2)
        v = self.wv(x).view(B, T, self.kv, self.dk).transpose(1, 2)
        q, k = rope(q), rope(k)
        k = k.repeat_interleave(self.h // self.kv, dim=1)    # grouped-query: share KV
        v = v.repeat_interleave(self.h // self.kv, dim=1)
        y = F.scaled_dot_product_attention(q, k, v, is_causal=self.causal)
        return self.wo(y.transpose(1, 2).reshape(B, T, d))


class Block(nn.Module):
    def __init__(self, d, n_heads, n_kv_heads, d_ff, causal=True):
        super().__init__()
        self.n1, self.n2 = nn.RMSNorm(d), nn.RMSNorm(d)
        self.attn = Attention(d, n_heads, n_kv_heads, causal)
        self.w1 = nn.Linear(d, d_ff, bias=False)
        self.w3 = nn.Linear(d, d_ff, bias=False)
        self.w2 = nn.Linear(d_ff, d, bias=False)

    def forward(self, x):
        x = x + self.attn(self.n1(x))                           # pre-norm residual
        h = self.n2(x)
        return x + self.w2(F.silu(self.w1(h)) * self.w3(h))    # SwiGLU feed-forward


class Decoder(nn.Module):
    def __init__(self, vocab, d=256, layers=4, n_heads=8, n_kv_heads=2, d_ff=None,
                 causal=True):
        super().__init__()
        d_ff = d_ff or int(8 * d / 3)
        self.emb = nn.Embedding(vocab, d)
        self.blocks = nn.ModuleList(Block(d, n_heads, n_kv_heads, d_ff, causal)
                                    for _ in range(layers))
        self.norm = nn.RMSNorm(d)
        self.head = nn.Linear(d, vocab, bias=False)
        self.head.weight = self.emb.weight                          # tied embeddings
        nn.init.normal_(self.emb.weight, std=0.02)    # keeps step-0 logits small

    def forward(self, tokens):                                  # tokens: (B, T) ints
        x = self.emb(tokens)
        for b in self.blocks:
            x = b(x)
        return self.head(self.norm(x))                          # logits: (B, T, vocab)


tiny = Cfg("tiny decoder", V=4096, d=256, L=4, h=8, n_kv=2, d_ff=int(8 * 256 / 3),
           tied=True)
lab5 = Cfg("Lab 5 decoder", V=46, d=128, L=4, h=4, n_kv=2, d_ff=int(8 * 128 / 3),
           tied=True)
for cfg in (tiny, lab5):
    model = Decoder(vocab=cfg.V, d=cfg.d, layers=cfg.L, n_heads=cfg.h,
                    n_kv_heads=cfg.n_kv)
    in_torch = sum(p.numel() for p in model.parameters())   # shared tensor: once
    print(f"{cfg.name:<14} d_ff {cfg.d_ff:>3}   counter {count(cfg)['total']:>10,}"
          f"   PyTorch {in_torch:>10,}")

model = Decoder(vocab=4096)
print("head and embedding are one tensor:", model.head.weight is model.emb.weight)
twice = sum(p.numel() for _, p in model.named_parameters(remove_duplicate=False))
print(f"counting the shared matrix twice would give {twice:,}")
tiny decoder   d_ff 682   counter  3,801,344   PyTorch  3,801,344
Lab 5 decoder  d_ff 341   counter    727,424   PyTorch    727,424
head and embedding are one tensor: True
counting the shared matrix twice would give 4,849,920
计数器与 PyTorch 在两种配置上完全一致:3,801,344 是第 12 节的“约 3.8M”,727,424 是实验 5 的模型。注意 d_ff:\tfrac{8}{3} \times 256 = 682.7、\tfrac{8}{3} \times 128 = 341.3,int 将二者截断。共享矩阵若计两次,会额外增加 4{,}096 \times 256 = 1{,}048{,}576 个参数,夸大 28%;从 state_dict 计数时容易出现这一错误,因为共享张量列在两个名称下。练习 12 要求手工逐项算出 3,801,344;可在步骤 4 前完成,并与 count(tiny) 返回的字典逐项比较。
步骤 4 — 对照公开模型配置
接下来检查公开模型。以下配置来自各模型 config.json,各有 12Ld^2 规则未考虑的特征:
- GPT-2 小(2019):多头注意力,宽度为 4d 的 GELU MLP,每个线性层上的偏差,带有偏差的 LayerNorm,1,024 个位置的学习表,共享嵌入。
- SmolLM2-135M:九个查询头共享三个 KV 头,宽度为 1{,}536 = \tfrac{8}{3}d 的 SwiGLU 网络,共享嵌入。
- Qwen2.5-0.5B:十四个查询头共享两个 KV 头,仅 \mathbf{W}_Q、\mathbf{W}_K、\mathbf{W}_V 有偏置;SwiGLU 很宽(4{,}864 \approx 5.4d),词表 151,936 个 token,嵌入共享。
- Llama-2-7B:步骤 2 的配置。
- Llama-3-8B:32 个查询头共享 8 个 KV 头,SwiGLU 宽度 14{,}336 = 3.5d,词表包含 128,256 个 token,输入与输出权重不共享。
代码打印各模型精确计数、12Ld^2 估计、非嵌入参数与该估计的比值、嵌入占比(token 表及 GPT-2 位置表),以及论文规模。第二张表用 d^2 为单位表示一层,从而解释近似规则为何有偏差。
configs = [
    tiny,
    Cfg("GPT-2 small", V=50257, d=768, L=12, h=12, n_kv=12, d_ff=3072, tied=True,
        glu=False, bias="all", learned_pos=1024, norm_bias=True, published="124M"),
    Cfg("SmolLM2-135M", V=49152, d=576, L=30, h=9, n_kv=3, d_ff=1536, tied=True,
        published="135M"),
    Cfg("Qwen2.5-0.5B", V=151936, d=896, L=24, h=14, n_kv=2, d_ff=4864, tied=True,
        bias="qkv", published="0.49B"),
    llama2,
    Cfg("Llama-3-8B", V=128256, d=4096, L=32, h=32, n_kv=8, d_ff=14336, tied=False,
        published="8B"),
]

print(f"{'model':<16}{'N_total':>15}{'12Ld^2':>15}{'ratio':>7}{'emb':>7}"
      f"{'published':>11}")
for cfg in configs:
    c = count(cfg)
    rule = 12 * cfg.L * cfg.d ** 2
    non_embedding = c["total"] - c["embeddings"]
    print(f"{cfg.name:<16}{c['total']:>15,}{rule:>15,}{non_embedding / rule:>7.3f}"
          f"{c['embeddings'] / c['total']:>7.1%}{cfg.published:>11}")

print("\none layer in units of d^2 (the rule assumes 4 + 8 = 12)")
for cfg in configs:
    c = count(cfg)
    d2 = cfg.d ** 2
    print(f"{cfg.name:<16} attention {c['attention_per_layer'] / d2:5.2f}"
          f"   FFN {c['mlp_per_layer'] / d2:5.2f}"
          f"   layer {(c['attention_per_layer'] + c['mlp_per_layer']) / d2:5.2f}")
model                   N_total         12Ld^2  ratio    emb  published
tiny decoder          3,801,344      3,145,728  0.875  27.6%          -
GPT-2 small         124,439,808     84,934,656  1.001  31.6%       124M
SmolLM2-135M        134,515,008    119,439,360  0.889  21.0%       135M
Qwen2.5-0.5B        494,032,768    231,211,008  1.548  27.6%      0.49B
Llama-2-7B        6,738,415,616  6,442,450,944  1.005   3.9%       6.7B
Llama-3-8B        8,030,261,248  6,442,450,944  1.083  13.1%         8B

one layer in units of d^2 (the rule assumes 4 + 8 = 12)
tiny decoder     attention  2.50   FFN  7.99   layer 10.49
GPT-2 small      attention  4.01   FFN  8.01   layer 12.01
SmolLM2-135M     attention  2.67   FFN  8.00   layer 10.67
Qwen2.5-0.5B     attention  2.29   FFN 16.29   layer 18.57
Llama-2-7B       attention  4.00   FFN  8.06   layer 12.06
Llama-3-8B       attention  2.50   FFN 10.50   layer 13.00
每个计数都四舍五入到其作者引用的大小,并且每个与规则的偏离都可以从第二个表中读出。在分组下,\mathbf{W}_K和\mathbf{W}_V将d映射到n_{kv} d_{\text{head}} = (n_{kv}/h)\,d维度,因此注意力成本为2d^2 + 2d^2 n_{kv}/h 4d^2:2 + 2/3 = 2.67 用于 SmolLM2(三个 KV 头对应 9 个),2 + 2/7 = 2.29 用于 Qwen2.5(两个对应 14 个),2 + 2/4 = 2.5 用于 Llama-3 和小型解码器(两个对应 8 个)。前馈网络的成本为 3 d_{\text{ff}}/d,单位为 d^2:当 d_{\text{ff}} = \tfrac{8}{3}d (SmolLM2) 时恰好为 8,对于 Llama-3 为 3 \times 3.5 = 10.5,3 \times 5.43 = 16.29 对于 Qwen2.5,其前馈网络本身就大于规则的整个层。因此,SmolLM2-135M 的非嵌入计数比规则低 11%,Qwen2.5-0.5B 比规则高 55%,而对于 GPT-2 Small 和 Llama-2-7B(这两个模型按照规则假设的方式构建),其误差在 0.5% 以内。
嵌入列解释了另一半原因。50,000–150,000 个 token 的词表,乘以 576–896 的宽度,就是数千万参数;所以小模型的五分之一到三分之一用于嵌入,Llama-2-7B 则不到 4%。Llama-3-8B 升回 13%,因为词表是 Llama 2 的四倍,且输入与输出不共享。第 11 节的结论是按配置计数;近似规则只适合满足 d_{\text{ff}} \approx \tfrac{8}{3}d(SwiGLU)或 4d(GELU)的较大多头模型,并应标明是估计。
步骤 5 — 每个 token 的 KV cache
生成时,每层保存此前所有 token 的键和值(第 9 节),因此每新增一个 token,缓存增加量为
因子 2 计入 K 与 V,bf16 每值占 2 字节。查询头数不出现,因为只存储 n_{kv} 个 KV 头。与第 9 节相同,张量大小用二进制单位(1 KiB = 1,024 B,1 MiB = 2^{20} B,1 GiB = 2^{30} B),后续第 07–10 模块引用时同时给出十进制 GB。代码后半固定 Llama-2-7B 配置,只改变 n_{kv},比较长度 4,096 的单序列缓存与权重;图 6.15 使用这一结果。
def kv_cache_bytes_per_token(cfg, bytes_per_value=2):
    """K and V of one token, in every layer and every KV head (bf16: 2 bytes)."""
    d_head = cfg.d // cfg.h
    return 2 * cfg.L * cfg.n_kv * d_head * bytes_per_value


print(f"{'model':<16}{'KV heads':>9}{'bytes/token':>13}{'KiB':>8}")
for cfg in configs:
    per_token = kv_cache_bytes_per_token(cfg)
    print(f"{cfg.name:<16}{cfg.n_kv:>9}{per_token:>13,}{per_token / 1024:>8.1f}")

seq_len = 4096
print(f"\none {seq_len:,}-token sequence at the Llama-2-7B shape, bf16")
for label, n_kv in (("multi-head, 32 KV heads", 32), ("grouped, 8 KV heads", 8),
                    ("multi-query, 1 KV head", 1)):
    shape = Cfg(label, V=32000, d=4096, L=32, h=32, n_kv=n_kv, d_ff=11008,
                tied=False)
    per_token = kv_cache_bytes_per_token(shape)
    per_sequence = per_token * seq_len
    print(f"{label:<24}{per_token:>9,} B/token {per_sequence / 2**20:>7,.0f} MiB"
          f"  ({per_sequence / 1e9:.3f} GB)")
weight_bytes = count(llama2)["total"] * 2
print(f"Llama-2-7B weights in bf16: {weight_bytes / 1e9:.1f} GB"
      f" ({weight_bytes / 2**30:.1f} GiB)")
model            KV heads  bytes/token     KiB
tiny decoder            2        1,024     1.0
GPT-2 small            12       36,864    36.0
SmolLM2-135M            3       23,040    22.5
Qwen2.5-0.5B            2       12,288    12.0
Llama-2-7B             32      524,288   512.0
Llama-3-8B              8      131,072   128.0

one 4,096-token sequence at the Llama-2-7B shape, bf16
multi-head, 32 KV heads   524,288 B/token   2,048 MiB  (2.147 GB)
grouped, 8 KV heads       131,072 B/token     512 MiB  (0.537 GB)
multi-query, 1 KV head     16,384 B/token      64 MiB  (0.067 GB)
Llama-2-7B weights in bf16: 13.5 GB (12.6 GiB)
缓存取决于 KV 头,并不直接取决于参数量。GPT-2 small 保留全部 12 个头,每 token 缓存是参数量约大四倍的 Qwen2.5-0.5B 的三倍;后者十四个查询头只共享两个 KV 头。Llama-2-7B 的 4,096-token 序列缓存为 2,048 MiB = 2 GiB(2.15 GB),是 12.6 GiB 权重的六分之一;约六条并发序列的缓存就与权重一样大。八个 KV 头(Llama-3-8B 布局)将缓存降四倍至 512 MiB,再降到一个 KV 头可减少八倍至 64 MiB。缓存与权重的比例影响服务器 batch 中可容纳的请求数,第 10 模块 据此构建内存预算。
步骤 6 — 在 meta 设备上验证参考实现
公布规模经过取整,不能核对最后一位。Hugging Face transformers 的参考实现无需下载权重。在 PyTorch 的 meta 设备上,张量只有形状和 dtype,没有数据存储;在 with torch.device("meta"): 中构造模型,会执行构造函数并注册参数,不分配权重。8B 模型可以在几分之一秒内、仅用少量元数据构造。配置类使用与 Cfg 相同的数值。GPT-2 默认配置就是 small;SmolLM2 与两个 Llama 使用 Llama 类;Qwen2.5 使用 Qwen2 类,为查询、键、值投影添加偏置。未安装 transformers 时,代码提示后继续其他步骤。
try:
    from transformers import (GPT2Config, GPT2LMHeadModel, LlamaConfig,
                              LlamaForCausalLM, Qwen2Config, Qwen2ForCausalLM)
    have_transformers = True
except ImportError:
    have_transformers = False
    print("transformers is not installed: skipping the cross-check")


def reference_model(cfg):
    """The Hugging Face implementation of a configuration (weights not allocated
    when built on the meta device)."""
    if cfg.name == "GPT-2 small":
        return GPT2LMHeadModel(GPT2Config())       # the defaults are GPT-2 small
    shape = dict(vocab_size=cfg.V, hidden_size=cfg.d, intermediate_size=cfg.d_ff,
                 num_hidden_layers=cfg.L, num_attention_heads=cfg.h,
                 num_key_value_heads=cfg.n_kv, tie_word_embeddings=cfg.tied)
    if cfg.bias == "qkv":
        return Qwen2ForCausalLM(Qwen2Config(**shape))
    return LlamaForCausalLM(LlamaConfig(**shape))


if have_transformers:
    for cfg in configs[1:]:
        with torch.device("meta"):         # shapes only: no memory is allocated
            reference = reference_model(cfg)
        n_reference = sum(p.numel() for p in reference.parameters())
        verdict = "same" if n_reference == count(cfg)["total"] else "DIFFERENT"
        print(f"{cfg.name:<14} transformers {n_reference:>15,}   counter "
              f"{count(cfg)['total']:>15,}   {verdict}")
GPT-2 small    transformers     124,439,808   counter     124,439,808   same
SmolLM2-135M   transformers     134,515,008   counter     134,515,008   same
Qwen2.5-0.5B   transformers     494,032,768   counter     494,032,768   same
Llama-2-7B     transformers   6,738,415,616   counter   6,738,415,616   same
Llama-3-8B     transformers   8,030,261,248   counter   8,030,261,248   same
五个模型的参数量全部一致。参考实现由其他人为其他目的编写,所以一致性检验了计数器的假设:偏置的位置、GPT-2 位置表和 LayerNorm 偏置的计数,以及输入输出表究竟是否共享。
第 7 步 — 每个 token 的前向 FLOPs
第 11 节约定,(m \times n) 与 (n \times p) 矩阵相乘需 2mnp FLOPs,每项计一次乘法与一次加法。单 token 时 m = 1,所以 N_{\text{matmul}} 中每个权重参与一次乘加,矩阵成本为 2N_{\text{matmul}} FLOP。注意力还添加两项无参数乘积。上下文 t 时,查询给 t 个键打分,每层跨头共 2td FLOPs(因为 h d_{\text{head}} = d),再以 2td FLOPs 混合 t 个值;L 层共 4Ldt。因果掩码下,位置 t 只看到 t 个键,长度 T 序列的平均为
前提是 kernel 跳过被屏蔽的一半,就像 FlashAttention 的因果分块所做的那样 (第 10 节)。下面的函数实现了这两种形式,并且在 train=True 的情况下,实现了步骤 8 的 3 的因子。最后两行找到了注意力成本与矩阵相乘一样多的地方。对于一个 token,4Ldt = 2N_{\text{matmul}} 给出 t = N_{\text{matmul}}/(2Ld);与 N_{\text{matmul}} \approx 12Ld^2 是 t \approx 6d。对因果序列进行平均,2LdT = 2N_{\text{matmul}} 给出 T = N_{\text{matmul}}/(Ld) \approx 12d。
def flops_per_token(cfg, t, causal_avg=False, train=False):
    """Section 11's convention. With causal_avg=False, t is the context of one token;
    with causal_avg=True, t is the length T of a causally masked sequence and the
    attention term is the average over its positions."""
    matmul = 2 * count(cfg)["n_matmul"]
    if causal_avg:
        attention = 2 * cfg.L * cfg.d * t
    else:
        attention = 4 * cfg.L * cfg.d * t
    forward = matmul + attention
    return 3 * forward if train else forward


GFLOP = 1e9
matmul = flops_per_token(llama2, 0)
print(f"matrix multiplies, 2 N_matmul: {matmul / GFLOP:.2f} GFLOP per token")
for t in (512, 4096, 32768):
    attention = flops_per_token(llama2, t) - matmul
    print(f"one token at context {t:>6,}: attention {attention / GFLOP:5.2f} GFLOP,"
          f" {attention / (matmul + attention):5.1%} of its total,"
          f" +{attention / matmul:.1%} on the matmuls")
average = flops_per_token(llama2, 4096, causal_avg=True) - matmul
print(f"causal 4,096-token sequence, average: attention {average / GFLOP:.2f} GFLOP,"
      f" +{average / matmul:.1%}")

t_cross = matmul / (4 * llama2.L * llama2.d)
T_cross = matmul / (2 * llama2.L * llama2.d)
print(f"one token: attention = matmuls at t = {t_cross:,.0f}"
      f"   (rule 6d = {6 * llama2.d:,})")
print(f"causal average: attention = matmuls at T = {T_cross:,.0f}"
      f"   (rule 12d = {12 * llama2.d:,})")
matrix multiplies, 2 N_matmul: 13.21 GFLOP per token
one token at context    512: attention  0.27 GFLOP,  2.0% of its total, +2.0% on the matmuls
one token at context  4,096: attention  2.15 GFLOP, 14.0% of its total, +16.3% on the matmuls
one token at context 32,768: attention 17.18 GFLOP, 56.5% of its total, +130.0% on the matmuls
causal 4,096-token sequence, average: attention 1.07 GFLOP, +8.1%
one token: attention = matmuls at t = 25,205   (rule 6d = 24,576)
causal average: attention = matmuls at T = 50,410   (rule 12d = 49,152)
上下文 512 个 token 时,注意力仅占 2%,几乎可忽略。在完整 4,096 上下文的最后 token,注意力占总 FLOPs 的 14%(在矩阵乘法成本上增加 16%);整个训练序列平均只增加 8.1%,因为各位置平均只看到一半上下文。32,768 时,注意力超过总计算的一半。精确交叉点 25,205、50,410 比近似 6d、12d 高 2.6%,因为 N_{\text{matmul}} 比 12Ld^2 大 2.6%,包含输出投影(Vd = 131{,}072{,}000)和略宽的 FFN。
第 8 步 — 每个 token 的训练 FLOPs
层 \mathbf{Y} = \mathbf{X}\mathbf{W} 的反向传播计算两个乘积,其主导计算量都与前向相同:\partial\mathcal{L}/\partial\mathbf{X} = (\partial\mathcal{L}/\partial\mathbf{Y})\,\mathbf{W}^\top 传递梯度,\partial\mathcal{L}/\partial\mathbf{W} = \mathbf{X}^\top(\partial\mathcal{L}/\partial\mathbf{Y}) 计算权重梯度。注意力的两项无参数乘积也如此,所以训练约需三次前向,即每 token 6N_{\text{matmul}} + 6LdT,对长度 T 的因果序列取平均(第 11 节推导)。常用简化公式 6N_{\text{total}} 计入全部参数、忽略注意力。代码在 Llama-2-7B 的训练长度 4,096 下比较二者,并拆分两种误差来源。
T = 4096
convention = flops_per_token(llama2, T, causal_avg=True, train=True)
shortcut = 6 * count(llama2)["total"]
matmul_part = 6 * count(llama2)["n_matmul"]
attention_part = 6 * llama2.L * llama2.d * T
lookup_part = 6 * llama2.V * llama2.d        # the input embedding: never multiplied
print(f"convention, 6 N_matmul + 6LdT: {matmul_part / GFLOP:.2f}"
      f" + {attention_part / GFLOP:.2f} = {convention / GFLOP:.2f} GFLOP per token")
print(f"shortcut, 6 N_total:           {shortcut / GFLOP:.2f} GFLOP per token,"
      f" {(convention - shortcut) / convention:.1%} low")
print(f"  counts the input embedding:  +{lookup_part / GFLOP:.2f} GFLOP never spent")
print(f"  leaves out attention:        -{attention_part / GFLOP:.2f} GFLOP")
convention, 6 N_matmul + 6LdT: 39.64 + 3.22 = 42.87 GFLOP per token
shortcut, 6 N_total:           40.43 GFLOP per token, 5.7% low
  counts the input embedding:  +0.79 GFLOP never spent
  leaves out attention:        -3.22 GFLOP
简化公式有两个反向误差:为只需查找的输入嵌入错误计入每 token 0.79 GFLOP,又漏掉注意力的 3.22 GFLOP。两者不抵消,6N_{\text{total}} 比本模块约定低 5.7%。作为初步估计已足够接近,所以常被采用;但计算利用率时,该差别仍有意义。练习 13 将单 token 成本换算为整个 Llama 2 训练的计算预算与 GPU 利用率;用 6ND 规划预算则是 第 08 模块 的内容。
第 9 步 — 参数所在位置
将步骤 4 的表变成图:各公开模型一根条形,归一化为 100%,分为嵌入、注意力、前馈网络、归一化,总数标在末端。这就是第 11 节的图 6.16。归一化不足各模型的 0.1%,因此比条形轮廓还薄。
published = configs[1:]
parts = ["embeddings", "attention", "mlp", "norms"]
part_names = {"embeddings": "embeddings", "attention": "attention",
              "mlp": "feed-forward", "norms": "norms"}
colours = {"embeddings": "#2563EB", "attention": "#C2410C",
           "mlp": "#7E22CE", "norms": "#15803D"}


def short(n):
    """124439808 -> '124.4M', 6738415616 -> '6.74B'."""
    return f"{n / 1e9:.2f}B" if n >= 1e9 else f"{n / 1e6:.1f}M"


fig, ax = plt.subplots(figsize=(8, 3.6))
for row, cfg in enumerate(published):
    c = count(cfg)
    left = 0.0
    for part in parts:
        share = 100 * c[part] / c["total"]
        ax.barh(row, share, left=left, height=0.6, color=colours[part],
                edgecolor="white", linewidth=1.5,
                label=part_names[part] if row == 0 else None)
        left += share
    ax.text(101.5, row, short(c["total"]), va="center", fontsize=10)
ax.set_yticks(range(len(published)), [cfg.name for cfg in published])
ax.invert_yaxis()                      # first model at the top
ax.set_xlim(0, 112)
ax.set_xticks(range(0, 101, 20))
ax.set_xlabel("share of all parameters (%)")
ax.set_title("Where the parameters are: five published decoders")
ax.legend(ncols=4, loc="upper center", bbox_to_anchor=(0.45, -0.2), frameon=False)
plt.tight_layout()
plt.show()
三个小模型有五分之一到三分之一用于嵌入(SmolLM2 21%、Qwen2.5 28%、GPT-2 32%)。Llama-2-7B 几乎全部是层,而每层约三分之二是 FFN。Qwen2.5-0.5B 的注意力占比最小,因为分组减少注意力参数,同时很宽的 FFN 增大了其他部分。
步骤 10 — 注意力与矩阵乘法的成本
最后绘制步骤 7 的结果,上下文长度在对数轴上从 512 到 131,072:固定的矩阵乘法成本、上下文 t 下单 token 的注意力成本与总成本、长度 T 因果序列的平均注意力成本。两条竖线标出交叉点,对应图 6.17。
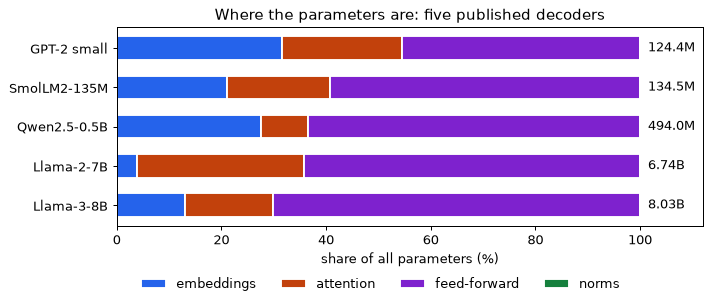
contexts = np.logspace(np.log10(512), np.log10(131072), 200)
matmul_g = np.full_like(contexts, matmul / GFLOP)
one_token_g = 4 * llama2.L * llama2.d * contexts / GFLOP
causal_avg_g = 2 * llama2.L * llama2.d * contexts / GFLOP

fig, ax = plt.subplots(figsize=(8, 5))
ax.plot(contexts, matmul_g, color="#1A2E4A", label="matrix multiplies, 2 N_matmul")
ax.plot(contexts, one_token_g, color="#C2410C",
        label="attention, one token at context t (4Ldt)")
ax.plot(contexts, matmul_g + one_token_g, color="#2563EB",
        label="total for that token")
ax.plot(contexts, causal_avg_g, color="#15803D", linestyle="--",
        label="attention, average over a causal sequence of length T (2LdT)")
# mark the crossovers; the labels sit on opposite sides so that they never overlap
for x, text, side in ((t_cross, f"t = {t_cross:,.0f}\n(6d = {6 * llama2.d:,})", "right"),
                      (T_cross, f"T = {T_cross:,.0f}\n(12d = {12 * llama2.d:,})", "left")):
    ax.axvline(x, color="#94A3B8", linewidth=1, linestyle=":")
    nudge = 0.95 if side == "right" else 1.05
    ax.text(x * nudge, 76, text, ha=side, fontsize=9, color="#475569")
ax.set_xscale("log")
ax.set_xlim(512, 131072)
ax.set_ylim(0, 85)
ax.set_xlabel("context length (tokens, log scale)")
ax.set_ylabel("forward GFLOP per token")
ax.set_title("Llama-2-7B: attention overtakes the matrix multiplies at about 6d")
ax.legend(loc="upper center", bbox_to_anchor=(0.5, -0.14), ncols=2, fontsize=9,
          frameon=False)
plt.tight_layout()
plt.show()
从左到右看图:上下文只有几千 token 时,总成本接近平线,“每参数每 token 两次 FLOP”很准确。单 token 注意力线在 t = 25{,}205 与平线相交,之后注意力比全部模型权重的乘法还贵;因果平均在两倍距离 T = 50{,}410 相交。两条注意力曲线对 t 都是线性,因此在对数横轴上向上弯曲:上下文加倍,注意力项加倍,矩阵乘法项不变。
预期观察
- 计数器与模块的两个解码器(3,801,344 和 727,424)的 PyTorch 参数以及所有五个已发布模型的参考实现一致,并且每个计数四舍五入到其作者引用的大小:124M、135M、0.49B、6.7B 和 8B。
- 对于 GPT-2 Small 和 Llama-2-7B,非嵌入计数在 12Ld^2 规则的 0.5% 范围内,这两个模型是按照规则假设构建的(多头注意力,前馈网络约为 8d^2),但 SmolLM2-135M 比它低 11%,Qwen2.5-0.5B 比它高 55%:分组查询注意力每层删除最多 2d^2,宽前馈网络添加 3 d_{\text{ff}}/d - 8 个 d^2 单位。
- 小模型的五分之一到三分之一用于嵌入,Llama-2-7B 不足 4%;Llama-3-8B 更大的词表和不共享的权重使其回升至 13%。
- KV cache 遵循 KV 头的数量:对于 Llama-2-7B 的 32 个头,每个 token 512 KiB;对于 Llama-3-8B 的 8 个头,每个 token 128 KiB; Llama-2-7B 形状的单个 4,096 个 token 序列花费 2 GiB,即权重的六分之一。
- 短上下文时注意力 FLOPs 很小(512 个 token 下占 2%)。单 token 上下文超过约 6d 时,注意力超过矩阵乘法(Llama-2-7B 为 25,205);因果序列平均的交叉点约为 12d(50,410)。
- 按本模块约定,在 T = 4{,}096 下训练 Llama-2-7B,每 token 需 42.87 GFLOP;简化公式 6N_{\text{total}} 得到 40.43,低估 5.7%。
进一步尝试
- 混合专家。 为
Cfg添加n_experts、top_k两个字段。改变计数器,使各层存储n_experts份 FFN 加一个路由器(d \times n_{\text{experts}} 矩阵),而n_matmul只计入每 token 实际经过的top_k个专家。基于 Llama-2-7B 配置,采用 8 个专家、top-2 路由,打印总参数与活跃参数;应约为 37.0B 与 11.1B(包括两个嵌入表)。概念见 第 05 模块,工程见 第 08 模块。 - 未录入的配置。 联网时,用
transformers.AutoConfig.from_pretrained获取HuggingFaceTB/SmolLM2-360M的配置(约 1 KB,不下载权重),从字段构造Cfg,确认 361,821,120 个参数;再用 meta 设备上的LlamaForCausalLM核对。 - 缓存随上下文长度变化。 编写函数返回单序列 KV cache 大小。对 Llama-2-7B 配置,分别绘制 32、8、1 个 KV 头,从 1,000 到 128,000 token 的曲线,并在权重大小 12.6 GiB 处画水平线。读出各布局中单序列缓存超过权重所需的上下文长度。
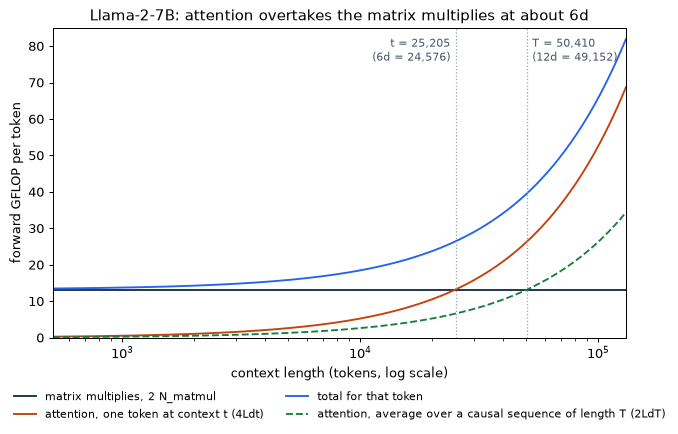
实验 5 — 训练小型 GPT、采样并移除掩码
目标。 用生成的维护记录训练字符级解码器,将损失与数据源熵比较,并测试生成记录。再用相同架构去掉因果掩码训练;仅前缀评分会揭示普通留出窗口损失遗漏的问题。实验独立运行,不下载数据。
步骤一:生成记录
QUICK = True 采用 300 步因果训练、200 步无掩码训练。设为 False 后,因果训练变为 FULL_STEPS = 1500 步,无掩码仍为 200 步。使用四个 CPU 线程,与其他实验可比;实际耗时取决于机器,完整运行可能需几分钟。较长训练给复制机制更多形成时间。
import collections
import json
import math
import random
import re
import time
import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
import torch.nn.functional as F

QUICK = True
FULL_STEPS = 1500
torch.set_num_threads(4)
torch.manual_seed(0)
np.random.seed(0)
source_rng = random.Random(0)
specs = {
    "P": ("pump", "pressure", "bar", 0.5, 7.5, 2.0, 6.0),
    "T": ("tank", "level", "%", 2, 99, 10, 90),
    "C": ("compressor", "speed", "rpm", 2400, 3300, 2600, 3100),
    "H": ("exchanger", "outlet", "C", 35, 95, 40, 85),
    "V": ("valve", "position", "%", 0, 100, None, None),
}


def status_for(letter, value):
    low, high = specs[letter][-2:]
    if low is None:
        return "OK"
    return "LOW" if value < low else "HIGH" if value > high else "OK"


lines = []
for _ in range(12000):
    letter = source_rng.choice("PTCHV")
    identifier = f"{letter}-{source_rng.randint(0, 999):03d}"
    kind, quantity, unit, low, high, _, _ = specs[letter]
    value = (source_rng.uniform(low, high) if letter == "P"
             else source_rng.randint(low, high))
    shown = f"{value:.1f}" if letter == "P" else str(value)
    # Status is determined by the displayed value so records can be checked exactly.
    status = status_for(letter, float(shown))
    lines.append(f"{identifier} {kind} {quantity} {shown} {unit} "
                 f"{status} end {identifier}\n")
corpus = "".join(lines)
alphabet = sorted(set(corpus))
encode = {character: index for index, character in enumerate(alphabet)}
tokens = torch.tensor([encode[c] for c in corpus], dtype=torch.long)
split = int(0.9 * len(tokens))
train_data, valid_data = tokens[:split], tokens[split:]
vocab = len(alphabet)
print(f"mode: {'QUICK' if QUICK else 'FULL'}")
print(f"characters {len(corpus):,}, lines {len(lines):,}, vocabulary {vocab}")
print("".join(lines[:3]), end="")
mode: QUICK
characters 486,841, lines 12,000, vocabulary 46
H-776 exchanger outlet 91 C HIGH end H-776
H-041 exchanger outlet 51 C OK end H-041
V-497 valve position 51 % OK end V-497
结束标识符重复开头标识符,状态由显示数值确定。因此,生成器只在记录类型、标识符和值上引入随机性。按字符位置划分可能切开记录,但窗口严格留在各自划分内,不会将验证目标暴露给训练窗口。
步骤 2:参考熵
下面的单元组与二元组熵,是训练字符的代入估计。生成器熵按记录类型、数量及取整压力值的真实分布计算。对均匀压力取整后,两端区间只有普通区间的一半宽,71 个显示值并非等概率。
def entropy(probabilities):
    p = np.asarray(probabilities, dtype=float)
    p = p[p > 0]
    return float(-(p * np.log(p)).sum())


training_text = corpus[:split]
counts = collections.Counter(training_text)
unigram = entropy(np.array(list(counts.values())) / len(training_text))
pairs = collections.Counter(zip(training_text[:-1], training_text[1:]))
previous = collections.Counter(training_text[:-1])
bigram = -sum(n / (len(training_text) - 1) * math.log(n / previous[a])
              for (a, b), n in pairs.items())
mean_length, value_entropy = 0., 0.
for letter, (kind, quantity, unit, low, high, _, _) in specs.items():
    if letter == "P":
        values = np.arange(5, 76) / 10
        probabilities = np.full(71, 1 / 70)
        probabilities[[0, -1]] /= 2
    else:
        values = np.arange(low, high + 1)
        probabilities = np.full(len(values), 1 / len(values))
    value_entropy += entropy(probabilities) / 5
    for value, probability in zip(values, probabilities):
        shown = f"{value:.1f}" if letter == "P" else str(int(value))
        record = (f"{letter}-000 {kind} {quantity} {shown} {unit} "
                  f"{status_for(letter, float(value))} end {letter}-000\n")
        mean_length += len(record) * probability / 5
line_entropy = math.log(5) + math.log(1000) + value_entropy
true_floor = line_entropy / mean_length
no_copy_floor = (line_entropy + math.log(1000)) / mean_length
print(f"uniform {math.log(vocab):.3f}, unigram {unigram:.3f}, bigram {bigram:.3f}")
print(f"generator: {line_entropy:.3f} nats/line, {mean_length:.3f} chars/line")
print(f"true entropy {true_floor:.3f}, no-copy reference {no_copy_floor:.3f} nats/char")
uniform 3.829, unigram 3.410, bigram 1.717
generator: 13.392 nats/line, 40.558 chars/line
true entropy 0.330, no-copy reference 0.501 nats/char
无法复制参考值假设设备字母已由记录确定,但重复的三位数字要重新预测,每行增加 log(1000)。它描述一种受限预测器,不是完整数据源的熵。
第 3 步:完整的解码器和初始化检查
此处重复了模型代码,因此本实验不需要 实验 4 中的变量。 RoPE 使用相邻对,并且键头和值头都在连续组中扩展。
def rope(x, base=10000.0):
    """x: (B, h, T, dk). Rotate pairs of dims by position-dependent angles."""
    B, h, T, dk = x.shape
    theta = base ** (-torch.arange(0, dk, 2, device=x.device) / dk)   # (dk/2,)
    ang = torch.arange(T, device=x.device)[:, None] * theta[None, :]   # (T, dk/2)
    cos, sin = ang.cos()[None, None], ang.sin()[None, None]
    x1, x2 = x[..., 0::2], x[..., 1::2]
    return torch.stack([x1 * cos - x2 * sin, x1 * sin + x2 * cos], dim=-1).flatten(-2)


class Attention(nn.Module):
    def __init__(self, d, n_heads, n_kv_heads, causal=True):
        super().__init__()
        self.h, self.kv, self.dk = n_heads, n_kv_heads, d // n_heads
        self.causal = causal
        self.wq = nn.Linear(d, d, bias=False)
        self.wk = nn.Linear(d, n_kv_heads * self.dk, bias=False)
        self.wv = nn.Linear(d, n_kv_heads * self.dk, bias=False)
        self.wo = nn.Linear(d, d, bias=False)

    def forward(self, x):
        B, T, d = x.shape
        q = self.wq(x).view(B, T, self.h, self.dk).transpose(1, 2)    # (B, h, T, dk)
        k = self.wk(x).view(B, T, self.kv, self.dk).transpose(1, 2)
        v = self.wv(x).view(B, T, self.kv, self.dk).transpose(1, 2)
        q, k = rope(q), rope(k)
        k = k.repeat_interleave(self.h // self.kv, dim=1)    # grouped-query: share KV
        v = v.repeat_interleave(self.h // self.kv, dim=1)
        y = F.scaled_dot_product_attention(q, k, v, is_causal=self.causal)
        return self.wo(y.transpose(1, 2).reshape(B, T, d))


class Block(nn.Module):
    def __init__(self, d, n_heads, n_kv_heads, d_ff, causal=True):
        super().__init__()
        self.n1, self.n2 = nn.RMSNorm(d), nn.RMSNorm(d)
        self.attn = Attention(d, n_heads, n_kv_heads, causal)
        self.w1 = nn.Linear(d, d_ff, bias=False)
        self.w3 = nn.Linear(d, d_ff, bias=False)
        self.w2 = nn.Linear(d_ff, d, bias=False)

    def forward(self, x):
        x = x + self.attn(self.n1(x))                           # pre-norm residual
        h = self.n2(x)
        return x + self.w2(F.silu(self.w1(h)) * self.w3(h))    # SwiGLU feed-forward


class Decoder(nn.Module):
    def __init__(self, vocab, d=256, layers=4, n_heads=8, n_kv_heads=2, d_ff=None,
                 causal=True):
        super().__init__()
        d_ff = d_ff or int(8 * d / 3)
        self.emb = nn.Embedding(vocab, d)
        self.blocks = nn.ModuleList(Block(d, n_heads, n_kv_heads, d_ff, causal)
                                    for _ in range(layers))
        self.norm = nn.RMSNorm(d)
        self.head = nn.Linear(d, vocab, bias=False)
        self.head.weight = self.emb.weight                          # tied embeddings
        nn.init.normal_(self.emb.weight, std=0.02)    # keeps step-0 logits small

    def forward(self, tokens):                                  # tokens: (B, T) ints
        x = self.emb(tokens)
        for b in self.blocks:
            x = b(x)
        return self.head(self.norm(x))                          # logits: (B, T, vocab)


def make_model(causal):
    torch.manual_seed(0)
    return Decoder(vocab=vocab, d=128, layers=4, n_heads=4, n_kv_heads=2,
                   causal=causal)


def batch(data, generator, B=32, T=128):
    starts = torch.randint(len(data) - T, (B,), generator=generator)
    windows = data[starts[:, None] + torch.arange(T + 1)]
    return windows[:, :-1], windows[:, 1:]


x0, y0 = batch(train_data, torch.Generator().manual_seed(1))
bad = make_model(True)
with torch.no_grad():
    nn.init.normal_(bad.emb.weight, std=1.0)
    bad_loss = F.cross_entropy(bad(x0).reshape(-1, vocab), y0.reshape(-1)).item()
good = make_model(True)
with torch.no_grad():
    good_loss = F.cross_entropy(good(x0).reshape(-1, vocab), y0.reshape(-1)).item()
print(f"parameters: {sum(p.numel() for p in good.parameters()):,}")
print(f"unit-scale tied embeddings: {bad_loss:.3f}")
print(f"std 0.02 embeddings: {good_loss:.3f}; uniform baseline {math.log(vocab):.3f}")
assert sum(p.numel() for p in good.parameters()) == 727424
del bad, good
parameters: 727,424
unit-scale tied embeddings: 115.321
std 0.02 embeddings: 3.881; uniform baseline 3.829
单位尺度反例故意重新初始化共享表,具体值随随机抽样变化。它说明,若初始损失远高于 log(vocab),应在训练前调查。
第四步:因果训练
验证始终采用十个固定的留出 batch,训练使用独立随机生成器;模型没有 dropout。因此,各检查点损失对应同一组验证窗口。输出不打印耗时,避免机器负载干扰数值比较。
@torch.no_grad()
def validation_loss(model):
    model.eval()
    generator = torch.Generator().manual_seed(2)
    losses = []
    for _ in range(10):
        x, y = batch(valid_data, generator)
        losses.append(F.cross_entropy(model(x).reshape(-1, vocab), y.reshape(-1)).item())
    return float(np.mean(losses))


def train(causal, steps):
    model = make_model(causal)
    optimiser = torch.optim.AdamW(model.parameters(), lr=3e-3,
                                 betas=(0.9, 0.95), weight_decay=0.1)
    generator = torch.Generator().manual_seed(1)
    curve = []
    for step in range(1, steps + 1):
        progress = max(0, (step - 50) / (steps - 50))
        scale = step / 50 if step <= 50 else 0.5 * (1 + math.cos(math.pi * progress))
        for group in optimiser.param_groups:
            group["lr"] = 3e-3 * scale
        model.train()
        x, y = batch(train_data, generator)
        loss = F.cross_entropy(model(x).reshape(-1, vocab), y.reshape(-1))
        optimiser.zero_grad(set_to_none=True)
        loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimiser.step()
        if step == 1 or step % 100 == 0 or step == steps:
            held_out = validation_loss(model)
            curve.append((step, loss.item(), held_out))
            print(f"step {step:4d}: train {loss.item():.3f}, validation {held_out:.3f}",
                  flush=True)
    return model, curve


causal, causal_curve = train(True, 300 if QUICK else FULL_STEPS)
step    1: train 3.881, validation 3.858
step  100: train 0.562, validation 0.567
step  200: train 0.540, validation 0.542
step  300: train 0.533, validation 0.532
QUICK 不保证学会远距离复制。若模型学会复用开头标识符,较长训练可将损失降到无法复制参考值以下;转变时刻会随浮点计算与训练配置变化。若完整运行恰在转变期间结束,可尝试 FULL_STEPS = 2000,并报告额外计算量。
第 5 步:采样和解析
用固定采样生成器、温度 0.8,采样 32 条独立序列。排除各样本最后一条不完整行;单独报告格式错误。标识符与状态准确率只对格式正确的行计算。
@torch.no_grad()
def sample(model, count=32, steps=240):
    model.eval()
    generator = torch.Generator().manual_seed(3)
    sequence = torch.full((count, 1), encode["\n"], dtype=torch.long)
    for _ in range(steps):
        probabilities = (model(sequence[:, -128:])[:, -1] / 0.8).softmax(-1)
        next_token = torch.multinomial(probabilities, 1, generator=generator)
        sequence = torch.cat((sequence, next_token), dim=1)
    return ["".join(alphabet[i] for i in row) for row in sequence.tolist()]


pattern = re.compile(
    r"^([PTCHV])-(\d{3}) (\w+) (\w+) (\d+(?:\.\d)?) (\S+) "
    r"(OK|LOW|HIGH) end ([PTCHV]-\d{3})$")


def score_samples(texts):
    complete = [line for text in texts for line in text.split("\n")[1:-1]]
    parsed, copied, correct_status = 0, 0, 0
    for line in complete:
        match = pattern.fullmatch(line)
        if match is None:
            continue
        letter, digits, kind, quantity, shown, unit, status, closing = match.groups()
        spec = specs[letter]
        if (kind, quantity, unit) != spec[:3]:
            continue
        parsed += 1
        copied += closing == f"{letter}-{digits}"
        correct_status += status == status_for(letter, float(shown))
    print(f"complete {len(complete)}, well-formed {parsed} "
          f"({parsed / max(1, len(complete)):.1%})")
    print(f"among well-formed: identifier copied {copied / max(1, parsed):.1%}, "
          f"correct status {correct_status / max(1, parsed):.1%}")
    return dict(complete=len(complete), parsed=parsed, copied=copied,
                correct_status=correct_status)


causal_samples = sample(causal)
print(causal_samples[0])
causal_scores = score_samples(causal_samples)
P-201 pump pressure 4.6 bar OK end P-828
C-143 compressor speed 3096 rpm HIGH end C-583
T-238 tank level 40 % OK end T-413
P-172 pump pressure 4.7 bar OK end P-495
T-280 tank level 79 % OK end T-998
C-987 compressor speed 3325 rpm HIGH end
complete 176, well-formed 170 (96.6%)
among well-formed: identifier copied 0.0%, correct status 90.0%
格式、复制、状态是三个不同的成功标准。看似合理的记录,结尾标识符仍可能错误。这个合成解析器只能检验本实验的规则,不能验证真实维护决策。
第 6 步:不使用掩码进行训练并评估前缀
采用相同初始化与训练 batch 种子,只改变因果标志。随机留出窗口为各次仅前缀预测提供实际可用的 8–127 个前缀字符,不提供目标。
unmasked, unmasked_curve = train(False, 200)
unmasked_samples = sample(unmasked)
print("unmasked sample:")
print(unmasked_samples[0])
unmasked_scores = score_samples(unmasked_samples)


@torch.no_grad()
def prefix_loss(model, predictions=200):
    model.eval()
    generator = torch.Generator().manual_seed(5)
    losses = []
    for _ in range(predictions):
        start = int(torch.randint(len(valid_data) - 129, (), generator=generator))
        length = int(torch.randint(8, 128, (), generator=generator))
        prefix = valid_data[start:start + length][None]
        target = valid_data[start + length][None]
        losses.append(F.cross_entropy(model(prefix)[:, -1], target).item())
    return float(np.mean(losses))


causal_prefix, unmasked_prefix = prefix_loss(causal), prefix_loss(unmasked)
print(f"prefix-only loss: causal {causal_prefix:.3f}, unmasked {unmasked_prefix:.3f}")
print(f"window validation: causal {validation_loss(causal):.3f}, "
      f"unmasked {validation_loss(unmasked):.3f}")
step    1: train 3.907, validation 3.860
step  100: train 0.336, validation 0.338
step  200: train 0.011, validation 0.014
unmasked sample:

-iitir rrrerl rr aar e er 88888888888888888888878888  an e H-888 H-888 excharer r 89 % OK end T-888
H-78 exchanger outlet 888 C LOW end H-888
H-888 exchGH-8888 lve bale C OK end H-888
T-888 tanr level 88 % OK end T-880
H-883 exchanger outle
complete 83, well-formed 0 (0.0%)
among well-formed: identifier copied 0.0%, correct status 0.0%
prefix-only loss: causal 0.521, unmasked 1.291
window validation: causal 0.532, unmasked 0.014
无掩码模型在窗口评估中能读取大多数目标;最后输入位置例外,因为下一字符在窗口之外。仅前缀评估去掉各测试位置的泄漏。模型预测时使用未来输入,无法用留出划分弥补。
第 7 步:比较曲线
fig, ax = plt.subplots(figsize=(8, 4.5))
for name, curve, style in (("causal", causal_curve, "-"),
                            ("unmasked", unmasked_curve, "--")):
    values = np.asarray(curve)
    ax.plot(values[:, 0], values[:, 2], style, label=f"{name}, validation")
for level, name in ((math.log(vocab), "uniform"), (unigram, "unigram"),
                    (bigram, "bigram"), (no_copy_floor, "no-copy reference"),
                    (true_floor, "generator entropy")):
    ax.axhline(level, linewidth=0.8, alpha=0.5, label=f"{name}: {level:.3f}")
ax.set_xscale("log")
ax.set_xlabel("training step")
ax.set_ylabel("loss (nats per character)")
ax.set_title(f"Maintenance records: {'QUICK' if QUICK else 'FULL'} run")
ax.legend(fontsize=8)
plt.tight_layout()
plt.show()
metrics = dict(mode="QUICK" if QUICK else "FULL", causal_curve=causal_curve,
               unmasked_curve=unmasked_curve, causal_scores=causal_scores,
               unmasked_scores=unmasked_scores, causal_prefix=causal_prefix,
               unmasked_prefix=unmasked_prefix, true_floor=true_floor,
               no_copy_floor=no_copy_floor)
with open("m06-lab5-metrics.json", "w", encoding="utf-8") as stream:
    json.dump(metrics, stream, indent=2)
预期观察
格式与局部规律改善时,因果损失会低于单元组、二元组参考。比较复制成功率与损失是否低于无法复制参考。无掩码模型的窗口损失可能很低,但仅前缀损失和生成记录会暴露泄漏。上面打印的是实际 QUICK 运行;完整运行观察单独列在下面。
使用 QUICK = False,实际 1500 步因果训练得到验证损失 0.399、仅前缀损失 0.394。生成 172 条完整行,全部可解析;155 条正确复制标识符(90.1%),171 条状态正确(99.4%)。约 1000 步后,验证损失低于无法复制参考。无掩码对照仍为窗口损失 0.014、仅前缀损失 1.291,83 条完整生成行均不可解析。保留上方 QUICK 输出,使默认代码与显示结果对应同一次运行。
进一步尝试
- 使用 0.2–2 MB 的公共领域文本;重新计算词汇和经验熵。
- 将上下文缩至 32 个字符,检查预测各结尾字符时,开头标识符的哪些部分仍可见。不要假定一层适用于所有记录长度,因为该语料包含不同格式与长度。
- 在温度 0.3 和 1.5 下重复采样并再次评分格式、复制和状态。
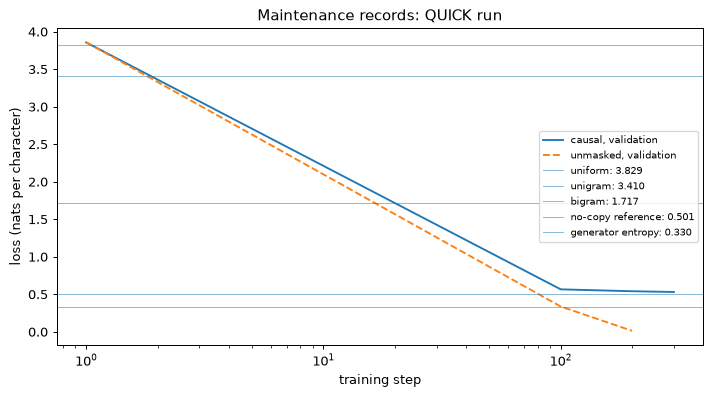
实验 6 — 寻找归纳头
目标。 用重复随机片段训练仅包含注意力的 Transformer,测量前一 token 与归纳注意力模式,并干预各头。比较两层模型与一层对照。全部数据在本地生成,不下载模型。
步骤 1:生成一个复制距离不同的任务
抽取一条 64-token 序列,再抽取 10–32 的片段长度,将首段立即重复。重复部分的首个 token 无法由前缀预测,后续 token 则可预测。目标向前移一位,所以位置 j 的可预测目标,由查询位置 j - 1 评估。
import json
import numpy as np
import matplotlib.pyplot as plt
import torch
import torch.nn as nn
import torch.nn.functional as F

np.random.seed(0)
torch.manual_seed(0)
torch.set_num_threads(4)
VOCAB, LENGTH, STEPS = 64, 64, 1500


def repeated_batch(generator, count=64):
    tokens = torch.randint(VOCAB, (count, LENGTH), generator=generator)
    segment = torch.randint(10, 33, (count,), generator=generator)
    predictable = torch.zeros_like(tokens, dtype=torch.bool)
    for row, n in enumerate(segment.tolist()):
        tokens[row, n:2 * n] = tokens[row, :n].clone()
        predictable[row, n + 1:2 * n] = True
    return tokens[:, :-1], tokens[:, 1:], predictable[:, 1:], segment


x, y, predictable, segment = repeated_batch(torch.Generator().manual_seed(1))
print("inputs", tuple(x.shape), "targets", tuple(y.shape))
print("segment lengths:", segment[:8].tolist())
print(f"predictable target share: {predictable.float().mean():.3f}")
assert all(torch.equal(x[row, n:2 * n - 1], x[row, :n - 1])
           for row, n in enumerate(segment.tolist()))
inputs (64, 63) targets (64, 63)
segment lengths: [13, 13, 21, 25, 16, 22, 13, 14]
predictable target share: 0.295
固定复制距离可被位置规则解决;改变距离,迫使模型寻找较早的匹配 token,再使用其后继 token。随机 token 冲突仍会造成歧义;该任务分布不保证每个重复 token 都有唯一匹配。
步骤 2 — 暴露注意力权重与各头输出
显式 softmax 允许检查注意力,并在输出投影前将某个头的输出置零。消融移除整个头的贡献,而非单个注意力条目。模型没有前馈子层。
def rotary(x):
    T, dk = x.shape[-2:]
    frequencies = 10000.0 ** (-torch.arange(0, dk, 2) / dk)
    angles = torch.arange(T)[:, None] * frequencies[None]
    cosine, sine = angles.cos()[None, None], angles.sin()[None, None]
    first, second = x[..., 0::2], x[..., 1::2]
    return torch.stack((first * cosine - second * sine,
                        first * sine + second * cosine), dim=-1).flatten(-2)


class InspectableBlock(nn.Module):
    def __init__(self, width=64, heads=4):
        super().__init__()
        self.heads, self.dk = heads, width // heads
        self.norm = nn.RMSNorm(width)
        self.qkv = nn.Linear(width, 3 * width, bias=False)
        self.output = nn.Linear(width, width, bias=False)

    def forward(self, x, zero_heads=()):
        B, T, d = x.shape
        q, k, v = (a.reshape(B, T, self.heads, self.dk).transpose(1, 2)
                   for a in self.qkv(self.norm(x)).chunk(3, dim=-1))
        q, k = rotary(q), rotary(k)
        scores = q @ k.transpose(-1, -2) / self.dk ** 0.5
        future = torch.ones(T, T, dtype=torch.bool).triu(1)
        weights = scores.masked_fill(future, -torch.inf).softmax(-1)
        head_output = weights @ v
        if zero_heads:
            head_output = head_output.clone()
            head_output[:, list(zero_heads)] = 0
        merged = head_output.transpose(1, 2).reshape(B, T, d)
        return x + self.output(merged), weights


class CopyModel(nn.Module):
    def __init__(self, layers):
        super().__init__()
        self.embedding = nn.Embedding(VOCAB, 64)
        nn.init.normal_(self.embedding.weight, std=0.02)
        self.blocks = nn.ModuleList(InspectableBlock() for _ in range(layers))
        self.norm = nn.RMSNorm(64)
        self.head = nn.Linear(64, VOCAB, bias=False)

    def forward(self, tokens, ablate=None):
        x, maps = self.embedding(tokens), []
        for layer, block in enumerate(self.blocks):
            x, weights = block(x, (ablate or {}).get(layer, ()))
            maps.append(weights)
        return self.head(self.norm(x)), maps


model = CopyModel(2)
print(f"two-layer parameters: {sum(p.numel() for p in model.parameters()):,}")
two-layer parameters: 41,152
第 3 步:训练和分离可预测目标
对所有目标训练,不只训练重复区域。用固定的新 batch 分别报告可预测与不可预测位置的损失。后者是有用对照:即使复制改善,随机非复制目标仍应很难。
@torch.no_grad()
def evaluate(model, count=256, seed=9, ablate=None):
    model.eval()
    x, y, predictable, segment = repeated_batch(
        torch.Generator().manual_seed(seed), count)
    logits, maps = model(x, ablate)
    losses = F.cross_entropy(logits.reshape(-1, VOCAB), y.reshape(-1),
                             reduction="none").reshape_as(y)
    return (losses[predictable].mean().item(),
            losses[~predictable].mean().item(), maps, predictable, segment, x)


def fit(layers):
    torch.manual_seed(0)
    model = CopyModel(layers)
    optimiser = torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=0)
    generator = torch.Generator().manual_seed(1)
    curve = []
    for step in range(1, STEPS + 1):
        model.train()
        x, y, _, _ = repeated_batch(generator)
        logits, _ = model(x)
        loss = F.cross_entropy(logits.reshape(-1, VOCAB), y.reshape(-1))
        optimiser.zero_grad(set_to_none=True)
        loss.backward()
        optimiser.step()
        if step == 1 or step % 100 == 0:
            repeated, random_loss, *_ = evaluate(model, count=64)
            curve.append((step, repeated, random_loss))
            print(f"layers {layers}, step {step:4d}: copy {repeated:.3f}, "
                  f"other {random_loss:.3f}", flush=True)
    return model, curve


two_layer, two_curve = fit(2)
layers 2, step    1: copy 4.290, other 4.307
layers 2, step  100: copy 3.917, other 4.211
layers 2, step  200: copy 3.771, other 4.221
layers 2, step  300: copy 3.639, other 4.231
layers 2, step  400: copy 3.524, other 4.256
layers 2, step  500: copy 3.401, other 4.281
layers 2, step  600: copy 2.871, other 4.346
layers 2, step  700: copy 1.197, other 4.513
layers 2, step  800: copy 0.829, other 4.424
layers 2, step  900: copy 0.579, other 4.361
layers 2, step 1000: copy 0.436, other 4.332
layers 2, step 1100: copy 0.374, other 4.324
layers 2, step 1200: copy 0.346, other 4.305
layers 2, step 1300: copy 0.374, other 4.285
layers 2, step 1400: copy 0.338, other 4.287
layers 2, step 1500: copy 0.304, other 4.288
步骤 4 — 量化各头关注的位置
前一 token 分数,对所有非首位查询,平均从查询 t 到键 t - 1 的权重。对于可预测查询 t,较早的后继位于键 t - n + 1,其中 n 是片段长度。归纳分数平均该键的权重。使用 256 条新序列计算,而不是挑选一个好看的例子。
@torch.no_grad()
def head_scores(model):
    repeated, random_loss, maps, predictable, segment, x = evaluate(model)
    previous_scores, induction_scores = [], []
    batch_ids, query_ids = predictable.nonzero(as_tuple=True)
    key_ids = query_ids - segment[batch_ids] + 1
    for layer, weights in enumerate(maps):
        previous = weights.diagonal(offset=-1, dim1=-2, dim2=-1).mean(dim=(0, 2))
        induction = weights[batch_ids, :, query_ids, key_ids].mean(dim=0)
        previous_scores.append(previous.numpy())
        induction_scores.append(induction.numpy())
        print(f"layer {layer}: previous "
              + " ".join(f"{v:.3f}" for v in previous.tolist()))
        print(f"layer {layer}: induction "
              + " ".join(f"{v:.3f}" for v in induction.tolist()))
    print(f"held-out copy loss {repeated:.3f}, other loss {random_loss:.3f}")
    return previous_scores, induction_scores, maps, segment


previous, induction, maps, segments = head_scores(two_layer)
previous_head = int(np.argmax(previous[0]))
induction_head = int(np.argmax(induction[1]))
fig, axes = plt.subplots(1, 2, figsize=(10, 4))
for ax, layer, head, title in (
        (axes[0], 0, previous_head, "strongest layer-0 previous-token score"),
        (axes[1], 1, induction_head, "strongest layer-1 induction score")):
    pattern = maps[layer][0, head].numpy()
    image = ax.imshow(pattern, vmin=0, vmax=1, origin="upper", cmap="Blues")
    ax.set_xlabel("key position")
    ax.set_ylabel("query position")
    ax.set_title(f"{title}\nhead {head}, segment length {int(segments[0])}", fontsize=9)
    fig.colorbar(image, ax=ax, fraction=0.046)
plt.tight_layout()
plt.show()
layer 0: previous 0.631 0.300 0.119 0.110
layer 0: induction 0.000 0.000 0.001 0.001
layer 1: previous 0.052 0.035 0.041 0.037
layer 1: induction 0.927 0.920 0.935 0.922
held-out copy loss 0.286, other loss 4.297
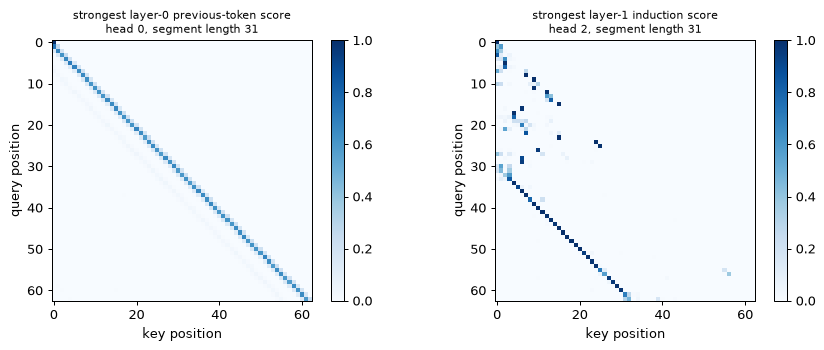
第五步:对每个头进行干预
在相同的 512 条新序列上评估各干预。损失增大说明该头对当前模型在该分布上的预测有贡献,却不能证明它是某个人类概念的唯一实现。
baseline = evaluate(two_layer, count=512, seed=11)[0]
print(f"baseline copy loss {baseline:.3f}")
ablations = []
for layer in range(2):
    for head in range(4):
        loss = evaluate(two_layer, count=512, seed=11, ablate={layer: [head]})[0]
        ablations.append((layer, head, loss))
        print(f"zero layer {layer}, head {head}: {loss:.3f}, change {loss - baseline:+.3f}")
    loss = evaluate(two_layer, count=512, seed=11, ablate={layer: list(range(4))})[0]
    print(f"zero all heads in layer {layer}: {loss:.3f}")
baseline copy loss 0.270
zero layer 0, head 0: 2.866, change +2.596
zero layer 0, head 1: 1.373, change +1.103
zero layer 0, head 2: 2.855, change +2.585
zero layer 0, head 3: 2.811, change +2.541
zero all heads in layer 0: 4.518
zero layer 1, head 0: 2.265, change +1.995
zero layer 1, head 1: 1.986, change +1.716
zero layer 1, head 2: 2.513, change +2.242
zero layer 1, head 3: 1.873, change +1.603
zero all heads in layer 1: 4.399
移除整层是超出训练状态分布的干预。应结合单头干预和注意力分数解读,不把某次损失变化视为完整解释。
第 6 步:单层控制
使用相同 batch 生成器、训练步数与优化器。一层模型参数更少,且只有一个注意力阶段,因此同时改变容量与可用计算。它测试的是此处的具体设置,不能证明一层 Transformer 普遍无法复制。
one_layer, one_curve = fit(1)
one_previous, one_induction, _, _ = head_scores(one_layer)
fig, ax = plt.subplots(figsize=(8, 4))
for name, curve in (("two layers", two_curve), ("one layer", one_curve)):
    curve = np.asarray(curve)
    ax.plot(curve[:, 0], curve[:, 1], label=f"{name}, predictable")
ax.axhline(math_log_vocab := float(np.log(VOCAB)), color="grey", linestyle=":",
           label=f"uniform guess: {math_log_vocab:.2f}")
ax.set_xlabel("training step")
ax.set_ylabel("held-out loss (nats per token)")
ax.set_title("Copying a variable-distance repeated segment")
ax.legend()
plt.tight_layout()
plt.show()
metrics = dict(two_curve=two_curve, one_curve=one_curve,
               previous=[a.tolist() for a in previous],
               induction=[a.tolist() for a in induction],
               ablations=ablations, baseline=baseline,
               one_induction=[a.tolist() for a in one_induction])
with open("m06-lab6-metrics.json", "w", encoding="utf-8") as stream:
    json.dump(metrics, stream, indent=2)
layers 1, step    1: copy 4.259, other 4.303
layers 1, step  100: copy 4.068, other 4.172
layers 1, step  200: copy 3.681, other 4.218
layers 1, step  300: copy 3.547, other 4.223
layers 1, step  400: copy 3.474, other 4.234
layers 1, step  500: copy 3.436, other 4.232
layers 1, step  600: copy 3.433, other 4.224
layers 1, step  700: copy 3.378, other 4.242
layers 1, step  800: copy 3.378, other 4.237
layers 1, step  900: copy 3.353, other 4.244
layers 1, step 1000: copy 3.339, other 4.240
layers 1, step 1100: copy 3.331, other 4.248
layers 1, step 1200: copy 3.337, other 4.242
layers 1, step 1300: copy 3.334, other 4.243
layers 1, step 1400: copy 3.324, other 4.240
layers 1, step 1500: copy 3.317, other 4.240
layer 0: previous 0.025 0.031 0.024 0.032
layer 0: induction 0.068 0.065 0.068 0.063
held-out copy loss 3.338, other loss 4.243
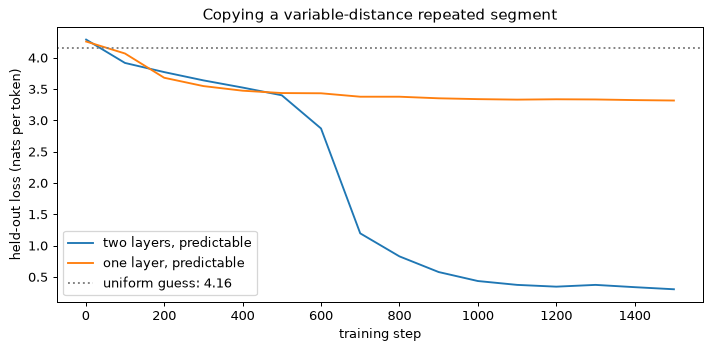
预期观察
比较复制损失曲线、注意力分数与消融效果。两层架构在这个任务中可以结合早期搬运的 token 信息和后续查找;一层对照检验这种组合的帮助程度。即使注意力分数不高,某个头仍可能通过值与输出投影影响结果;热图不是完整证据。打印数值来自本实验实际运行,其他机器的末位或转变时刻可能不同。
进一步尝试
- 将段长度固定为 32,并与可变距离的一层控制进行比较。
- 添加 SwiGLU,分别比较同宽度与相近参数量的损失曲线,明确报告采用哪一种比较。
- 用种子 1、2 重复训练,检查是否学会复制,以及哪些头呈现相应模式;不同种子下,头编号不必对应相同作用。
练习
使用自然对数,一次乘加计两次 FLOP。计算遵循 第 11 节 的约定。先独立尝试,再展开解答。
解释为何对任意有限的查询和键,因果注意力的第一个输出都精确等于第一个值向量。它预测下一个 token 时能使用哪些信息?
查看解答
只有第一个键可见,单个分数的 softmax 为 e^s/e^s=1,所以输出为 \mathbf{v}_1。该位置的后续各层也有相同信息边界:可依赖第一个 token 和位置,不能依赖后续 token。这并不决定具体损失;某些数据源中,第一个 token 已能高度确定下一个 token。
向三 token 算例加入 \mathbf{q}_4=\mathbf{k}_4=(1,-1)。去掉因果掩码,以四阶单位矩阵为值矩阵,计算各输出行,保留三位小数。解释前三行如何变化,以及正交键为何仍有权重。恢复掩码后,哪些行不变?
查看解答
未缩放分数各行为 (1,0,1,1)、(0,1,1,-1)、(1,1,2,0)、(1,-1,0,2),分别除以 \sqrt2。四种可能的指数为 1、e^{1/\sqrt2}=2.028115、e^{-1/\sqrt2}=0.493069、e^{\sqrt2}=4.113250。逐行归一化得到
因为 \mathbf{V}=\mathbf{I},所以 \mathbf{O}=\mathbf{P}。第四个键向每个无掩码分母加入正的指数项,改变所有前三行。虽然它与查询 3 正交,权重仍为 0.109,因为零分数的指数为 1,不是 0。恢复因果掩码后,前三行看不到键 4,保留原权重,只在第四分量补零。
头宽度为 128 时,查询与键的元素独立、方差为 1。描述未缩放点积的尺度,并解释对学习查询与键投影的影响。
查看解答
方差为 128,标准差为 \sqrt{128}=11.31。随机分数差距过大,可使 softmax 接近独热分布;雅可比元素 p_i(1-p_i)、-p_i p_j 变小,削弱到达查询、键投影的梯度。除以 \sqrt{128} 可在这些独立性假设下恢复单位方差,但不强制训练后的分数方差仍为 1。
设 \mathbf{P} 为置换矩阵,证明无位置信息、无掩码的自注意力满足 \operatorname{Attention}(\mathbf{P}\mathbf{X})= \mathbf{P}\operatorname{Attention}(\mathbf{X})。再证明,固定查询、同时同序排列键和值时,输出不变。固定因果掩码是否对任意置换仍保留第一个恒等式?
查看解答
线性投影给出 \mathbf{Q}'=\mathbf{P}\mathbf{Q}、\mathbf{K}'=\mathbf{P}\mathbf{K} 和 \mathbf{V}'=\mathbf{P}\mathbf{V}。因此分数变为 \mathbf{S}'=\mathbf{P}\mathbf{S}\mathbf{P}^{\top}。排列行会重新排序独立的 softmax 计算。排列列会重新排序每行的指数,而不更改其分母。因此, \softmax(\mathbf{S}')=\mathbf{P}\softmax(\mathbf{S})\mathbf{P}^{\top} 和
固定查询,同时排列键和值,分数变为 \mathbf{S}\mathbf{P}^{\top},softmax 为 \softmax(\mathbf{S})\mathbf{P}^{\top};乘以 \mathbf{P}\mathbf{V} 时排列抵消。固定因果掩码与序列索引绑定,通常不等于它自身置换后的版本,所以任意置换不能保留上述恒等式。无位置信息、无掩码注意力对 token 排列等变;位置编码或依赖顺序的掩码,才提供内容集合缺少的顺序信息。
写出前置与后置归一化的残差更新,找出直接恒等路径。说明它对深层梯度意味着什么,又不保证什么。
查看解答
前置归一化为 \mathbf{x}_{\ell+1}=\mathbf{x}_{\ell}+ F_{\ell}(\operatorname{Norm}(\mathbf{x}_{\ell})),后置归一化为 \mathbf{x}_{\ell+1}=\operatorname{Norm}(\mathbf{x}_{\ell}+F_{\ell}(\mathbf{x}_{\ell}))。前者的雅可比为恒等矩阵加子层导数,直接残差路径不经过中间归一化的雅可比;后者的残差路径也经过这些矩阵。因此,前者提供更简单的梯度路径,却不保证所有梯度有界或非零:分支可能尺度不当,也可能相互抵消。最终输出归一化同样有自己的导数。
将 RoPE 写为二维旋转的块对角矩阵,证明相对位置点积恒等式与范数保持。若值也按绝对位置旋转,输出如何变化?
查看解答
对于频率对 \theta_i,使用
相乘两个旋转块,利用角度加法公式得到 \mathbf{R}(a)\mathbf{R}(b)=\mathbf{R}(a+b),转置得到 \mathbf{R}(a)^{\top}=\mathbf{R}(-a)。因此逐块有 \mathbf{R}_t^{\top}\mathbf{R}_s=\mathbf{R}_{s-t}、(\mathbf{R}_t\mathbf{q})^{\top}(\mathbf{R}_s\mathbf{k}) =\mathbf{q}^{\top}\mathbf{R}_{s-t}\mathbf{k}。又因 \mathbf{R}_t^{\top}\mathbf{R}_t=\mathbf{I},故 \|\mathbf{R}_t\mathbf{q}\|^2=\mathbf{q}^{\top}\mathbf{q}。若值也旋转,输出为 \mathbf{o}_t=\sum_s p_{ts}\mathbf{R}_s\mathbf{v}_s。共同平移 c 保持权重不变,却将输出变为 \mathbf{R}_c\mathbf{o}_t。分数仍是相对的,输出坐标却带有绝对旋转;普通 RoPE 因此不旋转值。
某模型只学习了 1024 个位置的绝对位置嵌入,却收到 2000 个 token。比较它与训练长度为 1024 的 RoPE 模型的失败方式。
查看解答
只有 1024 行的嵌入表无法索引更后的位置。扩大表、加入未训练行,可以避免索引错误,却没有学到这些位置的表示。RoPE 在训练长度之外仍定义旋转,所以计算可执行;但更大偏移会带来未训练的角度组合,以及更多竞争键。数学上能定义超过 1024 的位置,不保证长上下文可靠;仍需适当训练与评估。
给出两个原因,解释为何双向掩码语言模型不能直接变成从左到右的下一个 token 生成器。
查看解答
它用两侧上下文预测选中的缺失 token,并非用前缀预测所有后继;生成时右侧上下文尚不存在。另外,其通常的无掩码位置 logits 未被训练为下一个 token 分布。可以设计迭代掩码生成或改变目标,但这些都不是直接采用本模块不变的因果下一个 token 生成过程。
在宽度与深度相同条件下,比较 32 个查询头、8 个 KV 头的 GQA 与普通多头注意力。哪些投影和推理存储张量缩小四倍,哪些主要计算项不变?
查看解答
键和值投影宽度从 d 缩至 d/4,各自权重减至四分之一;缓存键和值也缩小四倍。查询与输出投影、FFN 不变。各查询头仍给所有可见键打分并混合值,因此查询-键和概率-值乘法的主导 FLOPs 不变;总计算仍因较小的键和值投影而下降。
解释为何将稠密注意力换成 FlashAttention 可以保持训练后模型的函数,而加入滑动窗口通常会改变它。
查看解答
FlashAttention 分块计算同样的可见分数、softmax 与加权和,只改变浮点顺序和执行细节。滑动窗口移除部分可见键,改变 softmax 分母与加权和。因此,全注意力模型改用窗口后需要适应训练和评估,不能视为等价的 kernel 替换。
将分数 (2,1,3,0) 与标量值 (1,2,3,4) 分成两个各含两项的块。计算各块处理后的累积最大值、归一化常数和累加器,并与直接 softmax 加权平均核对。
查看解答
第一个块之后,m=2、\ell=1+e^{-1}=1.367879 和 a=1+2e^{-1}=1.735759。第二块将最大值提高到 3,要求旧贡献乘以 e^{-1}。然后
比值约为 2.471。直接以最大值 3 缩放,指数为 (e^{-1},e^{-2},1,e^{-3}),总和同样为 \ell',值的加权和为 e^{-1}+2e^{-2}+3+4e^{-3}=a'。这种核对避免了先将权重取整再相乘。
计算词表 4096、宽度 256、四层、八个查询头、两个 KV 头、FFN 宽度 \lfloor8(256)/3\rfloor、无偏置 RMSNorm、共享嵌入的解码器参数量。逐项列出,解释与 12Ld^2 的差异。
查看解答
头宽度为 32,KV 投影宽度为 64,共享词表有 4096(256)=1{,}048{,}576 个参数。每层查询与输出矩阵共 2(256^2)=131{,}072,键与值共 2(256)(64)=32{,}768,注意力总计 163,840。FFN 宽度为 682,三个矩阵共 3(256)(682)=523{,}776;两个归一化共 512。每层 688,128,四层 2,752,512。再加最终归一化 256 和词表,得到 3,801,344。
规则 12Ld^2=3{,}145{,}728 不计嵌入,并假设普通多头注意力。GQA 每层节省 98,304;FFN 宽度取整又少 512,两个归一化恰好加回 512。因此,块总计 3{,}145{,}728-4(98{,}304) =2{,}752{,}512,嵌入与最终归一化解释剩余差异。
使用第 11 节 Llama-2-7B 的计数、两万亿训练 token、序列长度 4096,以及给定的 184,320 GPU 小时预算。分别用 6N_{\text{total}}D 和本系列约定计算模型 FLOPs,再换算每 GPU 持续 FLOP/s,以及相对给定峰值 312 TFLOP/s 的利用率。解释该估计忽略什么。
查看解答
设 N_{\text{total}}=6{,}738{,}415{,}616、N_{\text{matmul}}=6{,}607{,}343{,}616。简化计数为 6N_{\text{total}}D=8.08610\times10^{22} FLOPs;权重项为 7.92881\times10^{22},因果注意力项为 6(32)(4096)(4096)(2\times10^{12})=6.44245\times10^{21},相加为 8.57306\times10^{22} FLOPs。
给定 GPU 小时等于 184{,}320(3600)=663{,}552{,}000 GPU 秒,除后分别约为每 GPU 1.219\times10^{14}、1.292\times10^{14} FLOP/s,再除以 312\times10^{12},得到模型算力利用率 39.1%、41.4%。简化计数错误计入查找权重并漏掉注意力,误差部分抵消,最终仍低 5.7%。两种模型计数均不含检查点重算、优化器操作、评估、停机或通信。这里是模型算力利用率,不是直接测量硬件活动。
训练与验证损失异常迅速降到每字符 0.02 奈特。列出两个泄漏错误,并设计测试信息边界的干预。
查看解答
缺失或反向的因果掩码暴露下一个 token;目标未移位则让模型重建当前输入。先检查输入目标配对,再固定前缀、改变未来 token;因果模型较早位置的 logits 必须不变。仅前缀评分与生成提供独立检查;低留出窗口损失本身无法区分这些错误与成功学习。
实现显式因果注意力,与 PyTorch SDPA 比较输出。设置 batch 为 1、8 个头、头宽 64、float32,计算长度 512、2048、4096 的分数存储,并为两种实现计时。可选:在 GPU 上比较长度 512、2048、8192 的峰值分配内存,报告实际后端。
查看解答
以下显式实现可独立运行。计时前先核对数值;计时不含随机输入构造。预热避免某一实现单独承担首次调用初始化开销,但结果仍取决于机器。
import time
import torch
import torch.nn.functional as F

torch.manual_seed(0)
torch.set_num_threads(4)


def explicit(q, k, v):
    T = q.shape[-2]
    future = torch.ones(T, T, dtype=torch.bool, device=q.device).triu(1)
    scores = q @ k.transpose(-1, -2) / q.shape[-1] ** 0.5
    return scores.masked_fill(future, -torch.inf).softmax(-1) @ v


def fused(q, k, v):
    return F.scaled_dot_product_attention(q, k, v, is_causal=True)


with torch.no_grad():
    for T in (512, 2048, 4096):
        q, k, v = (torch.randn(1, 8, T, 64) for _ in range(3))
        reference, actual = explicit(q, k, v), fused(q, k, v)
        error = (reference - actual).abs().max().item()
        assert error < 1e-5
        print(f"T={T}: score storage {8 * T * T * 4 / 2**20:.0f} MiB, "
              f"max difference {error:.2e}")
        for name, function in (("explicit", explicit), ("SDPA", fused)):
            function(q, k, v)
            started = time.perf_counter()
            for _ in range(3):
                function(q, k, v)
            print(f"  {name}: {(time.perf_counter() - started) / 3:.4f} s")
仅分数张量分别为 8、128、512 MiB;长度 8192 时为 2 GiB。显式实现还保留 softmax 输出与临时量,所以峰值高于分数张量大小。SDPA 的内存取决于实际选择的实现,不是函数名。
可选 GPU 实验应先分配输入,再重置峰值统计,测量新增的实时分配;在计时和内存查询前后同步。较长的显式计算可能内存不足;这测量的是容量限制,不是正确性失败。
from torch.nn.attention import SDPBackend, sdpa_kernel

for T in (512, 2048, 8192):
    q, k, v = (torch.randn(1, 8, T, 64, device="cuda", dtype=torch.float16)
               for _ in range(3))
    for name, function in (("explicit", explicit), ("FlashAttention SDPA", fused)):
        torch.cuda.synchronize()
        baseline = torch.cuda.memory_allocated()
        torch.cuda.reset_peak_memory_stats()
        with torch.no_grad(), sdpa_kernel(SDPBackend.FLASH_ATTENTION):
            result = function(q, k, v)
        torch.cuda.synchronize()
        extra = torch.cuda.max_memory_allocated() - baseline
        print(T, name, "incremental peak MiB", extra / 2**20)
        del result
显式分支不受后端选择影响;SDPA 分支要求支持 FlashAttention 后端。后端错误应报告,不能悄悄换用其他实现。比较结束后,在解码器中恢复融合函数。
自测题
为每个问题选择一个答案。错误后重新访问相关概念部分。
论文导读
阅读 1
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., Polosukhin, I. “Attention is all you need.” NeurIPS, 2017. Paper.
阅读理由。 这是原始论文。学完本模块后,你应能理解模型章节的每个方程,并识别它与现代块的区别:后置归一化、正弦位置编码、ReLU、编码器-解码器。
阅读内容。 完整阅读第 3 节“模型架构”、第 4 节“为何使用自注意力”和表 1。略读第 5 节“训练”,重点看含预热的学习率公式。第 6 节只看表 3 的 base 与 big 两行,其余结果和结论可跳过。
阅读时要回答的问题
- 找到解释 1/sqrt(d_k) 缩放的脚注。它用了哪些假设,是否与本模块第 2 节相同?
- 表 1 比较了每层的复杂性。对于哪些序列长度 n(相对于 d),自注意力层比循环层更便宜?
- 论文使用前置还是后置归一化?引用子层方程,联系学习率公式的预热部分。
- 使用该模块的规则(d = 512,d_ff = 2,048,12d^2 的 6 个编码器层,16d^2 的 6 个解码器层,大约 37,000 x 512 的一个共享嵌入)估计基本模型的参数,并与表 3 的 65M 进行比较。(大约 63M。)
- 第 7 节 的三种形状中的哪一种是这个模型,它的交叉注意力键和值来自哪里?
阅读 2
Su, J., Lu, Y., Pan, S., Murtadha, A., Wen, B., Liu, Y. “RoFormer: Enhanced transformer with rotary position embedding.” arXiv:2104.09864, 2021. Paper.
阅读理由。 作者给出 RoPE 的原始推导,包括第 6 节使用的复数形式,以及实验 2 绘制的远距离衰减性质。
阅读内容。 阅读相对位置目标的表述、二维复数推导、一般块对角旋转矩阵、逐元素高效实现及远距离衰减。跳过与线性注意力的结合及实验结果。
阅读时要回答的问题
- 论文要求函数 f_q、f_k 且 <f_q(x_m, m), f_k(x_n, n)> = g(x_m, x_n, m - n)。将其写入该模块的符号 (q, k, t, s) 中。
- 将本文的逐元素实现与模块的 RoPE() 函数进行比较。每对组合在一起的维度是什么?当权重在实现之间移动时,为什么约定很重要?
- 用你自己的话陈述长期衰减特性,并将其与 实验 2 的 q = k = 全 1 的曲线进行比较。
阅读 3
Dao, T., Fu, D. Y., Ermon, S., Rudra, A., Ré, C. “FlashAttention: Fast and memory-efficient exact attention with IO-awareness.” NeurIPS, 2022. Paper.
阅读理由。 不做近似,即让注意力额外内存随序列长度线性增长。其算法 1 对应实验 3,背景部分也清楚解释注意力为何受内存限制。
阅读内容。 阅读第 2 节的 GPU 存储层级与算法 0,以及第 3.1 节的分块、重算和算法 1。阅读第 3.2 节 IO 复杂度定理的陈述,可跳过证明。略看块稀疏扩展,并查看一个加速测量结果。
阅读时要回答的问题
- 将算法 1 的 m、l 更新对应到第 10 节的在线 softmax 递推。哪一行用 exp(m - m’) 重新缩放?
- 论文给出了标准注意力的 Theta(N d + N^2) HBM 访问和 FlashAttention 的 Theta(N^2 d^2 / M),其中 M 是 SRAM 大小。证明当 N >> d 时,比率约为 M / d^2,并在 d = 64 且 M = 100 KB 的 fp16 值(约 51,200 个元素)时对其进行评估:约 12。
- 反向传播为何重算 S、P,而不是从内存读取?为何 FLOPs 更多,反而可能更快?
- 本文为 A100 上的 HBM 和片上 SRAM 提供了多少带宽?
小结
- 注意力计算可见值向量的内容相关加权和。
- 查询键分数按头宽度的平方根缩放,以控制其初始方差。
- 因果掩码可防止每个预测读取其后继 token。
- 多头注意力将几个独立投影的值混合物写入共享的残差流中。
- 前置归一化在中间块保留直接残差路径。
- RoPE 旋转查询与键,使各维度对贡献相对位置分数。
- 编码器、解码器和编码器-解码器模型的信息边界和训练目标有所不同。
- 分组查询保留查询头,同时减少键/值投影宽度和缓存存储。
- FlashAttention 分块计算全注意力,维护累积归一化常数与输出累加器。
- 输入表只做查找时,参数存储量与计算量采用不同计数。
- 训练矩阵乘积的成本约为前向的三倍。
- 初始损失检查与仅前缀评分,可发现普通验证损失遗漏的错误。
下一模块讨论下一个 token 目标对语言建模的意义:分词、困惑度、缩放定律、提示词、采样与大语言模型的局限。继续阅读 第 07 模块。
关键术语
| English | 中文 |
|---|---|
| self-attention | 自注意力 |
| query / key / value | 查询 / 键 / 值 |
| scaled dot-product attention | 缩放点积注意力 |
| causal mask | 因果掩码 |
| padding mask | 填充掩码 |
| permutation equivariance | 置换等变性 |
| multi-head attention | 多头注意力 |
| residual stream | 残差流 |
| induction head | 归纳头 |
| feed-forward network | 前馈网络 |
| SwiGLU (gated linear unit) | SwiGLU(门控线性单元) |
| pre-norm / post-norm | 前置归一化 / 后置归一化 |
| RMSNorm (root-mean-square normalisation) | 均方根归一化(RMSNorm) |
| positional encoding | 位置编码 |
| rotary position embedding (RoPE) | 旋转位置编码(RoPE) |
| ALiBi (attention with linear biases) | 线性偏置注意力(ALiBi) |
| context extension, position interpolation | 上下文扩展,位置插值 |
| encoder-only / decoder-only | 仅编码器 / 仅解码器 |
| encoder-decoder, cross-attention | 编码器-解码器,交叉注意力 |
| masked language modelling | 掩码语言建模 |
| grouped-query attention / multi-query attention | 分组查询注意力 / 多查询注意力 |
| KV cache (key-value cache) | KV cache |
| FlashAttention | FlashAttention(IO 感知注意力) |
| GPU kernel, fused kernel | kernel,融合 kernel |
| online softmax | 在线 softmax |
| sliding-window attention | 滑动窗口注意力 |
| vision transformer, patch embedding | 视觉 Transformer,图像块嵌入 |
| tied embeddings | 嵌入权重共享(权重绑定) |
| floating-point operations (FLOPs) | 浮点运算次数(FLOPs) |
参考文献
- Vaswani, A. et al. “Attention is all you need.” NeurIPS, 2017. The original transformer; guided reading 1.
- Bahdanau, D., Cho, K., Bengio, Y. “Neural machine translation by jointly learning to align and translate.” ICLR, 2015. The attention the transformer kept (Module 04).
- Devlin, J. et al. “BERT: Pre-training of deep bidirectional transformers for language understanding.” NAACL, 2019. Encoder-only, masked language modelling.
- Radford, A. et al. “Improving language understanding by generative pre-training.” 2018; “Language models are unsupervised multitask learners.” 2019. GPT and GPT-2: decoder-only, learned positions, the 1/sqrt(N) residual initialisation.
- Brown, T. et al. “Language models are few-shot learners.” NeurIPS, 2020. GPT-3; in-context learning as the argument for one decoder-only model.
- Raffel, C. et al. “Exploring the limits of transfer learning with a unified text-to-text transformer.” JMLR, 2020. T5; the controlled comparison of shapes and objectives.
- Wang, T. et al. “What language model architecture and pretraining objective work best for zero-shot generalization?” ICML, 2022. Causal decoders win for zero-shot use after self-supervised pretraining.
- Xiong, R. et al. “On layer normalization in the transformer architecture.” ICML, 2020. Why pre-norm trains without warmup.
- Zhang, B., Sennrich, R. “Root mean square layer normalization.” NeurIPS, 2019. RMSNorm.
- Shazeer, N. “GLU variants improve transformer.” arXiv, 2020. SwiGLU and its relatives.
- Geva, M., Schuster, R., Berant, J., Levy, O. “Transformer feed-forward layers are key-value memories.” EMNLP, 2021.
- Meng, K., Bau, D., Andonian, A., Belinkov, Y. “Locating and editing factual associations in GPT.” NeurIPS, 2022. Factual recall localised in mid-layer FFNs.
- Elhage, N. et al. “A mathematical framework for transformer circuits.” Transformer Circuits Thread, 2021. The residual stream, QK and OV circuits.
- Olsson, C. et al. “In-context learning and induction heads.” Transformer Circuits Thread, 2022. Induction heads and their abrupt formation (Lab 6).
- Jain, S., Wallace, B. C. “Attention is not explanation.” NAACL, 2019. Why attention maps need interventions behind them.
- Su, J. et al. “RoFormer: Enhanced transformer with rotary position embedding.” arXiv, 2021. RoPE; guided reading 2.
- Press, O., Smith, N. A., Lewis, M. “Train short, test long: attention with linear biases enables input length extrapolation.” ICLR, 2022. ALiBi.
- Haviv, A., Ram, O., Press, O., Izsak, P., Levy, O. “Transformer language models without positional encodings still learn positional information.” Findings of EMNLP, 2022.
- Chen, S., Wong, S., Chen, L., Tian, Y. “Extending context window of large language models via positional interpolation.” arXiv, 2023.
- Peng, B., Quesnelle, J., Fan, H., Shippole, E. “YaRN: Efficient context window extension of large language models.” ICLR, 2024. Also traces the history of NTK-aware scaling.
- Shazeer, N. “Fast transformer decoding: One write-head is all you need.” arXiv, 2019. Multi-query attention.
- Ainslie, J. et al. “GQA: Training generalized multi-query transformer models from multi-head checkpoints.” EMNLP, 2023.
- Beltagy, I., Peters, M. E., Cohan, A. “Longformer: The long-document transformer.” arXiv, 2020. Sliding-window plus global attention.
- Jiang, A. Q. et al. “Mistral 7B.” arXiv, 2023. Sliding-window attention with GQA in an open model.
- Xiao, G., Tian, Y., Chen, B., Han, S., Lewis, M. “Efficient streaming language models with attention sinks.” ICLR, 2024.
- Milakov, M., Gimelshein, N. “Online normalizer calculation for softmax.” arXiv, 2018. The online softmax.
- Dao, T., Fu, D. Y., Ermon, S., Rudra, A., Ré, C. “FlashAttention: Fast and memory-efficient exact attention with IO-awareness.” NeurIPS, 2022. Guided reading 3.
- Dao, T. “FlashAttention-2: Faster attention with better parallelism and work partitioning.” ICLR, 2024.
- Kaplan, J. et al. “Scaling laws for neural language models.” arXiv, 2020. The per-token FLOP accounting used in Section 11.
- Touvron, H. et al. “LLaMA: Open and efficient foundation language models.” arXiv, 2023. The reference decoder recipe; the 6.7B configuration.
- Touvron, H. et al. “Llama 2: Open foundation and fine-tuned chat models.” arXiv, 2023. Training tokens and GPU-hours used in exercise e13.
- Grattafiori, A. et al. “The Llama 3 herd of models.” arXiv, 2024. GQA with 8 KV heads; RoPE base 500,000.
- Dosovitskiy, A. et al. “An image is worth 16x16 words: Transformers for image recognition at scale.” ICLR, 2021. The vision transformer.
- Touvron, H. et al. “Training data-efficient image transformers and distillation through attention.” ICML, 2021. DeiT.
- Phuong, M., Hutter, M. “Formal algorithms for transformers.” arXiv, 2022. Precise pseudocode for every variant in this module; a good companion to Section 12’s code.